
Anthropic annonce que Claude Opus 5.5 coûte 40 % de moins à exécuter qu'Opus 5. Quelqu'un dans votre équipe a déjà posé le calcul évident : à budget égal, environ 1,7 fois plus d'exécutions d'agents, donc environ 1,7 fois plus de travail livré. Ce calcul est arithmétiquement juste et opérationnellement faux, et la semaine où l'on agit en conséquence est celle où votre tableau se remplit d'exécutions terminées que personne n'a lues.
La contrainte pour faire tourner plus d'agents en parallèle n'a jamais été la facture de modèles. C'était la capacité d'une seule personne à lire un diff, à comprendre ce qu'un agent a décidé et à l'accepter. Une baisse de prix ne change rien à ce chiffre. Elle augmente la vitesse à laquelle le travail y arrive.
TL;DR
Un plafond de revue est le nombre d'exécutions d'agents terminées qu'une équipe peut réellement lire, juger et accepter en une journée, et il est déterminé par les personnes, pas par les tokens. Des modèles moins chers augmentent le débit d'arrivée à ce plafond sans toucher au plafond lui-même : le premier effet visible d'une baisse de prix est donc une file d'attente plus longue, pas une livraison plus rapide. Les agents font de la recherche, exécutent, testent et rendent compte. Les humains donnent la direction, accordent l'autorité et acceptent le résultat. La réponse utile consiste à plafonner la concurrence en fonction des relecteurs plutôt que du budget, et à distinguer le travail d'agent qui converge vers un seul résultat vérifiable de celui qui se ramifie en de multiples résultats. Sharkly garde le contexte, la progression, les blocages, les résultats et la revue humaine visibles sur la Task, de la demande à la livraison, ce qui est précisément ce qui rend la file d'attente mesurable.
Ce qui a réellement baissé de prix
Deux laboratoires ont livré le 2026-09-22. Voici la partie qui concerne votre facture.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| Identifiant API | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Entrée pour 1 M de tokens | 5 $ | 4 $ | 2 $ | 0,10 $ |
| Sortie pour 1 M de tokens | 25 $ | 20 $ | 10 $ | 0,50 $ |
| Entrée mise en cache | n/a | 0,20 $ en lecture, 5 $ en écriture | 90 % de réduction sur les lectures | 90 % de réduction sur les lectures |
Anthropic indique qu'Opus 5.5 coûte 40 % de moins à exécuter qu'Opus 5 et produit sa sortie environ 30 % plus vite. Les tarifs catalogue ci-dessus correspondent à 20 % de moins que le prix aux tokens d'Opus 5, ce qui est notre propre calcul à partir de deux chiffres publiés et une affirmation distincte des 40 %. OpenAI indique que Sol et Luna sont chacun 50 % moins chers que les tarifs promotionnels de GPT-5.6, et « promotionnel » est le mot d'OpenAI lui-même : ce chiffre est donc mesuré par rapport à un tarif remisé et non à un tarif catalogue.
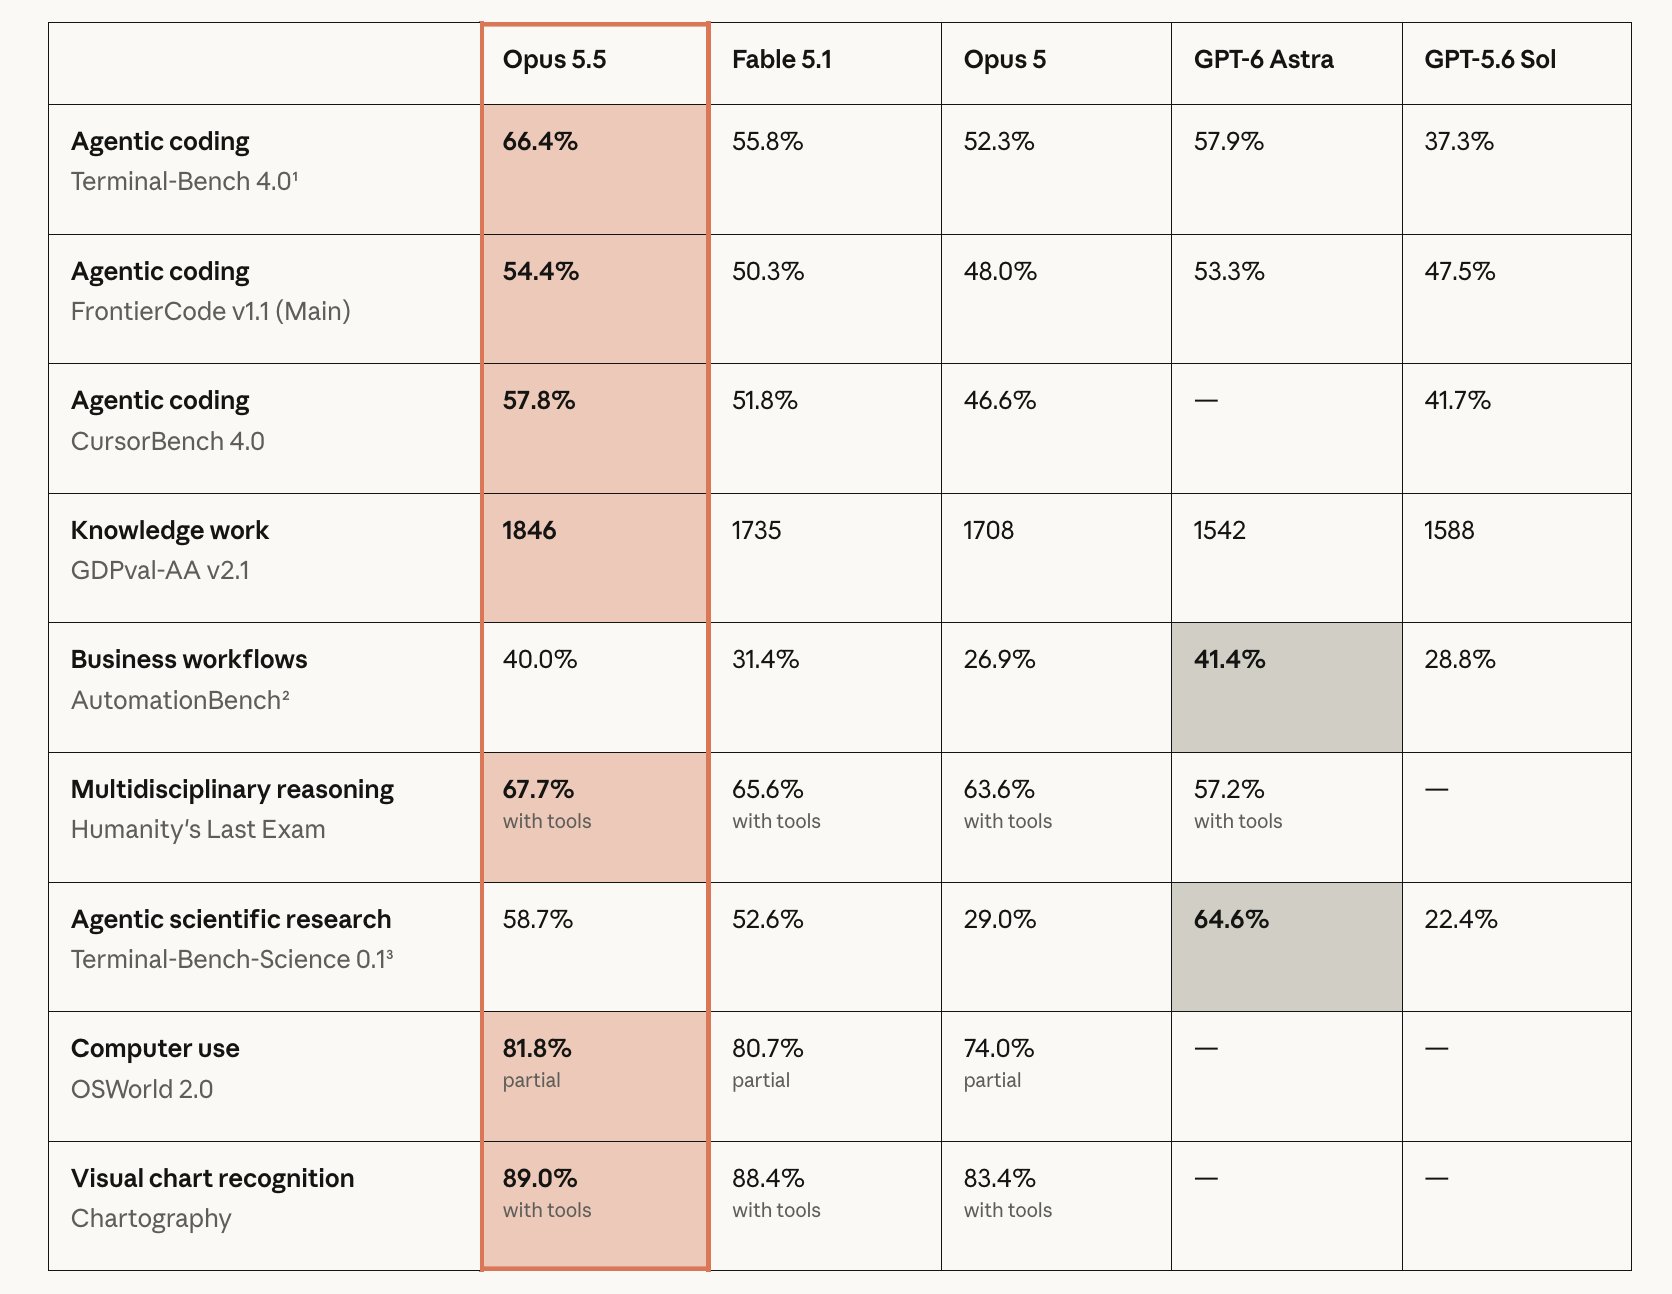
Le coût par tâche accomplie a davantage bougé que le coût par token. Sur AutomationBench 1.0.6, OpenAI rapporte GPT-6 Sol en raisonnement « extra high » avec un score de 33,2 % pour 0,27 $ par tâche, contre Claude Opus 5 en raisonnement maximal avec 26,9 % pour 11,1 fois le coût de Sol. Sur DeepSWE 1.1, OpenAI place GPT-6 Luna en raisonnement maximal à 66,6 % et 93 % moins cher par tâche qu'Opus 5.
Le prix d'une tentative a donc chuté fortement, chez deux fournisseurs, en une seule journée. Rien d'autre dans votre semaine n'a changé.
Le calcul que tout le monde a fait cette semaine
Gardez la dépense constante et divisez. À 40 % de moins à l'exécution, la même somme mensuelle achète environ 1,67 fois plus d'exécutions d'Opus 5.5 que d'exécutions d'Opus 5. Redirigez plutôt la moitié routinière du travail vers Luna et le multiplicateur cesse d'être intéressant, car à 0,10 $ et 0,50 $ le million de tokens, la ligne « modèles » n'est plus ce que vous budgétez.
Faites maintenant le second calcul, celui qui détermine si quoi que ce soit est livré. Prenez le nombre d'exécutions terminées qu'un de vos ingénieurs peut lire correctement en une journée. Pas survoler, pas approuver sur une coche verte : lire le diff, comprendre ce que l'agent a choisi de faire et en assumer la responsabilité. Quel que soit ce nombre, il était identique le 2026-09-21 et il le sera encore le trimestre prochain. L'arithmétique de la capacité de revue tourne mal avant même une baisse de prix, et une baisse de prix ne modifie que le côté entrant.
Une baisse de prix n'est pas une augmentation de capacité. C'est un changement dans le coût de génération d'une chose qui exige toujours une personne.
L'indice : ce n'était pas le coût qui vous arrêtait
Si le coût des modèles était la contrainte déterminante, les équipes auraient tourné sur la configuration la moins chère qui fonctionne. Ce n'était pas le cas. Les propres chiffres d'OpenAI indiquent que le chercheur médian de son organisation consomme plus de 600 $ d'inférence par jour aux tarifs API, et que le 90e percentile en consomme 7 000 $ par jour. Son tableau de benchmarks publié montre des équipes utilisant sciemment une configuration 11,1 fois plus chère par tâche pour obtenir un score inférieur, parce qu'un résultat auquel on fait confiance vaut plus qu'un résultat qu'il faut vérifier deux fois.
Voilà la forme de la vraie contrainte. Les gens paient un multiple important pour une sortie qui demande moins d'examen humain par unité. La ressource rare qu'ils achètent, c'est l'attention, pas le calcul, et elle s'achetait déjà à un fort premium.
Ce qui signifie qu'une baisse de prix frappe de façon asymétrique. Elle rend le côté génération moins cher et laisse le côté acceptation exactement là où il était.
La ramification qui converge, et celle qui atterrit sur le tableau
Voici la distinction qui rend les modèles bon marché réellement utiles plutôt que discrètement coûteux, et c'est celle que la plupart des équipes passent sous silence.
Certains parallélismes convergent. Trois agents tentent la même migration dans des worktrees isolés, une suite de tests et un Agent leader désignent celui qui passe, et un seul résultat parvient à une personne. Le coût a triplé et la charge de revue n'a pas bougé. C'est là qu'une baisse de prix vous achète un vrai débit, et que la nouvelle économie justifie de modifier votre configuration.
D'autres parallélismes divergent. Dix agents prennent dix Tasks sans lien entre elles et produisent dix diffs, dix résumés de changements et dix décisions d'acceptation. Le coût, ce sont les mêmes dix exécutions. La charge de revue, c'est dix fois l'unité d'attention d'une personne.
| Ramification convergente | Ramification divergente | |
|---|---|---|
| Exemple | 3 tentatives sur une même migration, la meilleure gagne | 10 Tasks, 10 Assignees, 10 diffs |
| Ce que les modèles moins chers apportent | Plus de tentatives, plus de chances que l'une soit bonne | Plus de travail terminé en attente |
| Éléments de revue produits | 1 | 10 |
| Sûr à mettre à l'échelle sur le seul critère du prix | Oui | Non |
Utilisez les modèles bon marché pour élargir la ramification convergente aussi loin que votre patience pour les reprises le permet. Ne les utilisez pas pour élargir la ramification divergente au-delà de vos relecteurs, aussi abordables les exécutions soient-elles devenues. Voilà la paire de décisions honnête, et c'est sa seconde moitié qui coûte cher quand on l'ignore.
Quoi changer à la place du budget
Plafonnez la concurrence en fonction des relecteurs, pas de la dépense. Écrivez la règle là où la Crew peut la voir : les Tasks ouvertes en attente d'acceptation humaine ne doivent pas dépasser le nombre de relecteurs en service multiplié par le nombre de revues que l'un d'eux réalise pendant un service. Vos deux chiffres, pas les nôtres. Quand le plafond est atteint, les agents cessent de prendre de nouvelles Tasks, même si le budget le permettrait. Une règle de routage écrite l'emporte ici sur une préférence, car une préférence perd discrètement face à un prix plus bas.
Faites de « en attente d'un humain » un état visible. Une exécution terminée et une exécution qui s'est arrêtée pour poser une question sont identiques vues de l'extérieur, et toutes deux sont invisibles si le seul enregistrement est un terminal. L'exécution, les blocages, les résultats et les échanges de suivi devraient revenir dans la chronologie de la Task, pour que la file d'attente soit une chose que l'on peut compter plutôt qu'une impression du vendredi.
Chiffrez la revue, pas les tokens. Un suivi des coûts entre agents qui rapporte des dollars par exécution répond à une question qui n'est plus déterminante. Le chiffre qui mérite une place sur un tableau de bord, ce sont les minutes humaines par changement accepté. Si ce chiffre a augmenté après votre passage à un modèle moins cher, alors le modèle moins cher est plus cher.
Dépensez une partie de l'économie en preuves. Une exécution qui joint sa vérification de types, ses résultats de tests, son résumé de changements et ses limites connues coûte plus de tokens et moins d'attention. À 0,20 $ le million de lectures d'entrée en cache sur Opus 5.5 et 90 % de réduction sur les lectures en cache avec GPT-6, la passe de vérification supplémentaire est quasi gratuite, et elle rachète la ressource qui était réellement rare.
Où cela nous laisse pour la semaine
Deux laboratoires ont réduit le prix d'une tentative le même jour, et l'un d'eux s'est comparé à un modèle remplacé quelques heures plus tard. Ni l'un ni l'autre n'a livré quoi que ce soit qui lise un diff à votre place. La propriété humaine du travail est la partie qui n'a pas baissé de 40 %, et c'est celle qui décide de ce qui atteint la production.
Si vous faites déjà tourner plusieurs agents de code, le geste utile cette semaine n'est pas d'augmenter le nombre de tâches concurrentes. C'est de découvrir ce qu'est réellement votre plafond de revue, puis d'y aligner la concurrence. Sharkly vous offre un seul endroit pour voir les exécutions, les blocages, les résultats et la file de travail en attente d'acceptation par une personne.


