
Anthropic a lancé Claude Sonnet 5.5 le 28 septembre au tarif de 2 $ par million de tokens en entrée et 10 $ par million en sortie, soit le même prix catalogue que Sonnet 5 et la moitié du coût d'Opus 5.5. Selon Anthropic, il s'exécute plus de 30 % plus rapidement que Sonnet 5 et réduit le coût par tâche jusqu'à 30 %. Pour une équipe qui déploie plusieurs agents de développement, la nouveauté majeure réside dans le fait que le modèle destiné aux Agents du quotidien se positionne désormais à quelques points seulement du modèle phare sur la plupart des lignes du tableau de lancement d'Anthropic.
Son intégration sur votre tableau de bord est toutefois moins automatique qu'il n'y paraît. Dans Claude Code, le modèle default renvoie vers Opus 5.5 sur les forfaits Pro, Max, Team, Enterprise ainsi que sur l'API Anthropic ; un Computer exécutant Claude Code reste donc sur le modèle phare tant que personne ne le modifie manuellement. De plus, l'alias sonnet ne pointe vers Sonnet 5.5 que sur l'API Anthropic : sur Bedrock, Google Cloud et Microsoft Foundry, il cible toujours Sonnet 4.5. Une équipe pensant être « passée à Sonnet » peut ainsi se retrouver avec trois modèles différents sur trois Computers, sans aucun moyen de savoir quel modèle a exécuté telle session. Ce guide propose l'approche la plus directe et pragmatique : un Computer, un Agent, une vraie Task, puis une grille d'évaluation pour déterminer où Opus 5.5 justifie encore son surcoût.
En résumé
Mettez à jour Claude Code sur le Computer vers la version v2.1.284 ou ultérieure, définissez explicitement l'identifiant complet claude-sonnet-5-5 au lieu de l'alias sonnet, et relancez une analyse jusqu'à ce que le Runtime Claude Code affiche le statut Available. Rédigez des instructions d'Agent qui préviennent les validations prématurées et les ajouts superflus propres à Sonnet 5.5, conservez un répertoire de travail configuré sur Temporary, ajustez le délai d'expiration pour des tâches bien délimitées et assignez une Task. Au sein d'une Crew, confiez les tâches courantes aux membres sous Sonnet 5.5 et conservez Opus 5.5 pour le rôle de leader et de réviseur. Les Agents cherchent, exécutent, testent et rendent compte. Les humains fixent le cap, accordent les autorisations et valident le résultat final.
Où se configure le modèle
Sharkly ne sélectionne pas les modèles à votre place. La documentation sur les Agents le précise sans ambiguïté : « L'Agent adopte le modèle par défaut du Runtime. Il ne garantit ni n'affiche aucun nom de modèle spécifique. Modifiez les modèles dans la configuration de l'outil du Runtime ou du Computer, et non au niveau de l'Agent. » La documentation ajoute également que l'Agent n'expose aucun sélecteur de modèle ni aucun contrôle sur la profondeur de réflexion.
Ce point est crucial pour Sonnet 5.5, car le niveau d'effort influence radicalement son comportement, et cet effort se configure là où réside le modèle : dans Claude Code sur le Computer. L'Agent définit la manière dont le travail est pris en charge, le Computer fournit l'hôte, le Runtime (ici Claude Code) gère la session d'exécution et la Task sert de référentiel partagé.
Étape 1 : configurer Sonnet 5.5 dans Claude Code sur le Computer
Sonnet 5.5 nécessite Claude Code v2.1.284 ou une version ultérieure, conformément à la documentation de configuration des modèles de Claude Code. Mettez-le à jour sur le Computer et connectez-vous à l'aide d'un abonnement payant ou d'une clé d'API disposant des accès requis ; Claude Code n'est pas accessible via l'offre gratuite Claude Free (ce qu'un accès chat standard permet ou non d'exécuter). Exécutez ensuite la commande claude --model claude-sonnet-5-5 dans un terminal standard sur cet hôte. Si une session démarre, Sharkly peut l'utiliser.
Fixez l'identifiant complet plutôt que l'alias. Voici vers quoi l'alias sonnet pointe actuellement dans Claude Code :
| Provenance du modèle dans Claude Code | L'alias sonnet renvoie vers |
|---|---|
| API Anthropic | Sonnet 5.5 |
| Claude Platform sur AWS | Sonnet 4.6 |
| Amazon Bedrock | Sonnet 4.5 |
| Google Cloud Agent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
L'identifiant est claude-sonnet-5-5 sur toutes les plateformes, sauf sur Bedrock où le modèle passe par le profil inter-régions global global.anthropic.claude-sonnet-5-5. L'option opusplan hérite du même problème d'alias : elle planifie sur Opus et exécute sur la version actuellement associée à sonnet.
Pérennisez ensuite ce choix : configurez le modèle dans les paramètres de Claude Code sur ce Computer afin que chaque exécution initiée par le service local utilise Sonnet 5.5 plutôt qu'Opus 5.5 par défaut, puis vérifiez à nouveau dans le terminal.
De retour dans Sharkly, ouvrez la vue détaillée du Computer et lancez une nouvelle détection ou un test de connexion. Le Runtime Claude Code doit afficher Available. Un Computer affiché comme étant en ligne indique simplement que son service local émet des pulsations (heartbeats) ; seul le statut du Runtime garantit qu'une exécution peut effectivement débuter.
Étape 2 : adapter l'Agent au comportement de Sonnet 5.5
Accédez à la section Agents, sélectionnez New Agent, puis choisissez le Computer et le Runtime Claude Code. Le guide de prompting de Sonnet 5.5 d'Anthropic met en lumière certains réflexes du modèle qui finissent bien souvent par engorger la file de révision.
Le niveau d'effort détermine la nature exacte du modèle exploité. Claude Code exécute par défaut Sonnet 5.5 avec un niveau d'effort medium, et le mode de réflexion ne peut pas y être désactivé. La plupart des performances spectaculaires annoncées lors du lancement ont été mesurées avec l'effort réglé sur max. Les benchmarks d'Anthropic attribuent à Sonnet 5.5 un score de 39,2 % sur CursorBench 4.0 en medium et de 55,5 % en max, pour un coût estimé respectivement à 0,70 $ et 9,67 $ par tâche. Il s'agit là de budgets foncièrement différents, et non d'un bon ou d'un mauvais paramétrage. Le guide préconise le niveau medium pour le développement agentique sur des tâches bien spécifiées, et recommande de réserver les niveaux xhigh et max aux situations où les gains de performance sont clairement mesurés.
Il a tendance à solliciter l'utilisateur trop tôt. Avec un niveau d'effort faible ou moyen, Sonnet 5.5 s'interrompt fréquemment pour demander une validation au cours de tâches agentiques longues. Dans Sharkly, cette demande de confirmation s'ajoute sous forme de commentaire à la Task, qui passe alors en attente d'une réponse humaine et stagne dans la boîte de réception (Inbox) d'un collaborateur. Indiquez expressément à l'Agent de poursuivre en explicitant ses hypothèses de travail. Par ailleurs, avec un effort faible, le modèle peut affirmer que le code est prêt sans avoir exécuté les tests : exigez impérativement ces vérifications.
Il intègre des éléments non sollicités. Le guide souligne l'ajout spontané de tests, de documentation et de petits fichiers annexes, quel que soit le niveau d'effort sélectionné, ainsi que le lancement de cycles de révision supplémentaires ou de sous-agents réviseurs aux niveaux xhigh et max. La note de bas de page du lancement d'Anthropic en illustre le coût : Sonnet 5.5 a obtenu un score inférieur sur FrontierCode en niveau max par rapport au niveau xhigh, car il a plus souvent déclenché la compétence de revue de code de Claude Code. Celle-ci génère de multiples sous-agents en parallèle, ce qui a provoqué des dépassements de délai ou des modifications hors périmètre dans deux cas étudiés par Cognition. Pour le réviseur, cela se traduit par un diff plus volumineux contenant des modifications extérieures à la Task.
Délai d'expiration et répertoire de travail. Anthropic positionne Sonnet 5.5 sur des « tâches courantes et bien délimitées ». Calibrez donc le délai d'expiration par Task en conséquence, et si une exécution atteint la limite, divisez la Task avant de relever le plafond. Conservez le répertoire de travail sur Temporary : chaque Task bénéficie d'un dossier isolé, et les exécutions adossées à un dépôt préparent un worktree neuf, évitant ainsi tout écrasement entre exécutions parallèles. Laissez la concurrence à sa valeur par défaut (50 % de la limite du Computer) tant que celui-ci n'a pas été éprouvé en conditions réelles de charge.
Modèle d'instructions à adapter :
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior. Do not add tests,
docs, or new files unless the Task asks for them; list any you
think are missing in your report instead.
Do not stop to ask whether to continue. When a detail is ambiguous,
proceed with a stated assumption and record it in your report.
Ask only when different interpretations would materially change
the result.
Run the closest relevant checks before reporting done, and report
failures without hiding them.
Do not start extra review rounds or reviewer subagents.
If a safeguard notice or refusal appears, say so in your report.
Stop and ask before anything destructive or outside the attached
repositories.
Étape 3 : assigner une première Task, puis structurer une Crew à deux niveaux
Choisissez une Task aux critères d'acceptation précis, désignez l'Agent comme Assignee, puis faites-la passer du Backlog (où patientent les tâches assignées) à un statut prêt pour l'exécution. La session passe successivement par les états queued, dispatched et running, tandis que l'onglet Executions affiche les logs en direct.
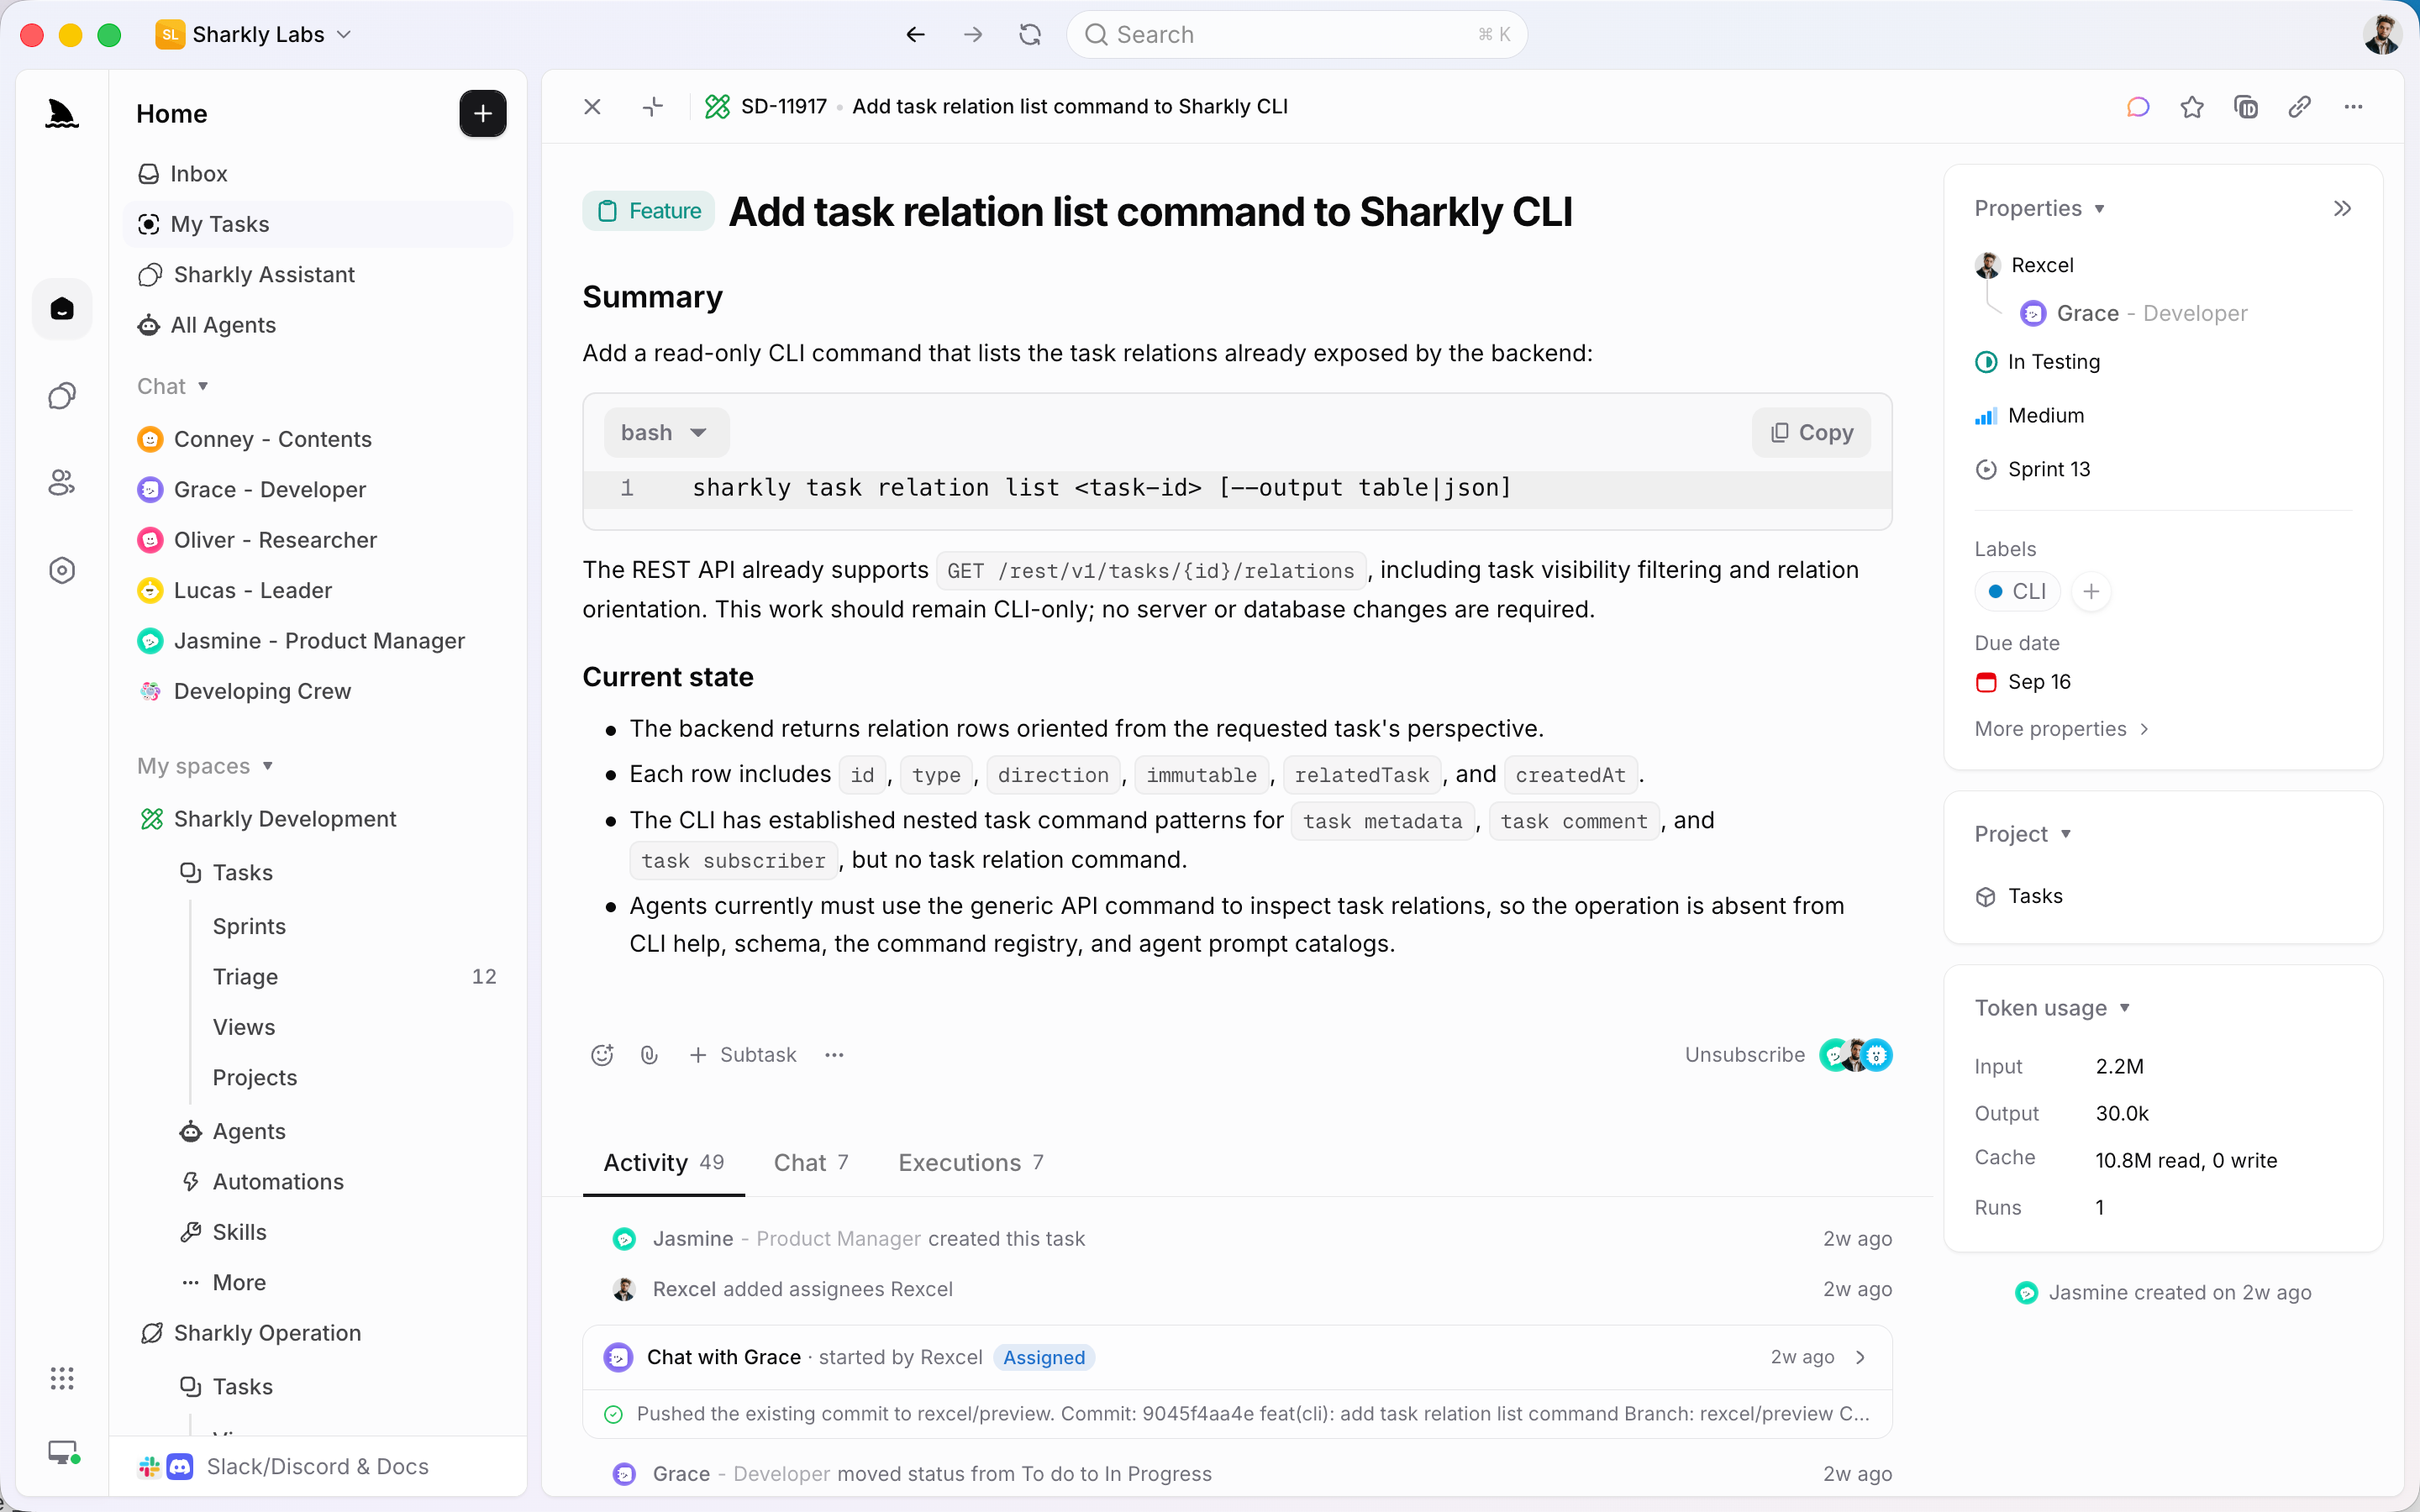
Confiez cette première Task à un seul Agent. Une Crew est un groupe réutilisable d'humains et d'Agents coordonné par un Agent leader ; elle démontre toute sa valeur lorsque ce leader doit interpréter un objectif global et synthétiser les contributions de plusieurs membres au sein d'une même Task. Pour corriger un bug circonscrit, un seul Agent reste l'approche idéale.
Dans une Crew, la répartition des rôles s'aligne sur le positionnement établi par Anthropic. Opus 5.5 « reste nettement supérieur sur les travaux complexes et ouverts », ce qui correspond exactement au rôle du leader : planifier, répartir le travail et réviser. Les tâches des membres correspondent aux périmètres bien cadrés pour lesquels Sonnet 5.5 est conçu. L'un des premiers bêta-testeurs cité lors du lancement décrit d'ailleurs ce même schéma : Sonnet 5.5 implémente l'architecture préalablement définie par Opus 5.5.
| Modèle de Runtime | Identifiant API | Entrée / sortie par million | Cas d'usage idéal |
|---|---|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 |
2 $ / 10 $ | Membres d'équipe pour les tâches courantes : corrections de bugs, fonctionnalités ciblées, documentation |
| Claude Opus 5.5 | claude-opus-5-5 |
4 $ / 20 $ | Leader, réviseur, travaux exploratoires et ouverts |
| Claude Sonnet 5 | claude-sonnet-5 |
2 $ / 10 $ | Version précédente de Sonnet ; modèle de repli en cas d'alerte sur des requêtes liées à la cybersécurité |
| GPT-6 Sol | gpt-6-sol |
2 $ / 10 $ | Un second Runtime, basé sur Codex, à un tarif identique |
L'emplacement documenté pour configurer le modèle étant l'outil de paramétrage du Computer, l'architecture à deux niveaux la plus fluide repose sur deux Computers : l'un conservant Opus 5.5 par défaut dans Claude Code pour le rôle de leader, l'autre configuré explicitement sur claude-sonnet-5-5 pour les membres opérationnels. La frontière entre ces deux rôles mérite d'être formalisée par une règle de routage claire ; l'article Sonnet 5.5 ou Opus 5.5 détaille cette démarche, tandis que le comparatif Sonnet 5.5 face à GPT-6 Sol traite de l'autre Runtime proposé au même tarif. La consommation de tokens s'appuie sur les abonnements ou les clés d'API configurés dans ces outils : ces coûts apparaissent donc directement sur la facture de votre fournisseur, et non sur celle de Sharkly.
Ce qui change sur le tableau de bord
Des exécutions plus rapides sollicitent les mêmes réviseurs. Produire un volume accru de code achevé par jour à budget constant ne crée pas d'heures de révision supplémentaires pour autant, d'autant que l'ajout spontané de tests et de documentation alourdit chaque diff. Organisez votre flux en fonction de votre capacité de révision, et non du seul coût du modèle.
Une exécution signalée peut ne pas avoir tourné sous Sonnet 5.5. Il s'agit du premier modèle Sonnet doté de garde-fous spécifiques à la cybersécurité. Anthropic précise que les tâches cyber jugées à risque plus élevé « basculeront visiblement vers Sonnet 5 », et la fiche technique (system card) avertit d'une hausse des refus, y compris lors d'audits de sécurité légitimes. Or, ce qui est visible dans la session ne l'est pas forcément sur le tableau de bord : Sharkly n'affichant pas le nom du modèle, rien dans la Task n'indique quel modèle a généré la réponse, à moins que l'Agent ne le consigne expressément par écrit. C'est tout l'intérêt des instructions fournies plus haut.
Le raisonnement reste lié au modèle qui l'a produit. Sonnet 5.5 ne peut pas interpréter les blocs de pensée d'Opus 5.5, aucun autre modèle ne peut lire ceux de Sonnet 5.5, et les blocs illisibles sont ignorés sans générer d'erreur. Même au cours d'une seule session Claude Code, basculer entre les deux modèles préserve le texte visible mais efface la réflexion sous-jacente. Entre les différents Agents d'une Crew, le fil de raisonnement n'a de toute façon jamais circulé : le réviseur reçoit uniquement ce que le membre a consigné dans la Task. L'article sur la perte de raisonnement lors des passages de relais détaille la solution à adopter, et nos modèles de passage de relais en proposent une structure prête à l'emploi.
Le modèle a évolué cette semaine. En revanche, l'assignation, le contexte, l'avancement, les blocages, les résultats et la validation humaine restent parfaitement visibles et centralisés pour l'équipe. Vous pouvez mettre en place cette organisation manuellement à l'aide de worktrees, ou vous appuyer sur Sharkly pour orchestrer l'ensemble du flux de travail.


