
Vous lancez un agent de codage sur une vraie tâche, vous fermez votre portable et vous partez déjeuner. Ça, c'est la partie facile. La partie difficile, c'est ce que vous découvrez en revenant : un terminal dont le début a défilé hors de l'écran, un diff que vous n'avez pas vu s'écrire, et aucune réponse claire à la seule question qui compte : ce travail est-il assez bon pour être conservé ?
Faire tourner un agent sans surveillance comporte deux moitiés, et la plupart des configurations n'en résolvent qu'une. La première consiste à garder le processus vivant et productif alors que personne ne regarde. La seconde, c'est la file de revue : l'amas d'exécutions terminées, à moitié terminées et échouées qui attendent une décision humaine à votre retour. Négligez cette seconde moitié et les agents sans surveillance ne font que déplacer le goulot d'étranglement : il n'est plus dans l'écriture du code, mais dans la reconstitution de ce qui s'est passé.
Cet article couvre les deux moitiés : comment mettre en place vous-même une exécution sans surveillance, le mode de défaillance à chaque étape, et le moment où cette installation artisanale cesse de passer à l'échelle. Quand un terminal en devient cinq, un tableau de tâches comme Sharkly se place au-dessus de vos agents de codage. Vous continuez de laisser Claude Code, Codex ou Gemini CLI faire le travail, et Sharkly regroupe la tâche, l'exécution et la revue au même endroit, au lieu de les disperser dans des terminaux que vous avez déjà fermés.
Ce qu'implique réellement une exécution sans surveillance
Une exécution sans surveillance, c'est un agent de codage qui exécute une tâche sur un hôte que vous ne surveillez pas activement, sa sortie étant capturée pour être relue plus tard. Cette définition repose sur trois éléments porteurs : une tâche que l'agent peut terminer sans vous, un hôte qui continue de tourner quand vous vous déconnectez, et un enregistrement que vous pouvez lire ensuite.
L'enregistrement est la partie que les gens sous-estiment. Quand vous observez un agent en direct, c'est vous, le journal : vous le voyez choisir le mauvais fichier, vous l'interrompez, vous rectifiez le tir. Sans surveillance, rien de tout cela n'a lieu. Tout ce que l'agent a fait doit survivre sous une forme que vous pouvez inspecter à froid, des heures plus tard, sans le moindre souvenir de ce que vous aviez demandé. Les agents font la recherche, l'exécution, les tests et le rapport. Les humains donnent la direction, accordent l'autorité et acceptent le résultat. Ce contrat ne tient que si le rapport est réel et complet au moment où vous y revenez.
L'objectif n'est donc pas « faire tourner l'agent sans moi », mais « faire tourner l'agent sans moi et récupérer quelque chose que je peux relire ». Ce sont deux problèmes distincts, et c'est sur le second que les workflows sans surveillance se cassent généralement.
Mettre en place soi-même une exécution sans surveillance
Voici la version manuelle minimale, avec le mode de défaillance qui fait mal à chaque étape.
Étape 1 : isolez le travail. Donnez à l'exécution son propre checkout pour qu'elle ne puisse pas entrer en collision avec votre éditeur ou un autre agent.
git worktree add ../task-auth-refactor -b task/auth-refactor
cd ../task-auth-refactor
Mode de défaillance : sautez cette étape et deux exécutions dans le même répertoire écrasent mutuellement leurs modifications non commitées. Voir un checkout par tâche pour comprendre pourquoi ce sont les worktrees, et non les branches seules, qui forment la frontière d'isolation.
Étape 2 : détachez le processus. Votre session SSH ou votre terminal va se fermer, et un processus au premier plan meurt avec lui (SIGHUP). Maintenez-le en vie avec nohup ou une session tmux :
nohup claude -p "Refactor auth to use the new token service; run the tests" \
  > run.log 2>&1 &
Mode de défaillance : lancez-le dans un simple shell au premier plan et fermer le capot tue l'agent au milieu d'une édition portant sur plusieurs fichiers, laissant derrière lui un arbre cassé. nohup règle la question de la durée de vie mais ne vous donne aucun moyen de revenir dedans ; tmux vous permet de vous rattacher et de voir ce qui se passe.
Étape 3 : capturez tout. Le > run.log 2>&1 ci-dessus n'est pas facultatif. C'est la file de revue, dans sa forme la plus brute.
Mode de défaillance : sans journal capturé, impossible de répondre à « pourquoi s'est-il arrêté ? ». Le blocage silencieux le plus fréquent est un agent qui attend indéfiniment une invite interactive que personne ne viendra remplir, car sans surveillance, personne n'est là pour taper « oui ». Lancez l'agent en mode non interactif et pré-approuvez le petit ensemble d'actions dont la tâche a besoin.
Étape 4 : limitez le rayon d'impact. Décidez, avant de partir, ce que l'agent peut faire seul et ce qui exige votre intervention. Restreignez le périmètre des fichiers, interdisez le force-push et ne laissez jamais une exécution sans surveillance fusionner vers une branche protégée.
Mode de défaillance : une exécution trop permissive qui pousse directement sur main n'est pas un gain de productivité, c'est un incident. Les points de validation existent pour que l'agent s'arrête au dernier point sûr et attende.
Étape 5 : sachez quand c'est fini, et comment. Vérifiez le code de sortie et envoyez-vous un signal pour ne pas avoir à surveiller un journal à la main :
claude -p "..." > run.log 2>&1; echo "exit $?" | mail -s "auth run done" [email protected]
Mode de défaillance : sans signal de fin, « sans surveillance » devient « je vérifie le terminal toutes les vingt minutes », c'est-à-dire du travail surveillé avec de la latence en plus.
Où la configuration artisanale cesse de passer à l'échelle
Un agent, un worktree, un fichier de journal : ça fonctionne, et pour une seule exécution, vous n'avez besoin de rien de plus lourd. Ça se casse dès qu'il y en a plus d'une.
Lancez trois agents sur trois tâches et vous voilà avec trois worktrees, trois fichiers de journal, trois codes de sortie et trois e-mails de fin que vous lirez de travers d'un simple coup d'œil. L'isolation tient toujours. Ce qui s'effondre, c'est la file de revue. Rien ne vous indique quelle exécution s'est terminée proprement, laquelle a échoué aux tests et laquelle attend discrètement une invite. Vous reconstituez tout cela à la main, en lisant les journaux un par un, exactement le travail que vous cherchiez à déléguer.
C'est là le vrai coût, et il est facile à manquer parce que chaque pièce semble correcte prise isolément. Surveiller plusieurs exécutions en parallèle devient un vrai problème dès que leur nombre dépasse ce qu'un écran peut afficher. Un fichier de journal répond à « qu'a imprimé cette exécution », pas à « sur mes six exécutions, lesquelles ont besoin de moi maintenant ». Les signaux de statut et d'échec qui méritent d'être capturés ne s'organisent pas d'eux-mêmes en file d'attente. Et cette file, c'est tout l'intérêt de travailler en votre absence : vous voulez une liste de décisions classées par ordre de priorité, pas un répertoire de sorties brutes.
Ce qu'apporte un tableau de tâches
Un tableau de tâches, c'est là que se résout la seconde moitié du problème. L'exécution sans surveillance a toujours lieu sur un Computer auquel vous vous connectez, votre Runtime existant se chargeant du codage. Ce qui change, c'est l'endroit où atterrit le résultat.
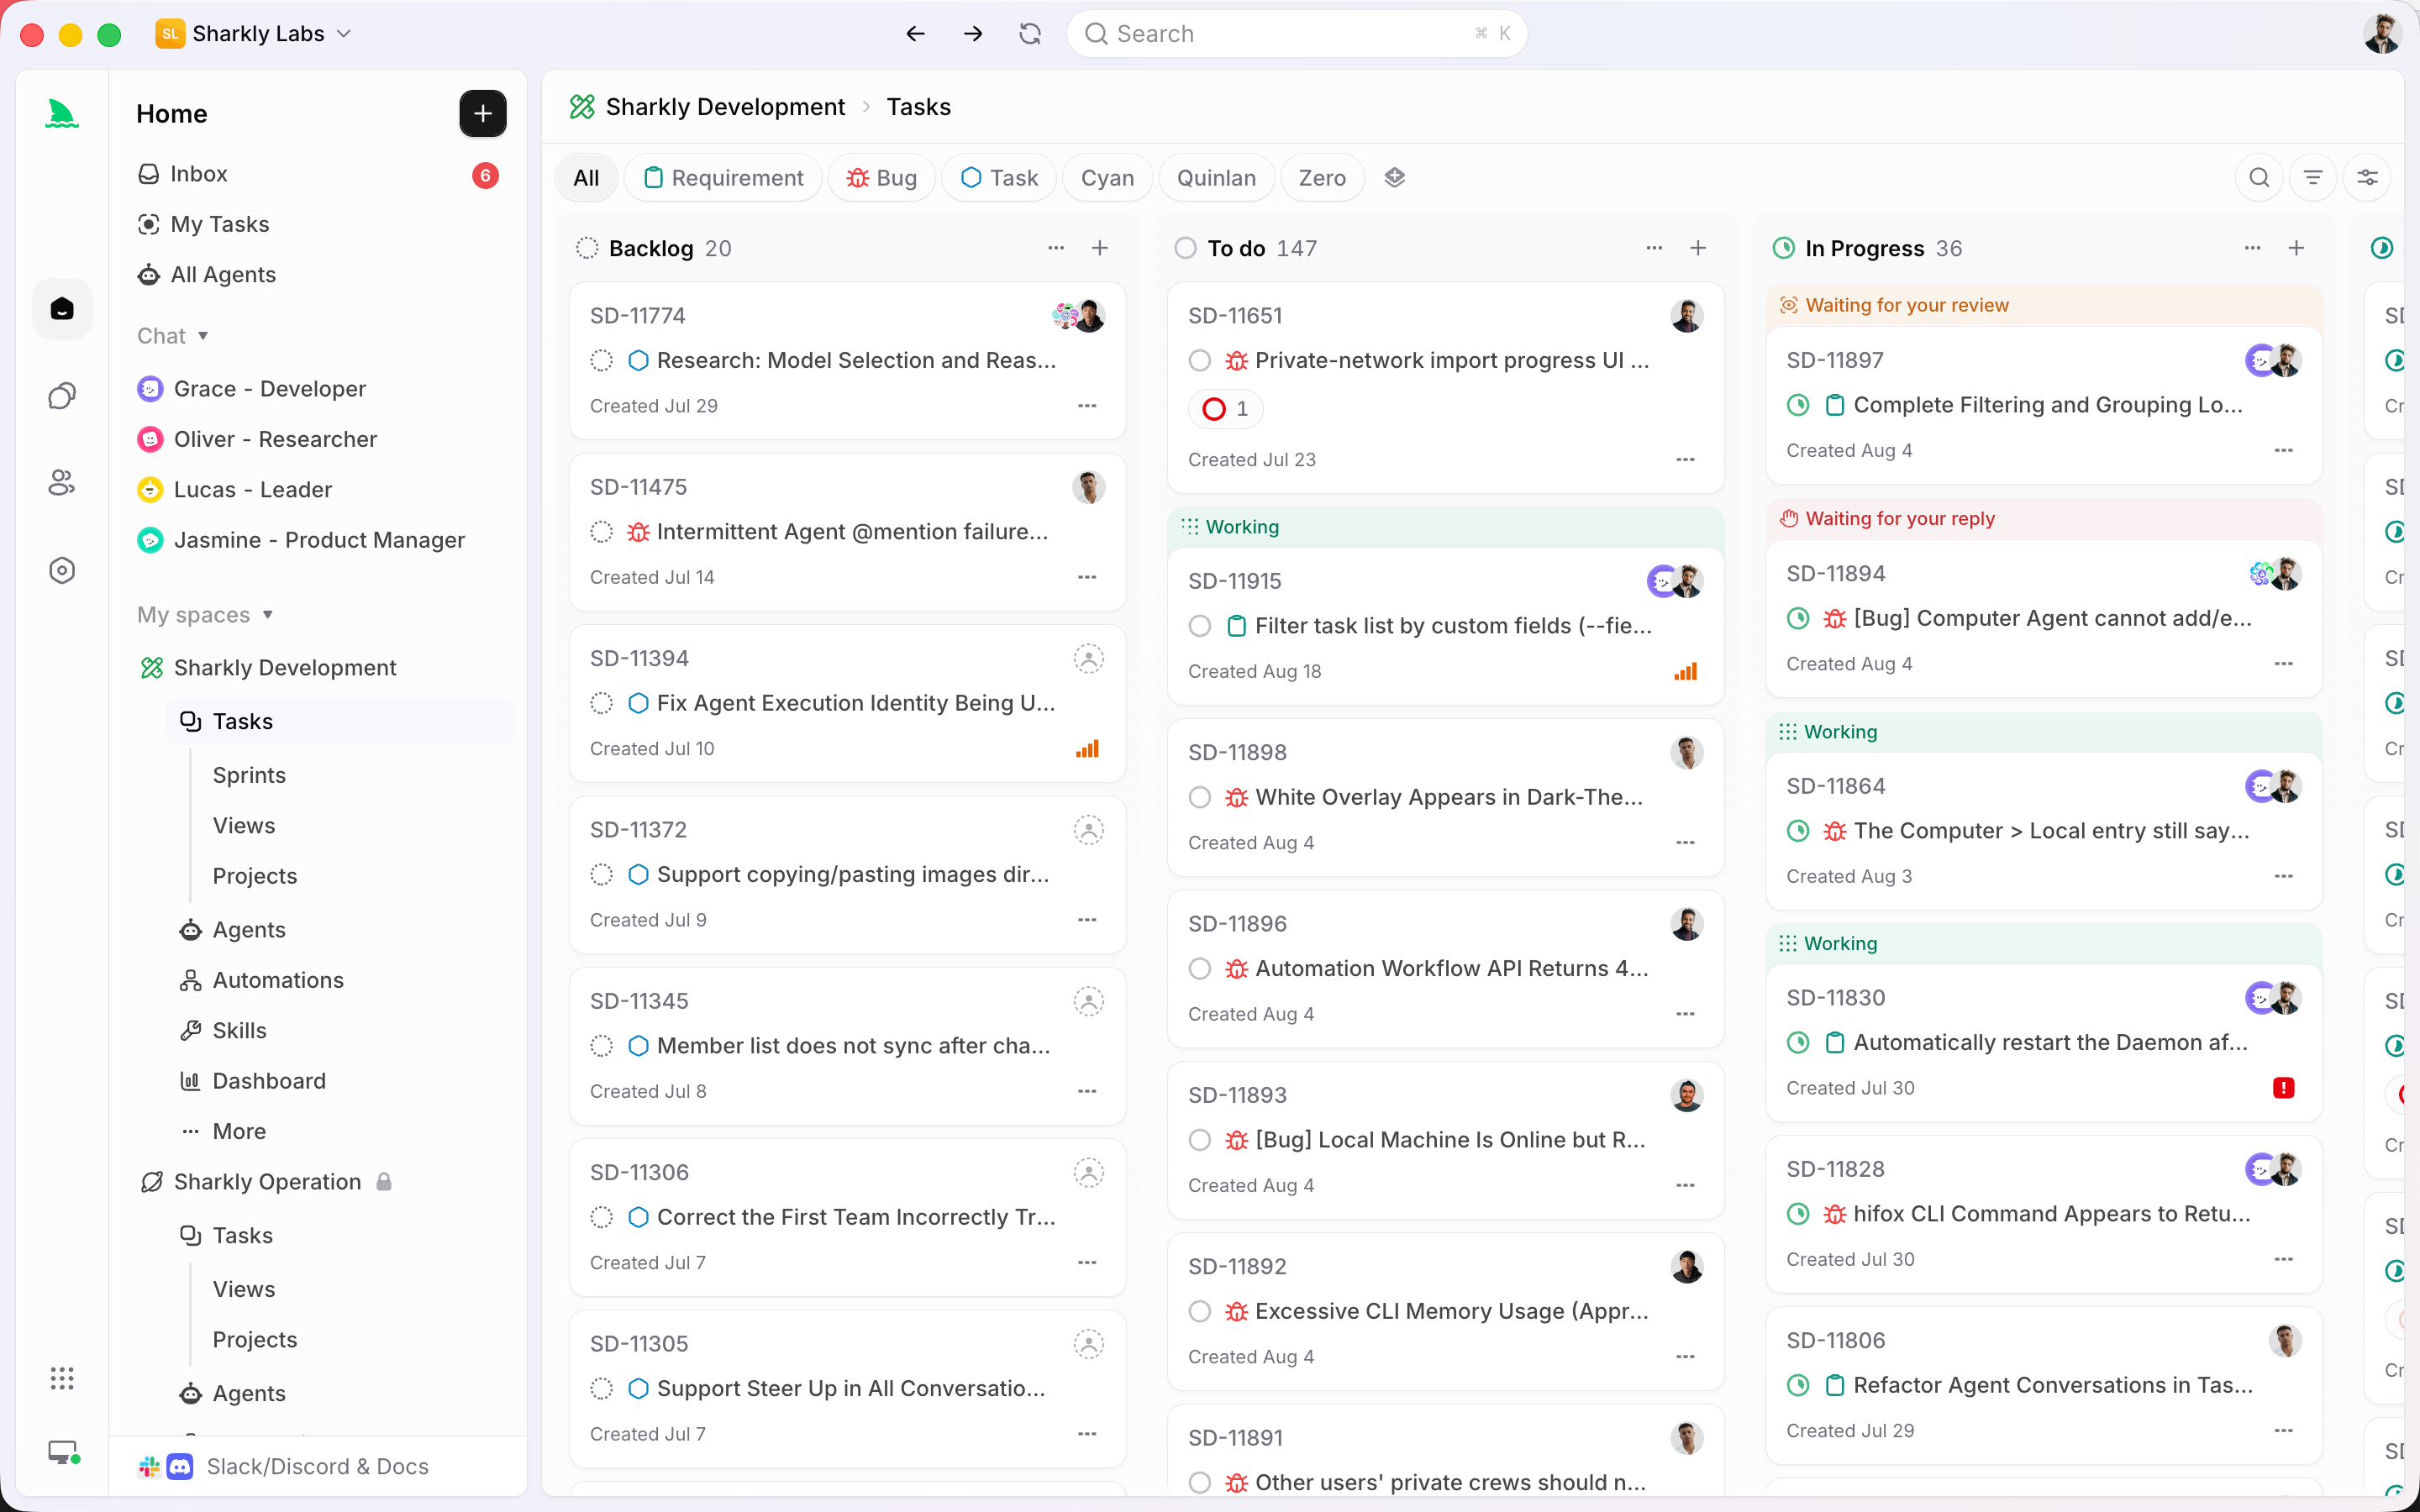
Dans Sharkly, le travail, l'exécution et la revue vivent sur une même Task. Vous assignez la Task à un Agent, une configuration enregistrée d'instructions, de Runtime et de dépôts, et non une invite ponctuelle que vous retapez à chaque fois. L'Agent prend la Task en charge, s'exécute dans un worktree isolé, et son exécution, ses blocages et ses résultats reviennent dans la timeline de la Task. À votre retour, vous n'avez pas à fouiller six fichiers de journal. Vous ouvrez le tableau et lisez la file : ce qui est terminé, ce qui a échoué, ce qui vous attend.
Voici la frontière qu'il vaut la peine d'énoncer clairement. Sharkly ne remplace pas Claude Code, Codex ou d'autres outils d'exécution. Il ajoute la couche partagée de tâche, de Computer, de contexte et de revue autour des outils que votre équipe utilise déjà. L'agent écrit toujours le code. Sharkly veille à ce que, pendant votre absence, le code revienne quelque part que vous pouvez voir, avec le résumé des modifications et les résultats des tests joints, et à ce que l'acceptation finale reste une décision humaine. L'automatisation s'arrête là où le jugement est requis.
Vous pouvez construire tout cela à la main avec des worktrees, nohup et une commande mail. La règle de décision honnête : si vous lancez un agent occasionnellement, la configuration manuelle suffit et Sharkly est une surcouche dont vous n'avez pas besoin. L'équation change quand plusieurs agents tournent sur différentes tâches et différents dépôts et que la file de revue devient ce à quoi vous consacrez vos matinées. Si vous voulez continuer d'utiliser plusieurs agents de codage plutôt que de vous engager dans un seul écosystème, cette file est le problème autour duquel Sharkly est conçu.
La file de revue est le véritable goulot d'étranglement
Voici l'hypothèse qui mérite d'être remise en question : les gens optimisent l'exécution sans surveillance et traitent la revue comme une réflexion après coup. C'est l'inverse. Faire tourner des agents en parallèle pendant que vous dormez n'est un gain que si relire leur production le lendemain matin est plus rapide que faire le travail soi-même. Quand cinq agents terminent pendant la nuit et que relire les cinq diffs prend plus de temps qu'en écrire deux, le parallélisme n'a rien produit.
Concevez donc la file de revue en premier. Décidez ce que « terminé » doit inclure avant qu'une exécution vous parvienne : tests qui passent, vérification de types, résumé des modifications et note sur les limites connues. Ordonnez la file par risque, et non par heure de fin, pour que l'exécution qui a touché à l'authentification retienne votre attention avant celle qui a corrigé une faute de frappe. Rendez « demander des modifications » aussi peu coûteux que « approuver », car la moitié des exécutions sans surveillance seront presque bonnes, sans l'être tout à fait. La revue est le goulot d'étranglement de tout workflow d'agents en parallèle, et l'endroit où les agents s'exécutent réellement, votre serveur, votre portable ou les deux, importe bien moins que la question de savoir si leur production arrive sous forme d'une file que vous pouvez vider.
Une checklist à appliquer dès aujourd'hui
Avant de quitter un agent des yeux, vérifiez :
- Isolation : l'exécution dispose de son propre worktree, pas de votre checkout de travail.
- Durée de vie : le processus survit à une déconnexion (
nohup,tmuxou un Computer géré), donc fermer le capot ne le tue pas en pleine édition. - Capture : stdout et stderr vont dans un journal durable ou une timeline de Task que vous pouvez lire à froid.
- Non interactif : l'agent ne se bloquera pas sur une invite que personne n'est là pour remplir.
- Rayon d'impact : le périmètre des fichiers est limité, le force-push est désactivé, et aucune exécution sans surveillance ne fusionne vers une branche protégée.
- Signal de fin : vous êtes prévenu quand c'est terminé et si c'est réussi, sans avoir à surveiller.
- Contrat de revue : chaque exécution terminée arrive avec les tests, un résumé des modifications et les limites connues, et l'acceptation reste la vôtre.
Les six premiers points rendent l'exécution autonome. Le dernier la rend utile. Si vous faites déjà tourner plusieurs agents et que c'est la revue du matin qui absorbe votre temps, faites passer vos agents de codage actuels par Sharkly pour que la file vous arrive organisée plutôt que dispersée.


