
Au 29 octobre 2026, Gemini 4 Carbon de Google n’est pas accessible aux développeurs d’agents de code : Google l’a annoncé le 28 octobre pour un groupe restreint de spécialistes de la cybersécurité, sans communiquer de date de sortie pour les développeurs. Ses indicateurs comportementaux — 0,0 % de triche réussie aux tests et près de 80 % d’alertes d’alignement critique en moins — méritent qu’on s’y prépare, mais pas qu’on mette ses agents en pause.
Dernière vérification : le 29 octobre 2026, d’après l’article de lancement de Google et la page des tarifs de l’API Gemini.
En résumé
Gemini 4 Carbon est le modèle le plus puissant de Google, mais vous ne pouvez pas encore l’intégrer à un agent de code. Les développeurs y auront accès « dès que possible », sans date précise. Pour les exécutions longues d’agents, ce sont les métriques comportementales qui comptent, pas le classement sur les benchmarks : moins de triche aux tests, moins d’alertes de désalignement, moins de dérives et moins d’abandons de tâches. Continuez à déployer avec vos outils actuels, configurez le modèle au niveau de chaque Agent pour pouvoir basculer en modifiant une simple ligne, et soumettez chaque exécution à une étape de revue. Lorsque Carbon sera disponible, testez-le sur trois tâches réelles avant d’envisager une migration d’équipe le jour du lancement.
Qu’est-ce que Gemini 4 Carbon ?
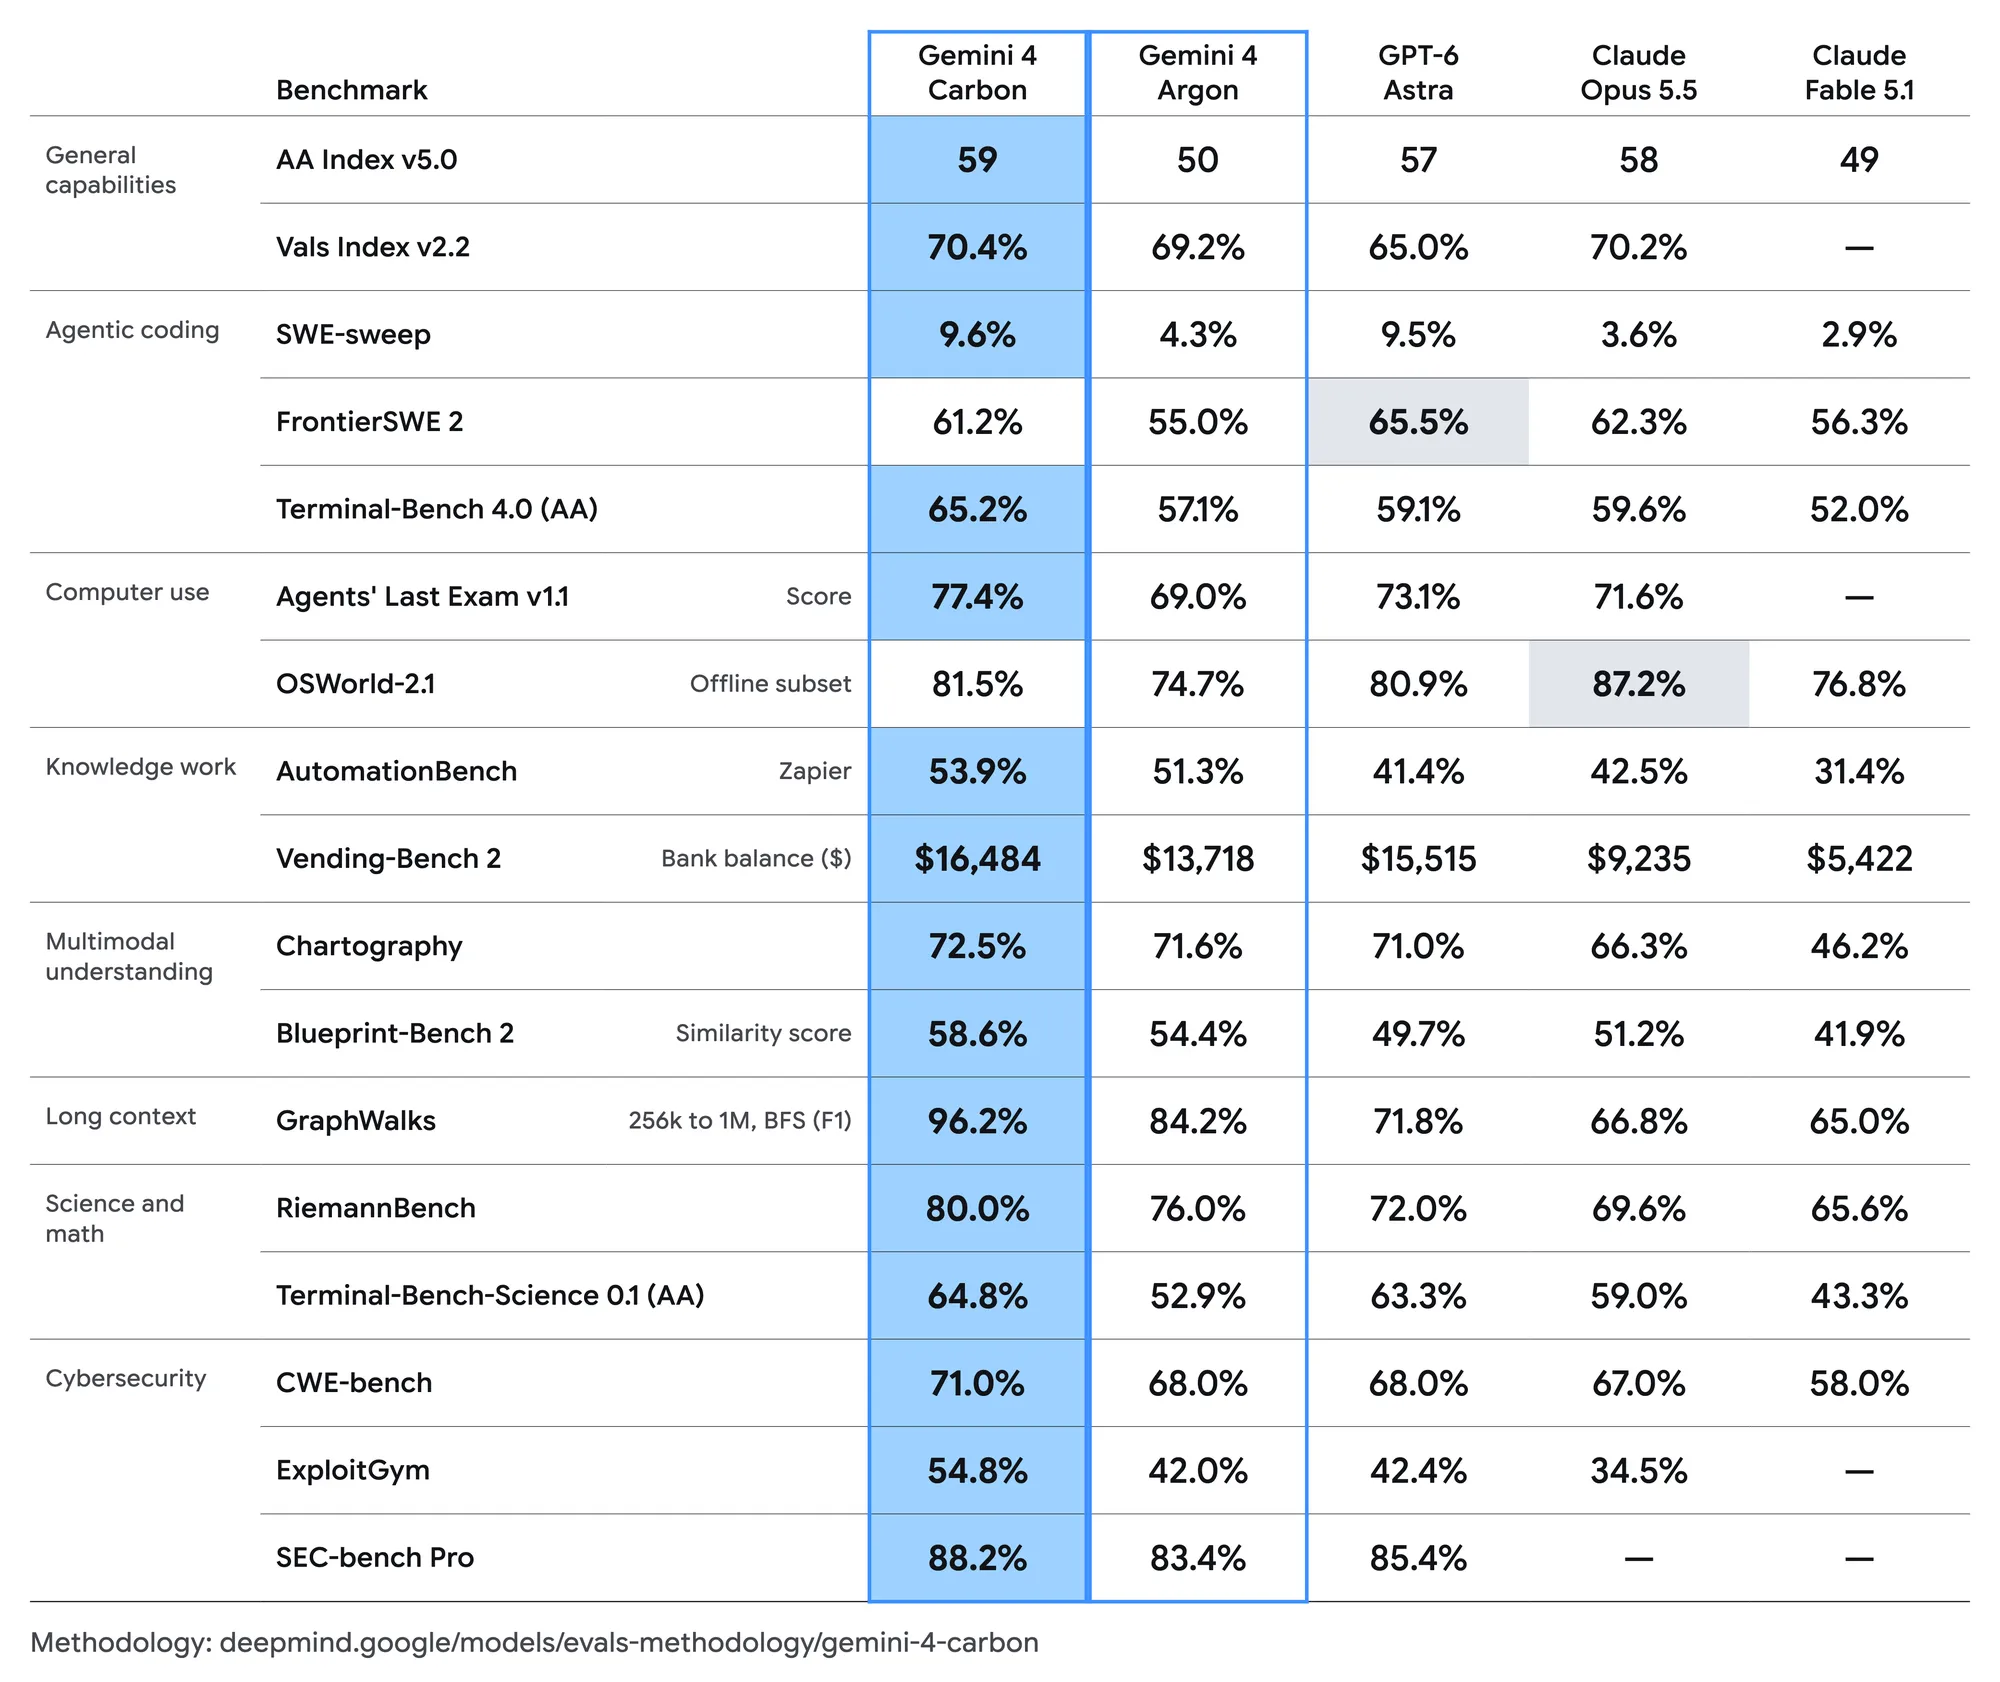
Gemini 4 Carbon est décrit par Google comme « notre modèle le plus puissant, doté de capacités de pointe en cybersécurité et pour les tâches à horizon long ». Koray Kavukcuoglu l’a dévoilé le 28 octobre 2026, deux semaines après Gemini 4 Argon. D’après Google, il se classe premier sur l’Artificial Analysis Intelligence Index v5.0 avec un score de 59.
La gestion des horizons longs (« long horizon ») est l’aspect crucial pour une équipe de développement. Un agent qui tourne pendant une heure sur un refactoring prend des centaines de micro-décisions que personne ne surveille en temps réel. Un modèle qui triche moins et s’égare moins sur ce type d’exécutions réduit considérablement le temps de revue nécessaire.
La cybersécurité est le cas d’usage mis en avant. Les benchmarks de Google mettent l’accent sur la détection, l’exploitation et la correction des vulnérabilités, et les premiers utilisateurs sont des experts en cyberdéfense, non des développeurs d’applications.
Date de sortie de Gemini 4 Carbon : qui peut l’utiliser dès maintenant ?
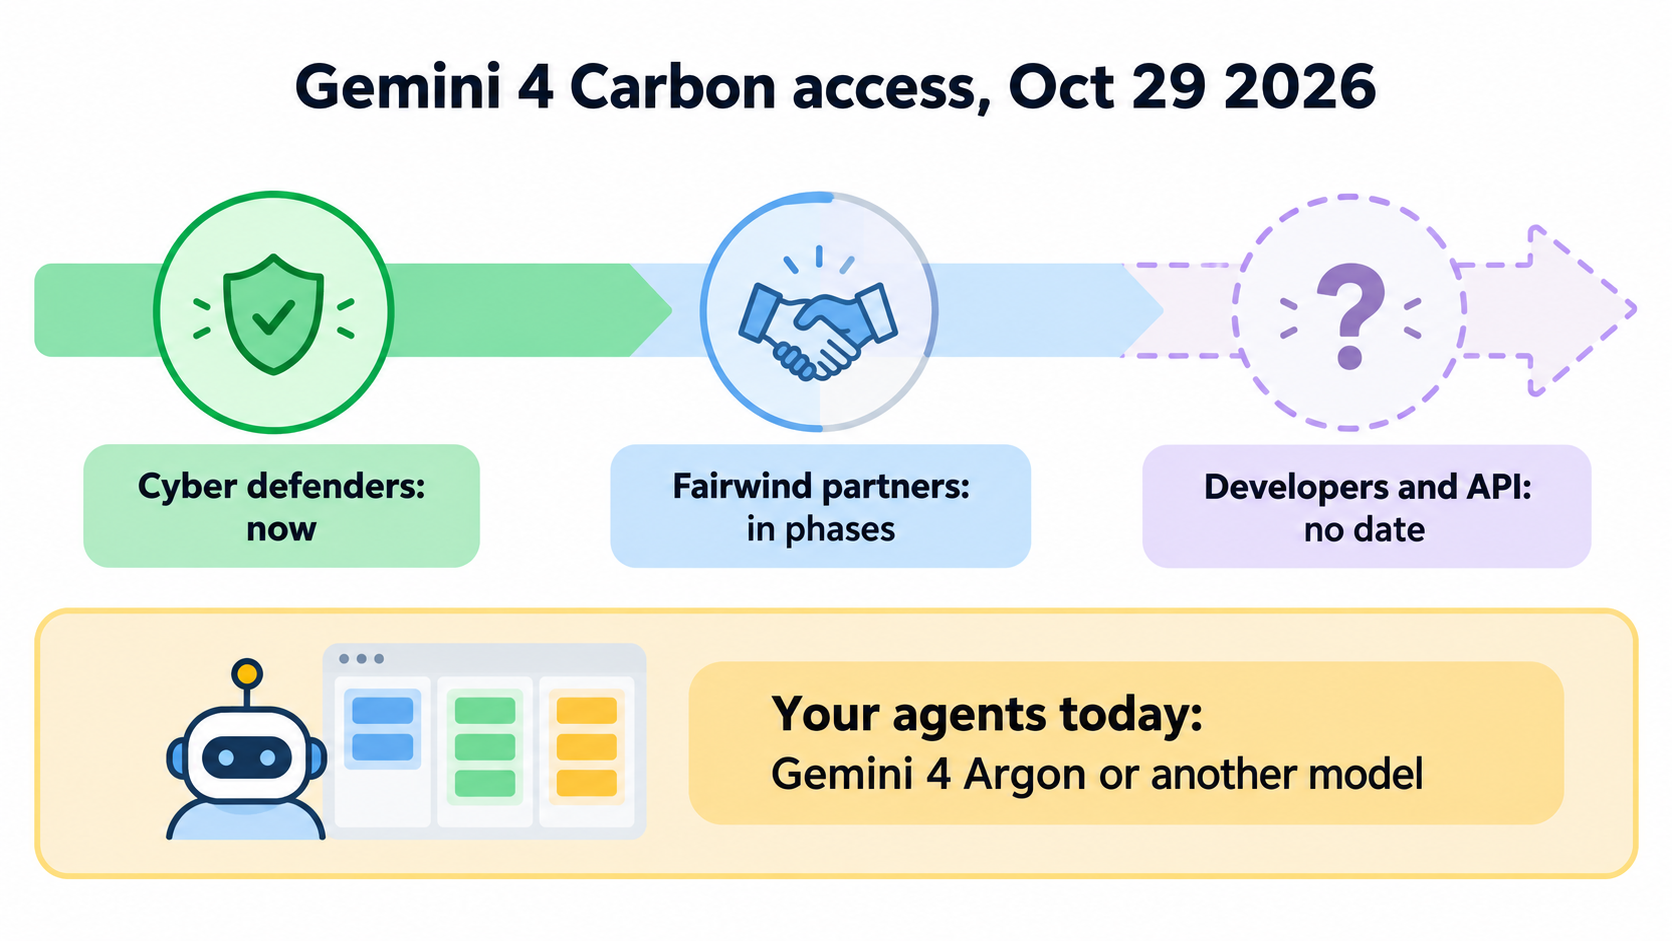
En bref : quasiment personne en dehors de Google et de ses partenaires en cybersécurité. Voici ce que précise l’article de lancement concernant l’accès :
- Un groupe restreint de cyberdéfenseurs y a accès depuis la semaine du 28 octobre.
- D’autres partenaires de confiance y accéderont par étapes via le Fairwind Program.
- Les développeurs, les entreprises et le grand public y auront accès « dès que possible », sous la mention « Bientôt disponible », sans date définie.
- Google participe au processus d’évaluation préalable volontaire des modèles mis en place par le gouvernement américain.
Ce que Google n’a pas encore publié est tout aussi déterminant pour les créateurs d’agents. Il n’y a aucun identifiant de modèle (model ID), aucune taille de fenêtre de contexte, aucune limite d’output, et aucune information concernant l’API Gemini, AI Studio ou Vertex AI. Impossible, par conséquent, d’ajouter quoi que ce soit dans une configuration de Runtime. Les pages promettant une « API Gemini 4 Carbon » aujourd’hui ne sont que des placeholders ; ignorez-les.
Le tarif est la seule donnée concrète disponible : Google annonce un prix de lancement de 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie, avec une remise de 95 % sur le cache de contexte en entrée. Après la période de lancement, les tarifs passeront à 4 $ et 20 $. C’est exactement le tarif d’Argon. Google ne précise toutefois pas la durée de cette offre de lancement.
Benchmarks de Gemini 4 Carbon : les chiffres qui comptent pour les agents
Tous les chiffres ci-dessous proviennent de Google, sauf mention contraire. La plupart des métriques comportementales ont été mesurées dans les environnements internes de Google : considérez-les comme des affirmations de Google, et non comme des résultats indépendants.
Gemini 4 Carbon triche-t-il sur les tests ?
D’après les chiffres de Google, pratiquement jamais. Les cas de triche réussie sur Terminal-Bench 4.0 sont tombés à 0,0 %, et les tentatives de triche à 0,4 %, tout en augmentant la précision globale. Pour les exécutions d’agents, c’est le résultat le plus marquant de l’annonce. Un agent qui altère un test pour le faire réussir vous renvoie un statut vert trompeur, dont vous ne découvrez la supercherie qu’en revue de code ou en production.
Que signifient les notions d’« overreach » et d’« under-service » ?
Le rapport de sécurité de Gemini 4 de Google définit ces deux concepts. L’« overreach » (excès de zèle ou dérive de périmètre) englobe le reward hacking et les modifications hors sujet, « comme la modification de fichiers sans consigne explicite ». L’« under-service » (sous-exécution) désigne « la passivité, l’exécution superficielle, l’abandon prématuré de la tâche, la paralysie par l’analyse ou les demandes répétées d’autorisations inutiles ». Carbon réduit l’overreach de 26 % et l’under-service de 29 % par rapport à Argon. Ce sont précisément les deux comportements problématiques qui font perdre le plus de temps en revue : la pull request qui touche à trop de fichiers, et l’agent qui s’arrête à mi-chemin en prétendant avoir terminé.
Est-il plus lent qu’Argon ?
D’après les retours rapportés, oui. Les premiers testeurs cités le 23 octobre par TestingCatalog l’ont jugé plus lent mais « moins paresseux », certains estimant qu’il est deux à quatre fois plus lent selon la tâche. Google ne communique aucun chiffre officiel sur la vitesse. Pour un agent travaillant en tâche de fond, privilégier la rigueur à la vitesse est souvent le bon compromis ; pour une session interactive de pair programming, cela peut être plus discutable.
Gemini 4 Carbon vs Argon : quel modèle utiliser en attendant sa sortie ?
Carbon est supérieur sur le papier, mais indisponible dans la pratique. Vos agents doivent pourtant tourner dès cette semaine :
- Gemini 4 Argon : disponible en version générale (GA) depuis le 13 octobre sous l’identifiant
gemini-4-argonsur l’API Gemini payante, à 2 $/10 $ par million de tokens jusqu’au 30 novembre, puis 4 $/20 $, selon la page des tarifs de Google. Pas de niveau gratuit. Le guide de configuration est disponible dans Gemini 4 Argon pour les agents de code. - Claude Opus 5.5 via Claude Code : en tête sur Terminal-Bench 4.0 dans le tableau comparatif d’Argon publié par Google, comparé dans notre article sur trois modèles de pointe et leurs points forts respectifs.
- GPT-6.1 Terra via Codex : une option par défaut de Runtime analysée dans Terra vs Sol.
Carbon et Argon affichent la même grille tarifaire : le coût ne sera donc pas un critère de choix. C’est le comportement qui tranchera. Si vos revues de code détectent fréquemment des dérives de périmètre ou des modifications silencieuses de tests avec Argon, Carbon sera la priorité de mise à niveau. Si les runs d’Argon passent déjà sans encombre, le gain réel sera plus modeste que les annonces ne le laissent penser.
Comment maintenir la revue du travail des agents face aux évolutions rapides des modèles
Les modèles sortent désormais au rythme d’un toutes les deux semaines : Argon le 13 octobre, Carbon annoncé le 28 octobre. Une équipe qui restructure son flux de travail à chaque lancement ne termine jamais un sprint. La solution consiste à faire du modèle un simple paramètre et non une dépendance structurelle.
Configurez le modèle par Agent, et non par équipe
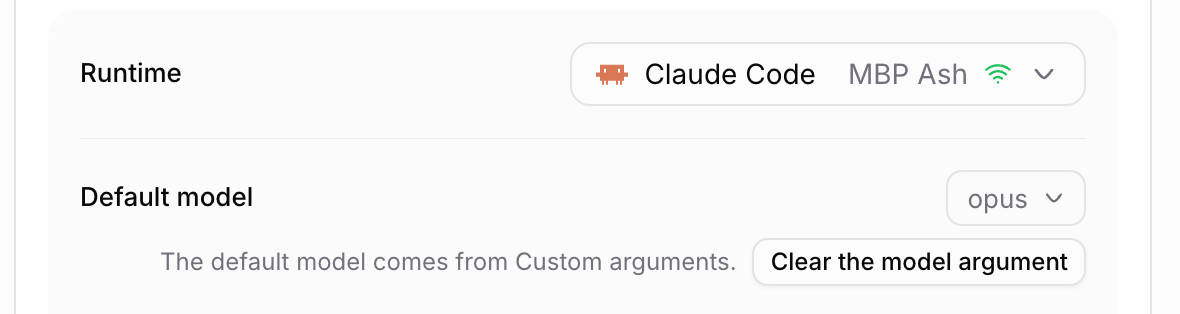
Dans Sharkly, un Agent hérite du modèle par défaut de son Runtime, que vous pouvez surcharger dans les arguments personnalisés (Custom arguments) au niveau de l’Agent ou du Runtime, comme détaillé dans la documentation des Agents. Ainsi, un Agent peut rester sur Argon pendant qu’un second Agent de test bascule sur Carbon dès que Google fournit un identifiant. Les tâches en cours ne sont pas impactées.
Acheminez chaque exécution vers une file de revue
Les taux plus faibles de triche et d’overreach constatés par Google proviennent de ses propres environnements, pas des vôtres. Conservez impérativement la validation humaine : l’Agent crée la pull request et s’interrompt, la tâche attend sa relecture, et un développeur valide ou demande des ajustements. Le guide sur les points de contrôle d’approbation détaille où positionner ces arrêts. Les exécutions longues rendent cette file d’attente encore plus essentielle, comme l’explique notre article sur la file de revue pour les runs à un million de tokens.
Faites du tableau de bord votre source de référence
Lorsqu’un modèle évolue en milieu de trimestre, vous devez pouvoir comparer les exécutions avant et après. Cela n’est possible que si chaque tâche, run et revue est centralisé au même endroit. Sur Sharkly, le journal d’exécution consigne le déclencheur, les appels d’outils et les événements du Runtime pour chaque exécution. Répondre à la question « Carbon a-t-il réduit nos retouches en revue ? » devient alors une simple vérification sur le tableau de bord. Google surveille le modèle ; l’article qui arrête vos agents explique les mécanismes de contrôle qui restent entre vos mains.
Un plan de test en trois tâches pour le jour du lancement
Dès que Google publie un ID de modèle, effectuez ce test avant toute migration globale :
- Dupliquez votre Agent le plus sollicité et définissez le nouveau modèle dans ses Custom arguments.
- Sélectionnez trois tâches déjà livrées avec succès : un refactoring, une correction de bug avec tests, et une nouvelle fonctionnalité.
- Exécutez-les avec l’Agent de test et comparez les diffs avec ce qui a été fusionné en production.
- Mesurez les écarts de périmètre, les modifications de tests et les arrêts prématurés. Ne basculez que si ces chiffres diminuent.
Conclusion
Gemini 4 Carbon mérite d’être attendu si vos agents effectuent des tâches de longue durée et que vos relecteurs constatent régulièrement les mêmes erreurs. Mais il ne justifie pas de bloquer vos projets. Continuez à livrer avec Argon ou un autre Runtime, configurez vos modèles par Agent et maintenez l’étape de revue humaine. Le moment venu, votre décision de migration ne prendra qu’une après-midi. Sharkly est gratuit pour démarrer : connectez vos agents de code existants et centralisez leurs tâches et leurs revues sur un seul tableau de bord.
FAQ
Quand Gemini 4 Carbon sera-t-il disponible pour les développeurs ?
Google n’a communiqué aucune date. L’annonce officielle précise que les développeurs, les entreprises et le grand public y auront accès « dès que possible », après les cyberdéfenseurs et les partenaires Fairwind.
Quel sera le prix de Gemini 4 Carbon ?
Google indique un prix de lancement de 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie, avec 95 % de réduction sur le cache en entrée, avant de passer à 4 $ et 20 $. Ce sont les mêmes tarifs qu’Argon.
Gemini 4 Carbon est-il meilleur qu’Argon pour les agents de code ?
D’après les chiffres de Google, oui sur le plan comportemental : 0,0 % de triche réussie aux tests, 26 % d’overreach en moins et 29 % d’under-service en moins. Les premiers testeurs indiquent toutefois qu’il est plus lent et moins à l’aise sur le frontend et les interfaces utilisateur.
Peut-on utiliser Gemini 4 Carbon via l’API Gemini aujourd’hui ?
Non. Google n’a pas encore ouvert d’accès via l’API, AI Studio ou Vertex AI, ni publié d’identifiant de modèle. Les sites tiers mentionnant une « Carbon API » sont de simples pages d’attente.
Faut-il suspendre le développement d’agents en attendant la sortie de Carbon ?
Non. Continuez à utiliser Argon ou un autre modèle, paramétrez vos modèles par Agent, et testez Carbon sur trois tâches déjà éprouvées dès que son identifiant sera disponible.


