
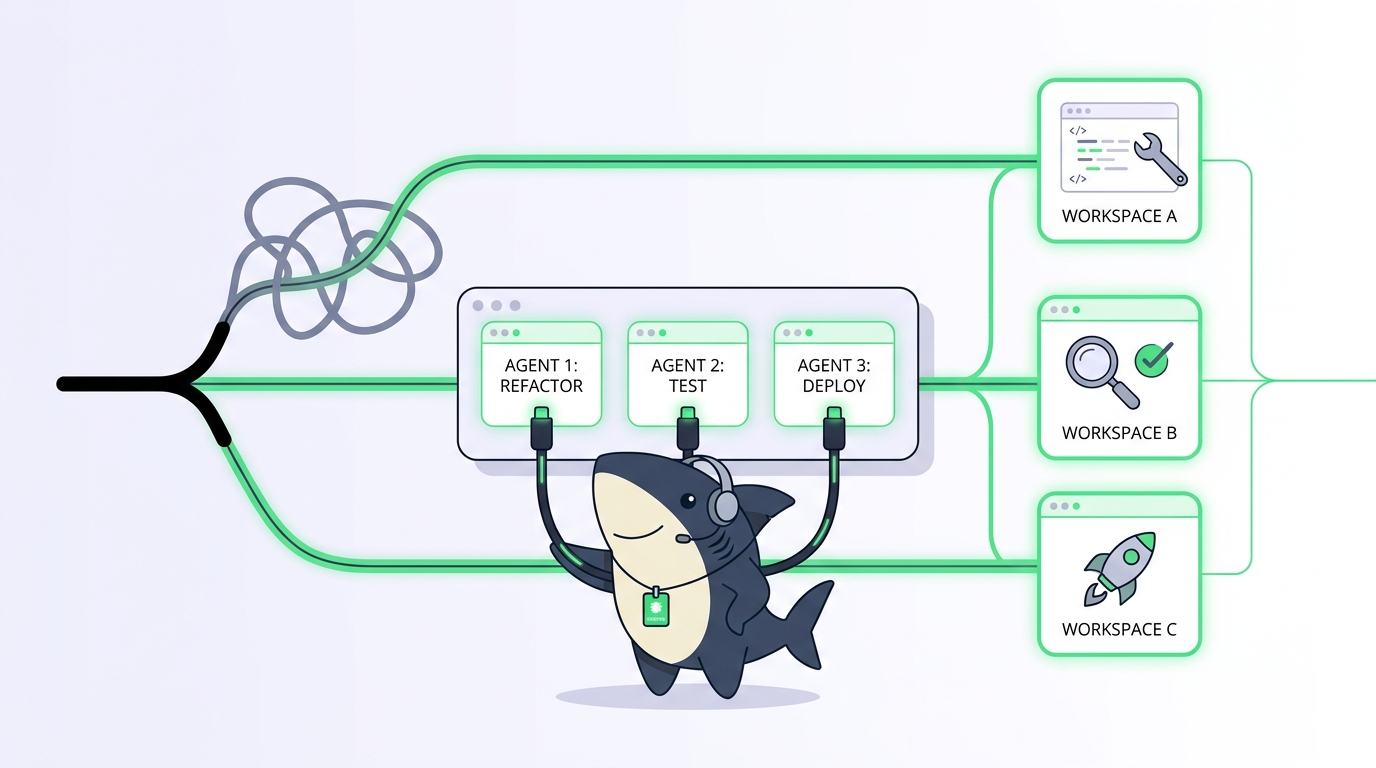
Pointez deux agents de codage IA sur le même checkout et ils finiront par vous gâcher une après-midi entière. L'un réécrit un fichier que l'autre est en train de modifier. L'un change de branche sous les pieds de l'autre. Les deux lancent npm install sur le même node_modules et vous laissent un lockfile que personne n'a écrit. La panne reste silencieuse, jusqu'au moment où elle ne l'est plus, et vous voilà en train de faire un bisect d'un chaos qu'aucun des deux agents ne sait expliquer.
Les worktrees Git sont la solution standard. Un worktree donne à chaque agent son propre répertoire de travail et sa propre branche extraite, le tout adossé à un dépôt partagé : le travail en parallèle cesse de se télescoper. Ce guide passe en revue les vraies commandes, les pièges qui mordent en pratique et la discipline de nettoyage dont personne ne vous parle. Il montre ensuite à partir de quand les scripts de worktree faits maison cessent de passer à l'échelle, et comment Sharkly exécute chaque Task dans son propre worktree automatiquement, afin que les résultats reviennent dans un enregistrement partagé au lieu de se disperser entre les terminaux.
Si vous ne faites tourner qu'un seul agent, vous n'avez pas encore besoin de tout cela. Dès que vous en lancez deux, l'isolation cesse d'être facultative.
TL;DR
Un worktree git est un second répertoire de travail rattaché au même dépôt, avec sa propre branche et son propre index. Donnez à chaque agent de codage IA son propre worktree : ils peuvent alors modifier, compiler et tester en parallèle sans s'écraser mutuellement ni se disputer la branche courante. Les commandes sont simples ; c'est le coût opérationnel (installations par worktree, nettoyage, disque, coordination) qui grimpe. Sharkly absorbe ce coût en préparant automatiquement un worktree isolé pour chaque Task et en renvoyant chaque résultat à la Task pour relecture.
Pourquoi un seul checkout ne peut pas héberger deux agents
Un checkout git classique possède exactement un répertoire de travail, un index et un HEAD. C'est parfait pour une personne qui fait une seule chose. Cela s'effondre dès que deux agents travaillent en même temps, car ces trois éléments constituent un état partagé.
Imaginez deux agents sur le même dépôt. L'agent A refactorise le module d'authentification sur une branche nommée auth-refactor. On demande à l'agent B de corriger un bug de journalisation et il lance git checkout -b fix-logging. Cette simple commande déplace le HEAD de tout le checkout. Les modifications non commitées de l'agent A se retrouvent empilées sur la mauvaise branche, son prochain commit atterrit au mauvais endroit et sa compilation se met à échouer pour des raisons qu'il va passer vingt minutes à « déboguer ». Rien n'a planté. L'état est simplement devenu faux, en silence.
Avec les fichiers, c'est encore pire. Les deux agents partagent un seul répertoire de travail : quand l'agent B régénère un fichier de configuration ou relance un formateur, les modifications en cours de l'agent A sont écrasées sur le disque. Les agents de codage n'ont aucune représentation mentale du fait que « l'autre est en train de travailler sur quelque chose ». Ils lisent le fichier, agissent, puis le réécrivent. Deux écritures, un fichier, aucun verrou. Vous obtenez le classique problème de mise à jour perdue, à ceci près que les auteurs sont autonomes et rapides.
C'est la douleur qui fait remonter sans cesse le mot-clé « git worktrees ». Les gens ne cherchent pas « worktrees » parce que les branches les passionnent. Ils cherchent parce qu'ils ont essayé de lancer des agents en parallèle et s'y sont brûlés. Si c'est votre cas, le volet exécution parallèle est traité en profondeur dans notre guide sur l'exécution de plusieurs agents Claude Code en parallèle ; le présent article porte sur la primitive d'isolation qui se trouve en dessous.
Ce qu'est réellement un worktree git
Voici la définition, celle qui vaut la peine d'être mémorisée :
Un worktree git est un répertoire de travail supplémentaire lié au même dépôt, avec sa propre branche extraite, son propre index et son propre HEAD, le tout partageant une base d'objets unique.
Tout le tour de passe-passe tient dans cette dernière proposition. Un worktree n'est pas un clone. Un clone duplique l'intégralité du dépôt d'objets : chaque commit, chaque blob, chaque tag copié dans un second .git. Les worktrees partagent un seul dépôt d'objets et n'ajoutent qu'un second répertoire de travail léger. Vos commits sont visibles depuis tous les worktrees dès qu'ils sont créés, puisqu'il n'existe qu'une seule histoire en dessous. Ce qui diffère d'un worktree à l'autre, c'est l'extraction : quelle branche est sortie, ce qui est indexé, ce qui est modifié sur le disque.
Pour les agents, cela correspond parfaitement au problème. Chaque agent reçoit un worktree. Chaque worktree a sa propre branche et ses propres fichiers. Ils ne peuvent pas s'écraser mutuellement puisqu'ils se trouvent littéralement dans des répertoires différents, et ils ne peuvent pas tirer la branche sous les pieds de l'autre puisque chaque worktree épingle son propre HEAD. Les conflits reviennent là où ils ont leur place : au moment du merge, volontairement, sous relecture — et non en pleine édition, par accident.
Les commandes worktree que vous utiliserez vraiment
Partez d'un dépôt normal. Toutes les commandes ci-dessous s'exécutent depuis l'intérieur de celui-ci.
Créer un worktree avec une nouvelle branche. C'est celle que vous utiliserez le plus souvent :
git worktree add -b fix-logging ../myproject-fix-logging main
Cela crée un répertoire dans ../myproject-fix-logging, crée une nouvelle branche fix-logging à partir de main et l'extrait à cet endroit. Pointez un agent vers ce répertoire : il dispose d'un espace de travail propre et isolé.
Créer un worktree pour une branche existante :
git worktree add ../myproject-auth auth-refactor
Lister ce qui est ouvert :
git worktree list
/Users/you/myproject              9f3c1a2 [main]
/Users/you/myproject-fix-logging  9f3c1a2 [fix-logging]
/Users/you/myproject-auth         3b7e0d4 [auth-refactor]
Une ligne par worktree, avec son chemin, le commit extrait et la branche. Quand vous pilotez une flotte d'agents, cette liste est votre référence pour savoir qui est où.
Supprimer un worktree quand le travail est fusionné ou abandonné :
git worktree remove ../myproject-fix-logging
Élaguer les métadonnées obsolètes après avoir supprimé un répertoire de worktree à la main (les agents et les scripts le font plus souvent que vous ne le souhaiteriez) :
git worktree prune
Voilà toute la surface d'API. Cinq commandes. La difficulté n'est pas là.
Les pièges qui mordent vraiment
Les commandes sont simples. C'est la réalité opérationnelle qui engloutit les après-midis. Voici les modes de défaillance qui apparaissent dès que de vrais agents tournent dans de vrais worktrees.
Les fichiers non suivis et ceux listés dans gitignore ne suivent pas. Un worktree extrait les fichiers suivis à la branche que vous avez demandée. Il ne copie ni vos node_modules, ni votre .env, ni votre venv, ni votre cache de build, ni rien d'autre que git ignore. Un worktree tout neuf pour un projet Node n'est donc pas exécutable tant que vous n'y avez pas lancé l'installation. Chaque worktree paie sa propre installation de dépendances, son propre fichier d'environnement, sa propre compilation. Les agents qui partent du principe que « le dépôt est déjà prêt » échoueront à leur première commande dans un nouveau worktree tant que vous ne gérez pas explicitement la préparation.
Impossible d'extraire deux fois la même branche. Git refuse qu'une même branche soit extraite dans deux worktrees à la fois, et il a raison. Si deux agents ont tous les deux besoin de main extraite, l'un des deux doit créer une branche. C'est une fonctionnalité, pas une limite, mais cela surprend ceux qui s'attendaient à des copies totalement indépendantes.
Le disque se remplit vite. Le stockage d'objets est partagé, donc l'historique ne coûte presque rien. Les répertoires de travail et leurs installations, eux, coûtent cher. Dix worktrees d'un projet avec 900 Mo de node_modules, c'est 9 Go de dépendances dupliquées. Sur un portable qui fait tourner quelques agents, vous le sentez dès le déjeuner.
Les worktrees sales résistent à la suppression. git worktree remove refuse si le worktree contient des modifications non commitées, ce qui vous protège de la suppression d'un travail qu'un agent n'a pas terminé. Quand vous voulez vraiment le supprimer : git worktree remove --force. Mais c'est désormais à vous de décider, à la main et pour chaque worktree, si ce travail non commité avait de l'importance.
Les répertoires supprimés laissent des fantômes. Supprimez un dossier de worktree avec rm -rf et git continuera de le lister jusqu'à ce que vous lanciez git worktree prune. Les scripts qui créent des worktrees plus vite qu'ils ne les nettoient accumulent des entrées obsolètes, et ces entrées retiennent des verrous qui empêchent de réutiliser des noms de branche. Le nettoyage n'est pas facultatif ; il est simplement facile à oublier, jusqu'à ce que git worktree list ressemble à un cimetière.
Les caches imbriqués des agents ne sont pas à vous de supprimer. Certains runtimes conservent leurs propres caches de worktrees, par exemple sous ~/.claude/worktrees. Ne pointez pas vos scripts de nettoyage vers ceux-ci. Laissez l'outil propriétaire du cache le gérer.
Pris isolément, aucun de ces points n'est difficile. Le problème, c'est qu'ils se cumulent. Deux worktrees, vous les gérez à la main. Cinq, vous écrivez un script. Douze agents en cours sur deux dépôts, et le script devient un petit morceau d'infrastructure avec ses propres bugs — dont vous êtes l'astreinte.
À partir de quand les scripts ne passent plus à l'échelle
Voici la trajectoire, sans enjoliver. Vous commencez par une fonction shell qui encapsule git worktree add, place un agent dans le nouveau répertoire et lance la préparation. Ça marche. Vous ajoutez une convention de nommage pour éviter les collisions de répertoires. Vous ajoutez une commande de nettoyage. Puis les exigences s'empilent.
Vous voulez savoir quel agent se trouve dans quel worktree à cet instant, et dans quel état est sa branche. Votre git worktree list ne connaît pas les agents ; il connaît des répertoires. Vous bricolez un fichier de correspondance. Vous voulez que les installations de dépendances par worktree ne mettent pas votre disque à genoux, alors vous ajoutez de la logique de cache. Vous voulez que la sortie d'un agent, son diff et ses résultats de tests atterrissent quelque part où un humain peut les relire, au lieu de rester prisonniers d'un terminal qui se ferme. Vous voilà en train d'écrire un collecteur de résultats. Vous voulez que deux agents ne prennent pas la même tâche dans la file. Vous voilà en train d'écrire un verrou.
À un moment donné, vous avez réimplémenté une couche d'orchestration à coups de scripts shell, et personne n'est chargé de la maintenir. C'est exactement la faille sur laquelle se joue la discussion sur les alternatives à vibe kanban, et c'est pourquoi les équipes se tournent vers une véritable couche de gestion dès que le nombre d'agents franchit un seuil. Le worktree n'a jamais été la partie difficile. Ce qui l'est, c'est de coordonner de nombreuses exécutions isolées et de ramener leurs résultats au même endroit.
Comment Sharkly exécute chaque Task dans son propre worktree
Sharkly est une plateforme tout-en-un de pilotage et de gestion d'agents. Elle ne remplace pas Claude Code, Codex ni les autres outils d'exécution que vos agents utilisent déjà ; elle ajoute autour d'eux une couche partagée de Tasks, de Computers, de contexte et de relecture. L'isolation par worktree est intégrée à cette couche, pour que vous cessiez de la bricoler vous-même.
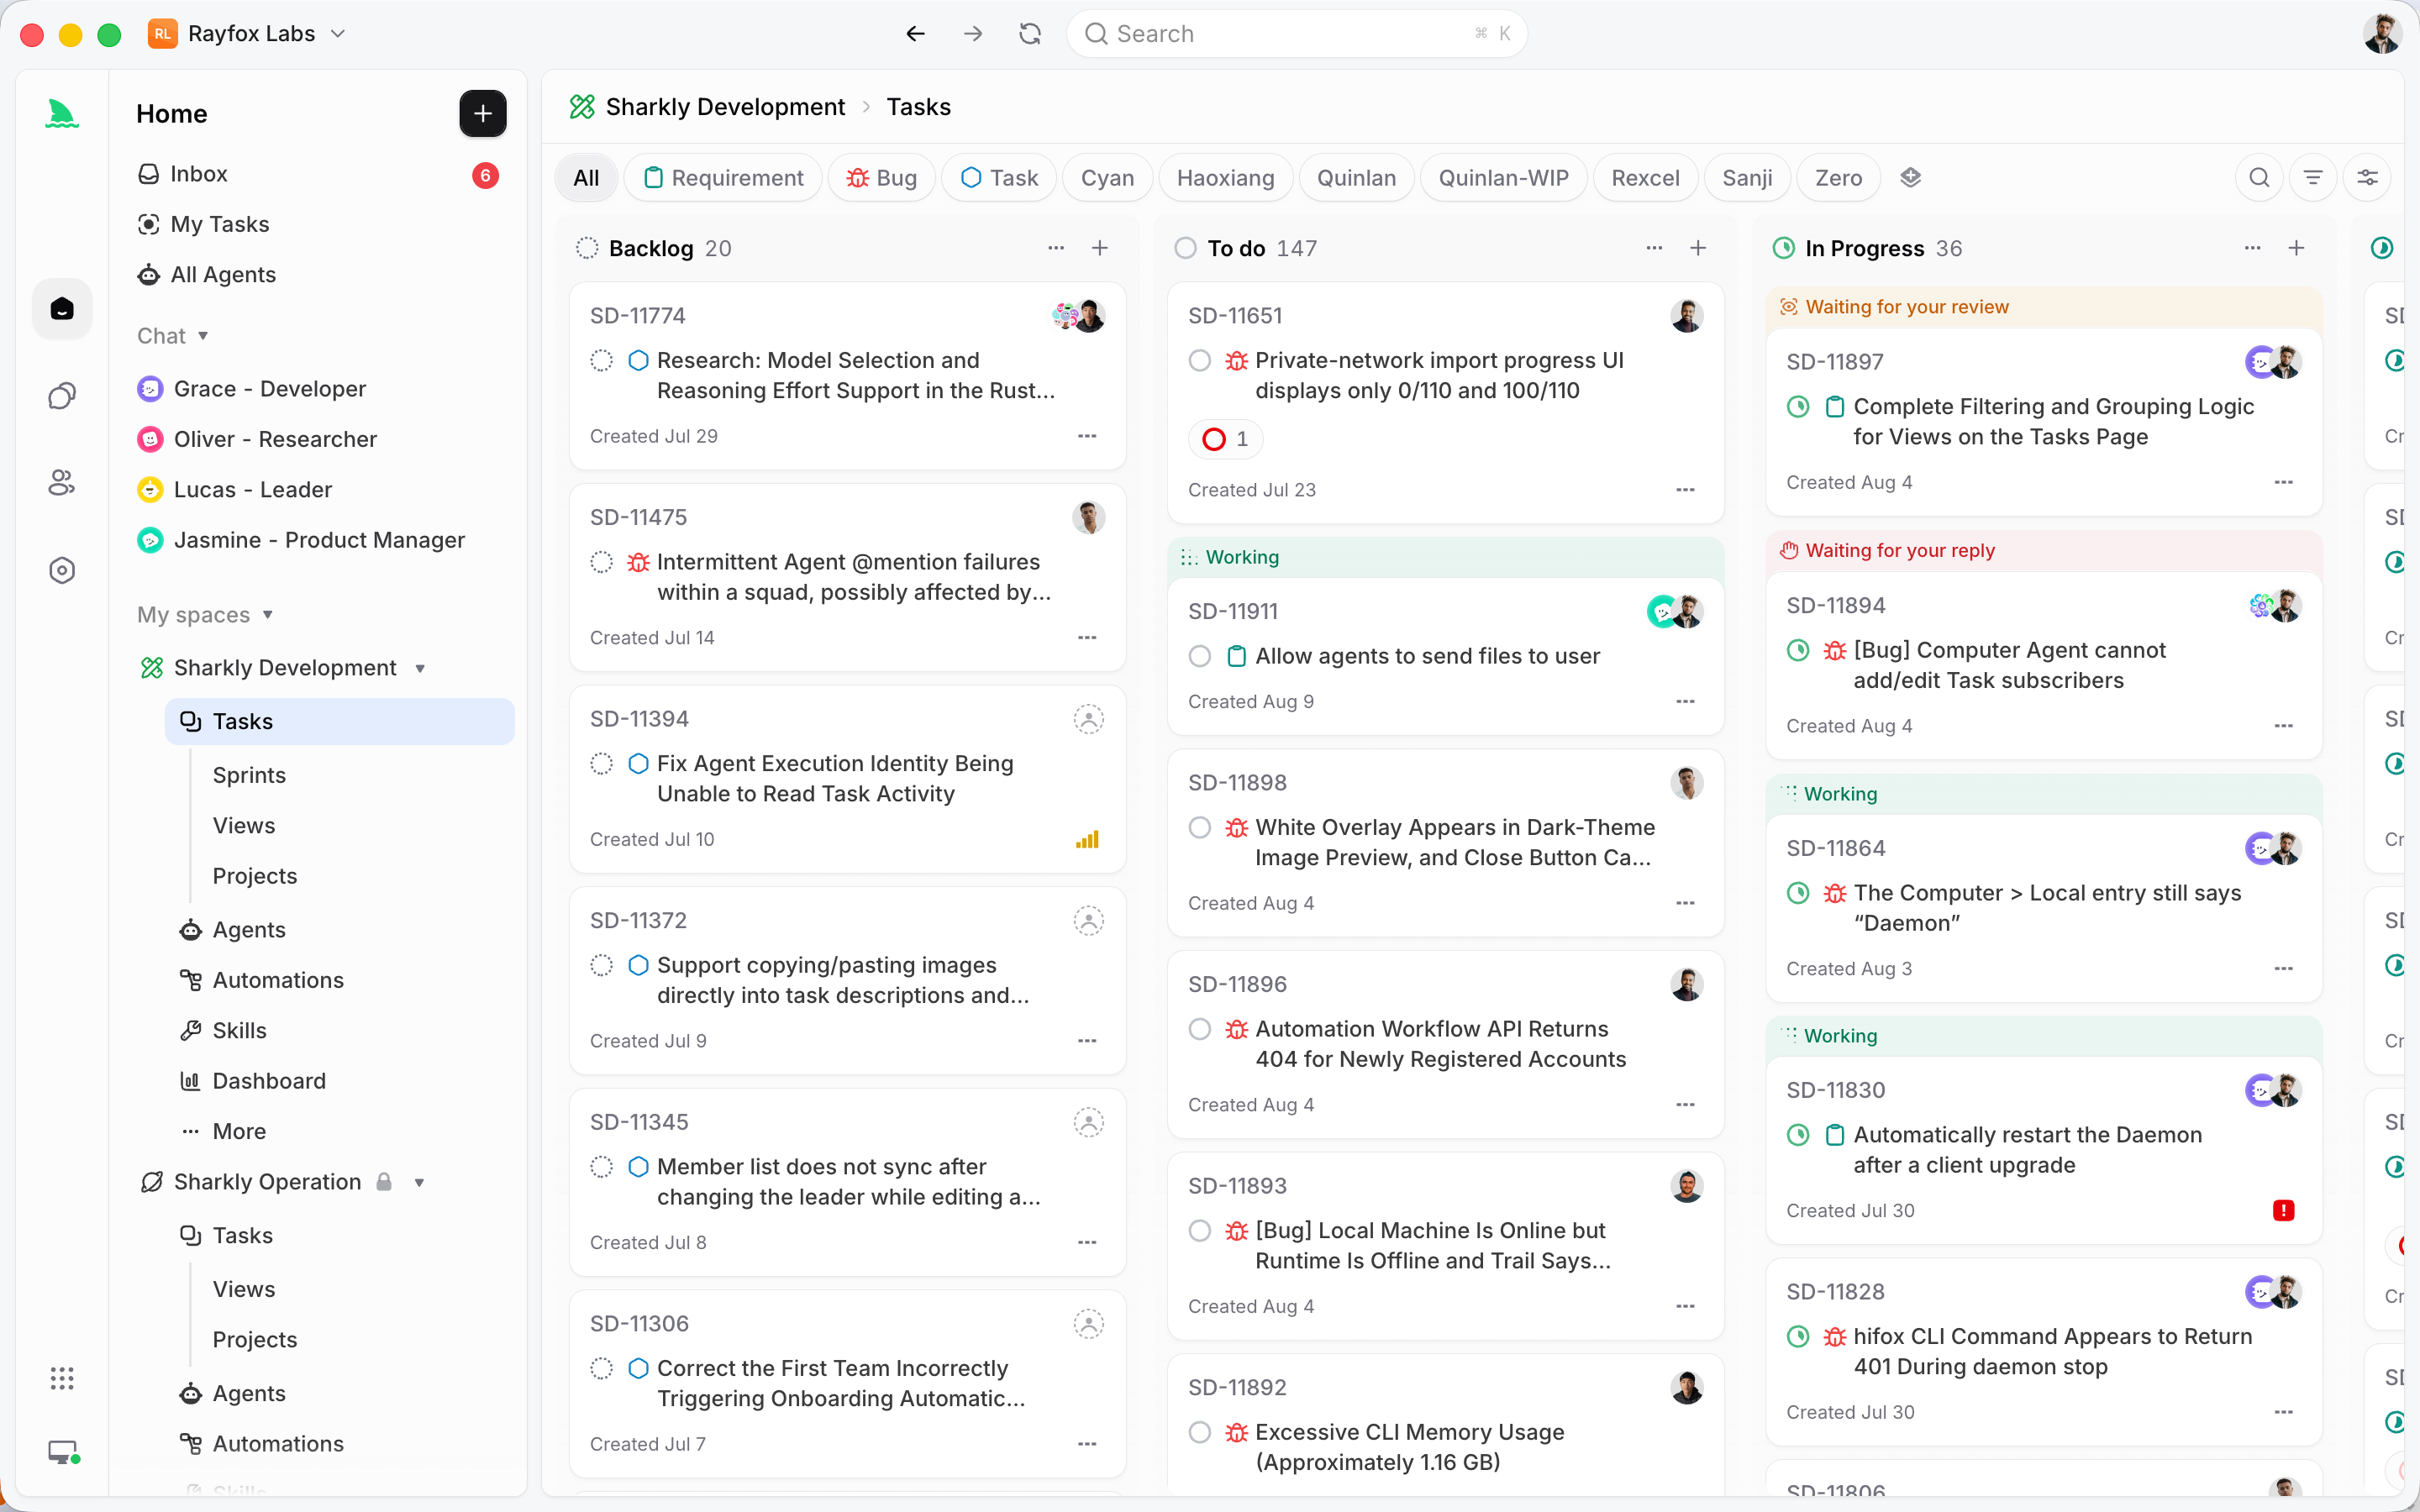
Le mécanisme est direct. Chaque Task reçoit un répertoire isolé. Pour le travail adossé à un dépôt, Sharkly prépare un worktree neuf à chaque exécution à partir de ses données de dépôt en cache, si bien que plusieurs Tasks peuvent travailler sur la même source sans jamais écrire dans un checkout partagé. Vous ne lancez pas git worktree add. Vous n'écrivez ni convention de nommage, ni tâche de nettoyage, ni fichier de correspondance. Vous assignez une Task, et l'isolation est déjà là.
C'est cette séparation des responsabilités qui rend l'ensemble serein. L'Agent définit comment le travail doit être traité. Le Computer fournit l'hôte et les ressources locales. Le Runtime exécute la session d'agent proprement dite. La Task reste l'enregistrement partagé de l'équipe. Comme chaque exécution se déroule dans son propre worktree, le frontend, le backend, une correction de bug et de nouveaux tests peuvent tous avancer en même temps sans se marcher dessus : exactement le parallélisme que l'approche manuelle cherchait à atteindre.
Et les résultats ont un endroit où aller. L'exécution, les points de blocage, les résultats et les échanges de suivi reviennent tous dans la timeline de la Task. Au lieu qu'un diff d'agent reste dans un terminal auquel vous devez penser à revenir, le résumé des changements, la sortie de vérification et les limites connues reviennent dans la Task, où une personne les accepte, demande des modifications ou décide du merge. Le contexte, la progression, les blocages, les résultats et la relecture humaine restent visibles de la demande à la livraison, dans un seul espace partagé plutôt que dispersés entre des prompts privés et des sessions de terminal. Si ce modèle est nouveau pour vous, assigner votre première Task à un agent de codage IA est le chemin d'entrée le plus court.
Vous conservez les outils que vous utilisez déjà. L'usage des modèles continue de passer par les abonnements ou les clés API configurés dans ces outils ; Sharkly ajoute autour d'eux l'isolation, la coordination et la relecture.
Worktrees manuels ou couche de gestion
Les deux approches reposent sur la même primitive. La différence, c'est qui supporte la charge opérationnelle.
| Point de préoccupation | Worktrees git manuels | Worktrees gérés par Sharkly |
|---|---|---|
| Isolation par agent | Vous lancez git worktree add à chaque exécution |
Chaque Task reçoit automatiquement un worktree neuf |
| Préparation par worktree | Vous scriptez les installations et les fichiers d'environnement | Prise en charge dans la préparation de la Task |
| Nettoyage et élagage | À votre charge, facile à oublier | Géré ; le nettoyage sûr ne touche jamais aux caches protégés |
| Quel agent est où | Un fichier de correspondance que vous maintenez | Visible sur la Task, aucun fichier annexe |
| Résultats et diffs | Prisonniers de chaque terminal | Reviennent dans la Task pour relecture |
| Prise de Task / verrous | Vous écrivez le verrou | Les Tasks sont prises dans un plan partagé |
| Coordination du disque | Manuelle | Gérée sur l'ensemble des Computers connectés |
Optez pour les worktrees manuels quand vous êtes un développeur seul faisant tourner un ou deux agents et que vous voulez garder le contrôle total du shell. Cette configuration est tout à fait correcte, et elle vaut la peine d'être apprise, car la mécanique vous montre ce que fait n'importe quelle couche au-dessus. Passez à une couche de gestion quand le nombre grimpe, quand plus d'une personne doit voir le travail, ou quand la perte des résultats d'un agent dans un terminal fermé vous a réellement coûté quelque chose. C'est la règle de décision honnête que nous exposons dans notre guide sur l'orchestration d'agents IA : n'ajoutez pas de machinerie de coordination tant que le travail parallèle n'est pas réel, et ne continuez pas à la bricoler une fois qu'il l'est.
Le contrat humain-agent tient toujours
L'isolation change l'endroit où le travail se fait, pas qui décide. Les worktrees permettent aux agents de chercher, exécuter, tester et rendre compte en parallèle sans collisions. Les humains continuent de fixer la direction, d'accorder l'autorité et d'accepter le résultat. L'automatisation s'arrête là où le jugement de l'équipe est requis. Un worktree neuf par agent est ce qui rend cette frontière applicable : le travail de chaque agent arrive sous forme de changement distinct et relisible sur sa propre branche, et non comme une modification intraçable fondue dans un checkout partagé. Vous relisez des branches, pas le chaos. Pour une vue d'ensemble de ce que ce basculement implique au quotidien, notre article explicatif sur le codage agentique pose le contexte, et Qu'est-ce que Sharkly couvre la plateforme de bout en bout.
Quelques bonnes pratiques éprouvées pour les worktrees manuels
Si vous restez en manuel pour l'instant, ces habitudes évitent la majeure partie des problèmes :
- Nommez les répertoires de worktree d'après la branche ou la tâche, pas dans l'ordre séquentiel.
myproject-auth-refactorvous dit de quoi il s'agit ;myproject-wt3, non. - Placez les worktrees au même niveau que le checkout principal, pas imbriqués à l'intérieur. L'imbrication perturbe les outils qui parcourent l'arborescence et fait gonfler vos règles d'exclusion.
- Automatisez la préparation de chaque worktree dans un seul script que l'agent exécute en premier, pour qu'un nouveau worktree soit exécutable en une étape au lieu d'échouer sur une installation manquante.
- Élaguez selon un planning, pas au hasard. Un
git worktree prunequotidien accompagné d'une revue degit worktree listlimite les entrées fantômes. - Ne supprimez jamais un cache de runtime imbriqué comme
~/.claude/worktreesdepuis vos propres scripts. Laissez le runtime s'en occuper. - Committez ou stashez avant de supprimer.
--forceest là pour les cas où vous êtes sûr, pas par défaut.
Conclusion
Les worktrees Git sont la primitive d'isolation qui rend sûrs les agents de codage IA en parallèle. Les idées essentielles valent la peine d'être retenues :
- Un checkout possède une branche, un index, un
HEAD, et ne peut pas héberger deux agents à la fois. - Un worktree ajoute un second répertoire de travail sur la même histoire partagée, si bien que chaque agent dispose de sa propre branche et de ses propres fichiers.
- Les cinq commandes (
add,list,remove,prune, et--forcequand vous l'assumez) sont simples. - C'est le coût opérationnel (installations par worktree, disque, nettoyage, coordination, collecte des résultats) qui augmente.
- Les worktrees manuels conviennent pour un ou deux agents ; une couche de gestion gagne sa place à mesure que le nombre et les enjeux augmentent.
- Sharkly prépare automatiquement un worktree neuf pour chaque Task et renvoie chaque résultat dans la Task pour relecture humaine.
Apprenez d'abord les commandes manuelles ; elles vous montrent ce que fait n'importe quelle couche au-dessus. Quand la gestion commence à coûter plus cher que le travail lui-même, Sharkly vous retire des épaules le worktree, la coordination et la relecture. Connectez un Computer, créez un Agent et confiez-lui quelque chose d'ennuyeux.
FAQ
Qu'est-ce qu'un worktree git, en termes simples ? C'est un second répertoire de travail rattaché au même dépôt, avec sa propre branche extraite et ses propres modifications indexées et non indexées. Il partage un seul historique de commits avec le checkout principal, ce qui le rend bien plus léger qu'un clone. Pour les agents IA, cela signifie que chaque agent dispose d'un espace de travail privé sans toucher aux fichiers des autres.
Pourquoi les agents de codage IA ont-ils besoin de worktrees ? Parce que deux agents partageant un même checkout s'écraseront mutuellement les fichiers et se changeront mutuellement de branche. Un worktree par agent déplace les conflits au moment du merge, où ils sont visibles et relisibles, plutôt qu'en pleine édition, où ils corrompent l'état en silence. Consultez notre guide sur l'exécution de plusieurs agents Claude Code en parallèle pour la configuration parallèle complète.
Un worktree, est-ce la même chose qu'un clone ? Non. Un clone copie l'intégralité de la base d'objets dans un dépôt distinct. Un worktree partage une seule base d'objets et n'ajoute qu'un nouveau répertoire de travail et une extraction de branche. Les commits effectués dans un worktree sont immédiatement visibles depuis tous les autres, et l'utilisation du disque est bien moindre.
Deux worktrees peuvent-ils extraire la même branche ? Non. Git refuse d'extraire une même branche dans deux worktrees à la fois, pour vous protéger d'écritures conflictuelles sur cette branche. Si deux agents ont besoin de cette branche comme base, l'un des deux doit créer une nouvelle branche à partir d'elle.
Comment nettoyer des worktrees en toute sécurité ? Committez ou stashez d'abord tout travail en cours, puis git worktree remove <path>. Si vous avez supprimé un répertoire de worktree à la main, lancez git worktree prune pour effacer les métadonnées obsolètes. Ne pointez jamais vos scripts de nettoyage vers le cache propre à un runtime, comme ~/.claude/worktrees.
Quand faut-il arrêter de gérer les worktrees à la main ? Quand vous coordonnez plus de deux ou trois agents, quand plus d'une personne doit voir le travail, ou quand un résultat perdu dans un terminal fermé vous a fait perdre du temps. À ce stade, une couche de gestion qui isole et suit chaque exécution est rentable. Notre guide sur l'orchestration d'agents IA explique quand franchir ce pas.


