
TL;DR : Pour donner une voix à votre agent IA, placez GPT-Live-1.1 d'OpenAI devant lui comme interface vocale et laissez le vrai travail aux agents que vous faites déjà tourner. GPT-Live écoute tout en parlant et confie le raisonnement et les appels d'outils à un backend via la délégation. En mode client delegation, votre application intercepte chaque transfert, lance une Sharkly Automation via son webhook et restitue le résultat à l'oral.
Qu'est-ce que GPT-Live-1.1 ?
GPT-Live-1.1 est le modèle vocal full-duplex d'OpenAI pour les conversations multilingues : il peut écouter tout en parlant, ce qui permet aux gens de l'interrompre comme ils interrompraient un collègue. Il fonctionne sur le point de terminaison v1/live/sessions, prend en charge le function calling et le streaming, et peut déléguer le raisonnement et l'usage d'outils à un agent backend au lieu de faire ce travail lui-même.
La page du modèle GPT-Live-1.1 d'OpenAI indique qu'il transcrit la parole avec plus de précision que GPT-Live-1 et conserve un accent et une voix plus homogènes d'une langue à l'autre. Les entrées et sorties sont audio et texte. Il n'accepte pas les images directement.
L'élément qui compte pour les équipes d'agents, c'est la délégation. Le modèle vocal est conçu pour parler, pas pour lancer une refonte de 20 minutes. Il confie ce travail à autre chose et maintient la conversation pendant qu'il attend.
Si votre équipe assigne déjà du travail à des agents de code sur un tableau partagé, Sharkly peut être cette « autre chose ». La suite de ce guide montre comment câbler tout cela.
Pourquoi un agent vocal a besoin d'une équipe backend
Une interface vocale a un budget de latence très strict. Les gens attendent une réponse dans la seconde environ, et un silence plus long donne l'impression que quelque chose est cassé. Le travail réel d'un agent ne rentre pas dans cette fenêtre : lire un dépôt, exécuter des tests ou trier une file d'attente prend des minutes.
Un agent vocal qui essaie donc de tout faire lui-même échoue de deux façons. Soit il répond vite mais superficiellement, soit il se tait le temps de réfléchir. Aucune des deux n'est utile quand vous marchez vers une réunion et voulez savoir si les exécutions d'agents de la nuit dernière ont réussi.
La solution, c'est la séparation que vous utilisez peut-être déjà pour le texte : une interface rapide qui gère la conversation et un backend plus lent qui fait le travail. GPT-Live intègre cette séparation directement dans l'API. Si vous avez lu notre article sur les transferts agent-à-agent et agent-à-humain, c'est exactement le même modèle, avec un micro.
Comment fonctionne la délégation GPT-Live
GPT-Live propose deux modes de délégation, choisis au moment de la création de la session. Pour changer de mode, il faut démarrer une nouvelle session.
| Délégation Responses | Délégation client | |
|---|---|---|
| Qui fait tourner le backend | OpenAI, via l'API Responses | Votre application |
| Configuration | delegation.type: "responses" avec model, instructions, tools |
delegation.type: "client" |
| Modèle backend | Celui que vous configurez, par exemple gpt-6-luna |
N'importe ce que vous pouvez appeler |
| Retour des résultats | Géré pour vous | session.commentary.append ou session.thinking.append |
| Convient pour | Consultations et appels d'outils qu'OpenAI peut exécuter | Le travail qui vit dans vos propres systèmes |
La délégation Responses est le chemin le plus court. Vous désignez un modèle backend et OpenAI l'exécute avec les outils que vous listez. Le guide de délégation recommande de commencer avec gpt-6-luna et d'essayer gpt-6-sol pour les tâches backend plus complexes.
La délégation client est le chemin pour les agents que vous faites déjà tourner. Quand le modèle vocal décide qu'il a besoin d'aide, votre application reçoit un événement session.delegation.created avec un ID de délégation. Cet événement ne contient pas les paroles de l'utilisateur : votre application reconstruit donc la requête à partir des événements de transcription et de son propre état. Quand le travail est terminé, vous renvoyez le résultat avec le même ID de délégation et GPT-Live le reformule à voix haute.
Le modèle : GPT-Live parle, votre équipe d'agents travaille
Voici la forme d'une interface vocale posée sur Sharkly. Sharkly se situe au-dessus de vos agents de code (Claude Code, Codex, Gemini CLI et autres) comme la couche où le travail est assigné, exécuté sur des Computers connectés et relu. Le modèle vocal ne touche jamais à un dépôt. Il demande du travail, et le tableau l'enregistre.
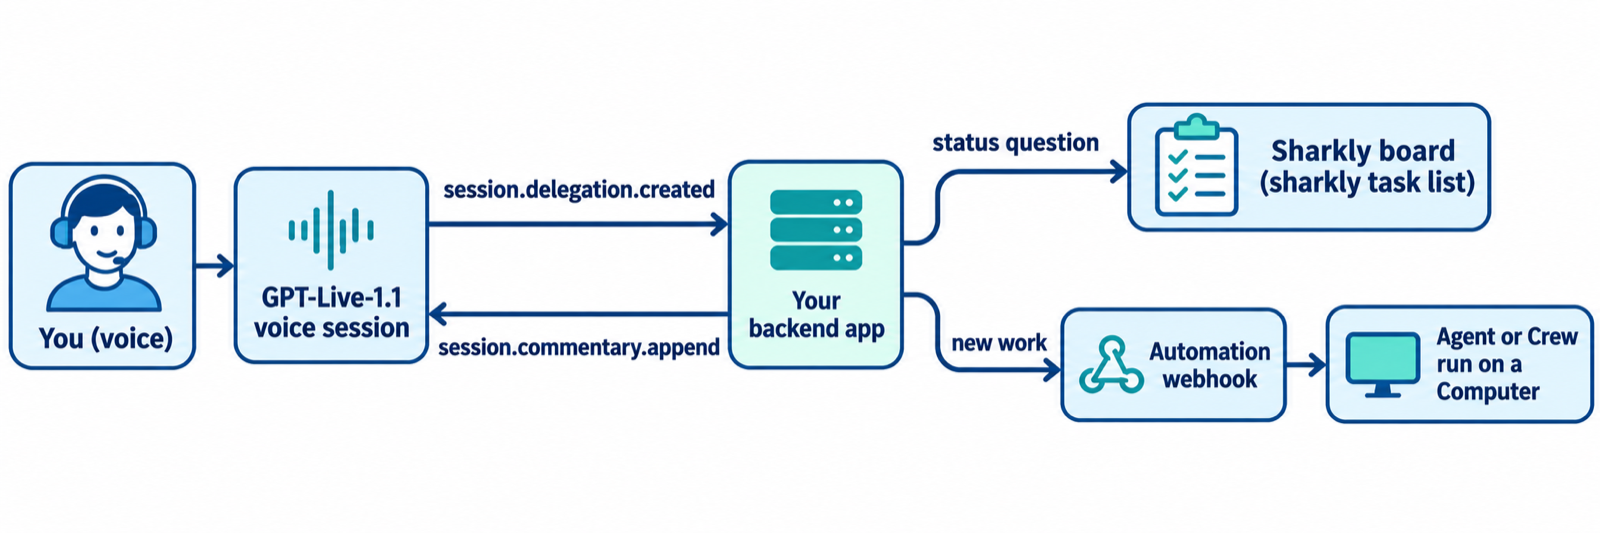
Trois types de requêtes couvrent la plupart de ce que les gens demandent à un agent vocal à propos de leur équipe d'agents :
- Questions d'état (« La suite de tests nocturne a-t-elle réussi ? »). Votre backend lit le tableau avec la CLI
sharklyet répond en quelques secondes. - Nouveau travail (« Fais examiner le test de connexion instable par un agent »). Votre backend appelle un webhook d'Automation Sharkly, et un Agent ou un Crew démarre une exécution.
- Décisions (« Fusionne-le »). Votre backend refuse et indique à la personne où relire. La voix est un mauvais endroit pour approuver des changements.
Cette troisième règle est un choix de conception, pas une limitation de l'un ou l'autre produit. Un « oui » prononcé est facile à mal entendre et difficile à auditer. Gardez les approbations là où se trouvent les preuves, ce que notre guide sur les agents de code avec humain dans la boucle explique en détail.
Donnez une voix à votre agent IA : configuration pas à pas
Étape 1 : Créer l'Automation et son déclencheur webhook
Dans Sharkly, une Automation est une définition possédée par un Space pour du travail d'Agent ou de Crew répétable : instructions, assignataire, déclencheurs et historique d'exécution. Un déclencheur webhook crée une URL secrète qui accepte une requête POST d'un service externe. La documentation des Automations précise que l'URL complète n'est affichée qu'une seule fois, à la création ou à la régénération du déclencheur : stockez-la donc immédiatement comme secret.
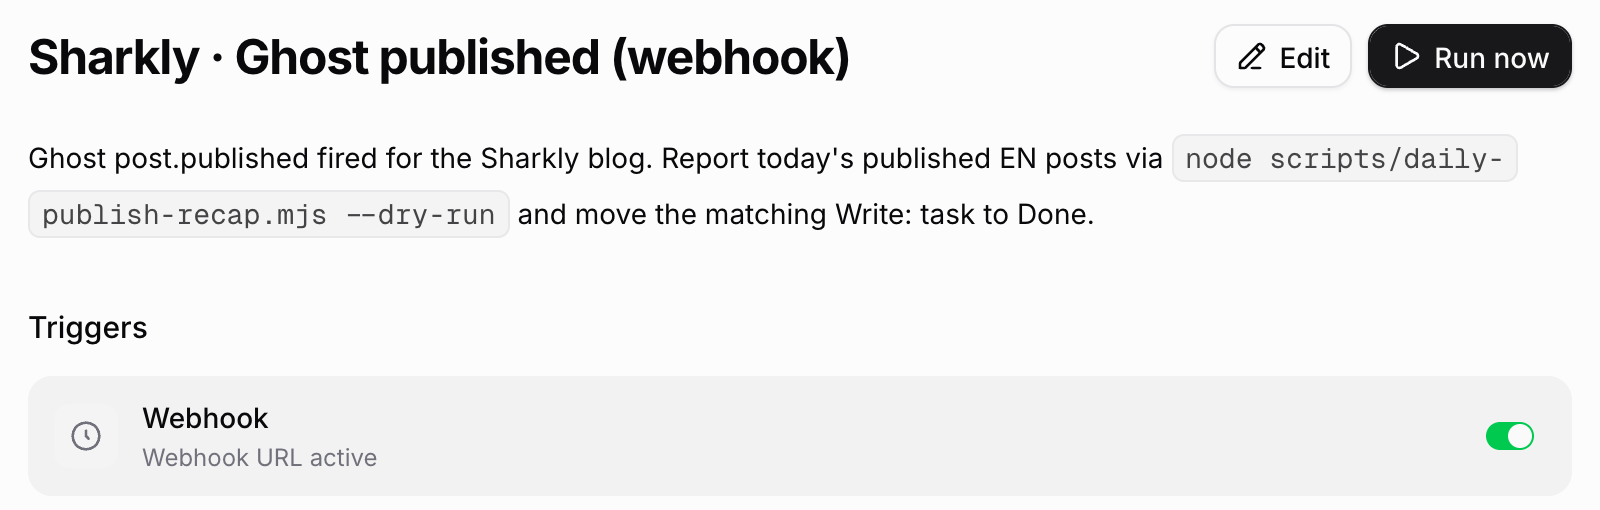
Rédigez les instructions pour que l'Agent lise la requête depuis le payload du déclencheur et enregistre son résultat en commentaire de tâche. Précisez ce qu'il peut modifier et quand une personne doit décider. Utilisez ensuite Run now pour tester l'Agent et son Computer avant de connecter du trafic vocal. Notre présentation des Automations dans Sharkly montre d'autres types de déclencheurs.
Étape 2 : Créer une session GPT-Live en mode client
La configuration de votre session nomme le modèle vocal et active la délégation client. Le paramètre acknowledgement_delay_ms laisse à votre application le temps d'envoyer sa propre mise à jour avant que GPT-Live ne prononce un accusé de réception générique.
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
OpenAI recommande WebRTC pour l'audio dans les applications navigateur, mobiles et serveur, WebSockets étant une alternative prise en charge. Le guide de démarrage GPT-Live couvre la configuration de la connexion.
Étape 3 : Router chaque délégation vers Sharkly
À l'arrivée de session.delegation.created, enregistrez l'ID de délégation, reconstruisez la requête à partir de la transcription et déterminez quel chemin elle emprunte. Ce squelette Node envoie le nouveau travail au webhook de l'Automation et répond aux questions d'état depuis le tableau.
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
Notez ce que promet la réponse vocale. Elle dit qu'une exécution a démarré, pas que le travail est terminé. Le guide d'OpenAI fait la même remarque à propos des réservations : n'envoyez le résultat qu'une fois l'action réussie.
Étape 4 : Lire les résultats sur le tableau, pas à l'oreille
Les exécutions d'agents prennent des minutes, et une session vocale peut se terminer avant le travail. Le tableau fait donc foi. L'Agent publie son résultat sur la tâche, l'historique d'exécution affiche le payload du déclencheur et la sortie, et une personne y relit le tout. La prochaine fois que vous demandez « qu'est-il arrivé au test instable ? », le chemin de consultation d'état vous relira ce résultat.
Coûts et limites à prévoir
| Élément | GPT-Live-1.1 (documentation OpenAI, 2026-11-20) |
|---|---|
| Point de terminaison | v1/live/sessions |
| Session active | 0,05 $ par minute |
| Veille | 0,02 $ par minute (sessions WebRTC pendant que l'inférence est en pause) |
| Facturation | À la durée ; la page de tarification d'OpenAI indique que GPT-Live est facturé à la seconde |
| Sessions simultanées | Limites distinctes de celles de GPT-Live-1 ; voir la page des limites de votre organisation |
| Appels backend | Facturés aux tarifs normaux du modèle configuré |
Un point debout de vérification de 10 minutes coûte 0,50 $ en temps vocal au tarif actif, avant tout appel backend. Pour référence, la page du modèle GPT-Live-1 liste 50, 300 et 500 sessions simultanées sur les offres Build, Launch et Grow, et aucun accès sur l'offre Free. GPT-Live-1.1 a ses propres limites.
Les exécutions d'agents côté Sharkly sont facturées sur le plan Claude Code, Codex ou API déjà attaché à chaque Runtime. Sharkly ne vend pas de tokens. Si vous routez les questions d'état vers un modèle backend économique, nos notes sur l'exécution d'agents GPT-6 Luna dans Sharkly s'appliquent directement.
Des garde-fous à ajouter dès le premier jour
- Les interruptions n'annulent pas le travail. Le guide d'OpenAI indique qu'interrompre la conversation parlée n'arrête pas le travail backend. Si quelqu'un dit « laisse tomber », c'est à votre backend de le gérer, sinon l'exécution continue.
- Traitez l'URL du webhook comme un mot de passe. La documentation de Sharkly la décrit comme un secret de type bearer par défaut. Ajoutez un secret de signature et régénérez l'URL si elle fuite.
- Cadregez l'Automation. Commencez par un travail observable et réversible, comme le conseille la documentation Sharkly, et relisez plusieurs exécutions avant d'élargir le périmètre.
- Conservez la délégation Crew au sein de Sharkly. Si une requête nécessite plusieurs agents, faites pointer le webhook vers un Sharkly Crew et laissez son leader répartir le travail.
Quand une interface vocale est le mauvais outil
Passez votre chemin quand la requête a besoin d'un diff, d'un log ou d'une capture d'écran pour avoir du sens. La voix ne peut pas vous montrer un test qui échoue. C'est aussi le mauvais canal pour tout ce qui exige une signature : les approbations, les déploiements et les changements d'accès ont leur place sur la tâche, là où se trouvent les preuves.
La voix trouve sa place pour les vérifications d'état rapides, le lancement d'exécutions bien définies et les moments où l'on a les mains prises. Pensez-y comme à une télécommande pour votre tableau d'agents, pas comme un remplacement.
Conclusion
GPT-Live-1.1 gère la partie d'un agent vocal qui est difficile à construire soi-même : la conversation full-duplex avec interruptions. La délégation confie tout le reste à un backend. Placez votre équipe d'agents existante derrière ce backend, et vous pourrez vous renseigner sur les exécutions et en lancer de nouvelles à voix haute, pendant que chaque résultat atterrit toujours sur un tableau relu par un humain.
Votre prochaine étape : créez une Automation avec un déclencheur webhook dans Sharkly, testez-la avec Run now, puis pointez une session GPT-Live en mode client vers elle. La documentation Sharkly couvre les Agents, Computers et Automations en détail.
FAQ
Comment donner une voix à mon agent IA ?
Placez un modèle vocal tel que GPT-Live-1.1 devant l'agent et laissez-le déléguer. Le modèle vocal gère l'écoute et la parole, et votre backend fait tourner l'agent et renvoie un court résultat que le modèle vocal dira.
GPT-Live-1.1 est-il disponible dans l'API ?
Oui. OpenAI liste gpt-live-1.1 avec le point de terminaison v1/live/sessions, le function calling et le streaming. Il ne prend pas en charge v1/realtime ni v1/responses directement.
Combien coûte GPT-Live-1.1 ?
OpenAI liste 0,05 $ par minute pour les sessions actives et 0,02 $ par minute en veille. Les appels au modèle backend effectués via la délégation sont facturés séparément à leurs tarifs normaux.
Quelle est la différence entre la délégation Responses et la délégation client ?
Avec la délégation Responses, OpenAI exécute un modèle backend que vous configurez. Avec la délégation client, votre application reçoit chaque requête et renvoie les résultats via session.commentary.append ou session.thinking.append.
GPT-Live-1.1 peut-il exécuter des agents de code directement ?
Non. Il délègue. C'est votre backend qui décide de ce qui s'exécute, par exemple en appelant un webhook d'Automation Sharkly qui lance une exécution d'Agent ou de Crew sur un Computer connecté.
Que se passe-t-il si j'interromps l'agent vocal en pleine tâche ?
La conversation s'arrête, mais pas le travail backend. Gérez l'annulation dans votre backend, par exemple en mettant l'exécution en pause ou en commentant la tâche.


