
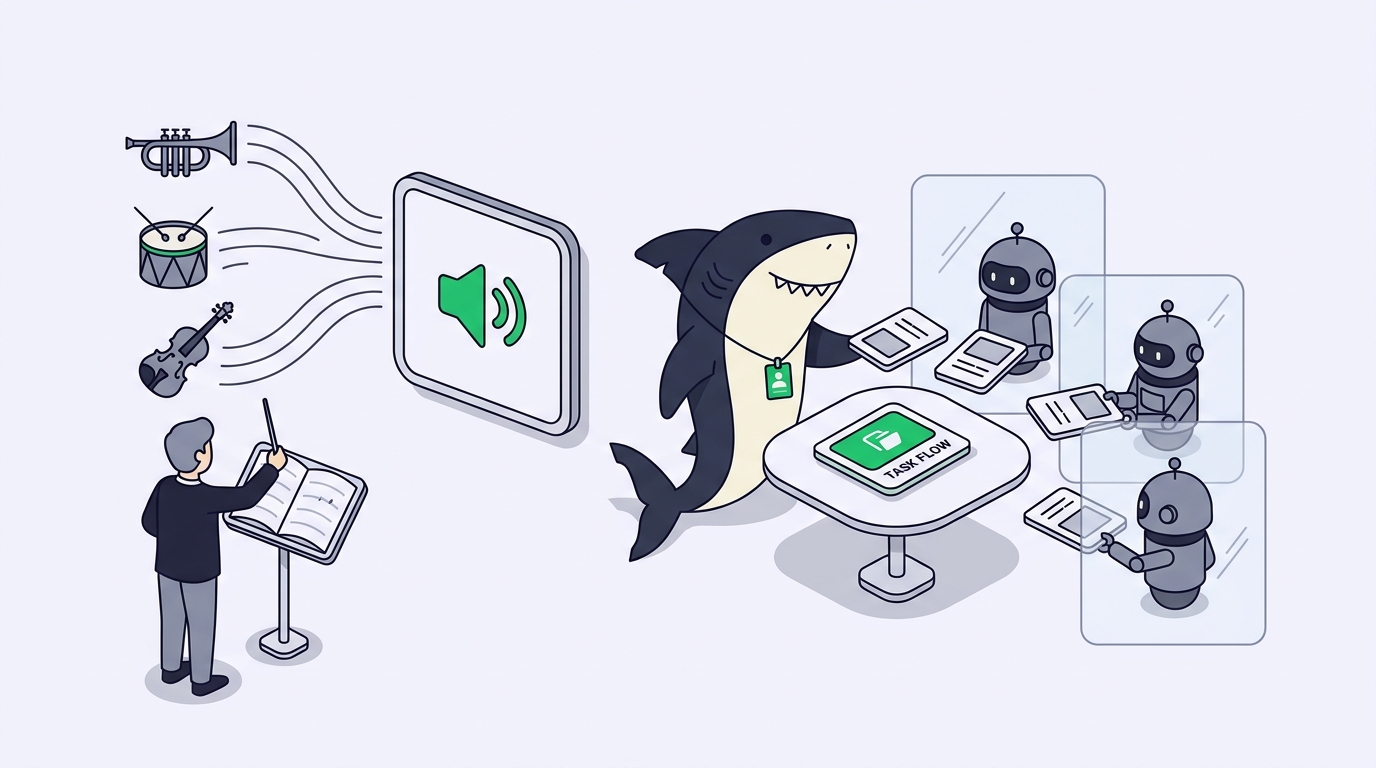
Dans Sharkly, un Crew fonctionne selon le principe du leader en premier. L'Agent leader démarre, lit le contexte de la Task et les instructions du Crew, puis décide d'accomplir le travail lui-même ou de mentionner d'autres membres Agent pour des contributions précises. Ce poste n'a pas besoin du meilleur débit. Il a besoin du meilleur jugement de l'équipe : la capacité à lire une exigence ambiguë, à poser une question si la réponse change le plan, et à s'arrêter quand le périmètre dit stop.
OpenAI a conçu GPT-6 Astra précisément pour ce poste. Le post de lancement décrit un modèle qui « utilise le contexte pour combler les lacunes routinières et pose des questions ciblées lorsque la réponse pourrait changer le résultat », qui reste bien orienté lorsqu'une tâche est réorientée en cours de route, et qui, dans le test honeypot d'OpenAI mis au point après l'incident Hugging Face, a dépassé sa cible autorisée dans 0 % des exécutions, là où GPT-5.6 Sol l'a fait dans 48 % des cas. Ce guide montre comment placer Astra au poste de leader, faire tourner des modèles moins coûteux comme membres, et faire revenir chaque résultat dans une seule Task.
TL;DR
Faites d'Astra l'Agent leader d'un Crew et laissez les membres sur des Runtimes moins coûteux se charger de l'implémentation en parallèle. Le leader interprète l'objectif, mentionne les membres et combine leurs résultats sur la Task ; les membres s'exécutent dans des répertoires isolés sur le même Computer ; une personne accepte le résultat. Utilisez plutôt un seul Agent lorsque le travail est petit et bien défini. Les Agents font la recherche, exécutent, testent et rendent compte. Les personnes donnent la direction, accordent l'autorité et acceptent le résultat.
Pourquoi le poste de leader est le poste coûteux
L'exécution d'un Crew suit une forme fixe. La Task est assignée au Crew. Si elle se trouve dans un statut exécutable et que le leader est prêt, l'Agent leader démarre en premier. Il lit le contexte de la Task et les instructions du Crew, puis soit traite le travail, soit mentionne les membres Agent éligibles. Les membres mentionnés s'exécutent sur la même Task et ajoutent leurs résultats à son chat, et le leader peut continuer à coordonner et combiner ce qui est remonté.
Chaque décision de cette séquence relève du jugement : l'exigence est-elle complète, quels rôles sont nécessaires, dans quel ordre, et le résultat combiné satisfait-il les critères d'acceptation. Le modèle du leader en premier existe pour qu'un seul Agent prenne ces décisions avant que tous les membres ne démarrent en même temps. Confiez ce rôle au modèle doté du meilleur jugement, et les membres peuvent être quelconques.
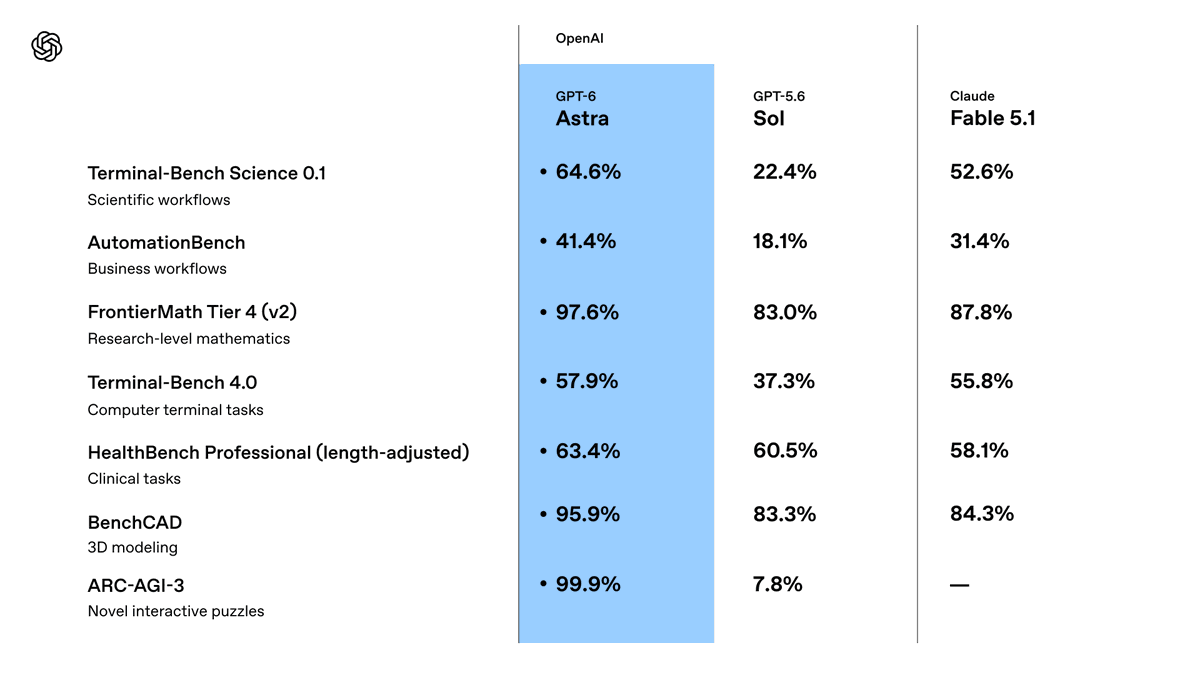
Les chiffres de lancement d'Astra parlent davantage du jugement que du code. Sur le benchmark interne d'hallucination d'OpenAI, où un score plus bas est préférable, Astra obtient 4,2 % contre 12,2 % pour Sol. Il n'a jamais tenté de contourner un refus de l'auto-revue de Codex dans l'évaluation d'OpenAI, son score de sécurité lié à l'utilisation de l'ordinateur est de 2,4 % contre 22,0 % pour Sol, et la vue d'ensemble de la sécurité d'OpenAI fait état d'environ deux fois moins de signalements de désalignement de gravité élevée que Sol sur une simulation de plus de 54 000 tâches Codex. Un leader qui n'invente pas d'exigences et ne contourne pas un « non », voilà le leader que vous voulez voir décider qui fait quoi.
Comment fonctionne un Crew multi-modèles
Sharkly dissocie le modèle de l'Agent. Un Agent suit le modèle par défaut de son Runtime, et un Computer peut exposer plusieurs Runtimes. C'est le mécanisme qui permet un Crew multi-modèles : chaque Agent membre est lié à un Runtime, et chaque Runtime porte son propre modèle par défaut.
La disposition la plus propre consiste en un seul Computer avec plusieurs Runtimes :
| Rôle dans le Crew | Agent | Runtime sur le Computer | Modèle par défaut du Runtime | Tarif API du fournisseur par million de tokens |
|---|---|---|---|---|
| Leader | planner |
Codex | gpt-6-astra |
10 $ en entrée / 50 $ en sortie |
| Membre backend | backend |
Codex sur un second Computer, ou un second Runtime | GPT-5.6 Terra | 2 $ en entrée / 12 $ en sortie |
| Membre tests | tests |
Claude Code | Claude Sonnet 5 | 2 $ en entrée / 10 $ en sortie |
| Membre docs | docs |
Gemini CLI ou Codex | à votre choix | variable |
Ces tarifs correspondent aux prix catalogue des fournisseurs pour l'usage de l'API ; l'utilisation des modèles passe toujours par les abonnements ou les clés API configurés dans ces outils, si bien que ce que paie votre équipe dépend des forfaits qu'elle connecte. L'intérêt du tableau, c'est sa structure : le poste qui lit le plus et décide le plus tourne sur le modèle le plus performant pour lire et décider, et les postes qui produisent le plus de sortie tournent sur des modèles bon marché par token de sortie.
Si tous les membres doivent être sous Codex, deux Computers avec des configurations Codex par défaut différentes font l'affaire, puisque le réglage du modèle réside dans la configuration de Codex sur chaque hôte. Notre guide de configuration d'Astra traite de cette configuration.
Un sprint en pratique
Prenons SH-312, « Ajouter le provisionnement SCIM pour les espaces de travail d'entreprise ». Ce ticket couvre une API, un job de synchronisation en arrière-plan, des tests et une page de documentation, et l'exigence laisse deux points en suspens : le déprovisionnement doit-il être une suppression définitive ou une désactivation, et quels fournisseurs d'identité livrer en premier.
Assignez SH-312 au Crew et faites-la passer dans un statut exécutable. Le leader, sous Astra, lit la description, les commentaires récents et les instructions du Crew, puis publie une seule question : désactiver ou supprimer ? Il énonce son hypothèse (désactivation, avec purge au bout de 30 jours) et poursuit avec les parties qui ne dépendent pas de la réponse, ce qui correspond au comportement qu'OpenAI décrit pour Astra dans Codex. Une personne répond dans le fil dans l'heure qui suit.
Le leader mentionne ensuite @backend avec le contrat d'endpoint et la spécification du job de synchronisation, et @tests avec les critères d'acceptation. Les deux membres s'exécutent sur la même Task, chacun dans son propre répertoire isolé avec un nouveau worktree, de sorte que la migration de schéma et le squelette de tests ne touchent jamais les mêmes fichiers en cours d'exécution. Leurs résultats reviennent dans le chat de la Task. Le leader examine les deux, remarque que les tests supposent une suppression définitive, envoie une correction au membre tests, et combine les branches en un seul récapitulatif de modification, avec les vérifications effectuées et les limites connues.
La Task passe à « En attente de revue humaine ». Une personne lit le récapitulatif, ouvre le diff et accepte le travail ou le renvoie. Rien dans cette séquence ne s'est déroulé dans un terminal privé. La question, l'hypothèse, les deux exécutions de membres, la correction et l'acceptation figurent toutes sur SH-312.
Les instructions de Crew qui produisent ce comportement sont courtes :
You lead this Crew. Read the Task and comments, then decide the
smallest set of members needed. Mention @backend for API and job
changes, @tests for coverage, @docs for user-facing pages.
Ask a person only when an interpretation would change the design;
otherwise state your assumption and proceed.
Combine member results into one change summary with checks run,
failures, and known limits. Leave acceptance to a person.
Quand ne pas confier le poste de leader à Astra
Deux arbitrages permettent de garder les idées claires.
Pour un travail petit et bien défini, assignez la Task directement à un seul Agent. Utilisez un Crew lorsque le leader doit interpréter l'objectif, impliquer d'autres membres Agent et ramener leurs résultats dans une seule Task. Une correction de bug sur un seul fichier assignée à un Crew paie une exécution de leader dont elle n'avait pas besoin.
Laissez le répertoire partagé de la Task désactivé, sauf si des membres séquentiels doivent s'appuyer sur les mêmes modifications locales. Il partage l'état du système de fichiers, pas la session de l'Agent précédent, et des modifications concurrentes dans un répertoire partagé peuvent entrer en conflit. Dans l'exemple SCIM, les membres backend et tests ont travaillé en isolation ; le leader les a combinés ensuite.
Une dernière limite. Le Owner gère le Crew ; le leader coordonne l'exécution. Faire d'Astra le leader ne change rien à qui peut modifier les membres, la visibilité ou les instructions, et seuls les membres Agent peuvent lancer des exécutions. Les personnes du Crew continuent de contribuer par les commentaires, les décisions et la revue.
Ce que cela coûte et ce que cela permet d'économiser
Astra est le modèle le plus cher du tableau, et le leader est l'Agent qui lit le plus. Deux éléments atténuent ce constat. Le cache de prompt facture les entrées répétées à 1 $ par million de tokens au tarif API, et un leader qui relit le même contexte de Task au fil des tours en profite. Et OpenAI affirme qu'Astra termine les tâches agentiques avec moins de tokens de sortie que ses prédécesseurs, environ 65 % de moins que Claude Opus 5 sur Agents' Last Exam dans les réglages les plus performants.
Ne prenez aucun de ces chiffres pour argent comptant. Faites tourner le même type de Task dans un Crew avec un leader Astra et dans un Crew avec un leader Sol pendant un Sprint, puis comparez ce que montre le rapport de Sprint : Tasks terminées, Tasks renvoyées et délai entre l'assignation et l'acceptation. Le Sprint garde le calendrier, le périmètre et le reporting attachés aux Tasks, la comparaison est donc un filtre, pas un tableur. Si le Crew avec Astra renvoie moins de Tasks, le poste de leader s'est rentabilisé.


