
OpenAI a livré GPT-6 Luna le 22 septembre à 0,10 $ par million de tokens d'entrée et 0,50 $ par million de tokens de sortie, avec l'identifiant d'API gpt-6-luna et une fenêtre de contexte de 1 M. À ce tarif, la question intéressante n'est plus de savoir si le modèle est suffisamment bon dans l'abstrait. Elle devient : quelles voies de votre tableau êtes-vous prêt à lui confier, et comment la voie économique et la voie coûteuse tournent-elles sur le même Computer sans que personne ne perde de vue laquelle a produit tel résultat.
C'est un problème de configuration avant d'être un problème de modèle. Une équipe qui associe Luna partout économise de l'argent, puis le redépense en relecture. Une équipe qui ne l'associe jamais continue de payer le tarif premium pour qu'un Agent renomme un fichier de test. Ce guide emprunte le chemin utile le plus court : placer gpt-6-luna sur un seul Computer, le garder dans sa propre voie, lui confier une vraie Task, et lire le résultat là où l'équipe peut le voir.
TL;DR
Associez gpt-6-luna comme modèle par défaut d'un Runtime sur un Computer connecté, vérifiez que ce Runtime affiche Available dans Sharkly, donnez-lui son propre Agent plutôt que de réutiliser l'Agent coûteux, augmentez le délai d'expiration par Task avant de faire confiance à une longue exécution, et réservez Luna aux travaux dont une personne peut vérifier le résultat en moins d'une minute. Sharkly n'affichera pas le nom du modèle. Il montrera l'exécution, le journal, les questions et le résultat sur la Task. Les Agents recherchent, exécutent, testent et rendent compte. Les People donnent la direction, accordent l'autorité et acceptent le résultat.
Où se trouve le réglage du modèle
Sharkly ne choisit pas les modèles. La documentation Agents est explicite : « L'Agent suit le modèle par défaut du Runtime. Il ne promet ni n'affiche de nom de modèle précis. Modifiez les modèles dans la configuration de l'outil Runtime ou Computer, pas sur l'Agent. »
Il n'y a donc pas de menu déroulant de sélection de modèle sur un Agent, ni de réglage de profondeur de réflexion. Quatre rôles, une fonction chacun. L'Agent définit la manière dont le travail doit être traité. Le Computer fournit l'hôte et les ressources locales. Le Runtime exécute la session d'agent proprement dite. La Task reste l'enregistrement partagé pour l'équipe. Le détail complet de cette configuration se trouve dans notre guide GPT-6 Sol ; cet article couvre la partie propre à la mise en place d'un modèle économique sur le tableau.
Étape 1 : associer gpt-6-luna au Computer
Sur le Computer qui l'exécutera, mettez à jour votre outil d'agent et connectez-vous avec un compte ou une clé API ayant accès à Luna. OpenAI a rendu Luna disponible dans ChatGPT Work et dans Codex pour les offres Plus, Pro, Business, Enterprise et Edu, a donné accès à Luna aux utilisateurs Free et Go dans l'application de bureau, et ne l'a pas encore intégré à Chat. Si codex -m gpt-6-luna démarre une session dans un terminal classique sur cet hôte, Sharkly peut l'utiliser.
Définissez ensuite le modèle par défaut pour que les exécutions sur ce Runtime le reprennent :
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
Deux mises en garde sur cet extrait. Le nom de la clé de l'effort de raisonnement varie selon les versions de Codex ; vérifiez-le par rapport à la configuration d'exemple de la version installée sur ce Computer. Et high y figure volontairement, et non comme valeur par défaut : tous les résultats Luna publiés ci-dessous sont mesurés à un effort high ou max, pas au réglage que vous choisiriez pour rendre un modèle économique encore moins cher. [VERIFY]
De retour dans Sharkly, ouvrez le détail du Computer et lancez la nouvelle analyse ou le test de connexion. Le Runtime doit afficher Available. Un Computer qui affiche simplement online signifie que son service local envoie des signaux de présence. C'est le statut de capacité du Runtime qui vous indique qu'une exécution peut démarrer.
Étape 2 : garder la voie économique visiblement séparée
Un Computer peut exposer un ou plusieurs Runtimes, chacun rapportant son propre état de connexion, et un Runtime ACP personnalisé peut être ajouté depuis le détail du Computer avec son propre nom et sa propre commande de démarrage. C'est le levier à actionner ici. Donnez à la voie Luna sa propre entrée Runtime et son propre Agent, nommé d'après la voie plutôt que d'après le modèle : le tableau vous indiquera dans quelle voie une Task a tourné, sans que personne ait à lire un journal d'exécution.
Ce n'est pas cosmétique. Sharkly ne peut pas lire de manière fiable le modèle qu'un Runtime utilise réellement, et c'est précisément pourquoi les Agents suivent la valeur par défaut du Runtime et n'affichent aucun nom de modèle. Si un Agent change silencieusement de modèle entre mardi et jeudi parce que quelqu'un a modifié un fichier de configuration, deux exécutions qui semblent identiques sur la Task ne l'étaient pas. Une voie par niveau de coût rend cela visible au seul endroit où l'équipe regarde déjà. Voir Les Computers dans Sharkly pour savoir comment les Runtimes sont détectés et testés.
Une paire de décisions, car deux voies ont un coût de maintenance. Séparez le Runtime lorsque plusieurs personnes assignent du travail sur ce Computer et que la différence entre une exécution à 0,10 $ et une exécution à 10 $ compte pour quelqu'un. Ne le séparez pas lorsqu'un seul ingénieur exécute une poignée de Tasks par semaine ; un Runtime unique et un jugement au cas par cas à chaque Task sont plus simples à suivre, et l'isolation par worktree empêche déjà les exécutions de se télescoper.
Étape 3 : dimensionner l'exécution pour un modèle qui démarre lentement
Économique ne veut pas dire rapide, et c'est le réglage que les gens ratent en premier. Artificial Analysis, un tiers plutôt que l'un ou l'autre des fournisseurs, a mesuré 153,9 tokens de sortie par seconde pour la variante de raisonnement max de GPT-6 Luna, avec 124,23 secondes avant le premier token. C'est plus long que ce que la plupart des gens attendent avant de conclure qu'un processus est bloqué.
Réglez donc délibérément le délai d'expiration par Task, et laissez le répertoire de travail en mode Temporary pour que chaque Task obtienne un répertoire isolé et un worktree neuf. Deux exécutions Luna sur le même dépôt ne peuvent alors pas s'écraser mutuellement, et une exécution qui réfléchit se distingue d'une exécution qui a planté, parce que la Task porte un statut, ce que l'historique d'un terminal ne fait pas.
Où placer un Runtime économique dans une Crew
Une Crew est un groupe réutilisable de People et d'Agents coordonné par un Agent leader. La règle de placement qui découle des propres chiffres d'OpenAI est que Luna a sa place parmi les membres, et non au sommet.
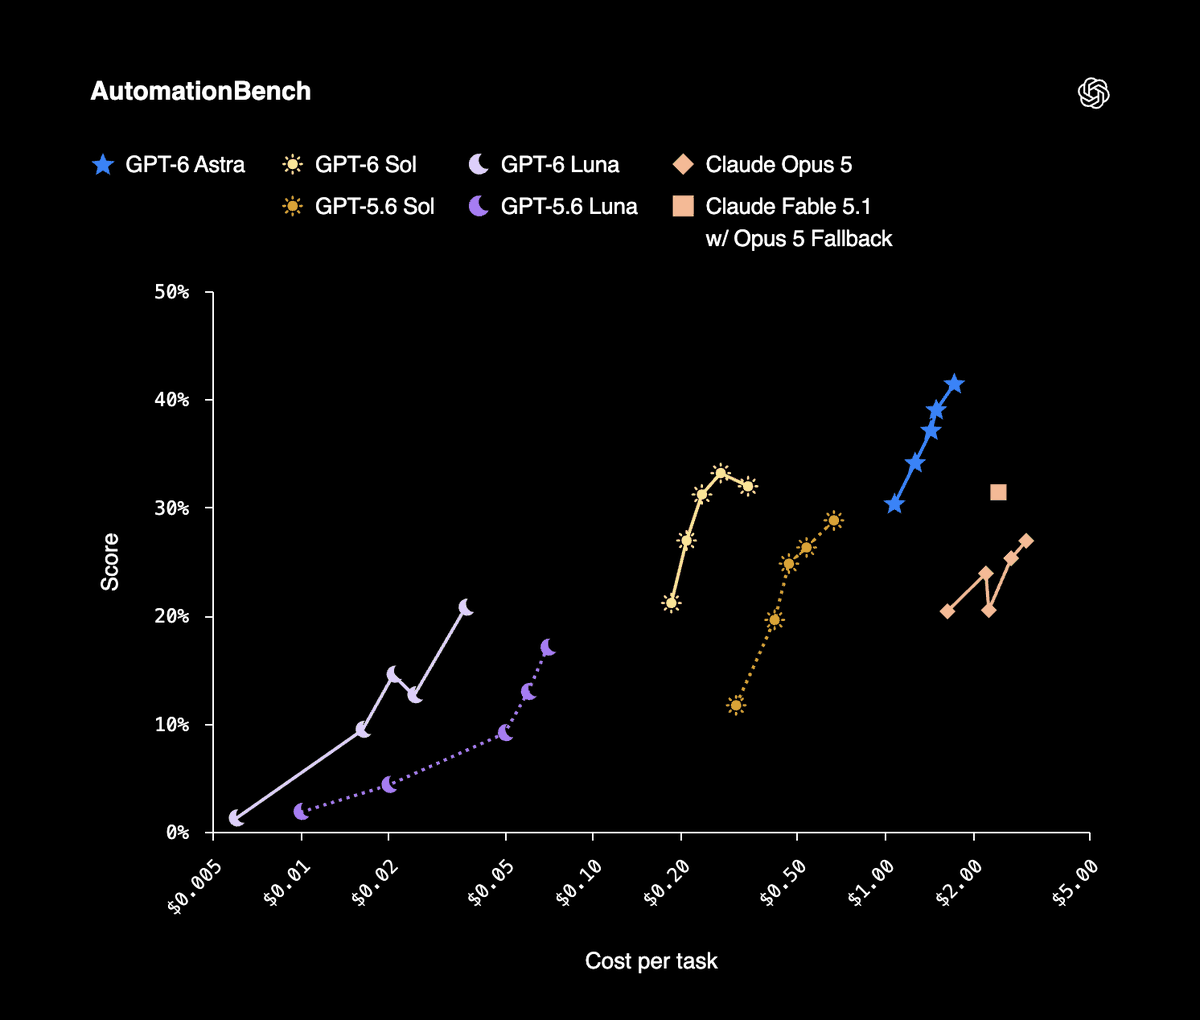
Le cas du membre est solide. Sur DeepSWE 1.1, OpenAI rapporte que Luna en effort max obtient 66,6 %, comparable à Claude Opus 5 et Fable 5 en effort medium, pour un coût par tâche inférieur de 93 % à celui d'Opus 5 et de 96 % à celui de Fable 5. Sur OSWorld 2.0 hors ligne, Luna en max bat GPT-5.6 Sol en medium pour un dixième du coût. Sur AutomationBench 1.0.6, Luna en high dépasse son prédécesseur de 5,4 points de pourcentage pour un coût par tâche inférieur de 58 %, et sur la factualité, Luna à effort plus élevé égale GPT-5.6 Sol pour environ un centième du coût. OpenAI décrit aussi Sol et Luna comme 50 % moins chers que le tarif promotionnel de GPT-5.6, et ce qualificatif est celui d'OpenAI : la référence est un tarif promotionnel, pas un tarif catalogue.
Le cas du leader est faible, et ce n'est pas à cause d'un benchmark. Un leader interprète l'objectif, décide de ce que font les membres et ramène leurs résultats dans une seule Task. Une erreur d'interprétation au sommet n'est pas une mauvaise exécution : c'est l'exécution de chaque membre pointée vers la mauvaise chose, et l'économie réalisée sur les tokens du leader est un arrondi négligeable face à cela. Notre guide du leader de Crew défend le même argument à l'autre extrémité de la grille tarifaire.
| Travail | Voie | Pourquoi |
|---|---|---|
| Triage, étiquetage, entretien du backlog | Luna | Volume élevé, et une personne peut vérifier le verdict en quelques secondes |
| Échafaudage de tests, premières notes de relecture | Luna en effort high | Les gains publiés s'obtiennent en high ou max, pas à un réglage inférieur |
| Modifications du code mis en production | GPT-6 Sol à $2 / $10 | AutomationBench 33,2 % à 0,27 $ par tâche |
| Interprétation d'un objectif ambigu pour une Crew | GPT-6 Sol, ou Astra à $10 / $50 | Une erreur du leader se multiplie sur tous les membres |
Consignez cela comme une règle plutôt qu'une habitude. Quel modèle pour quelle tâche de codage couvre en détail la question du routage.
Une réserve sur la lecture des marges d'OpenAI : son article de lancement se compare à Claude Opus 5, et Anthropic a remplacé Opus 5 par Opus 5.5 quelques heures plus tard, le jour même. Les comparaisons de Luna ci-dessus sont mesurées par rapport à la génération précédente du modèle qu'elles nomment.
Ce qu'un Runtime économique ne rend pas moins cher
Luna fait baisser le prix de production d'une modification. Il ne change rien au prix de son acceptation. Dix exécutions bon marché produisent dix diffs, dix ensembles de sorties de tests et dix décisions que seule une personne peut prendre ; et les chiffres de dépenses d'OpenAI sont un avertissement plutôt qu'une rassurance : ils font état d'un chercheur médian à plus de 600 $ par jour sur les agents de codage, le 90e percentile atteignant 7 000 $. Un coût par tâche plus faible, voilà comment une facture de ce genre se construit.
La version honnête du discours, donc. Un Runtime économique vaut la peine d'être associé lorsque le travail qu'il prend en charge est un travail qu'une personne peut vérifier rapidement ; c'est une fausse économie lorsqu'il multiplie la file d'attente devant votre relecteur. Gardez le contexte, l'avancement, les blocages, les résultats et la relecture humaine visibles de la demande à la mise en production, et choisissez la voie au moment de l'assignation plutôt qu'au moment de la relecture. La relecture humaine est le goulot d'étranglement aborde le volet planification de tout cela.
Si vous faites déjà tourner plusieurs agents de codage, connectez un Computer, créez un Agent sur la voie économique et confiez-lui quelque chose d'ennuyeux.


