
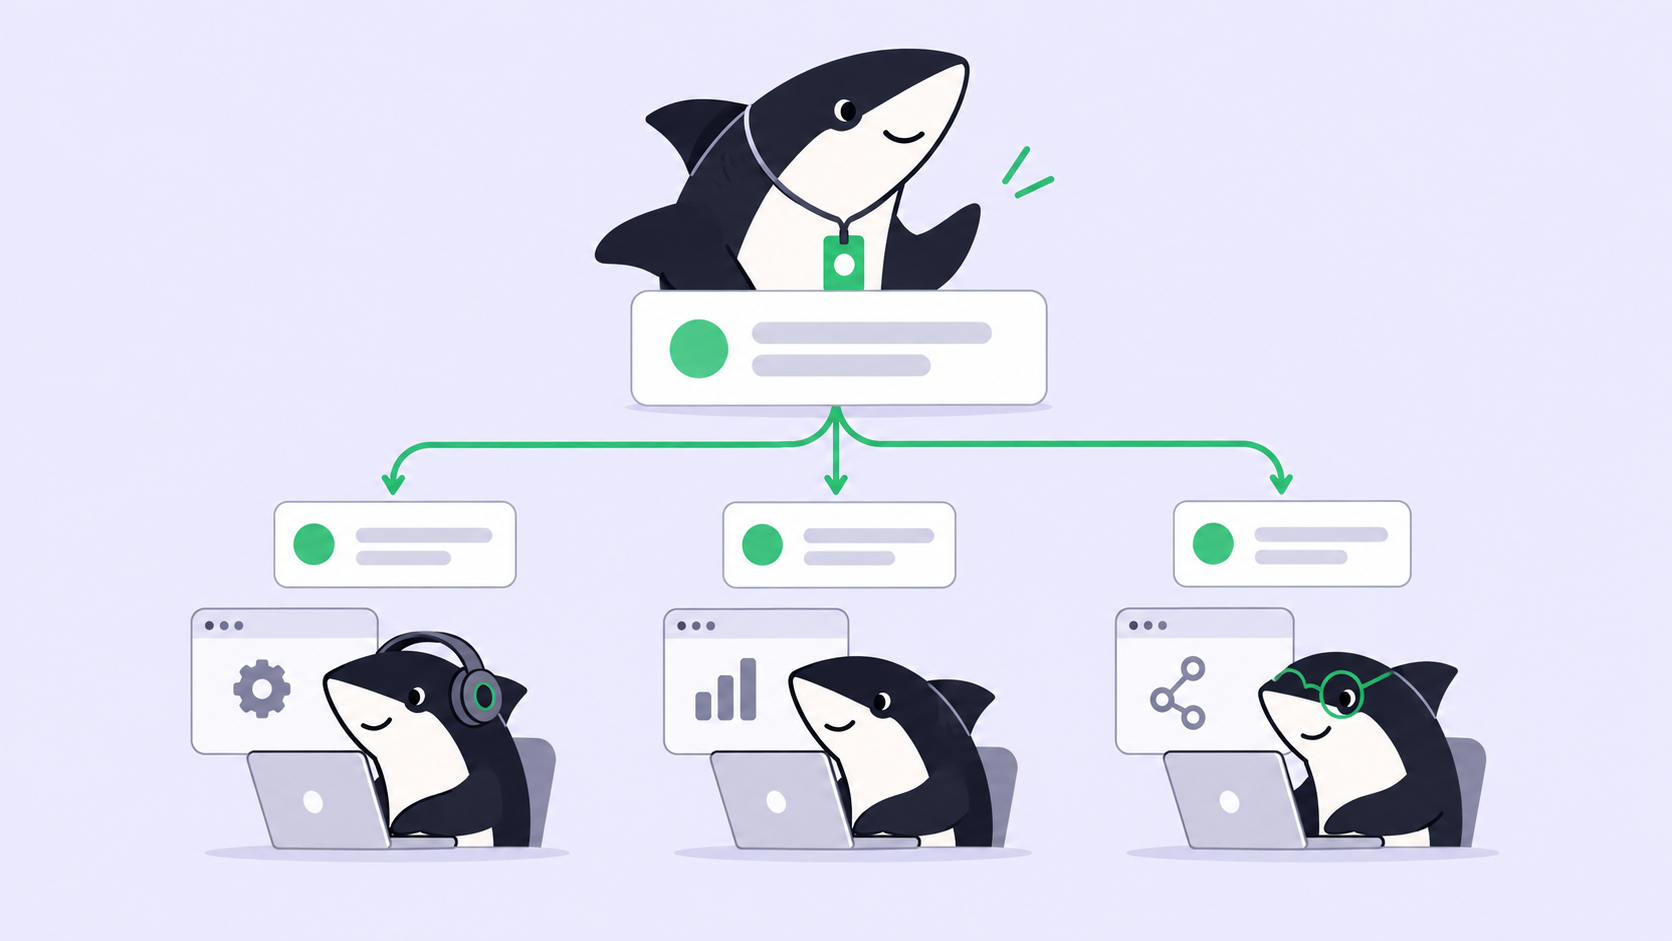
Un leader de Crew n'écrit presque pas de code. Il lit la Tâche, décide qui doit agir, mentionne les membres dont il a besoin, attend, lit ce qui lui revient, puis combine le tout ou renvoie le travail. Avec GPT-6 Astra à 10 $ par million de tokens d'entrée et 50 $ par million de tokens de sortie, l'Agent qui produisait le moins de code affichait le tarif le plus élevé du Crew.
OpenAI a lancé GPT-6 Sol le 22/09/2026 à 2 $ en entrée et 10 $ en sortie, identifiant API gpt-6-sol, soit un cinquième du tarif d'Astra des deux côtés. Cela ne fait pas de Sol le modèle le plus intelligent du marché. Cela rend le poste de coordination assez bon marché pour être pourvu sur chaque Crew que vous lancez.
Nous avions plaidé pour Astra dans GPT-6 Astra comme leader de votre Crew : confiez le poste qui décide au meilleur jugement de l'équipe, et les membres peuvent rester ordinaires. Cet argument tient toujours. Ce qui a changé, c'est le prix de sa mise en œuvre. Ce qui n'a pas changé, c'est la file de travaux terminés qui attendent qu'une personne les valide.
TL;DR
Un Crew est un groupe réutilisable de Personnes et d'Agents coordonné par un Agent leader, et l'exécution commence toujours par le leader : celui-ci lit le contexte de la Tâche et les instructions du Crew avant que le moindre membre ne démarre. Ce poste est gourmand en entrée et s'exécute plus d'une fois par Tâche, si bien que sa facture suit la lecture, pas l'écriture. Sol à 2 $ / 10 $, avec 90 % de remise sur les lectures d'entrée mises en cache, permet de garder un leader sur chaque Crew sans se ruiner. Gardez Astra ou Claude Opus 5.5 à ce poste lorsque l'exigence elle-même est ambiguë. Les Agents font la recherche, l'exécution, les tests et le reporting. Les Personnes donnent la direction, accordent l'autorité et valident le résultat.
Ce que le poste de leader dépense réellement
La documentation Sharkly décrit l'exécution d'un Crew comme une séquence figée. Si la Tâche est dans un statut exécutable et que le leader est prêt, c'est l'Agent leader qui démarre en premier. Il lit le contexte de la Tâche et les instructions du Crew, puis soit traite le travail lui-même, soit mentionne les membres Agents éligibles pour des contributions précises. Leurs résultats reviennent dans la Tâche, et le leader combine ce qui lui a été renvoyé.
Voyez-y un profil de facturation. Chaque tour du leader commence par de la lecture : la description, les commentaires ajoutés depuis la dernière fois, les instructions du Crew, les rôles disponibles et tout ce que les membres ont déjà publié. Il se termine par la rédaction d'une courte décision ou d'une mention. Beaucoup d'entrée, peu de sortie, et cela se répète.
Et ce poste est plus sollicité que la plupart des équipes ne l'imaginent, car le leader ne s'exécute pas une seule fois par Tâche. Sur une Tâche assignée à un Crew, un simple commentaire éligible d'un membre peut déclencher le leader du Crew, selon la même condition de disponibilité que n'importe quelle autre exécution. Une Tâche dont la discussion est active est une Tâche dont le leader a relu le fil plusieurs fois.
| Candidat au poste de leader | Identifiant API | Entrée / sortie pour 1 M | Entrée en cache |
|---|---|---|---|
| GPT-6 Astra | non communiqué | 10 $ / 50 $ | non communiqué |
| Claude Opus 5.5 | claude-opus-5-5 |
4 $ / 20 $ | 0,20 $ en lecture, 5 $ en écriture |
| GPT-6 Sol | gpt-6-sol |
2 $ / 10 $ | 90 % de remise sur les lectures |
| GPT-6 Luna | gpt-6-luna |
0,10 $ / 0,50 $ | 90 % de remise sur les lectures |
Ce sont les tarifs API des fournisseurs, et ils figurent ici pour les rapports qu'ils révèlent, pas pour la facture. L'usage des modèles continue de passer par les abonnements ou les clés API configurés dans vos outils de développement : ce que paie votre équipe dépend donc des forfaits auxquels elle est connectée.
Le coût par tâche, pas le coût par token
Un leader qui interprète mal une exigence coûte une journée d'exécutions de membres : la grille tarifaire n'est donc pas le bon endroit pour trancher. OpenAI publie le coût par tâche à côté du score, ce qui est bien plus proche de la vraie question.
| AutomationBench 1.0.6, tel que publié par OpenAI | Score | Coût par tâche |
|---|---|---|
| GPT-6 Sol, effort très élevé | 33,2 % | 0,27 $ |
| GPT-6 Astra, effort faible | 30,3 % | 3,9x Sol |
| Claude Opus 5, effort maximal | 26,9 % | 11,1x Sol |
Sur Agents' Last Exam V1, Sol en effort maximal obtient 56,4 %, au-dessus du meilleur résultat d'Opus 5, pour un coût par tâche inférieur de 60 %.
Trois réserves honnêtes avant de dépenser quoi que ce soit sur la foi de ce tableau. Il s'agit d'exécutions de benchmarks portant sur l'Agent entier, et non sur le leader ; personne ne publie de chiffre sur le coût de la coordination, et la facture réelle de votre leader dépend du bavardage de vos Tâches. La ligne Astra correspond à un effort de raisonnement faible, un point de comparaison choisi par OpenAI lui-même, et non à Astra travaillant à fond. Et OpenAI affirme clairement qu'Astra « reste notre meilleur modèle dans tous les domaines », tandis qu'Artificial Analysis, un tiers, situe l'indice d'intelligence de Sol à 48 contre 58 pour Claude Opus 5.5. Sol n'est pas le modèle le plus puissant que vous puissiez installer à ce poste. C'est le plus puissant que vous puissiez vous permettre d'y laisser en permanence, sur chaque Crew.
La mise en cache, une remise qui profite surtout au poste de leader
GPT-6 augmente par défaut les taux de succès du cache et applique une remise de 90 % sur les lectures d'entrée mises en cache. Deux changements comptent davantage pour un leader que pour un membre : modifier l'effort de raisonnement ou l'ensemble des outils disponibles n'invalide plus le cache, et des points de rupture explicites permettent de choisir où se termine un préfixe mis en cache. OpenAI cite GitHub, qui a vu plus de 50 % de tokens de prompt en moins à retraiter, sur des milliards de requêtes.
Dans un Crew, le leader est le pire contrevenant en matière de contexte renvoyé. Il relit les mêmes instructions de Crew, les mêmes conventions de dépôt et un fil de Tâche qui s'allonge à chaque tour, et ce préfixe est presque identique à chaque fois. C'est exactement la forme pour laquelle un préfixe mis en cache est conçu. La configuration se trouve dans le Runtime, sur le Computer, et non sur l'Agent ; comment exécuter des agents GPT-6 Sol dans Sharkly indique où la placer.
Quand garder Astra ou Opus 5.5 à ce poste
Utilisez Sol comme leader quand le Crew traite chaque jour de nombreuses Tâches bien délimitées, que les rôles sont stables et que l'essentiel du jugement peut être couché par écrit dans les instructions du Crew plutôt que reconstruit à chaque exécution. Gardez un modèle plus cher à ce poste quand l'exigence elle-même est ambiguë, quand une mauvaise interprétation enverrait trois membres sur la mauvaise piste, ou quand la Tâche est un long travail unique plutôt qu'une multitude de petites Tâches.
Un leader moins cher n'est pas une raison de confier à un Crew un travail qu'un seul Agent peut faire. La documentation est limpide là-dessus : pour un travail petit et bien défini, assignez la Tâche directement à un Agent. Utilisez un Crew quand le leader doit interpréter l'objectif, impliquer d'autres membres Agents et ramener leurs résultats dans une seule Tâche. Une correction d'un seul fichier passée par un Crew paie une exécution de coordination dont elle n'a jamais eu besoin, quel que soit le tarif.
Changer le modèle du leader ne change rien non plus à la propriété. L'Owner gère le Crew ; le leader coordonne l'exécution.
C'est en couchant le jugement par écrit qu'un poste moins cher devient viable :
You lead this Crew. Read the Task and the comments added since your
last turn, then pick the smallest set of members that can finish it.
Mention @backend for API and job changes, @tests for coverage,
@docs for user-facing pages.
Ask a person only when two readings of the requirement would produce
different designs. Otherwise state your assumption and proceed.
Combine member results into one summary: what changed, what you ran,
what failed, what you did not cover. Leave acceptance to a person.
Une remarque opérationnelle avant de faire confiance à un long tour de leader. Artificial Analysis a mesuré 102,15 secondes jusqu'au premier token pour la variante de raisonnement maximal de GPT-6 Sol, un chiffre tiers correspondant à une configuration en effort maximal, et non à une donnée du fournisseur. [VERIFY] Tout le Crew attend le premier tour du leader : un leader qui réfléchit et un leader qui est bloqué se ressemblent donc, tant qu'un statut ne dit pas le contraire.
La facture qui n'a pas bougé
OpenAI indique que son chercheur médian dépense plus de 600 $ par jour en agents de codage, et que le 90e percentile dépense 7 000 $. Aux tarifs de Sol, une équipe qui rationnait ses exécutions de Crew peut désormais s'en offrir plusieurs fois plus, et chacune d'elles se termine par un résultat qu'une personne doit lire.
Voilà la contrainte qu'une baisse de prix aggrave au lieu de l'atténuer. Une coordination moins chère achète plus de travail en parallèle, plus de diffs et plus de décisions par semaine, face à une capacité de relecture mesurée en heures humaines, qui n'a pas changé le 22/09/2026. Les Agents font la recherche, l'exécution, les tests et le reporting. Les Personnes donnent la direction, accordent l'autorité et valident le résultat. L'automatisation s'arrête là où le jugement de l'équipe est requis.
C'est pourquoi la production du leader compte plus que son tarif. Une exécution de leader qui se termine par un long fil à faire défiler ne vaut rien à 0,27 $, et rien à 3 $ non plus. Une exécution de leader qui ramène dans une seule Tâche le plan, les résultats des membres, les vérifications, les échecs et la question en suspens permet à une personne de valider le travail en quelques minutes au lieu de le reconstituer. Gardez le contexte, l'avancement, les blocages, les résultats et la relecture humaine visibles de la demande à la livraison : le poste moins cher devient alors du débit, et non du retard.
Ce qu'il faut changer cette semaine
- Choisissez un Crew dont le leader est coûteux et pointez son Runtime vers
gpt-6-solsur ce Computer. - Transférez par écrit dans les instructions du Crew le jugement que vous payiez le leader pour improviser.
- Lancez un Sprint et comparez deux chiffres avec le précédent : les Tâches terminées et les Tâches renvoyées après relecture. Si les renvois ont augmenté, l'ancien poste faisait plus que vous ne le pensiez.
Si vous faites déjà tourner plusieurs agents, Sharkly vous offre un seul endroit pour gérer leurs tâches et leurs résultats.


