
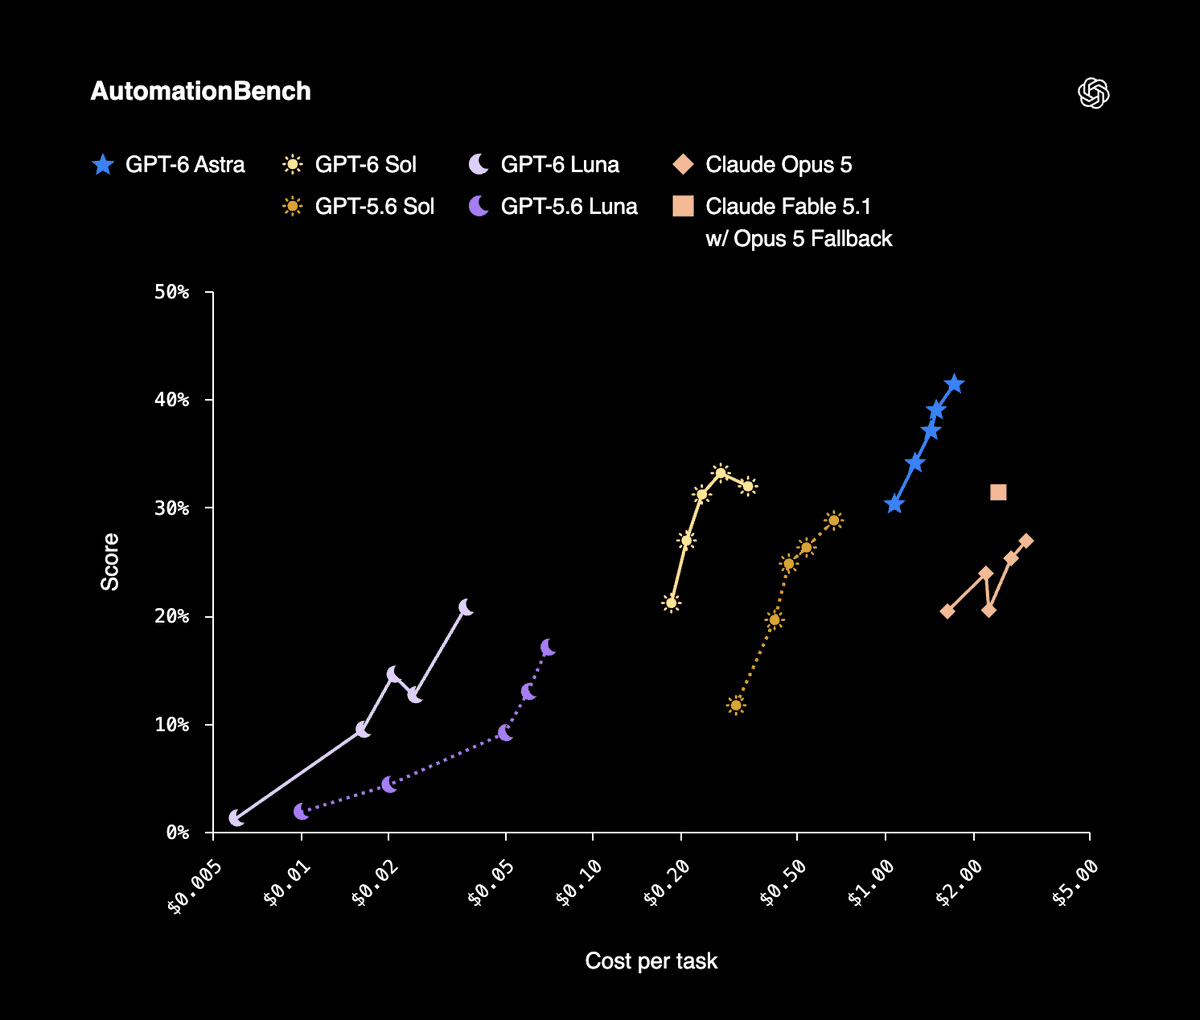
OpenAI a lancé GPT-6 Sol le 22 septembre à 2 $ par million de tokens en entrée et 10 $ par million en sortie, avec l'identifiant d'API gpt-6-sol et une fenêtre de contexte de 872k. Le chiffre qui devrait changer la façon dont votre comité de direction voit les choses n'est pas le tarif par token. C'est le coût par tâche terminée : d'après les résultats d'AutomationBench 1.0.6 d'OpenAI, Sol avec un effort de raisonnement xhigh obtient 33,2 % à 0,27 $ par tâche, tandis que Claude Opus 5 en effort maximal obtient 26,9 % à un coût par tâche 11,1 fois supérieur à celui de Sol.
Lisez cela comme une déclaration budgétaire plutôt que comme un classement. Si votre équipe rationnait les exécutions d'agents parce qu'une exécution complète coûtait cher, cette contrainte vient de se déplacer. La prochaine contrainte est celle que personne ne peut contourner à coups d'argent : quelqu'un doit toujours lire le diff et accepter le travail. Ce guide emprunte le chemin utile le plus court à travers la configuration, puis reste honnête sur la partie que la baisse de prix ne résout pas. Installez Sol dans Codex sur un seul Computer, créez un seul Agent, assignez une vraie Task.
TL;DR
Définissez model = "gpt-6-sol" dans Codex sur un Computer connecté, vérifiez que le Codex Runtime affiche Available dans Sharkly, laissez le répertoire de travail de l'Agent en mode Temporary, augmentez le timeout par Task avant de faire confiance à la première longue exécution, puis assignez une seule Task. Sharkly n'affichera pas le nom du modèle. Il affichera l'exécution, le log, les questions et le résultat sur la Task. Les agents font la recherche, exécutent, testent et rendent compte. Les humains donnent la direction, accordent l'autorité et acceptent le résultat.
Où se trouve le paramètre de modèle
Sharkly ne choisit pas les modèles. La documentation des Agents le dit clairement : « L'Agent suit le modèle par défaut du Runtime. Il ne promet ni n'affiche de nom de modèle spécifique. Changez de modèle dans la configuration du Runtime ou de l'outil Computer, pas sur l'Agent. »
Il n'y a pas de menu déroulant de modèle sur un Agent, ni de contrôle de profondeur de réflexion non plus, alors ne cherchez pas. Quatre rôles, un seul travail chacun. L'Agent définit comment le travail doit être traité. Le Computer fournit l'hôte et les ressources locales. Le Runtime exécute la session d'agent proprement dite, et Codex est le Runtime ici. La Task reste l'enregistrement partagé pour l'équipe.
Étape 1 : mettre GPT-6 Sol dans Codex sur le Computer
Sur le Computer qui va l'exécuter, mettez Codex à jour et connectez-vous avec un compte ou une clé API ayant accès à Sol. OpenAI a rendu Sol disponible dans ChatGPT Work et dans Codex pour les offres Plus, Pro, Business, Enterprise et Edu, et il n'est pas encore dans Chat. Si codex -m gpt-6-sol démarre une session dans un terminal simple sur cet hôte, Sharkly peut l'utiliser.
Ensuite, définissez la valeur par défaut pour que chaque exécution sur ce Computer la prenne en compte :
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
Deux mises en garde sur cet extrait. Le nom de la clé d'effort de raisonnement diffère selon les versions de Codex, alors vérifiez-le par rapport à la configuration exemple de la version de Codex installée sur ce Computer. Et le niveau d'effort est une décision de coût, pas un réglage de qualité que l'on laisse au maximum : les résultats publiés par OpenAI utilisent différents niveaux d'effort selon les benchmarks, et le chiffre de 0,27 $ par tâche ci-dessus correspond à la ligne xhigh. [VERIFY]
De retour dans Sharkly, ouvrez le détail du Computer et lancez le rescan ou le test de connexion. Le Codex Runtime devrait afficher Available. Un Computer qui apparaît simplement online signifie seulement que son service local envoie des heartbeats. C'est le statut de capacité du Runtime qui vous indique qu'une exécution peut démarrer.
Étape 2 : configurer le cache avant de faire grossir la Crew
C'est le changement apporté par GPT-6 qui compte le plus dès que plusieurs Agents travaillent dans le même dépôt, et c'est celui que la plupart des équipes vont ignorer.
OpenAI rapporte des taux de hit de cache plus élevés par défaut avec GPT-6, une remise de 90 % sur les lectures d'entrée mises en cache, un tableau de bord de mise en cache des prompts et un outil de diagnostic, et, ce qui est important pour le travail d'agent, le fait que modifier l'effort de raisonnement ou la disponibilité des outils n'invalide plus le cache. Des points de rupture explicites vous permettent de choisir où se termine un préfixe mis en cache. OpenAI cite GitHub qui observe plus de 50 % de tokens de prompt en moins nécessitant un traitement à neuf sur des milliards de requêtes.
Pour une crew, la forme pratique est la suivante. Chaque exécution d'Agent sur le même dépôt renvoie un préfixe volumineux et presque identique : la structure du dépôt, les règles maison, la commande de test, les conventions. Ce préfixe est exactement ce à quoi sert un cache, et c'est la raison pour laquelle une flotte d'agents peut coûter bien moins cher par exécution que le premier agent.
Une paire de décisions, car ce n'est pas du travail gratuit. Épinglez un préfixe stable et définissez un point de rupture explicite lorsque plusieurs Agents s'exécutent de manière répétée sur une même base de code et que vos textes de Skill et d'instructions sont figés. Ne vous en embêtez pas lorsqu'un Agent s'exécute une poignée de fois par semaine ou que ses instructions changent encore chaque semaine, car vous passerez plus de temps à maintenir la frontière que vous n'en économiserez.
Étape 3 : construire l'Agent autour d'une exécution qui démarre lentement
Ouvrez Agents, sélectionnez New Agent, choisissez le Computer et le Codex Runtime, puis réglez trois choses.
Timeout par Task. Réglez-le délibérément, car une exécution Sol dans un mode de raisonnement élevé peut sembler morte avant de sembler occupée. Artificial Analysis, un tiers et non l'un des deux fournisseurs, a mesuré 102,15 secondes jusqu'au premier token pour la variante à raisonnement maximal de GPT-6 Sol. C'est plus long que ce que la plupart des gens attendent avant de supposer qu'un processus s'est bloqué, et c'est exactement la défaillance qu'un statut sur un tableau partagé évite, contrairement à un terminal. Une exécution qui réfléchit et une exécution qui a planté sont identiques dans un scrollback. Consultez coding agent observability pour savoir ce qu'un statut doit porter pour valoir la peine d'être lu.
Répertoire de travail. Mode Temporary. Chaque Task dispose d'un répertoire isolé, et les exécutions adossées à un dépôt préparent un worktree neuf, de sorte que deux exécutions Sol sur le même dépôt ne peuvent pas s'écraser mutuellement. La concurrence par défaut pour les répertoires temporaires est de 50 % de la limite du Computer. Laissez-la ainsi jusqu'à ce que ce Computer ait traité plusieurs exécutions réelles ; une concurrence plus élevée consomme en même temps du CPU, de la mémoire, du disque et de la capacité du fournisseur.
Instructions. Courtes et stables :
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
Étape 4 : assignez une Task, puis décidez si une Crew mérite sa place
Choisissez une Task avec un critère d'acceptation clair. Sélectionnez l'Agent comme Assignee et faites sortir la Task de Backlog vers un statut dont la catégorie indique qu'elle est prête à être traitée ; une Task assignée en Backlog attend. L'exécution passe par les états queued, dispatched et running, et l'onglet Executions diffuse le log. Si l'Agent a besoin d'une décision, la question revient sur la Task sous forme de commentaire, la Task affiche waiting for human reply, et cela est acheminé vers votre Inbox.
Pour un changement bien délimité, un seul Agent est le bon choix et les pièces mobiles restent à zéro. Une Crew est un groupe réutilisable de People et d'Agents coordonné par un Agent leader, et elle mérite sa place lorsque le leader doit interpréter un objectif et ramener dans une seule Task les résultats de plusieurs membres.
Sol change ce calcul, car un leader lit, planifie, assigne et révise principalement, et c'était le travail le plus difficile à justifier en haut d'une grille tarifaire :
| Runtime model | API id | Input / output per 1M | Where it fits on a Crew |
|---|---|---|---|
| GPT-6 Astra | not stated | $10 / $50 | Leader when the plan itself is the hard part |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Leader and the members doing real changes |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | High volume members: triage, labelling, scaffolding |
Nous avons écrit la même configuration pour Astra dans running GPT-6 Astra as a Crew leader. L'argument tient toujours ; le prix en dessous, lui, a bougé.
Ce que la baisse de prix n'achète pas
OpenAI décrit Sol comme 50 % moins cher que le tarif promotionnel de GPT-5.6. Ce qualificatif est celui d'OpenAI lui-même et il compte, car la base de comparaison est un tarif promotionnel et non un tarif catalogue. Deux autres réserves méritent d'être notées sur la même page. Les benchmarks de lancement d'OpenAI se comparent à Claude Opus 5, qu'Anthropic a remplacé par Opus 5.5 quelques heures plus tard le même jour, donc lisez ces écarts comme mesurés face à la génération précédente. Et c'est le niveau d'effort qui fait le travail : Sol atteint 68,8 % sur DeepSWE 1.1 et 56,4 % sur Agents' Last Exam V1 en effort maximal, pas au réglage que vous laisseriez activé pour des tâches de routine.
Puis vient la partie qui ne concerne pas du tout le modèle. OpenAI rapporte que son propre chercheur médian dépense plus de 600 $ par jour en agents de codage, le 90e percentile dépassant 7 000 $. Un coût moindre par tâche, c'est la façon dont une facture comme celle-là se construit, pas dont elle s'évite. Chaque exécution produit toujours un changement qu'une personne doit lire, questionner et accepter, et cette file d'attente n'a pas été 11 fois moins chère cette semaine. Planifiez autour de la capacité de revue plutôt que du choix de modèle, consignez le routage sous forme de règle plutôt que de préférence, et gardez l'assignation, la progression, les blocages, les résultats et la revue humaine au même endroit, de la demande à la mise en production.
Si vous faites déjà tourner plusieurs agents de codage, connectez un seul Computer, créez un seul Agent et assignez-lui quelque chose d'ennuyeux.


