
Vous cherchez à déterminer à quel agent de codage confier du vrai travail : Claude Code, Codex, Gemini CLI, OpenCode, ou deux d'entre eux en même temps. Vous consultez donc les scores des benchmarks. Un agent résout 68 % d'un ensemble de tâches public, un autre 71 %, et c'est censé suffire pour faire votre choix. Puis l'agent arrive dans votre dépôt et se bloque sur une étape de build qu'aucun jeu de données public n'a jamais vue.
Un benchmark mesure un ensemble de problèmes figé et partagé. Votre base de code, elle, est un ensemble de problèmes privé : vos conventions, l'organisation de votre monorepo, le test instable que tout le monde ignore, le script de déploiement qu'une seule personne maîtrise. Le score qui décide de votre semaine, c'est celui que vous générez sur ce code, pas celui qu'un laboratoire a publié. Ce guide présente une méthode pour comparer les agents de codage sur les logiciels que vous livrez réellement, et pour mener cette comparaison sans ouvrir cinq terminaux afin de garder les agents séparés les uns des autres.
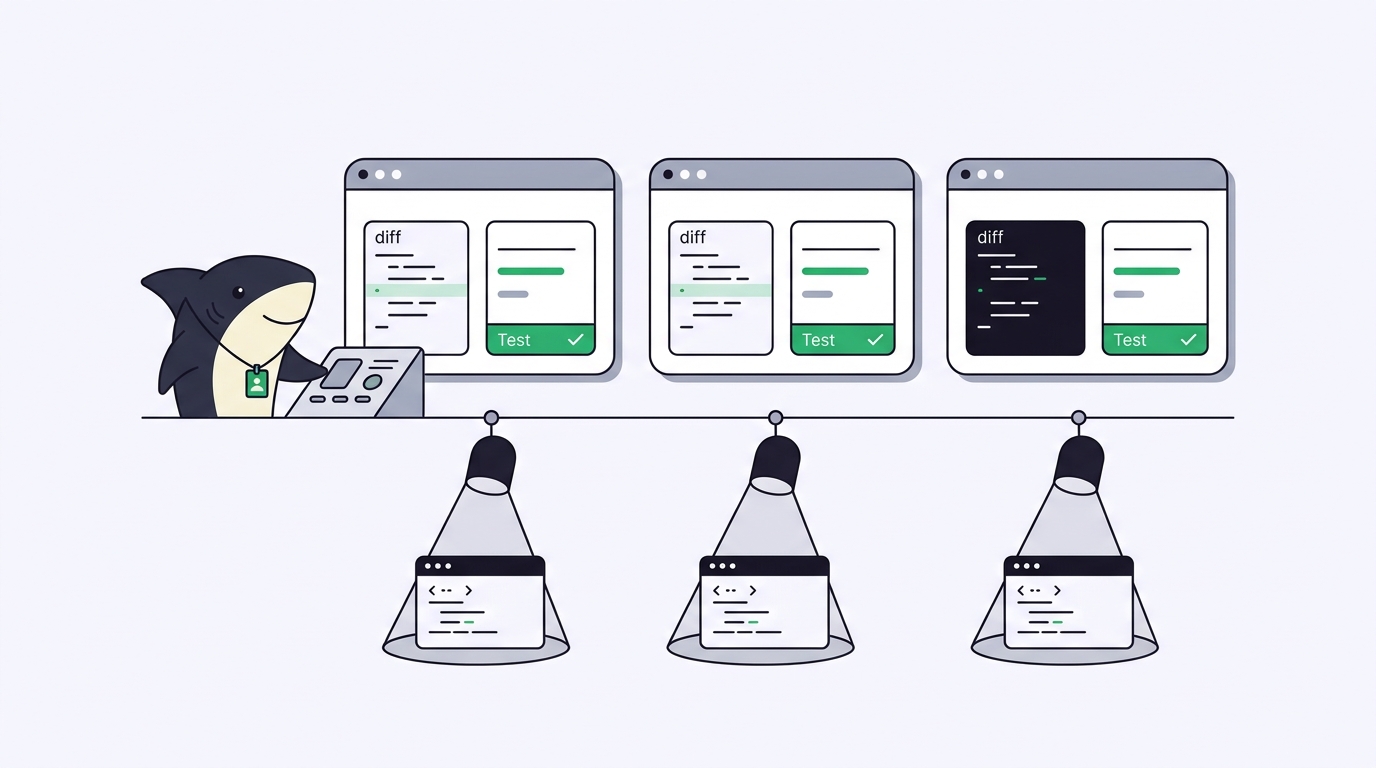
C'est là qu'intervient Sharkly. Sharkly est une plateforme tout-en-un de commande et de gestion d'Agents : vous connectez votre propre Ordinateur, attribuez la même Tâche à différents Agents, et chaque exécution renvoie son diff, sa sortie de tests et sa revue au même endroit. C'est ce qui rend une comparaison équitable possible. La variable que vous voulez mesurer, c'est l'agent, pas la jonglerie entre terminaux à laquelle vous devriez vous livrer pour éviter que trois exécutions se marchent sur les pieds.
Un score de benchmark mesure un jeu de données, pas votre dépôt
Un benchmark d'agents de codage est un ensemble de tests public et figé, noté de la même manière pour tout le monde. C'est précisément ce qui le rend utile aux laboratoires qui construisent des modèles, et précisément ce qui en fait un mauvais outil de prédiction pour vous.
Les benchmarks publics comme SWE-bench tirent leurs tâches de projets open source bien connus, avec un harnais ajusté et des critères d'acceptation soigneusement sélectionnés. Rien de tout cela ne décrit votre mardi. Ce qui détermine la performance d'un agent sur votre code, c'est justement ce qu'un jeu de données public ne pourra jamais contenir : vos bibliothèques internes que le modèle n'a jamais lues, votre configuration de lint, le fichier de contexte de 400 lignes qui explique comment le service démarre réellement, le seul module dépourvu de tests.
Un score de benchmark élevé ne prédit pas le comportement d'un agent dans votre dépôt. Il prédit son comportement dans celui de quelqu'un d'autre. Considérez le classement comme un filtre grossier pour savoir quels agents méritent d'être testés, puis faites le test qui compte. Si vous hésitez encore sur le modèle à associer à chaque agent, associer les modèles aux rôles des agents est une meilleure question de départ que le score brut.
Choisissez une vraie tâche, pas un prompt jouet
Commencez par la comparaison utile la plus simple. Ne benchmarkez pas les agents sur « crée une application de todo ». Choisissez une vraie exigence de votre backlog : un bug bien délimité, une petite fonctionnalité sur un seul module, une migration que vous alliez faire de toute façon. Quelque chose avec un test d'acceptation que vous pouvez exécuter et un diff que vous pouvez lire en quelques minutes.
Ensuite, donnez à chaque agent une entrée identique : la même description de tâche, le même commit de départ, les mêmes critères d'acceptation. Rédigez-la comme le ferait votre outil de suivi, une tâche comme SH-312: fix the timezone drift in the invoice export. Si un agent reçoit un prompt plus riche qu'un autre, vous mesurez votre prompt, pas l'agent.
Utilisez une correction de bug quand vous voulez voir comment un agent lit du code existant et reste dans les clous. Utilisez une petite fonctionnalité quand vous voulez voir comment il structure du code nouveau et s'il écrit ses propres tests. Faites les deux au fil du temps ; une seule tâche ne vous renseigne que sur une seule tâche.
Comparez chaque agent à son meilleur niveau, jamais à son pire
Chaque agent a une configuration dans laquelle il donne le meilleur de lui-même : le bon modèle, le bon fichier de contexte, les permissions dont il a réellement besoin. Donnez à Claude Code son CLAUDE.md, à Codex sa config, à chaque Runtime l'environnement recommandé par sa documentation. Comparer un agent bien configuré à un agent nu ne vous apprend rien, sinon lequel vous avez pris la peine de configurer.
Les faire tourner à leur meilleur niveau, côte à côte, c'est là que l'approche par terminaux s'effondre. Sur Sharkly, vous attribuez la même Tâche à chaque Agent, et chaque Agent s'exécute sur un Ordinateur connecté dans un worktree isolé, si bien que trois agents qui modifient le même dépôt ne touchent jamais aux fichiers les uns des autres. Vous obtenez trois tentatives propres sur le même problème au lieu d'un arbre de travail partagé et d'un merge à démêler à la main. Si vous faisiez cela manuellement, exécuter plusieurs agents en parallèle est précisément la partie que Sharkly est conçu pour vous retirer des épaules.
Si vous n'utilisez qu'un seul agent et vivez dans le terminal, une seule session Claude Code bien réglée dans un worktree suffit, et vous n'avez peut-être pas besoin de tout cela. L'équation change dès que vous comparez deux agents ou plus, sur plus d'une tâche, et que vous voulez les résultats sous une forme réellement lisible côte à côte.
Cinq critères qui départagent les agents sur du vrai travail
Un benchmark ne note qu'un seul chiffre : la tâche a-t-elle été réussie. Le vrai travail se joue sur cinq choses que ce chiffre laisse de côté.
| Critère | La question à laquelle il répond |
|---|---|
| Exécution parallèle | Puis-je exécuter les agents sur la même tâche en même temps, de manière isolée et sans conflits ? |
| Visibilité pour l'équipe | Quelqu'un d'autre que moi peut-il voir ce que chaque agent a fait, et pourquoi ? |
| Flux de revue | À quelle vitesse puis-je lire le diff, les tests et les limites connues, puis accepter ou rejeter ? |
| Exécution sur ma propre machine | L'agent s'exécute-t-il sur mon Ordinateur, dans mon véritable environnement et avec mes secrets ? |
| Intégrations | Le résultat arrive-t-il dans le tracker, le dépôt et les outils de revue que nous utilisons déjà ? |
Les quatre premiers critères sont précisément là où la plupart des agents semblent identiques dans un benchmark et se comportent de façon totalement différente sur votre code. L'exécution sur votre propre machine est particulièrement invisible pour un test public : un agent qui s'exécute face à votre vraie chaîne d'outils, votre base de données locale, vos véritables hooks CI, est testé sur ce que vous livrez, pas sur un sandbox qui y ressemble.
Les agents explorent, exécutent, testent et rendent compte. Vous fixez la direction, accordez l'autorité et acceptez le résultat. Une comparaison n'est honnête que si vous pouvez voir chacune de ces étapes, pour chaque agent, sans avoir à la reconstituer à partir de l'historique du terminal.
Évaluez ce qui revient, pas ce que l'agent prétend
Un agent qui affiche « terminé » n'est pas la même chose qu'une modification qui passe. Évaluez chaque exécution sur ce qui revient, pas sur ce qu'elle affirme. Pour chaque tentative, les éléments de preuve utiles sont toujours la même courte liste : le diff, les résultats de typecheck et de tests, le résumé des modifications et les limites que l'agent reconnaît. Sharkly garde le contexte, la progression, les blocages, les résultats et la revue humaine visibles de la demande à la livraison, si bien que la comparaison se lit comme un tableau de résultats plutôt que comme cinq terminaux dont vous devez vous souvenir.
C'est aussi là que le véritable goulot d'étranglement apparaît. Deux agents peuvent tous les deux « terminer » une tâche en vingt minutes et vous coûter tout de même une heure de revue chacun. Relire la production des agents constitue souvent la véritable limite à la quantité de travail parallèle qu'une équipe peut absorber, et cela devrait peser lourd dans le choix de votre agent. Ce qu'il faut pondérer dépend de qui fait le choix :
| Vous choisissez pour | Pondérez en priorité |
|---|---|
| Développeur solo | Le flux de revue et l'exécution sur votre propre machine ; vous êtes le seul relecteur |
| Petite équipe | L'exécution parallèle et la visibilité pour l'équipe ; plusieurs personnes doivent voir les mêmes exécutions |
| Équipe plateforme | Les intégrations et la visibilité ; le workflow doit survivre au prochain meilleur agent |
Cette dernière ligne est justement la raison de comparer. Le meilleur agent d'aujourd'hui ne sera peut-être pas le meilleur le trimestre prochain, et reconstruire votre workflow à chaque changement de leader est un impôt en soi. Sharkly n'est ni un agent de codage ni un harnais de benchmark ; c'est la couche qui vous permet de continuer à tester des agents sur votre propre code sans reconstruire le processus autour d'eux à chaque fois.
Si vous voulez continuer à utiliser plusieurs agents de codage plutôt que de vous engager dans un seul écosystème, c'est le problème autour duquel Sharkly est conçu. Téléchargez Sharkly, connectez un Ordinateur et attribuez la même vraie tâche à deux agents. La comparaison que vous obtenez porte sur votre base de code, la seule qui puisse prédire votre semaine.


