
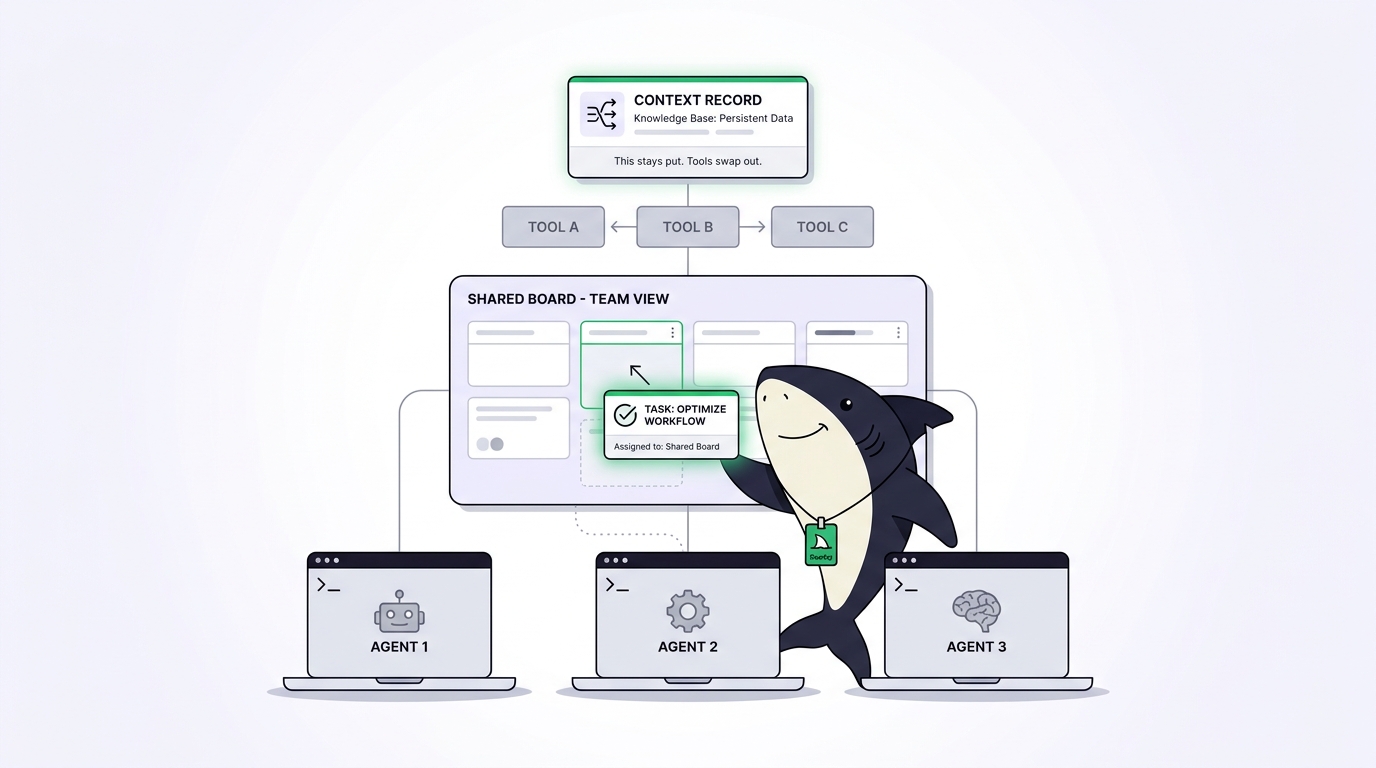
Vous lancez une fonctionnalité dans Claude Code. Elle se bloque sur une erreur de type coriace, alors vous confiez le même dépôt à Codex, qui excelle dans ce genre de tâche ingrate. Codex la corrige, mais il n’a désormais plus aucune idée de l’objectif de la fonctionnalité, des fichiers qu’il avait été convenu de ne pas toucher, ni de ce que signifie « terminé » ici. Vous réexpliquez tout de mémoire. Dix minutes plus tard, vous revenez à Claude Code, qui a tout oublié lui aussi. Le code a progressé. Le contexte, non.
C’est le prix à payer pour utiliser plus d’un agent de codage. Chaque outil conserve sa propre mémoire, dans son propre format et sa propre session ; dès que le travail passe d’un agent à un autre, tout ce qui n’est pas dans le diff tombe à l’eau. Préserver le contexte lors d’un changement d’agent de codage suppose de faire vivre ce contexte en dehors de tout agent individuel, sous une forme que le suivant peut lire sans que vous ayez à le lui raconter.
Cet article explique comment y parvenir, en s’appuyant sur Sharkly comme flux de travail : la couche qui se situe au-dessus de vos agents de codage et garde le contexte, l’avancement, les blocages, les résultats et la revue humaine visibles de la demande à la mise en production. Vous avez déjà des agents de codage. Le problème ici, c’est la couture entre eux, et elle s’élargit à chaque agent que vous ajoutez.
Pourquoi le contexte ne circule pas entre les agents
Le contexte d’une tâche de codage réside à trois endroits, et un seul est portable.
Le premier est le fichier d’instructions : CLAUDE.md, AGENTS.md, GEMINI.md. Les règles permanentes, les conventions, les commandes pour lancer les tests. Le deuxième est l’état de la session : l’historique de ce que vous et l’agent venez de vous dire, ce qu’il a essayé, ce qu’il a écarté. Le troisième est l’artefact lui-même, le diff sur le disque ou la branche.
Seul le troisième circule gratuitement. Un autre agent peut lire le code, mais il ne peut pas lire une conversation à laquelle il n’a pas participé, et il ne lira pas un fichier d’instructions destiné à un autre outil. Voilà la frontière qu’il vaut la peine d’énoncer clairement : changer d’agent préserve le code et abandonne le raisonnement. Le commit survit. Le « pourquoi » se trouvait dans un tampon d’historique qu’un agent a vu et que le suivant ne verra jamais.
Préserver le contexte lors d’un changement, c’est donc en réalité deux tâches : rendre les règles permanentes lisibles par tous les agents, et faire exister l’état de la tâche en cours autrement que comme la mémoire d’un seul outil. Les sections suivantes les traitent dans l’ordre. (Si votre problème est de perdre le contexte entre les exécutions d’un même agent, il s’agit d’un problème connexe mais distinct, abordé dans maintenir le contexte entre les sessions d’IA.)
Faire des règles permanentes un seul fichier que chaque agent lit
Commencez par la victoire facile. Claude Code lit CLAUDE.md, Codex lit AGENTS.md, Gemini CLI lit GEMINI.md. Même rôle, trois noms de fichier. Si vous les maintenez séparément, ils divergent, et l’agent vers lequel vous avez basculé suit désormais des règles obsolètes alors que vous croyez le contraire.
Écrivez les règles une seule fois et faites pointer les autres noms de fichier vers elles. Sur macOS ou Linux :
# AGENTS.md is the source of truth; the others are aliases
ln -s AGENTS.md CLAUDE.md
ln -s AGENTS.md GEMINI.md
git add AGENTS.md CLAUDE.md GEMINI.md
Désormais, chaque agent qui ouvre le dépôt lit les mêmes conventions, et il n’y a qu’un seul fichier à mettre à jour lorsqu’elles changent. Gardez-le court et factuel : la commande de test, les répertoires interdits, la règle de revue, la forme des commits. C’est le contrat partagé que chaque agent hérite dès son démarrage, quel que soit celui vers lequel vous avez basculé.
Le piège à surveiller : mettre des détails propres à une tâche dans ces fichiers. Le fichier d’instructions sert aux règles valables pour toutes les tâches du dépôt. « On utilise Vitest, pas Jest » y a sa place. « Termine la logique de nouvelle tentative du paiement et ne touche pas au middleware d’authentification » non ; c’est vrai pour une tâche cette semaine et faux pour la suivante. Mélanger les deux revient à faire lire à chaque agent des instructions destinées à un travail déjà livré.
Transporter le contexte de travail, pas seulement les règles
Le fichier de règles amène un nouvel agent sur la ligne de départ. Mais il ne dit rien de la tâche en cours : ce qui a été décidé, ce qui est à moitié fait, ce qui reste incertain. C’est précisément ce savoir qui s’évapore lors d’un changement, parce qu’il n’a jamais existé que dans la session de l’agent précédent.
La solution manuelle est une note de passation. Avant de changer d’agent, demandez à l’agent en cours d’écrire où il en est : l’objectif, les fichiers qu’il a modifiés, ce qu’il a vérifié et le seul point dont il n’était pas sûr. Collez-la dans l’agent suivant comme premier message. Ça marche, et pour un changement unique, c’est suffisant. Ce schéma mérite d’être intériorisé pour lui-même ; la forme d’une bonne note de passation est détaillée dans modèles de passation entre agents.
Le piège, c’est que la note ne vit nulle part de façon durable. C’est un paragraphe dans un terminal que vous allez fermer, ou un message que vous retapez à chaque fois. Faites l’aller-retour deux fois et vous maintenez la note de passation à la main, dans votre tête, à travers trois outils. Le contexte existe, mais c’est vous qui êtes devenu la base de données où il est stocké. Cela tient pour une tâche. Cela ne tient pas quand vous en menez plusieurs, et c’est là que l’approche bricolée atteint ses limites.
Où le bricolage cesse de passer à l’échelle
Des règles liées par lien symbolique et une note de passation collée vous mènent loin avec un dépôt et deux agents. Ajoutez un troisième agent, un deuxième dépôt, ou une tâche qui s’étale sur une journée, et l’arithmétique se retourne contre vous. Chaque changement est un export et un réimport manuels. Chaque tâche a son propre fil de « ce qui est fait », qui n’existe que là où le dernier agent l’a laissé. Rien ne vous signale qu’un agent backend a terminé le point de terminaison qu’attend l’agent frontend, parce que « signaler » était un message dans un terminal que personne ne surveille.
À ce stade, la solution n’est pas une meilleure note. C’est de sortir le contexte de travail des agents pour le placer entièrement dans une Tâche partagée, que chaque agent et chaque personne lit et alimente. Une Tâche dans Sharkly regroupe l’objectif, les critères d’acceptation, le diff, les blocages et la discussion dans un seul enregistrement. L’exécution, les blocages, les résultats et le suivi reviennent dans la chronologie de cette Tâche, si bien que changer d’agent n’est plus du tout un export. Vous réaffectez la Tâche ; l’agent suivant lit le même enregistrement que celui auquel le précédent a contribué.
C’est aussi là que la répartition entre humains et agents devient nette. Les agents font la recherche, exécutent, testent et rendent compte à la Tâche. Les personnes donnent la direction, accordent l’autorité et acceptent le résultat. L’automatisation s’arrête là où le jugement de l’équipe est requis, et l’enregistrement que lit le prochain intervenant est le même que celui que lit un relecteur. Cela ne fonctionne que parce que le contexte n’est plus enfermé dans une session.
Voici le vrai choix, énoncé sans détour. Si vous utilisez un seul agent dans un seul terminal sur un seul dépôt, vous n’avez besoin de rien de tout cela ; le contexte ne part jamais, donc il n’y a rien à préserver. Adoptez une Tâche partagée dès l’instant où le contexte doit survivre à un changement, que celui-ci soit d’agent à agent, d’agent à humain, ou simplement de vous à vous-même demain matin. Si vous voulez continuer à utiliser plusieurs agents de codage plutôt que de vous engager dans un seul écosystème, cette portabilité est tout l’intérêt : votre flux de travail survit à l’agent que vous choisirez ensuite, parce que le contexte n’a jamais été stocké à l’intérieur de l’un d’eux. C’est aussi la configuration qui vous permet de faire tourner Claude Code et Codex ensemble sur une même base de code sans que l’un ou l’autre devienne aveugle à la passation, et elle s’associe naturellement aux worktrees, un checkout par tâche, pour que les agents parallèles ne se heurtent pas.
La liste à cocher que vous pouvez appliquer dès aujourd’hui
Parcourez cette liste dans l’ordre. Les trois premiers points ne coûtent rien ; le quatrième est l’étape vers laquelle vous passez quand les trois premiers ne suffisent plus.
- Unifiez le fichier de règles. Faites pointer
CLAUDE.md,AGENTS.mdetGEMINI.mdpar lien symbolique vers une seule source. Limitez-vous aux conventions valables pour tout le dépôt, sans détail de tâche. - Rédigez une note de passation avant chaque changement. Objectif, fichiers modifiés, ce qui a été vérifié, question en suspens. L’agent en cours peut la rédiger ; vous la collez dans le suivant.
- Décidez le changement en fonction de la tâche, pas de l’habitude. Choisissez l’agent adapté au travail qui vous attend, à l’aide d’un guide d’orientation, plutôt que de vous rabattre sur le terminal déjà ouvert.
- Sortez le contexte des agents quand les notes ne suffisent plus. Dès que vous jonglez avec plus de deux agents ou dépôts, placez l’objectif, l’état et la revue sur une Tâche partagée, pour que changer d’agent soit une réaffectation et non une nouvelle explication.
Si vous utilisez déjà plusieurs agents et que vous racontez à nouveau le même contexte à chaque changement, c’est le problème autour duquel Sharkly est conçu : un seul endroit où les tâches, l’avancement et les résultats de chaque agent restent visibles, pour que le contexte survive au changement.


