
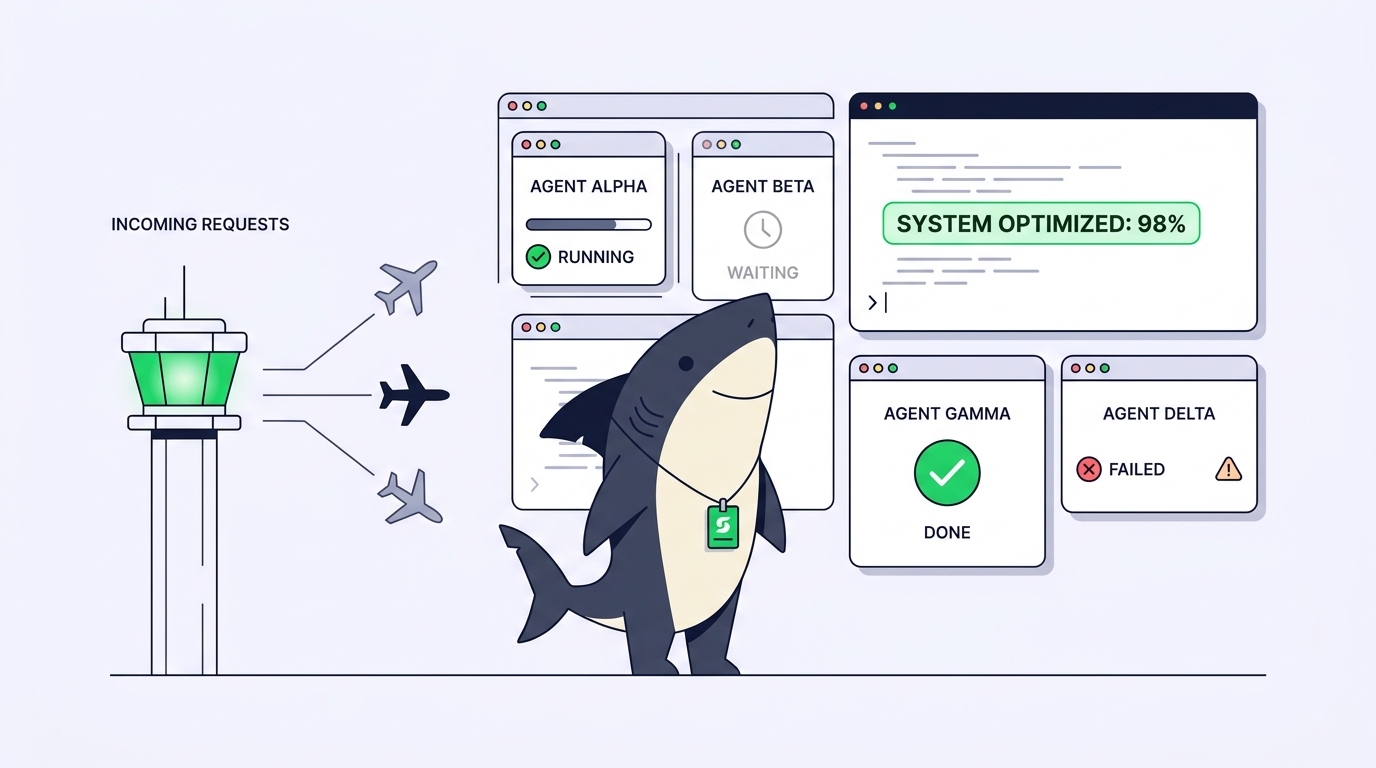
Ce matin, vous avez lancé trois agents de code. Le premier refactorise un module d’authentification, le deuxième rédige des tests et le troisième traque un test instable sur la CI. Une heure plus tard, vous vous retrouvez avec cinq terminaux ouverts, deux volets tmux détachés et ce sentiment persistant qu’au moins l’un d’eux s’est arrêté depuis un moment et tourne à vide sans que vous vous en soyez aperçu. Vous enchaînez les Alt+Tab, faites défiler des journaux de logs, tentez de deviner.
C’est justement cette incertitude qui représente le véritable coût de l’exécution d’agents en parallèle. Lancer plusieurs agents de code simultanément est devenu un jeu d’enfant. Savoir lequel réclame votre intervention, lequel est bloqué et lequel a terminé en silence, voilà ce qui vous bouffe l’après-midi. Surveiller des agents de code en parallèle consiste à répondre en direct à quatre questions sans avoir à ouvrir cinq fenêtres : que fait chaque agent, où en est-il dans sa progression, qu’est-ce qui le bloque et qu’a-t-il produit qui nécessite une revue ?
Ce guide passe d’abord en revue une configuration de monitoring « maison », détaille le point de défaillance de chaque étape, puis montre où cette approche atteint ses limites et ce qu’apporte une couche partagée de gestion des tâches. Cette couche partagée, c’est Sharkly : vous disposez déjà d’agents de code, et Sharkly les transforme en équipe en centralisant la progression, les blocages et les résultats de chacun au même endroit au lieu de les éparpiller sur plusieurs terminaux. Vous pouvez bricoler l’essentiel de ce monitoring vous-même. L’intérêt de comparer les deux approches est de cerner précisément le moment où la méthode artisanale commence à vous coûter plus cher qu’elle ne vous rapporte.
Les quatre signaux à surveiller de près
Le monitoring n’est pas un bloc monolithique. Quand on dit qu’une exécution d’agent « semble bien se passer », on fait généralement référence à l’un de quatre signaux distincts, et chacun a son propre mode de défaillance.
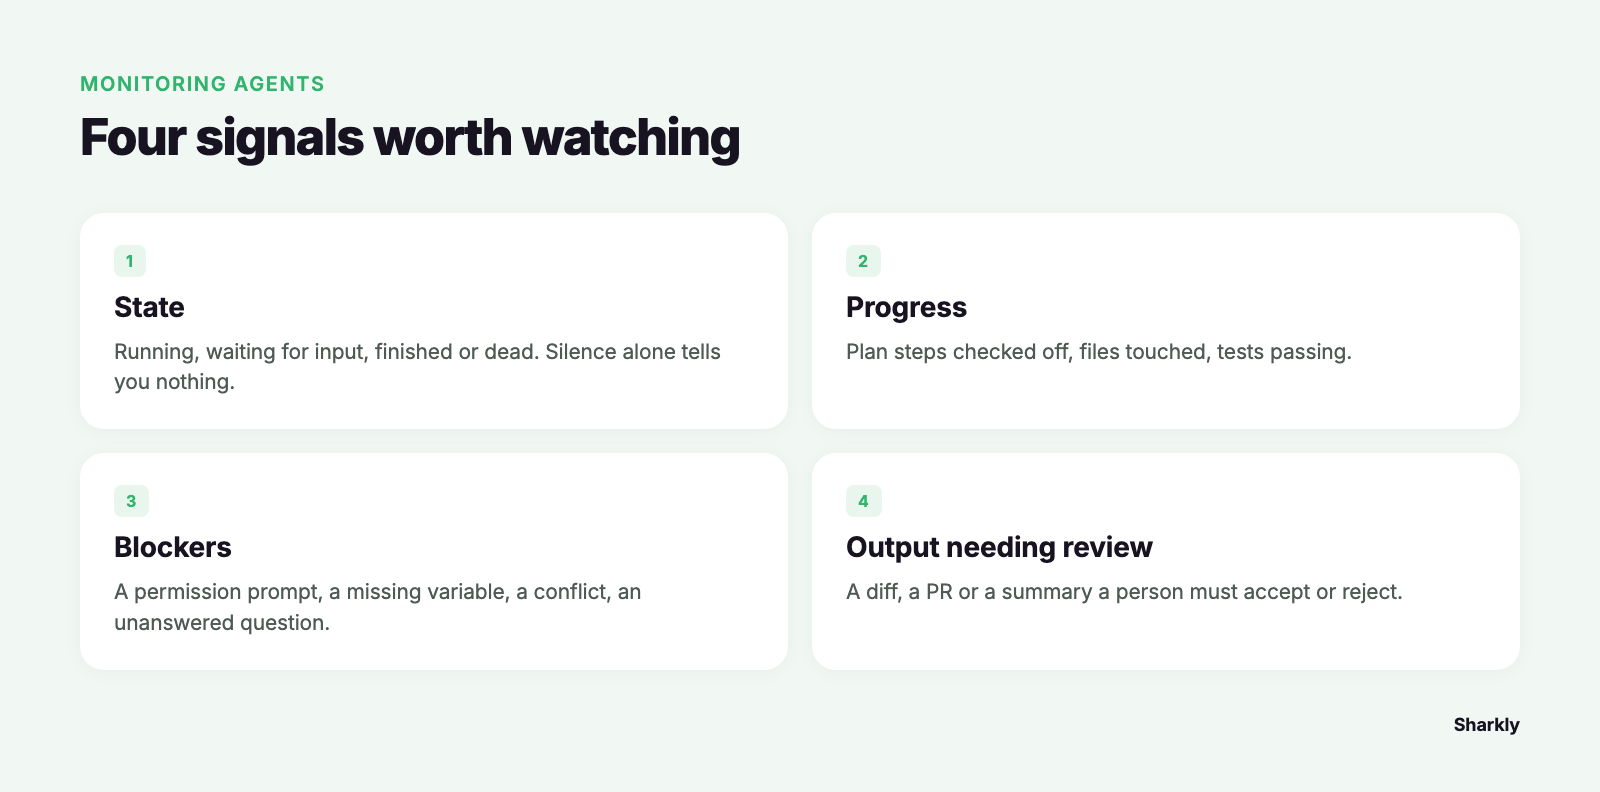
- État. Le processus est-il en cours d’exécution, en attente d’une saisie, terminé ou figé ? Un agent qui a fini et un agent bloqué ne produisent plus la moindre sortie : le silence ne dit donc rien à lui seul.
- Progression. Quelle part de la tâche est accomplie ? Étapes du plan cochées, fichiers modifiés, tests réussis. C’est la progression qui permet de vérifier qu’un agent en cours d’exécution avance réellement et ne tourne pas en boucle.
- Points de blocage. Qu’attend l’agent pour continuer ? Une invite demandant de confirmer des autorisations, une variable d’environnement manquante, un conflit de fusion ou une question posée restée sans réponse.
- Livrables en attente de revue. Qu’a produit l’agent qu’un être humain doit désormais valider ou rejeter ? Un diff, une PR, un résumé des modifications.
Ne surveillez que l’état et vous passerez à côté de l’agent actif mais piégé dans une boucle de tentatives infructueuses. Ne surveillez que la progression et vous manquerez celui qui a terminé il y a vingt minutes. Un bon système de monitoring doit faire remonter ces quatre signaux d’un seul coup d’œil, pour chaque agent.
Étape 1 : le monitoring artisanal et ses angles morts
L’approche maison s’appuie sur les outils que vous possédez déjà. Voici ce qu’elle donne en toute franchise, avec les failles propres à chaque étape.
Visualiser ce qui tourne. Si chaque agent s’exécute dans son propre worktree git, listez-les ainsi que leurs branches :
git worktree list
tmux ls   # if each agent runs in a tmux session
Point de défaillance : cela vous indique qu’une session existe, pas si l’agent qui s’y trouve est au travail ou en attente. Un volet tmux bloqué sur une invite Continue? (y/n) a exactement la même apparence qu’un volet en pleine tâche. Vous ne vous en rendez compte qu’en vous y rattachant.
Suivre la progression. Suivez la sortie de chaque agent avec tail -f et surveillez les changements de son worktree à intervalles réguliers :
tail -f /path/to/agent-1.log
watch -n 5 'git -C ../wt-auth status --short'
Point de défaillance : la charge mentale augmente linéairement avec le nombre d’agents. Lire trois journaux de logs reste gérable. Suivre six flux de logs entremêlés devient impossible, et les boucles watch vous montrent de l’activité sur des fichiers, pas du sens. Vous voyez des fichiers changer sans savoir si la modification est pertinente ou si l’agent tourne en rond.
Détecter la fin des tâches. Encapsulez chaque agent pour qu’il vous envoie une notification quand son processus se termine :
your-agent-command "$TASK"; \
  curl -s -X POST "$WEBHOOK_URL" -d "agent-1 exited $?"
Point de défaillance : un code de sortie 0 signifie seulement que le processus est arrivé à son terme, non que le travail est correct ou même terminé. De nombreux agents s’arrêtent proprement après avoir posé une question que vous n’avez jamais vue. Un ping « terminé » vous incite à vous fier à un signal trompeur.
Repérer les conflits. Lorsque plusieurs agents partagent un même dépôt, les worktrees isolent leurs répertoires de travail respectifs, mais deux agents modifiant le même fichier sur deux branches entreront inévitablement en conflit lors de la fusion.
git worktree list --porcelain | grep branch
Point de défaillance : vous ne découvrez le chevauchement qu’au moment du merge, c’est-à-dire au moment le plus coûteux pour s’en apercevoir.
Rien de tout cela n’est intrinsèquement mauvais. Pour deux ou trois agents travaillant sur des tâches indépendantes, quelques volets tmux et une boucle watch constituent un système de surveillance tout à fait raisonnable, et il est inutile de sortir l’artillerie lourde. Limitez la complexité au strict minimum jusqu’à ce que vous heurtiez un mur.
Où le monitoring maison montre ses limites
Ce mur apparaît dès lors que vous lancez suffisamment d’agents pour qu’un seul écran ne suffise plus à les afficher tous. Trois problèmes majeurs s’additionnent alors :
L’interrogation régulière indique l’état, pas la cause. Un git status et un suivi de logs vous indiquent qu’un fichier a bougé ou que la sortie s’est interrompue. Ils ne peuvent pas vous dire si l’agent attend une réponse à une invite, s’il bute sur une dépendance manquante ou s’il a terminé. Vous finissez par vous rattacher aux sessions une par une pour poser un diagnostic, reproduisant exactement ces allers-retours entre terminaux que le parallélisme était censé éliminer.
Aucun état n’est partagé. Votre monitoring est confiné à votre ordinateur portable, à votre serveur tmux, à l’historique de votre shell. Un collègue ne peut pas voir quel agent est affecté à quelle tâche, et vous non plus dès que vous refermez votre écran. Lorsqu’un agent s’exécute sur une machine distante, l’approche par suivi de logs locaux devient tout simplement inutilisable.
La revue devient le goulot d’étranglement. C’est l’écueil que l’on sous-estime le plus. Faire tourner des agents en parallèle ne sert à rien si la validation de leur travail redevient une file d’attente traitée au compte-gouttes par une seule personne. Cinq diffs terminés sans espace partagé pour suivre leur statut (« revu / modifications demandées / fusionné »), cela donne cinq onglets de navigateur et des pense-bêtes mentaux. Les agents sont devenus plus rapides ; l’humain est devenu plus lent.
À ce stade, ce ne sont pas des terminaux supplémentaires qui vous manquent. C’est un registre partagé.
L’apport d’un tableau de bord de tâches : centraliser les résultats
Une couche de gestion des tâches change l’unité élémentaire de monitoring : on ne surveille plus « un processus dans un volet », mais « une Tâche avec un état ». C’est le changement de paradigme au cœur de Sharkly, qui correspond point par point aux quatre signaux.
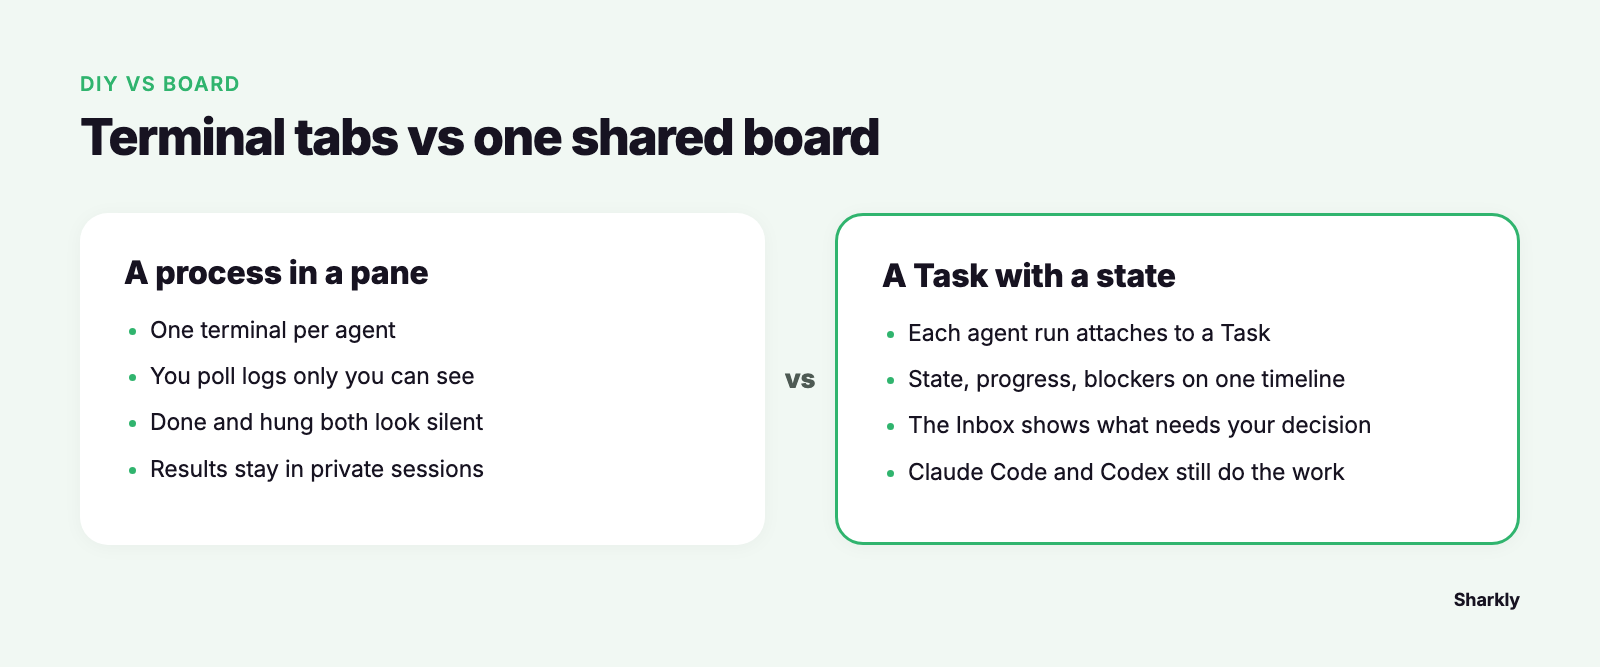
Chaque exécution d’agent est rattachée à une Tâche. L’état, la progression, les blocages et les résultats remontent tous dans le fil d’activité de cette Tâche au lieu de dormir dans un fichier de logs accessible à vous seul. Au lieu de scruter vos terminaux, vous consultez un tableau de bord : quelles Tâches sont en cours, lesquelles sont bloquées, lesquelles sont terminées et attendent votre retour. L’Inbox de Sharkly fait remonter les exécutions qui nécessitent une intervention humaine. La question n’est plus « est-ce que quelque chose a fini ? », mais « voici ce qui exige une décision de ma part ». Les agents explorent, exécutent, testent et rendent compte ; les humains fixent le cap, accordent les autorisations et valident le résultat. L’automatisation s’arrête là où le discernement commence.
Cette délimitation a toute son importance pour éviter tout malentendu : Sharkly n’exécute pas l’agent et n’écrit pas de code à sa place. Claude Code, Codex et les autres environnements d’exécution que vous utilisez déjà se chargent toujours de l’exécution. Sharkly ajoute par-dessus une couche partagée de tâches, d’environnement, de contexte et de revue, de sorte que l’avancement d’une exécution et son diff apparaissent à un endroit visible par toute l’équipe, de la demande initiale à la mise en production. Sharkly maintient également chaque exécution dans son propre worktree isolé, évitant ainsi que les conflits sur un même fichier, d’ordinaire découverts lors de la fusion, ne dépassent le cadre de la Tâche.
La règle de décision en toute franchise : si vous faites tourner un ou deux agents sur des tâches sans lien entre elles et que vous ne passez jamais le relais à qui que ce soit, le monitoring artisanal suffit largement et Sharkly serait superflu. L’équation change dès que le nombre d’agents dépasse la capacité de vos écrans, que les tâches tournent sur des machines distantes ou que d’autres personnes doivent accéder au même tableau de bord. Si vous souhaitez continuer à exploiter plusieurs agents de code sans vous enfermer dans un écosystème unique, cette vue partagée est précisément le défi auquel répond Sharkly. Pour avoir une vision plus globale de ce que doit contenir ce tableau de bord, découvrez ce qu’un tableau de bord pour agents de code IA devrait réellement afficher.
Une checklist de monitoring applicable dès aujourd’hui
Que vous restiez sur une solution maison ou que vous adoptiez une couche partagée, un système de monitoring d’agents en parallèle doit pouvoir répondre à ces critères sans que vous ayez à vous rattacher à la moindre session :
- Chaque agent est associé à une tâche clairement nommée. Fini l’anonymat d’un « agent-3 ». Vous devez pouvoir préciser l’objectif de chacun d’eux.
- L’état est identifiable en un coup d’œil. En cours, en attente de saisie, terminé ou en échec : des statuts clairement différenciés, et non déduits du silence.
- Les agents bloqués lèvent la main. Une invite attendant un
y/n, un secret manquant ou une question restée sans réponse vous sont directement signalés au lieu de stagner en silence. - Terminé signifie prêt pour revue, pas seulement arrêté. Une exécution terminée pointe vers un diff ou une PR, pas simplement vers un code de sortie.
- La revue possède son propre cycle de vie. Les statuts « revu », « modifications demandées » et « fusionné » sont suivis, évitant que le travail parallèle ne redevienne un goulot d’étranglement séquentiel.
- L’affichage résiste à la fermeture de l’ordinateur et se partage. L’état est conservé ailleurs que dans l’historique de votre shell.
- Le travail sur un même dépôt est isolé. Chaque agent dispose de son propre worktree, et les chevauchements de fichiers sont détectés avant la fusion, pas pendant.
Passez en revue cette liste au regard de votre installation actuelle. Les cases que vous ne pouvez pas cocher aujourd’hui sont précisément celles qui vous feront perdre un après-midi demain. Si vous faites déjà tourner plusieurs agents, Sharkly vous offre un espace centralisé pour gérer leurs tâches et leurs résultats. Vous pouvez également exécuter vos agents de code actuels via Sharkly tout en conservant vos environnements d’exécution habituels.


