
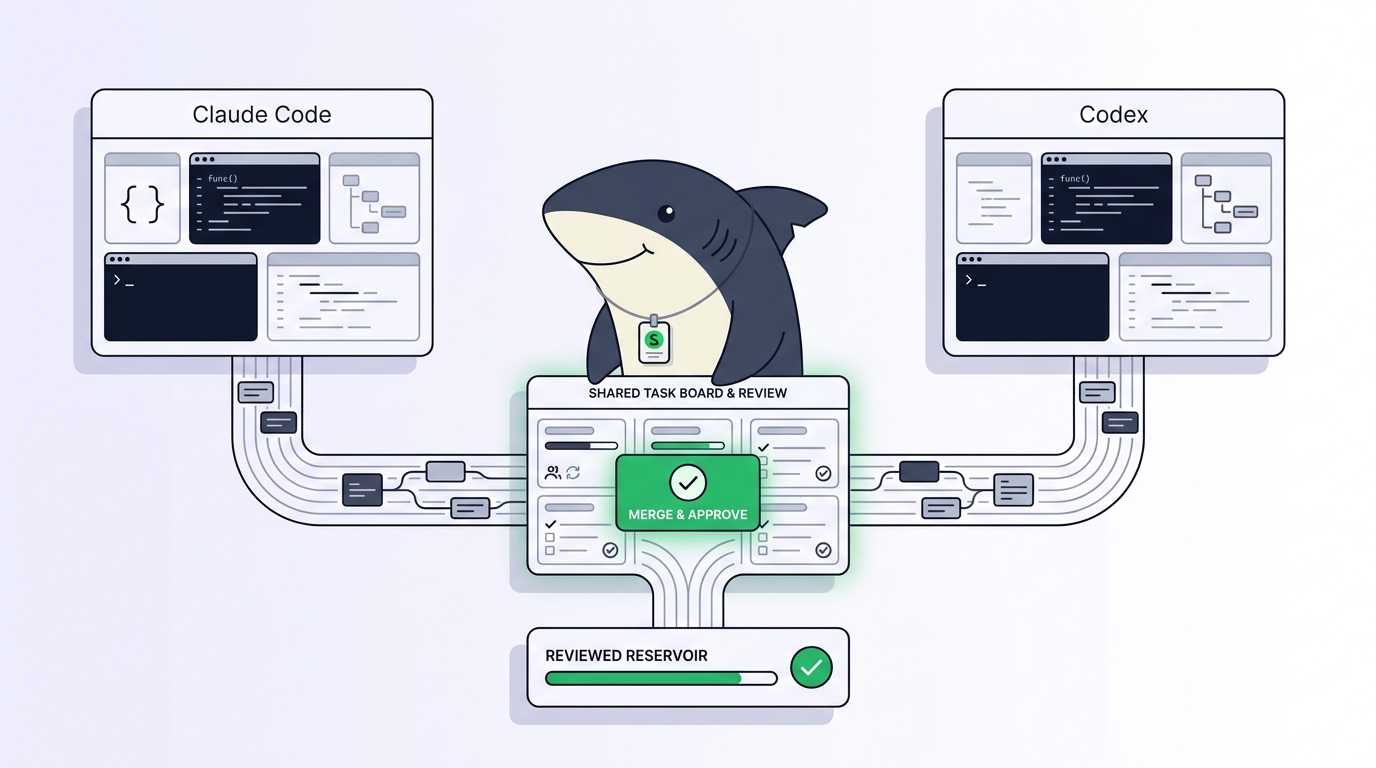
Claude Code excelle pour lire une large base de code et garder le fil d'un plan à travers de nombreux fichiers. Codex excelle pour les modifications bien délimitées et pilotées par les tests. Beaucoup d'ingénieurs finissent par vouloir les deux sur le même dépôt : l'un qui prépare une refonte pendant que l'autre consolide une suite de tests instable. Dès que vous essayez, le répertoire de travail commun devient le problème. Deux outils différents, deux CLI différentes, un seul dossier dans lequel les deux écrivent.
Ce guide détaille la mise en place étape par étape, nomme le mode de défaillance à chaque étape et montre où deux terminaux cessent de passer à l'échelle. La partie isolation est un problème résolu avec les git worktrees. La partie coordination, savoir quel outil travaille sur quoi et garder chaque modification vérifiable, c'est là qu'une couche indépendante du runtime comme Sharkly prend le relais.
Sharkly ne remplace ni Claude Code ni Codex. Il ajoute la couche partagée de Task, Computer, de contexte et de revue autour des outils d'exécution que vous utilisez déjà, de sorte qu'une session Claude Code et une session Codex deviennent deux affectations dans un seul workflow plutôt que deux terminaux à surveiller.
Pourquoi faire tourner Claude Code et Codex sur le même dépôt
Trois raisons reviennent sans cesse, et ce ne sont pas les mêmes problèmes.
Des forces différentes selon les tâches. Vous confiez le travail à large contexte (retracer ce bug à travers le module, planifier cette migration) à un agent, et le travail étroit et vérifiable (faire passer ce test, resserrer cette fonction) à l'autre. Associer l'outil à la tâche est un sujet en soi ; voir quel modèle pour quelle tâche de codage.
Un face-à-face sur du vrai travail. Le seul benchmark honnête, c'est votre base de code, pas un classement. Faire tourner les deux sur le même ticket et comparer les diffs vous en apprend plus que n'importe quel score publié. Nous détaillons la méthode dans comment comparer les agents de codage sur votre propre base de code.
Vous payez déjà pour les deux. Beaucoup d'équipes ont déjà un abonnement Claude et un siège Codex ou API. La neutralité vis-à-vis des fournisseurs est le point clé : votre workflow doit survivre quel que soit l'outil qui sortira le prochain meilleur modèle, sans reconstruction.
Quelle que soit la raison, l'échec est identique. Deux agents dans un même dossier, c'est deux rédacteurs qui modifient un seul document sans verrou. L'un change la branche sous les pieds de l'autre, ou reformate un fichier en pleine édition, et vous vous retrouvez avec des diffs à moitié appliqués qui n'ont aucun sens.
Étape 1 : donnez à chaque agent son propre worktree
Le git worktree règle la collision à la racine. Un dépôt peut avoir plusieurs répertoires de travail extraits en même temps, chacun sur sa propre branche, partageant une seule base de données .git. Au lieu d'un dossier pour lequel les deux outils se battent, vous en avez un par tâche.
# One checkout per task, each on its own branch
git worktree add ../app-refactor -b agent/refactor
git worktree add ../app-tests    -b agent/tests

git worktree list
Pointez un outil différent vers chaque répertoire :
cd ../app-refactor && claude          # Claude Code on the refactor
cd ../app-tests    && codex           # Codex on the test suite
Mode de défaillance si vous sautez cette étape : les deux outils font cd dans le même dépôt, se disputent les mêmes fichiers, et l'un écrase silencieusement le travail non commité de l'autre. Les worktrees rendent cela physiquement impossible. Le nettoyage qui suit a ses propres pièges ; gérer les worktrees sans les affres du nettoyage couvre git worktree remove et le problème des branches obsolètes.
Étape 2 : pointez chaque outil vers les bonnes instructions
Claude Code et Codex lisent des fichiers de projet différents. Claude Code cherche CLAUDE.md ; Codex lit AGENTS.md. Si votre dépôt n'en contient qu'un, un agent travaille à l'aveugle vis-à-vis de vos conventions.
Gardez les deux, et gardez-les cohérents. Le schéma fiable consiste à écrire les règles partagées une seule fois et à faire en sorte que chaque point d'entrée les inclue :
<!-- CLAUDE.md and AGENTS.md both start with -->
See ./docs/agent-conventions.md for build, test, and style rules.
# Verify each tool actually loads its file before you turn it loose
claude --version   # Claude Code reads CLAUDE.md from the worktree root
codex --version    # Codex reads AGENTS.md from the worktree root
Mode de défaillance si vous sautez cette étape : Codex suit une config de lint pendant que Claude Code en suit une autre, et chaque merge se transforme en bataille de style que personne n'a documentée. Une remarque personnelle s'impose ici : un jeton d'installation ne transporte pas vos conventions, et un fichier local dans le .gitignore ne se retrouve pas dans le worktree. Placez les règles partagées dans des fichiers suivis, sinon chaque nouveau worktree démarre à vide.
Étape 3 : lancez, puis regardez le fossé de coordination s'ouvrir
Avec deux worktrees et deux fichiers de config, la mécanique fonctionne. Vous avez Claude Code sur une branche et Codex sur une autre, aucun ne touchant les fichiers de l'autre. Pour un après-midi avec deux agents, ça tient.
Le fossé s'ouvre quand vous levez les yeux du clavier. Chaque session conserve son propre historique dans son propre onglet, invisible pour l'autre. Quand l'exécution de Codex a besoin de savoir ce que celle de Claude Code a déjà modifié, il n'y a aucune mémoire partagée à consulter, alors c'est vous qui devenez la couche d'intégration. Les agents terminent à des moments différents et attendent silencieusement une entrée, si bien que « lancer les deux en parallèle » se dégrade discrètement en « vérifier chacun l'un après l'autre ».
Passez à l'échelle au-delà de deux. Le réflexe naturel ensuite est un script wrapper qui crée des worktrees, lance le bon outil dans chacun et redirige la sortie vers des panneaux tmux nommés. Ça aide pour une poignée d'exécutions. Puis ça grossit : nommage des branches, nettoyage, un moyen de dire quel outil travaille sur quelle tâche, des relances pour celui qui a planté. Avant longtemps, vous maintenez un framework d'orchestration fragile tenu par du bash, où la moitié de l'état vit dans l'historique du shell et l'autre dans votre tête. En lancer beaucoup à la fois se heurte au même mur, que les agents soient tous Claude Code, comme dans faire tourner plusieurs agents Claude Code, ou un mélange.
Là où deux terminaux cessent de passer à l'échelle
Le test honnête pour savoir si vous avez dépassé la mise en place artisanale :
- Un collègue peut-il voir ce que vos agents font en ce moment, sans que vous lui lisiez votre terminal ?
- Quand Codex termine à 14 h et a besoin d'une entrée, quelque chose vous prévient-il ?
- Quand les deux agents terminent en même temps, y a-t-il une file d'attente pour relire leur travail, ou juste vous et deux branches ?
Si les réponses sont non, la pièce manquante n'est pas un autre script shell. C'est une couche qui affecte le travail à l'un ou l'autre outil, affiche le statut en direct et garde chaque modification vérifiable avant le merge. C'est ce qu'un tableau de tâches apporte par rapport aux terminaux bruts.
Voici la frontière qui mérite d'être énoncée clairement. Claude Code et Codex assurent l'exécution. Une couche de commande gère l'affectation, les Computers connectés, le contexte des tâches, la progression, les blocages, les résultats et la revue humaine sur les deux. Dans Sharkly, vous affectez une Task à un Runtime Claude Code et une autre à un Runtime Codex ; chacune s'exécute dans son propre worktree isolé sur un Computer connecté, et l'exécution, les blocages et les résultats reviennent dans la timeline de la Task au lieu de disparaître dans des terminaux privés.
La répartition du travail reste nette. Les agents recherchent, exécutent, testent et rapportent. Les humains fixent la direction, accordent l'autorité et acceptent le résultat. L'automatisation s'arrête là où votre jugement est requis, et vous rend un diff avec les preuves de vérification jointes. Vous gardez les outils que vous payez déjà, l'usage des modèles passe toujours par les abonnements et les clés API configurés dans chacun, et vous obtenez un seul endroit pour voir qui travaille sur quoi.
Utilisez la mise en place manuelle quand vous faites tourner un ou deux agents pour un après-midi et que vous pouvez garder l'état en tête. Passez à une couche partagée quand une deuxième personne a besoin de visibilité, quand le nombre dépasse ce qu'une seule fenêtre de terminal peut afficher, ou quand vous comparez des outils assez souvent pour que « quelle exécution a produit cette branche » cesse d'être évident.
Une checklist à appliquer dès aujourd'hui
Déroulez-la de haut en bas la prochaine fois que vous mettez les deux outils sur un même dépôt :
- [ ] Créez un
git worktreepar tâche, chacun sur sa propre branche. Ne pointez jamais deux outils vers le même répertoire. - [ ] Committez à la fois
CLAUDE.mdetAGENTS.md, chacun pointant vers un fichier de conventions partagé dans les sources suivies. - [ ] Confirmez que chaque outil charge sa config depuis la racine du worktree avant d'affecter du travail.
- [ ] Affectez une Task bien délimitée par agent. Le travail à large contexte à l'un, le travail étroit piloté par les tests à l'autre.
- [ ] Décidez votre point de contrôle de revue dès le départ : aucune branche ne fusionne tant qu'une personne n'a pas lu le diff et les résultats de tests.
- [ ] Quand vous dépassez deux ou trois exécutions simultanées, arrêtez de faire grossir le bash et déplacez l'affectation, le statut et la revue dans une seule couche.
Si vous voulez continuer à utiliser Claude Code et Codex plutôt que de vous engager dans un seul écosystème, c'est le problème autour duquel Sharkly est conçu. Téléchargez Sharkly, connectez un Computer, et affectez votre première Task à l'agent qui convient au travail.
FAQ
Claude Code et Codex peuvent-ils modifier les mêmes fichiers sans risque ? Pas dans le même répertoire. Donnez à chacun son propre git worktree pour qu'ils travaillent sur des branches séparées, puis fusionnez via une revue. La concurrence dans un même répertoire, c'est là que le travail non commité se perd.
Ai-je besoin de deux abonnements ? Vous avez besoin de ce que chaque outil exige. L'usage des modèles continue via les abonnements ou les clés API configurés dans Claude Code et Codex ; une couche de coordination ne modifie ni ne revend cet accès.
Un tableau de tâches est-il excessif pour deux agents ? Pour deux agents que vous contrôlez en une seule séance, de simples worktrees et deux terminaux suffisent. Le tableau gagne sa place quand un collègue a besoin de visibilité ou quand le nombre d'exécutions grimpe. Voir les meilleurs outils pour gérer des agents de codage IA en parallèle.


