
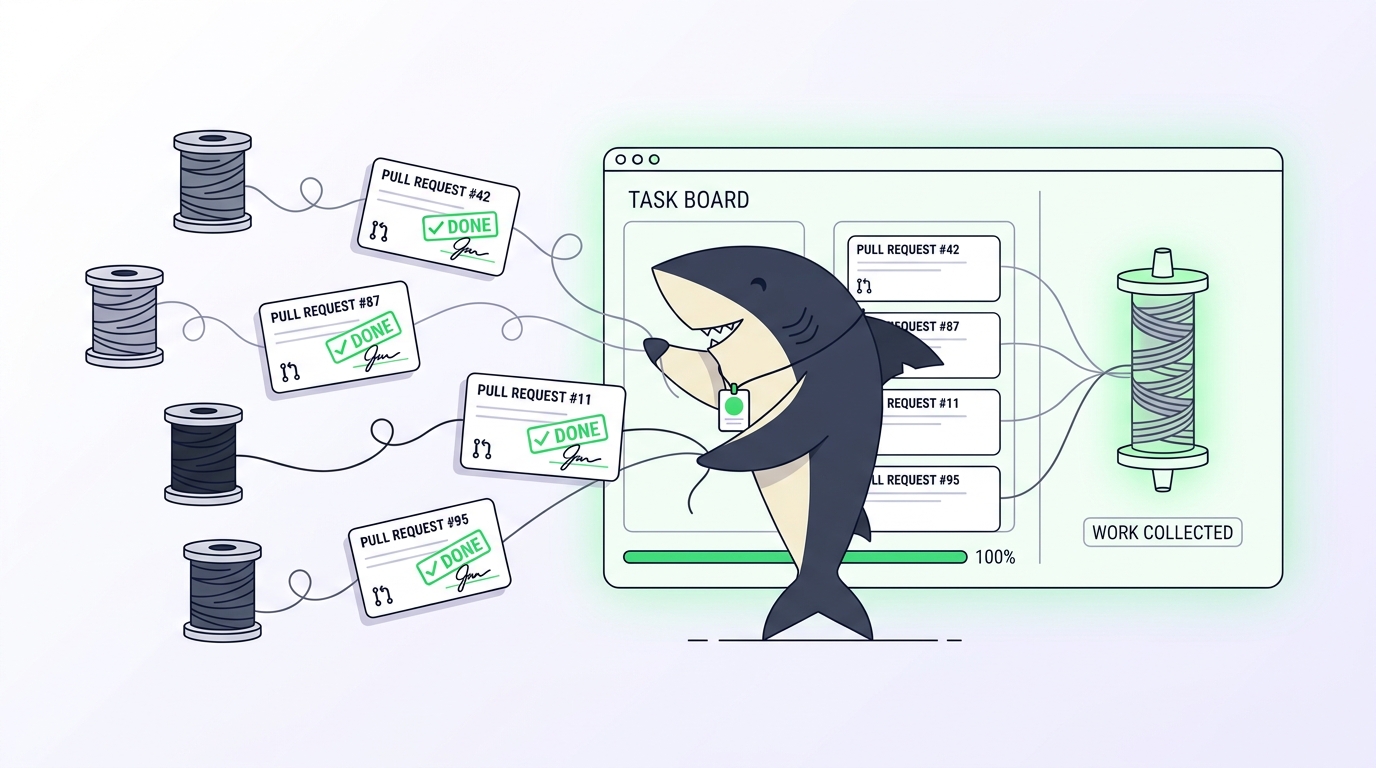
Vous avez lancé quatre agents ce matin. L'un a refactorisé le module d'authentification, un autre a écrit des tests, un troisième a couru après un job CI instable, et le dernier réfléchit encore. L'après-midi venu, vous avez une vague impression que des choses se sont produites, une pile d'onglets de terminal, trois worktrees dont vous vous souvenez à moitié, et deux pull requests que vous n'avez pas lues. Le travail a été fait. Mais vous ne voyez pas en quoi il consistait.
Suivre le travail accompli par les agents de codage IA, c'est transformer ce désordre en un registre : ce que chaque agent a modifié, si le résultat tient la route, et où il a abouti. C'est un vrai problème, car les agents terminent plus vite que vous ne pouvez les inspecter, et les preuves de ce qu'ils ont fait se trouvent dans des outils conçus pour une seule personne travaillant en solo. Ce guide commence par détailler la configuration manuelle, identifie ses points de rupture, puis présente le workflow qu'utilise Sharkly pour garder chaque résultat rattaché à la tâche qui l'a demandé.
En bref : vous pouvez suivre deux ou trois agents à la main avec git et votre terminal. Au-delà, il vous faut un espace partagé où les résultats reviennent d'eux-mêmes, car le goulot d'étranglement n'est plus le codage mais votre capacité à le relire.
TL;DR
Suivre le travail terminé d'un agent, c'est répondre à trois questions pour chaque exécution : qu'est-ce qui a changé, est-ce correct, et où le résultat a-t-il abouti. L'historique Git et les pull requests répondent à la première question pour un ou deux agents. Dès que plusieurs agents travaillent en parallèle, le registre se fragmente entre les worktrees, les terminaux et les files de PR, et vous perdez le lien entre la tâche et son résultat. Un tableau de tâches corrige cela en faisant revenir l'exécution, les blocages, les résultats et la revue humaine vers une seule tâche : le travail terminé devient consultable au lieu d'être à reconstituer.
Ce que signifie suivre le travail terminé
Le suivi n'est pas un journal d'activité. C'est la capacité de répondre à trois questions sur une exécution terminée sans avoir à la rétro-ingénierer.
- Ce qui a changé. Le diff, les fichiers touchés, la raison de chaque modification.
- Si c'est correct. Le typecheck, les tests, le build et un résumé de ce que l'agent a vérifié.
- Où cela a abouti. La branche, la PR, la tâche à laquelle cela appartient, et qui valide le résultat.
Un agent qui termine en silence a techniquement accompli son travail, mais vous ne pouvez rien en faire. L'état « terminé » qui vous intéresse est celui qu'une personne peut inspecter et accepter. C'est pourquoi « les tests passent » n'est pas synonyme de « le travail est suivi ».
Le modèle human-in-the-loop pour les agents de codage trace la frontière : les agents explorent, exécutent, testent et rendent compte ; les humains donnent la direction et acceptent le résultat. Le suivi est le mécanisme qui permet à cette seconde moitié d'exister.
La configuration en autonomie, étape par étape, et où chaque étape casse
Pour un agent sur une branche, les outils intégrés suffisent. Voici la version honnête, avec le mode de défaillance nommé à chaque étape.
Étape 1 : voir ce qui a changé. Après une exécution, vous lisez le diff.
git log --oneline -10
git diff main...HEAD --stat
Échec lorsque : deux agents partagent une branche, ou qu'un agent ne commit rien et laisse des modifications dans l'arbre de travail d'un worktree que vous avez oublié. Le diff que vous lisez n'est pas celui qui a été livré.
Étape 2 : isoler le travail de chaque agent. Vous attribuez à chaque agent son propre git worktree pour qu'ils ne se marchent pas dessus.
git worktree add ../auth-refactor -b auth-refactor
git worktree list
Échec lorsque : la liste dépasse ce que vous pouvez garder en tête. git worktree list vous indique les chemins, mais pas quel agent se trouve dans chacun, à quelle tâche il répond, ni s'il a terminé. Consultez la documentation officielle de git-worktree pour la mécanique ; elle s'arrête à la tenue des comptes.
Étape 3 : vérifier que les résultats ont abouti à une PR. Vous vous appuyez sur GitHub.
gh pr list --author "@me" --state open
gh pr view 214 --json title,statusCheckRollup
Échec lorsque : la PR existe mais personne n'a écrit pourquoi, ou que les checks sont au vert alors que la modification est erronée, ou que la PR ne renvoie pas à la demande qui l'a déclenchée. La référence de gh pr list vous montre les PR ouvertes, pas l'intention.
Étape 4 : se souvenir de ce que vous avez demandé. Cette étape n'a aucune commande. L'exigence d'origine vit dans un message Slack, une note ou votre mémoire. Quand vous relisez la PR trois jours plus tard, vous devinez les critères d'acceptation.
Chaque étape fonctionne. Le problème, ce sont les jointures entre elles. Le diff, l'isolation, la PR et l'intention vivent dans quatre systèmes qui s'ignorent, et vous êtes le seul lien entre eux.
Où la configuration manuelle cesse de passer à l'échelle
La rupture n'est pas un instant précis. C'est une pente, et vous pouvez dire où vous vous situez dessus.
| Agents en parallèle | Ce que le suivi coûte | Ce qui casse en premier |
|---|---|---|
| 1 | Lire un diff, une PR | Rien |
| 2 à 3 | Alterner entre les worktrees | Vous perdez qui a fait quoi |
| 4 à 6 | Reconstituer l'intention pour chaque PR | Les résultats dépassent votre capacité de revue |
| 7+ | Coordination à plein temps | Le travail terminé reste sans revue pendant des jours |
Le vrai coût se mesure en capacité de revue, pas en vitesse d'agent. Les agents produisent du travail terminé plus vite qu'une personne ne peut l'inspecter ; au-delà de quelques exécutions, votre débit est plafonné par la vitesse à laquelle vous pouvez répondre aux trois questions, et non par la vitesse à laquelle les agents codent. Ajouter des agents aggrave le problème de suivi au lieu d'améliorer la livraison.
Ce qu'apporte un tableau de tâches
La solution : cesser de considérer une exécution terminée comme un simple diff, et la traiter comme un élément qui revient vers une tâche.
Dans Sharkly, la tâche constitue le registre partagé. Vous assignez une tâche à un agent ou à un Crew, et l'exécution se déroule dans un worktree isolé, de sorte que les agents parallèles ne touchent jamais aux mêmes fichiers. Une fois terminé, l'exécution, les blocages, les résultats et les suites reviennent dans la chronologie de la tâche. Le résumé des modifications, les résultats de vérification et les limites connues sont rattachés à la tâche elle-même, et non à un terminal que vous devez encore avoir ouvert.
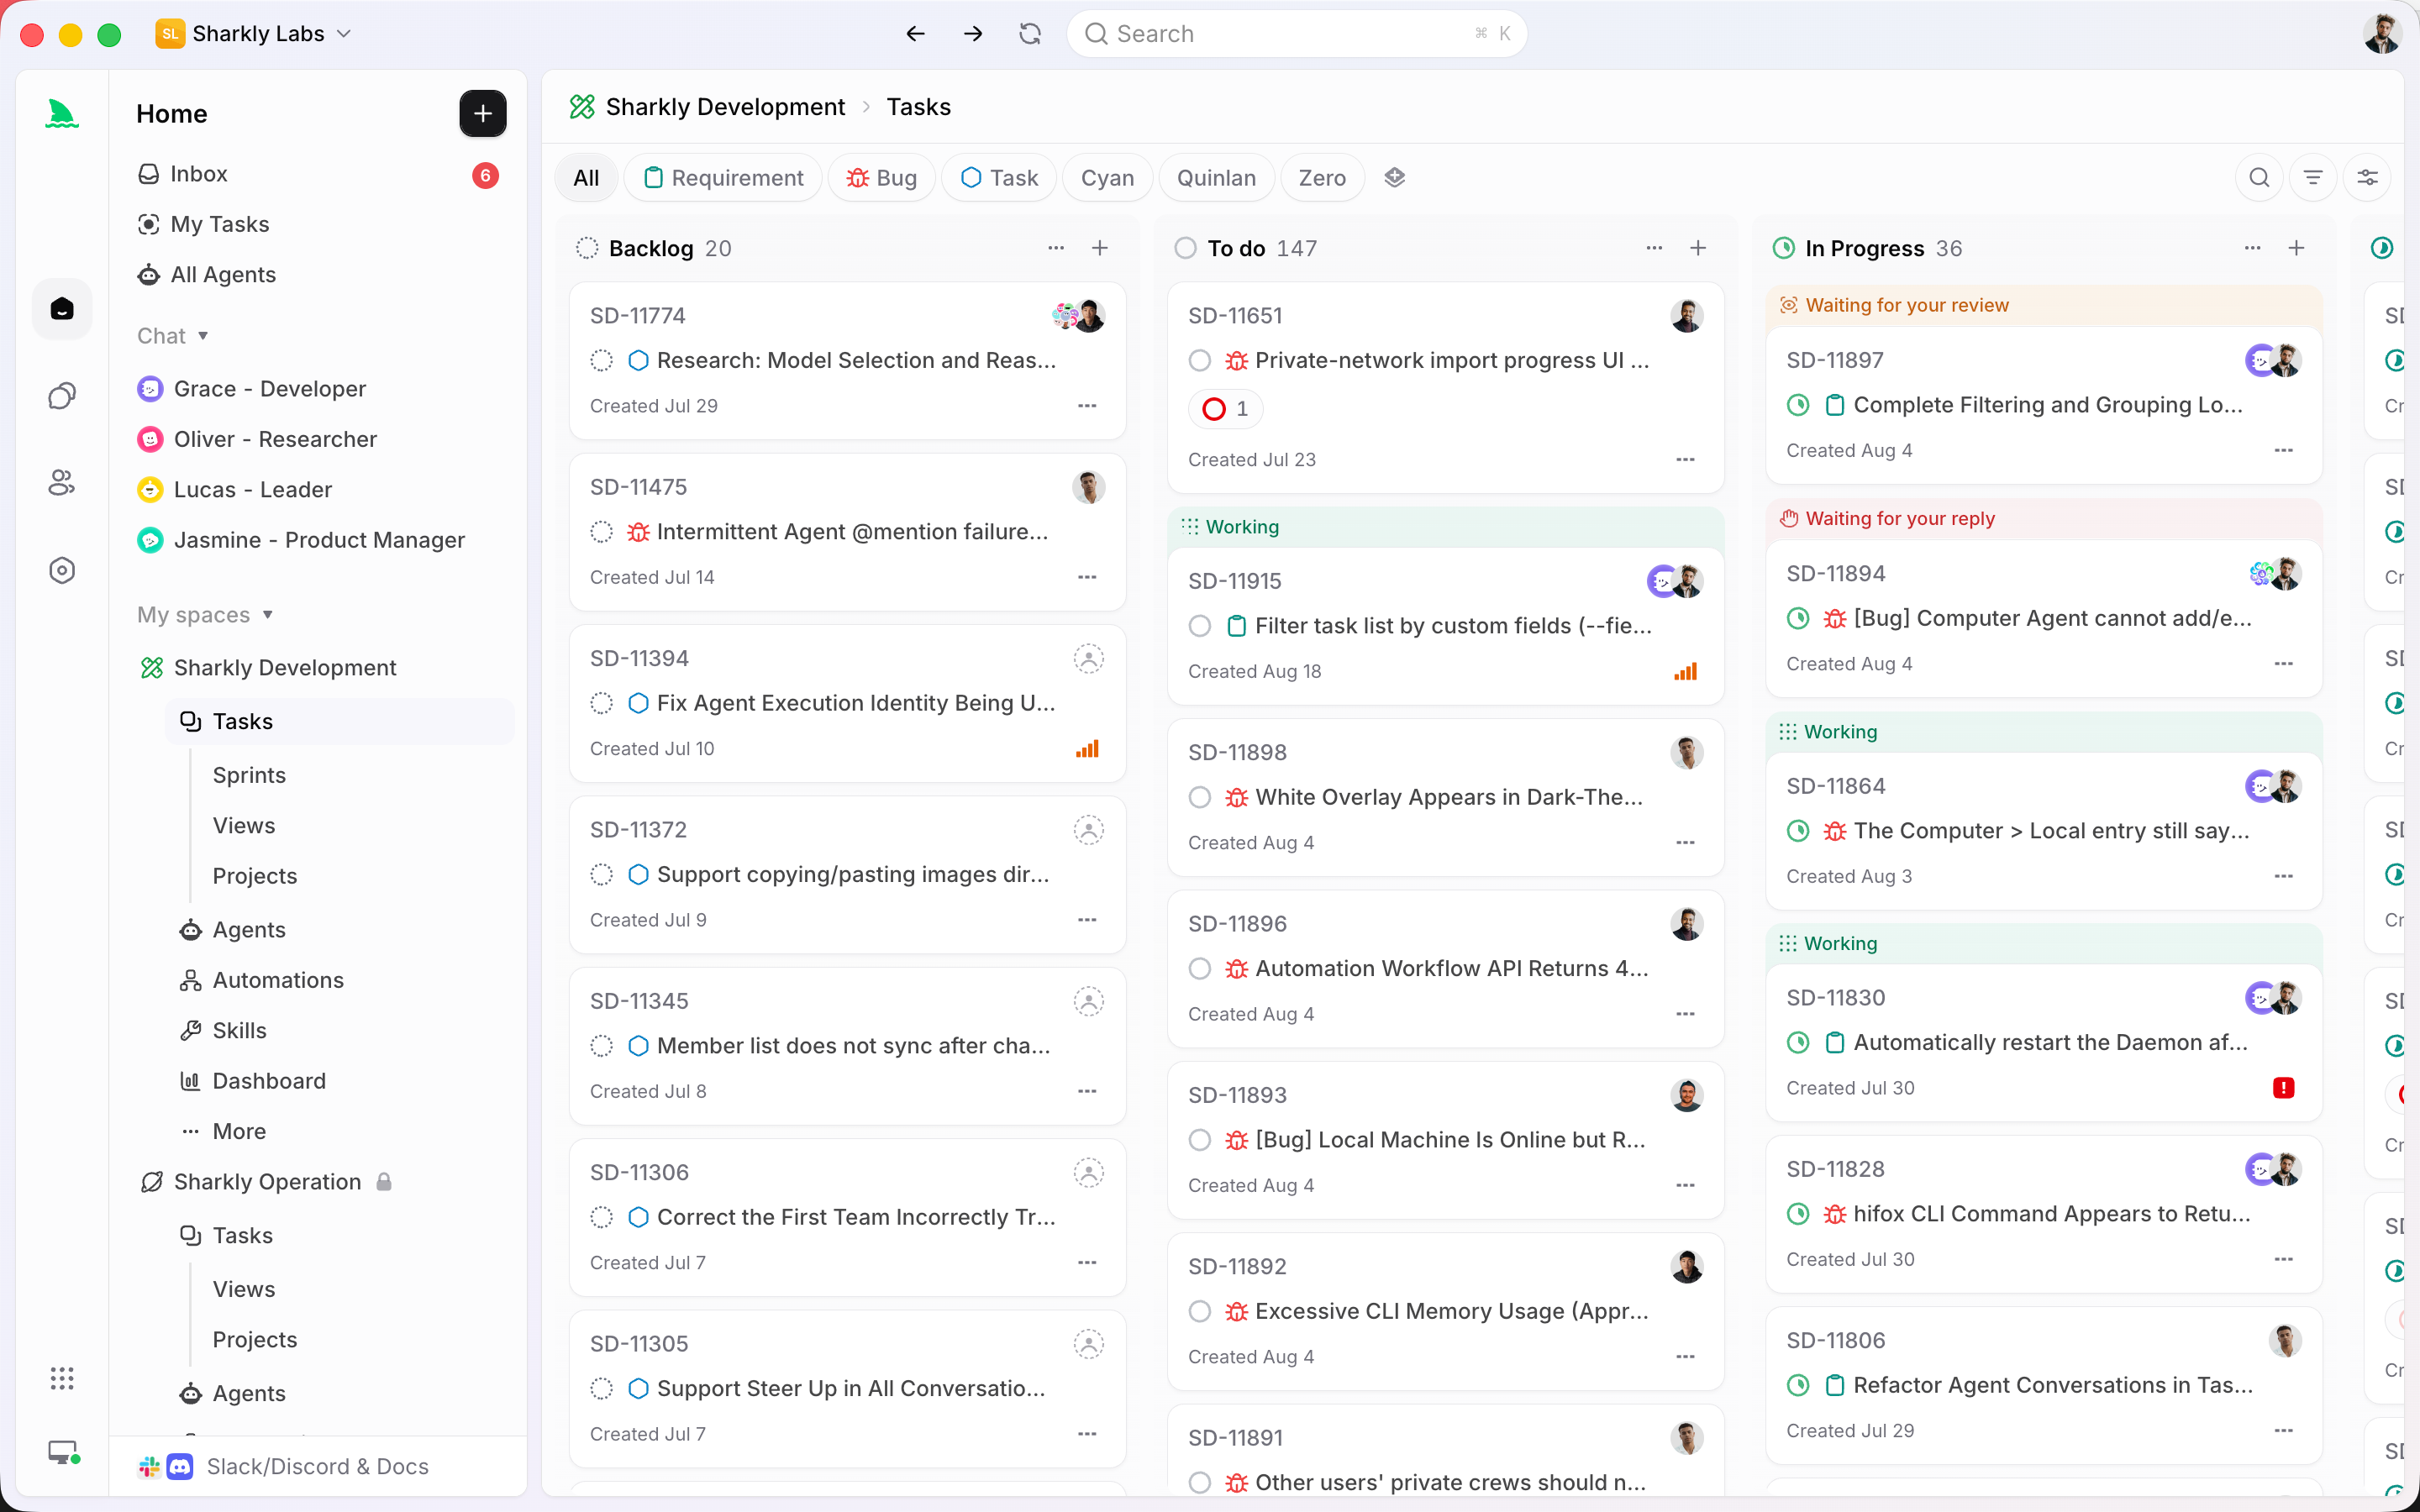
C'est toute la différence entre un journal et un registre. Un journal vous dit que quelque chose s'est produit. Un registre vous dit ce qui a changé, si c'est correct et où cela a abouti, le tout au même endroit, rattaché à la demande qui l'a déclenché. Vous relisez le travail terminé depuis la tâche, vous l'acceptez ou le renvoyez, et la décision porte votre nom.
C'est là que les jointures de la configuration en autonomie se referment. L'intention, le diff, les vérifications et la validation vivent sur un seul objet. Vous conservez les outils que vos agents utilisent déjà ; Claude Code et Codex continuent d'exécuter, et Sharkly ajoute par-dessus la couche de tâches, de contexte et de revue. Confier du travail à un agent IA ressemble alors à une délégation à un coéquipier, et le résultat revient là où vous pouvez le retrouver.
Vous pouvez télécharger Sharkly et connecter un Computer pour tester cette approche sur une seule tâche réelle avant de passer à l'échelle.
Quand vous n'avez besoin de rien de tout cela
Soyez honnête sur le seuil. Si vous faites tourner un seul agent de codage, dans un seul dépôt, et que vous lisez chaque diff avant la fusion, git et votre terminal suffisent déjà à suivre votre travail terminé. Un tableau de tâches n'ajouterait qu'une cérémonie inutile. La vue projet intégrée de Claude Code couvre étonnamment de besoins pour un workflow à agent unique.
L'équation change quand trois éléments s'accumulent : plus de deux ou trois agents en même temps, du travail que vous ne pouvez pas relire le jour même, et des résultats qui doivent parvenir à quelqu'un d'autre que vous. C'est à ce moment qu'un registre de tâches partagé cesse d'être une charge et devient le seul moyen de rendre le travail terminé visible, de la demande à la livraison.
Une checklist à appliquer dès aujourd'hui
Avant d'ajouter un nouvel agent, vérifiez que vous pouvez répondre oui à chacune de ces questions pour ceux qui tournent déjà :
- [ ] Pour n'importe quelle exécution terminée, pouvez-vous retrouver le diff en moins d'une minute sans ouvrir un terminal ?
- [ ] Chaque exécution terminée comporte-t-elle un résumé de ce que l'agent a vérifié, et pas seulement des checks au vert ?
- [ ] Pouvez-vous remonter d'une PR jusqu'à l'exigence qui l'a déclenchée ?
- [ ] Existe-t-il un endroit unique qui montre quel agent travaille sur quoi, ce qui est terminé et ce qui doit être relu ?
- [ ] La validation du travail terminé porte-t-elle le nom d'une personne ?
- [ ] Quand un agent termine, le résultat vient-il à vous, ou devez-vous aller le chercher ?
Chaque « non » est une jointure qui s'élargira à mesure que vous ajoutez des agents. La corriger tôt coûte moins cher que de reconstituer plus tard une semaine d'exécutions non suivies.
FAQ
Comment suivre ce qu'un agent de codage IA a modifié ? Lisez le diff, pas le résumé qu'en fait l'agent. Pour un seul agent, git diff et la PR suffisent. Pour plusieurs, gardez chaque exécution dans son propre worktree et renvoyez le diff accompagné d'un résumé de vérification vers une tâche partagée, pour ne pas avoir à le reconstituer à partir de l'historique du terminal.
Puis-je suivre le travail des agents IA avec GitHub seul ? Pour un ou deux agents, oui. GitHub vous montre les PR ouvertes et l'état des checks. Il ne vous dit pas quel agent a produit une PR, à quelle tâche elle répond, ni si la modification correspond à l'intention d'origine ; son utilité s'effiloche donc vite dès que plusieurs agents tournent en parallèle.
Combien d'agents puis-je faire tourner avant d'avoir besoin d'un tableau de tâches ? La plupart des gens ressentent les jointures autour de trois à quatre agents en parallèle, quand reconstituer l'intention de chaque PR commence à prendre plus de temps que la revue elle-même. Le déclencheur est la capacité de revue, pas un chiffre fixe. Voir notre note sur la gestion d'agents de codage en parallèle.
Un tableau de tâches ralentit-il des agents qui vont vite ? Non. Les agents continuent d'exécuter à pleine vitesse dans des worktrees isolés. Le tableau ajoute un chemin de retour pour que leur travail terminé atterrisse dans un endroit où vous pouvez le relire, ce qui supprime l'étape de reconstitution manuelle au lieu d'en ajouter une.


