
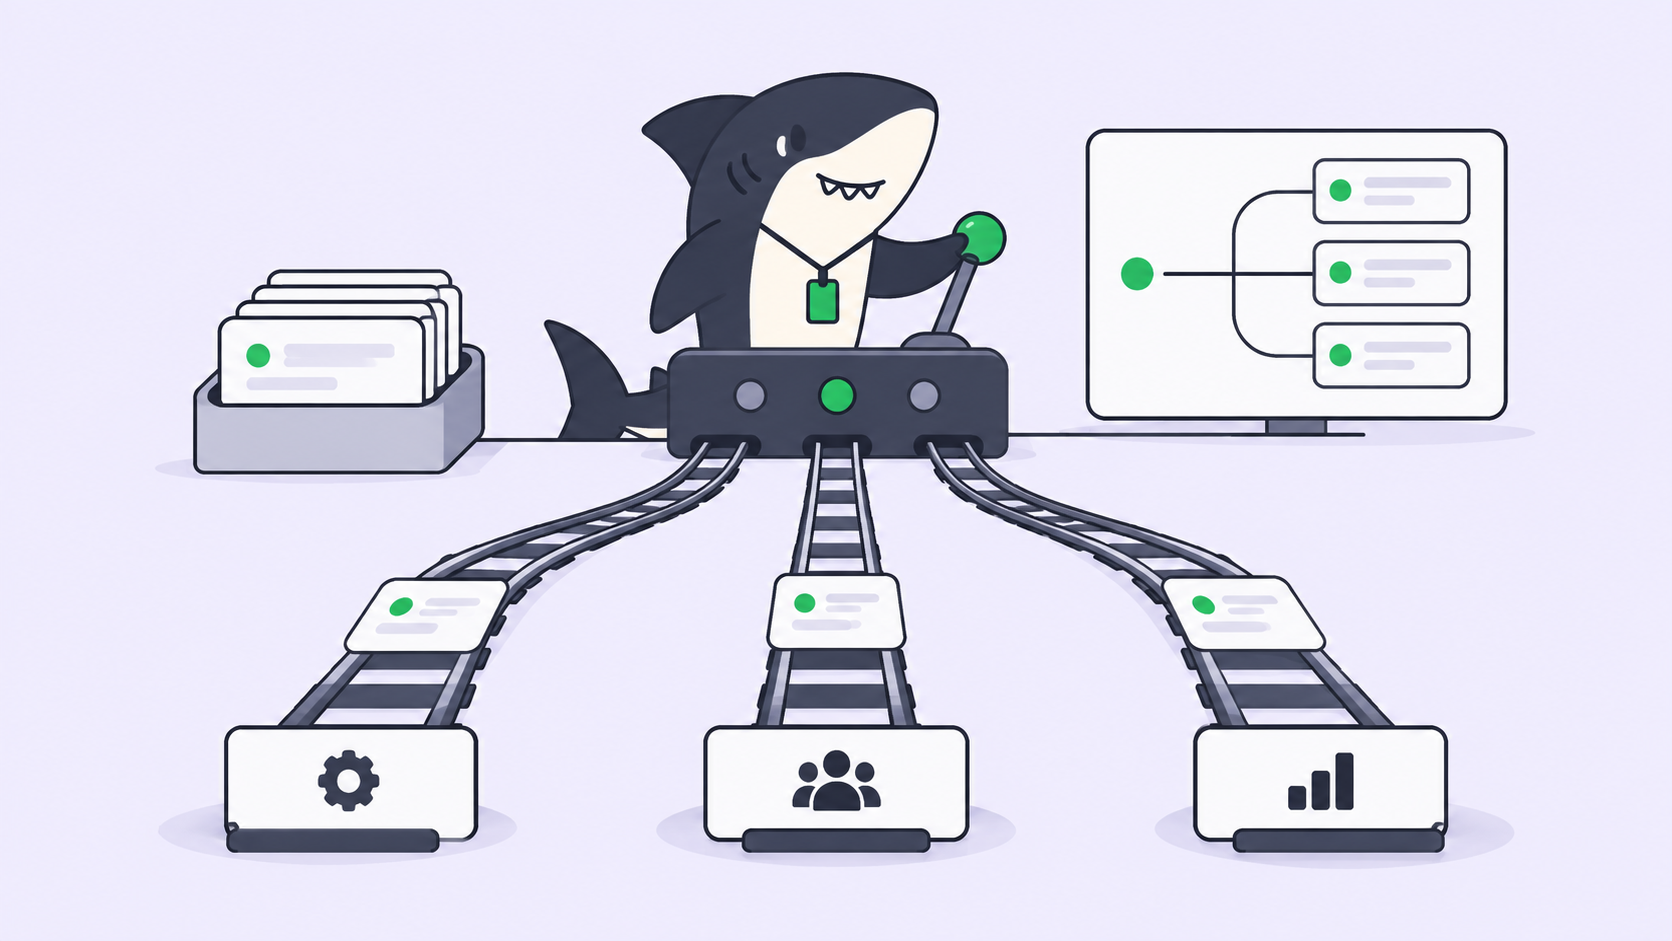
Votre équipe route déjà le travail entre les modèles. Simplement, elle le fait de tête. Un ingénieur fait tout tourner sur le palier le plus cher parce qu'il échoue moins souvent. Un autre est passé à un modèle bon marché le mois dernier sans le dire à personne. Un troisième utilise encore ce que l'outil a configuré par défaut à l'installation. C'est tenable tant qu'une seule personne pilote un seul agent. Ça s'arrête dès que cinq Agents tournent en parallèle et que plus personne ne peut dire lequel dépense quarante fois plus que nécessaire sur une docstring, ou lequel échoue en silence sur une tâche pour laquelle il n'a jamais été assez solide.
Le 22 septembre 2026, l'écart entre les paliers est devenu assez large pour compter. Anthropic a lancé Claude Opus 5.5. OpenAI a lancé GPT-6 Sol et GPT-6 Luna. Entre le moins cher et le plus cher des trois, l'écart atteint un facteur quarante sur les tokens d'entrée, et chacun d'eux est assez bon pour qu'on lui confie une véritable Task.
Une règle de routage est une déclaration écrite, pas une préférence
Une règle de routage énonce par écrit quelle catégorie de Task tourne sur quel Runtime. Elle est rattachée à l'Agent qui exécute le travail, et non à la personne qui a lancé l'exécution par hasard.
Voilà toute l'idée, et le mot important, c'est « écrit ». Une préférence vit dans le terminal d'une seule personne et expire dès qu'elle part en congé. Une règle vit à côté de l'Agent : un Assignee qui reprend une Task en hérite, un relecteur voit quel palier a produit le diff qu'il est en train de lire, et changer d'avis le trimestre suivant se fait en une modification au lieu de six conversations.
Une règle de routage n'est pas un classement des modèles. Elle ne désigne pas de vainqueur, et elle n'en a pas besoin. Elle dit où va chaque type de travail par défaut, et ce qui se passe quand ce défaut se révèle mauvais.
Ce que coûtent les trois paliers
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| Identifiant API | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Entrée / sortie par million | 4 $ / 20 $ | 2 $ / 10 $ | 0,10 $ / 0,50 $ |
| Entrée mise en cache | 0,20 $ en lecture, 5 $ en écriture | 90 % de remise sur les lectures | 90 % de remise sur les lectures |
| Contexte | 1M | 872k | 1M |
Pour référence : Claude Opus 5 à 5 $ / 25 $, et GPT-6 Astra à 10 $ / 50 $. OpenAI présente Sol et Luna comme 50 % moins chers que la tarification promotionnelle de GPT-5.6. Le mot « promotionnelle » est d'OpenAI lui-même, et il change tout : la base de comparaison de ce chiffre est un tarif remisé, pas un tarif catalogue. OpenAI précise aussi qu'Astra « reste notre meilleur modèle, tous domaines confondus », rappel utile que Sol est le palier au meilleur rapport qualité-prix de sa propre famille, et non son vaisseau amiral.
Une vérification pratique avant d'inscrire un palier dans une règle : OpenAI référence Sol et Luna dans ChatGPT Work et dans Codex pour les offres Plus, Pro, Business, Enterprise et Edu, Free et Go ayant accès à Luna dans l'application de bureau, et précise qu'aucun des deux n'est encore disponible dans Chat. La disponibilité façonne une règle de routage autant que le prix, car un palier auquel la moitié de votre Crew n'a pas accès n'est pas un palier.
Routez selon le coût par tâche terminée, pas selon le tarif au token
Le prix des tokens n'est qu'un indicateur indirect de ce que vous payez réellement. Un modèle au cinquième du tarif qui demande quatre tentatives et une intervention humaine n'est pas moins cher. Pour ce lancement, OpenAI a publié le coût par tâche à côté du score, ce qui est inhabituellement direct et constitue le bon type de preuve pour une décision de routage.
| Benchmark, tel que publié par OpenAI | Résultat | Coût par tâche, relatif |
|---|---|---|
| AutomationBench 1.0.6, Sol en extra-high | 33,2 % | 0,27 $ par tâche |
| AutomationBench 1.0.6, GPT-6 Astra en low | 30,3 % | 3,9 fois Sol |
| AutomationBench 1.0.6, Claude Opus 5 en max | 26,9 % | 11,1 fois Sol |
| AutomationBench 1.0.6, Fable 5.1 avec repli sur Opus 5 en max | 31,4 % | plus de 8,9 fois Sol |
| Agents' Last Exam V1, Sol en max | 56,4 %, au-dessus du meilleur score d'Opus 5 | 60 % de moins qu'Opus 5 |
| OSWorld 2.0 hors ligne, Sol en extra-high | 60,5 %, contre 60,3 % pour Opus 5 en medium | environ 80 % moins cher |
| DeepSWE 1.1, Luna en max | 66,6 % | 93 % moins cher qu'Opus 5 |
| DeepSWE 1.1, Sol en max | 68,8 %, à 1,1 point de Fable 5 en extra-high | environ 80 % moins cher |
Deux choses sont vraies en même temps à propos de ce tableau. Les écarts sont importants, et ils sont mesurés face à Claude Opus 5, et non face à Opus 5.5, qui n'existait pas au moment de la rédaction de l'article d'OpenAI et qui est sorti quelques heures plus tard, avec un coût d'exploitation inférieur de 40 % à celui d'Opus 5 selon Anthropic lui-même. Personne n'a refait la comparaison. Considérez ces lignes comme les derniers chiffres publiés, et le classement qu'elles suggèrent comme une hypothèse à tester sur votre propre dépôt.
Ce qui résiste à cette réserve, c'est la forme, et c'est précisément la forme dont une règle de routage a besoin. Les paliers bon marché tiennent la distance sur le travail borné et répétable, pour une fraction minime du coût. Les arguments d'Anthropic en faveur d'Opus 5.5 ne portent pas du tout sur le prix par tâche : 40 % moins cher à exploiter qu'Opus 5, une sortie environ 30 % plus rapide, 128k de sortie maximale, et la capacité de rester sur une tâche pendant 18 heures ou plus. Cela décrit un modèle qu'on envoie sur un travail long et ingrat, pas un modèle qu'on envoie sur cent petites tâches.
La règle, noir sur blanc
Voici l'artefact. Il est volontairement ennuyeux, et il doit se trouver là où l'équipe le lit, pas dans un fichier de configuration privé sur un seul portable.
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
Trois lignes font le vrai travail. Le palier par défaut est nommé, donc une Task à laquelle personne n'a pensé atterrit quelque part de sensé. L'escalade est explicite, donc un échec bon marché ne peut pas dégénérer en échec coûteux sans que personne ne s'en aperçoive. Les exceptions sont consignées sur la Task, et c'est là toute la différence entre une règle et une suggestion.
L'escalade, la moitié que les équipes négligent
Les économies du tableau ci-dessus sont bien réelles, à chaque tentative. Elles s'évaporent si une tentative bon marché se transforme systématiquement en une reprise coûteuse assortie d'une intervention humaine, car vous payez alors les deux exécutions et l'interruption. C'est le mode de défaillance des chaînes de repli automatiques : elles dissimulent le coût du palier bon marché dans la facture du palier cher, et personne ne peut voir le taux de change.
Rendez donc l'escalade manuelle et visible. Une exécution qui échoue revient sur la Task avec son journal, le diff produit jusque-là et la question sur laquelle elle s'est bloquée. Une personne décide s'il faut la faire monter d'un palier, la découper ou la clarifier. Les Agents font la recherche, l'exécution, les tests et le compte rendu. Les humains fixent la direction, accordent l'autorité et acceptent le résultat. Si votre chemin d'escalade est une boucle de reprise, vous avez automatisé précisément la décision qui demandait un humain.
Un dernier point à surveiller avant de router du travail sensible à la latence vers un palier inférieur. Artificial Analysis, un tiers plutôt que l'un des deux fournisseurs, a mesuré les variantes de raisonnement « max » à 115,2 tokens de sortie par seconde pour Sol, avec 102,15 secondes avant le premier token, et à 153,9 tokens par seconde pour Luna, avec 124,23 secondes. Vérifiez ces chiffres par rapport aux fiches actuelles avant de vous y fier. [VERIFY] La forme est ce qui compte : à effort de raisonnement maximal, les modèles bon marché ne sont pas ceux qui démarrent le plus vite, et un Agent qui réfléchit pendant cent secondes ressemble exactement à un Agent qui s'est bloqué. Quel que soit le palier vers lequel vous routez, la manière dont le Runtime signale sa progression et ses échecs détermine si quelqu'un remarque la différence.
Quand ne pas écrire de règle de routage
Si vous faites tourner un seul agent sur un seul dépôt, ne faites rien de tout cela. Choisissez le palier adapté à votre travail et passez à autre chose. Le routage coûte un document à maintenir et une discussion à avoir, et il ne devient rentable que lorsque plusieurs Agents tournent en même temps avec des coûts ou des modes de défaillance différents.
Le seuil est à peu près le suivant : écrivez la règle quand deux personnes ou plus peuvent lancer une exécution, ou quand un même budget couvre plusieurs Agents simultanés. En dessous, la règle est une charge inutile. Au-dessus, son absence est la raison pour laquelle personne ne peut expliquer la facture du mois dernier.
Le chiffre qui ne bouge pas
Le coût par tâche terminée a chuté fortement des deux côtés de ce lancement. Pour donner un ordre de grandeur, OpenAI indique qu'un chercheur médian dépense plus de 600 $ par jour en agents de codage, le 90e percentile atteignant 7 000 $. Les équipes situées sous cette ligne viennent d'obtenir plusieurs fois plus de travail d'agent terminé pour le même budget, ce qui mérite d'être suivi par Runtime plutôt que par facture.
Elles n'ont pas gagné une seule heure de relecture supplémentaire. Le routage est un levier de coût et un levier de fiabilité, mais pas un levier de débit, car la file de travail en attente d'une validation humaine reste inchangée. Ce que le routage peut faire, c'est rendre cette file lisible : quel palier a produit ce diff, combien il a coûté, combien de tentatives il a fallu, et si la Task qui a échoué deux fois se trouve dans l'Inbox de quelqu'un ou nulle part. Gardez l'objectif, l'exécution, le coût, les blocages et la relecture sur la Task, de la demande à la livraison : la règle de routage devient alors un réglage que l'équipe modifie, plutôt qu'une habitude que six personnes gardent pour elles.
Sharkly n'exécute pas le modèle et ne le choisit pas pour vous. C'est la couche partagée de Task, de Computer, de contexte et de relecture autour des outils qui s'en chargent, et c'est là qu'une règle de routage doit vivre si elle veut survivre à la personne qui l'a écrite. Si vous faites déjà tourner plusieurs agents de codage, quel modèle pour quelle tâche et quel agent s'en charge sont la même décision vue sous deux angles. Connectez un Computer, créez un Agent par palier, et confiez quelque chose d'ennuyeux à celui qui est bon marché.


