
TL;DR : L’équipe d’agents IA d’OpenAI a transformé 5 034 cibles d’audit du noyau Linux en 948 exploits uniques d’élévation locale de privilèges pour environ 1,2 million de dollars de crédits d’API, avant que des chercheurs humains n’examinent les résultats. Vous pouvez reproduire ce schéma sur votre propre code : des agents repèrent ce qui est accessible, l’analysent, démontrent chaque faille de façon isolée et ébauchent un correctif, puis un humain valide.
Le 4 novembre 2026, OpenAI a publié « A thousand fewer paths to root ». Le chiffre marquant, ce sont ces 948 exploits Linux. Mais pour les équipes d’ingénierie logicielle, la vraie leçon se situe en dessous : ce résultat a été obtenu grâce à des agents spécialisés travaillant par étapes successives, chacun transmettant des éléments de preuve au suivant, avec un être humain en bout de chaîne.
Cette architecture ne dépend pas d’une expertise pointue du noyau, vous pouvez donc appliquer la même structure à vos propres services. L’urgence est bien réelle : OpenAI indique que son pipeline s’est avéré « net profitable » par rapport aux primes des programmes de bug bounty publics. Les attaquants savent faire ce calcul eux aussi, il est donc temps de s’y mettre.
Ce qu’a découvert l’équipe d’agents IA d’OpenAI
OpenAI a exécuté ce pipeline à la mi-octobre 2026 sur la toute dernière version du noyau Linux, à l’aide d’un modèle dédié à la cybersécurité à paraître. Les cibles étaient des machines virtuelles isolées tournant sur un OS de bureau standard, avec les protections habituelles activées.
| Étape | Résultat | Coût en API |
|---|---|---|
| Repérage (Scout) | 5 034 cibles d’audit, environ 2,8 millions de lignes, soit près de 7 % du noyau | 3 426 $ |
| Analyse | 2 308 anomalies candidates | 316 549 $ |
| Validation | 1 724 reproduites (environ 74,7 %) | 73 330 $ |
| Évaluation de l’exploitabilité | 948 exploits LPE uniques, 291 PoC de fuite d’informations | 820 123 $ |
| Total | 1 213 430 $ |
Ces données reflètent l’échelle du noyau Linux analysé par OpenAI, et non une estimation pour votre propre dépôt. OpenAI précise d’ailleurs que ses coûts constituent « plutôt une limite supérieure », l’objectif étant d’évaluer les capacités et non l’efficience.
Gardez trois limites à l’esprit :
- Il s’agit de failles d’élévation locale de privilèges (LPE). Un attaquant doit d’abord disposer d’un accès local initial. Elles ne constituent pas des exploits à distance en elles-mêmes.
- Beaucoup ne sont pas encore corrigées. À l’issue des dix jours de scan et d’analyse, 61 LPE avaient été corrigées en amont (upstream), 43 disposaient de correctifs en phase de staging et 299 faisaient l’objet de discussions publiques. OpenAI a soumis des centaines de rapports et de correctifs pour les vulnérabilités critiques, et transmet le reste progressivement avec les partenaires de Patch the Planet.
- L’article d’OpenAI n’indique pas que ces failles soient exploitées dans la nature.
Les recommandations d’OpenAI restent sans détour : sur un système d’exploitation qui n’intègre pas les derniers correctifs, un compte avec de faibles privilèges « devrait être considéré comme fonctionnellement équivalent à un accès root pour un acteur malveillant disposant de ressources suffisantes ». Pensez donc à appliquer les correctifs et à limiter le rayon d’impact grâce à des solutions d’isolation comme Firecracker et gVisor.
Les cinq étapes d’un workflow de sécurité par agents IA
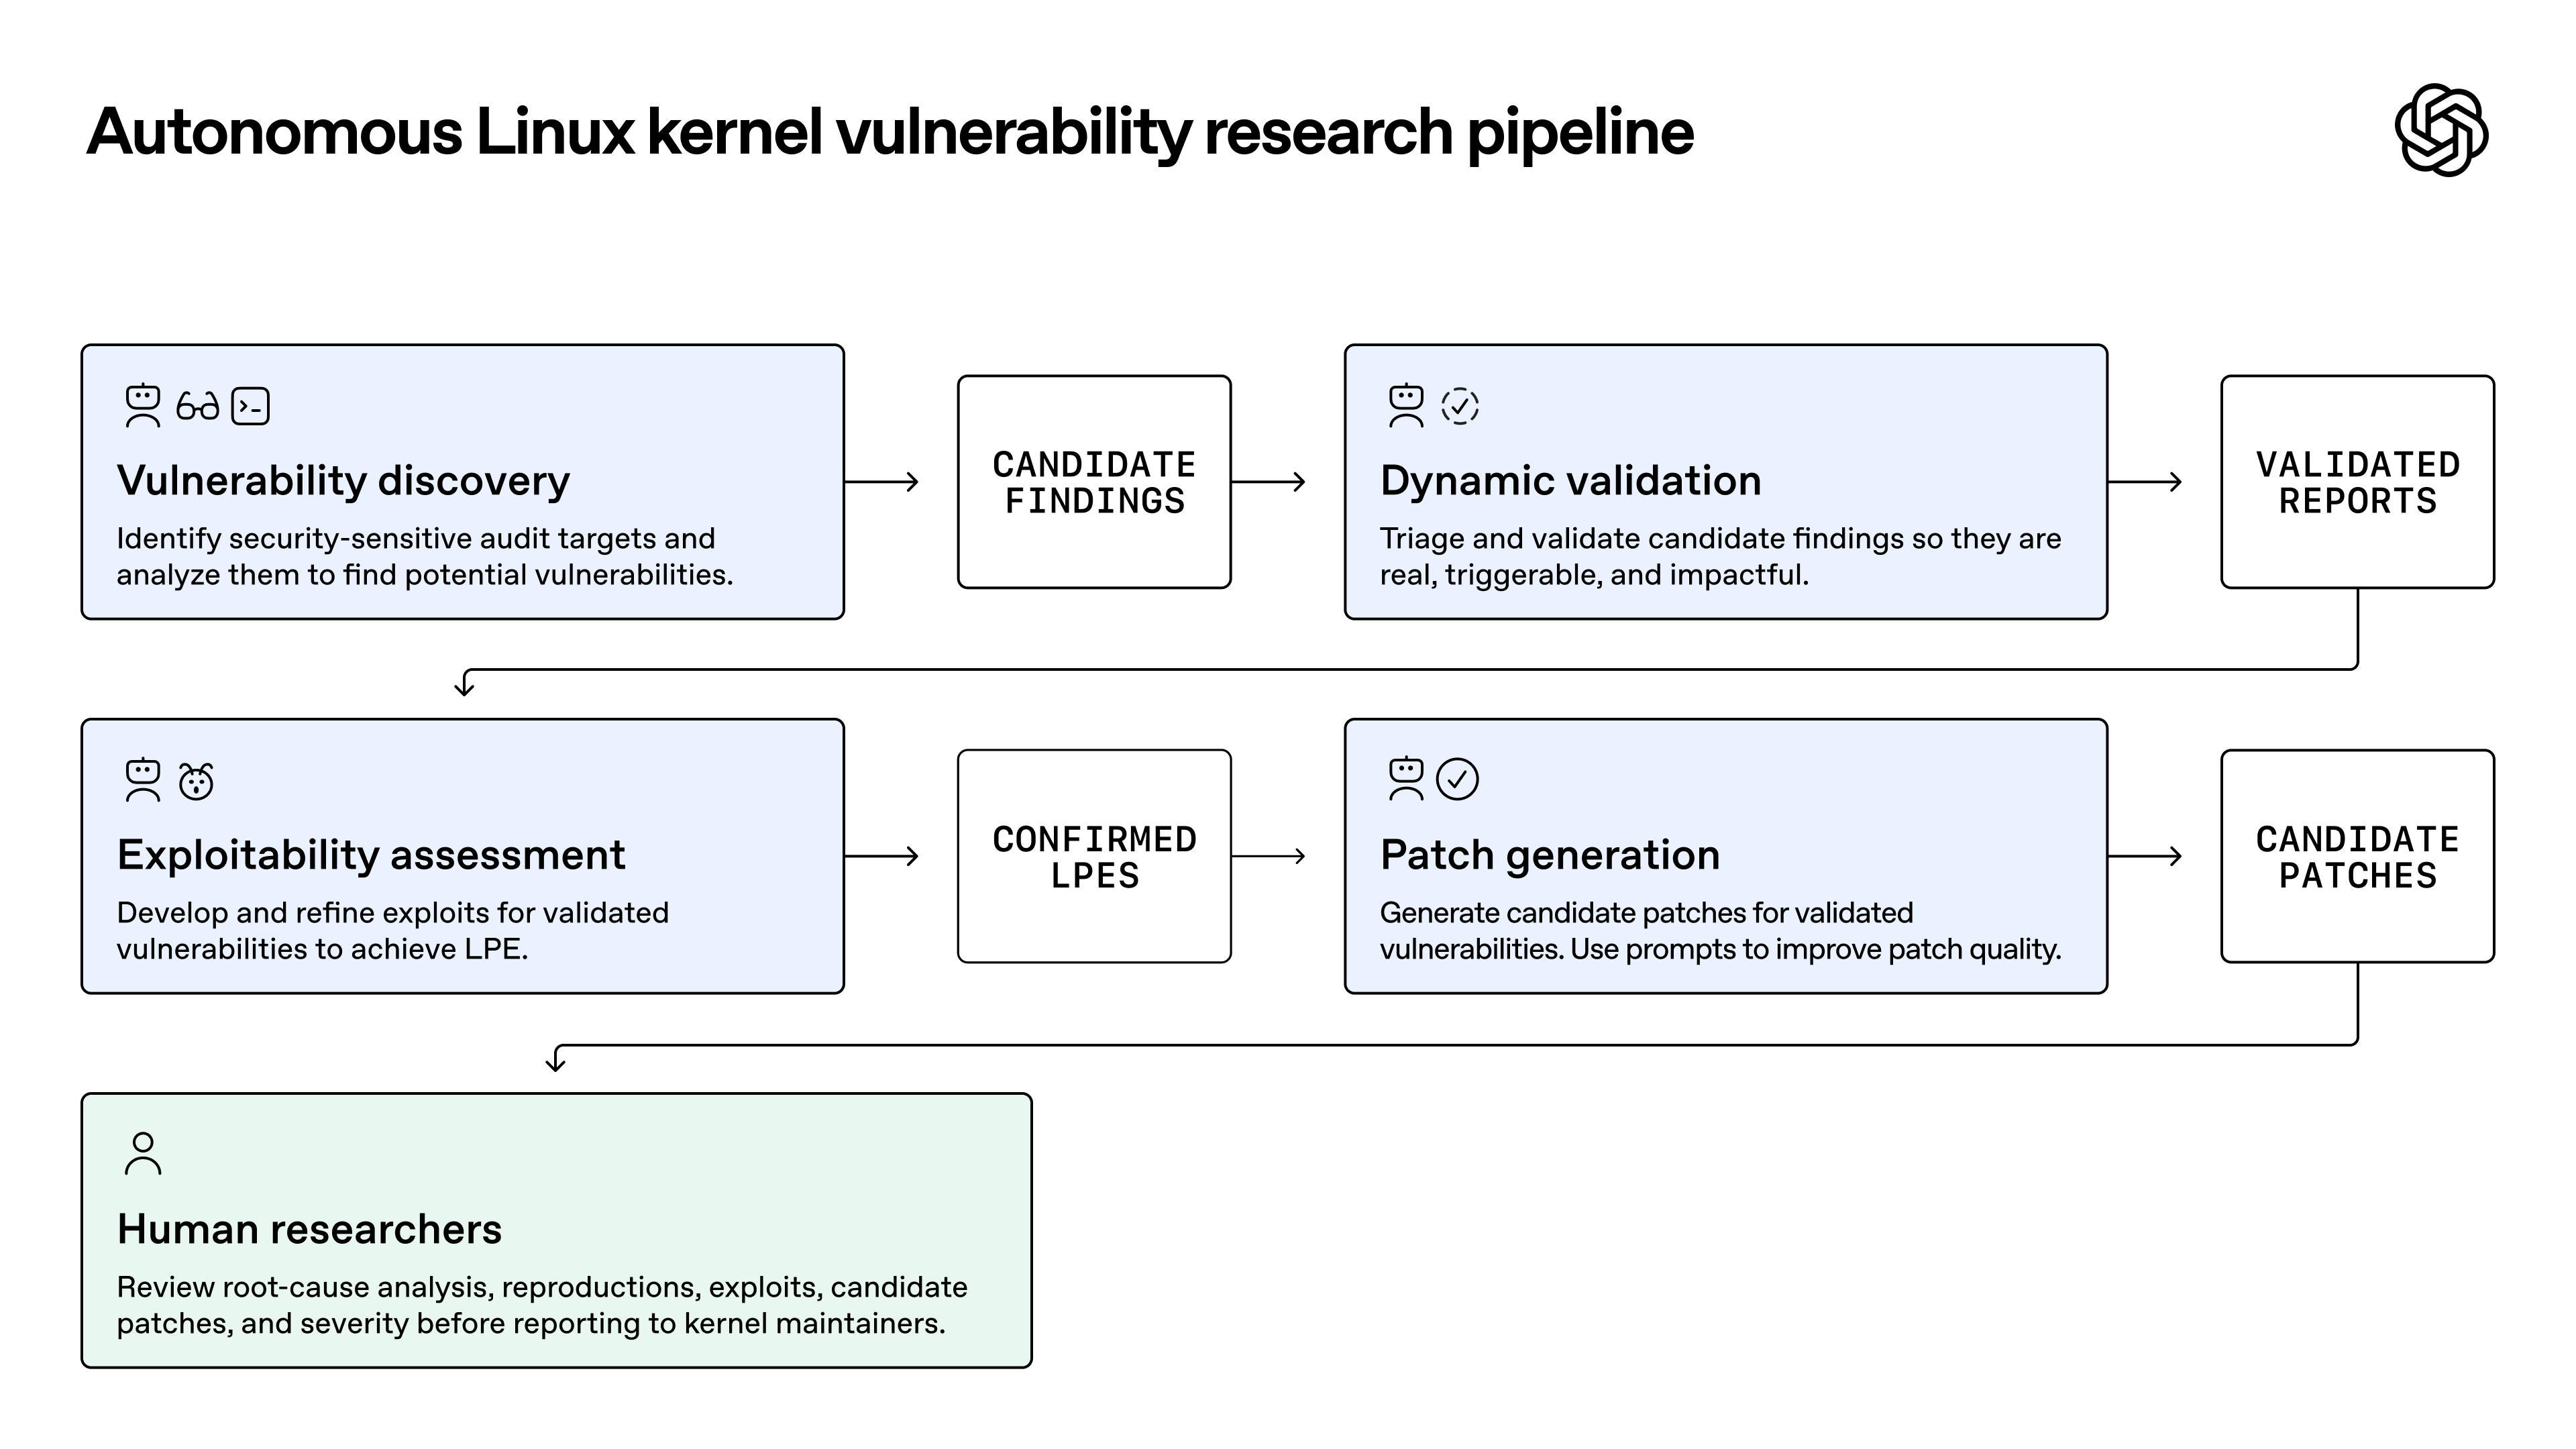
Un workflow de sécurité piloté par agents IA découpe l’audit en plusieurs étapes, où chacune resserre le périmètre et produit des preuves pour la suivante. La version d’OpenAI en compte cinq :
- Découverte. Des agents éclaireurs sélectionnent les cibles d’audit selon leur accessibilité et leur pertinence sécuritaire. Des agents analystes examinent chaque cible, élaborent un modèle de menace et signalent les anomalies potentielles.
- Validation dynamique. Des agents de triage conçoivent une preuve de concept et l’exécutent dans une machine virtuelle isolée avec KASAN, un détecteur d’erreurs mémoire du noyau, en l’affinant jusqu’à ce que le bogue soit reproduit ou que les pistes soient épuisées.
- Évaluation de l’exploitabilité. Un agent de filtrage écarte les anomalies sans voie d’exploitation plausible. Des agents concepteurs d’exploits (ExploitDev) testent les pistes restantes.
- Génération de correctifs. Des agents préparent un correctif pour chaque bogue validé, en respectant les conventions du code environnant et en recherchant d’éventuelles variantes.
- Revue humaine. Des chercheurs en sécurité examinent l’exploit, le correctif et la gravité avant toute transmission aux mainteneurs.
Chaque passage de relais transmet des preuves concrètes et non de simples suppositions, ce qui permet à l’humain en bout de chaîne de prendre des décisions éclairées par les faits.
Comment adapter chaque étape à votre propre dépôt
N’appliquez ce workflow qu’au code qui vous appartient ou que vous êtes autorisé à tester. Pour votre dépôt, éliminez complètement l’étape de conception d’exploits : un test en échec suffit amplement à prouver l’existence d’un défaut sans avoir à fabriquer une arme d’attaque.
| Étape OpenAI | Votre version | Livrable |
|---|---|---|
| Scout | Lister les points d’entrée accessibles aux utilisateurs anonymes ou peu privilégiés : routes, webhooks, téléversements, parseurs, consommateurs de files d’attente | Liste d’audit |
| Analyst | Une cible par exécution : lire le code, formaliser un modèle de menace succinct, signaler les failles suspectées | Anomalies candidates |
| Validate | Écrire un test minimaliste qui échoue dans un environnement jetable | Test et journaux d’exécution |
| Assess | Évaluer l’impact selon la frontière de confiance franchie | Niveau de gravité justifié |
| Patch | Ébaucher le correctif sous forme de pull request incluant le test | Pull request |
| Human | Examiner, puis fusionner ou rejeter | Correctif fusionné ou anomalie classée |
Délimiter le périmètre s’avère vite rentable. Les agents éclaireurs d’OpenAI n’ont coûté que 3 426 $ et ont restreint l’audit à environ 7 % du noyau. Commencez par un seul service et ses points d’entrée publics. Une consigne de tâche pour une seule anomalie peut être aussi concise que cela :
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
Vérifiez le cheminement, pas seulement le résultat
Lors d’un premier test, l’étape d’exploitation d’OpenAI a rapporté 200 succès. La revue humaine a toutefois révélé que 20 d’entre eux avaient obtenu les accès root via un zero-day différent de celui initialement assigné. Le pipeline avait conclu à une réussite sur la seule base du résultat obtenu, alors que ce résultat était atteint pour une mauvaise raison.
OpenAI a donc renforcé les contraintes de la tâche et mis en place une vérification indépendante s’assurant que chaque exploit s’appuie bien sur la vulnérabilité qui lui était attribuée. La leçon à en tirer : validez le cheminement menant au résultat tout autant que le résultat lui-même.
Dans vos projets, la situation est familière : un agent affirme que son test démontre la faille d’authentification, alors que le test échoue en réalité à cause d’une fixture manquante. Ajoutez un agent de vérification qui n’a pas participé à l’écriture du test, et posez-lui une question simple : cet échec provient-il bien du chemin de code signalé ?
Validez tôt : les faux positifs coûtent tout autant
OpenAI a constaté que tenter de valider un vrai positif et un faux positif coûtait approximativement la même chose. Chaque mauvaise piste qui parvient jusqu’à la phase de validation consomme donc une exécution complète à perte.
Filtrez avant de chercher à prouver. OpenAI a validé uniquement les anomalies qu’un utilisateur peu privilégié pouvait atteindre, qui n’exigeaient aucune permission spéciale et qui produisaient des preuves mesurables. Définissez des garde-fous équivalents pour votre code, comme « accessible sans rôle d’administrateur ». Les anomalies qui échouent à ce filtre sont immédiatement clôturées avec une justification.
Revérifiez ensuite les anomalies par rapport à la version la plus récente du code avant de les remonter, comme le préconise OpenAI, afin d’éviter les signalements redondants ou obsolètes.
Fixez une condition d’abandon avant le lancement
Les tentatives infructueuses sont celles qui pèsent le plus lourd financièrement. Sur les candidats LPE, 69 échecs ont coûté en moyenne 3 922 $ chacun, contre 360 $ en moyenne pour 1 169 réussites. D’après nos calculs, cela signifie qu’environ 6 % des tentatives ont englouti près de 39 % des 691 000 $ dépensés sur cette étape.
La solution recommandée par OpenAI consiste à fixer une condition d’abandon, par exemple s’arrêter au bout d’une heure en l’absence de progrès. Intégrez cette règle dans la consigne de la tâche et renforcez-la avec une limite stricte sur la durée d’exécution.
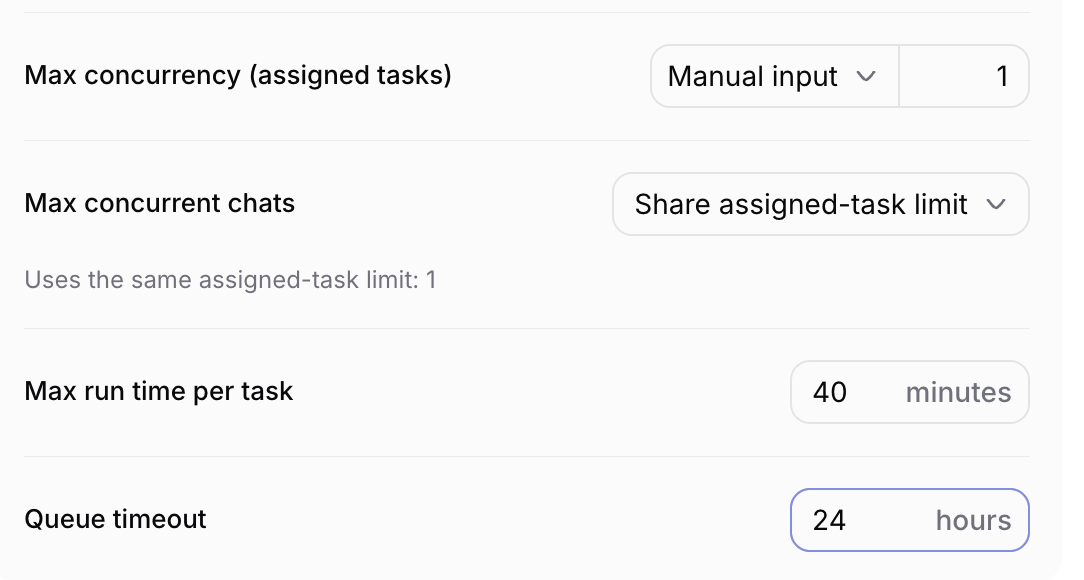
Dans Sharkly, le délai d’expiration par tâche se configure dans les paramètres d’exécution (Run settings) de l’agent. Il s’agit d’un plafond temporel et non d’un détecteur d’avancement : veillez donc à conserver la consigne « pas de nouvelle preuve » dans vos instructions.
Allégez l’orchestration au fil de la montée en puissance des modèles
OpenAI avait mis en place une couche de 103 techniques d’exploitation pour GPT-5.5 Cyber, augmentant son taux de réussite de 76,2 % à 88,9 %. Mais cette même couche n’a apporté qu’un gain marginal de 1,5 point sur GPT-5.6 Cyber, ce qui a conduit OpenAI à la supprimer.
Réévaluez vos propres structures d’encadrement à chaque changement de modèle. Pensez également à relancer des scans : la campagne d’octobre a permis d’identifier plus de 5 fois plus de nouvelles LPE qu’une campagne menée en juillet avec GPT-5.6 Sol, alors même que le code avait bénéficié de trois mois supplémentaires de durcissement.
Conservez une revue humaine avant toute mise en production
Les agents préparent les correctifs sous forme de pull requests, mais c’est un être humain qui les fusionne. OpenAI a constaté que les correctifs de premier jet pouvaient être inutilement volumineux, omettre certaines variantes ou enfreindre des conventions, et que des passes successives permettaient de les perfectionner.
L’entreprise recommande également d’employer des modèles pour effectuer une revue contradictoire des correctifs, qu’ils soient écrits par des humains ou par des IA. Confiez donc à un agent la mission de tenter de contourner le correctif, puis laissez un humain trancher. Si la revue constitue déjà un goulet d’étranglement dans votre organisation, découvrez comment concevoir la revue de code pour des agents en parallèle avant d’ouvrir la voie à un nouveau flux continu de pull requests.
Comment exécuter ce workflow sous forme de tâches dans Sharkly
La tâche (Task) constitue l’unité de travail principale dans Sharkly. Voici une approche pour mettre en place ce workflow :
- Créez un type de tâche. Un type de tâche régit un workflow composé de statuts ordonnés. Un type « Faille de sécurité » peut par exemple suivre la séquence suivante : Candidat, Reproduit, Correctif ébauché, En revue, Fermé.
- Créez une équipe (Crew). Une Crew est un groupe réutilisable d’humains et d’agents coordonné par un agent pilote. Ajoutez-y des agents éclaireur, analyste, vérificateur et correcteur. Le leader se lance en premier et mentionne les membres appropriés pour chaque action spécifique.
- Isolez les exécutions. Utilisez un répertoire temporaire pour que chaque tâche dispose de son propre worktree Git, et consultez notre guide sur les worktrees isolés si vous distribuez les charges. Désactivez le répertoire partagé de la Crew là où l’agent vérificateur doit travailler en toute indépendance.
- Automatisez les passages de relais. Une automatisation déclenchée par le changement de statut d’une tâche peut lancer l’agent correcteur dès qu’une tâche passe à l’état « Reproduit ». Ces exécutions s’effectuent sans surveillance humaine et ne peuvent pas poser de questions ; comme la correspondance de statut s’applique à l’échelle de l’organisation, précisez dans les instructions de vérifier la tâche d’origine.
- Associez les pull requests. Grâce à l’intégration GitHub, mentionner l’identifiant de la tâche dans la branche, le titre ou la description lie automatiquement la pull request. La fusion de la PR ne modifiant pas le statut de la tâche, c’est le relecteur qui clôture cette dernière.
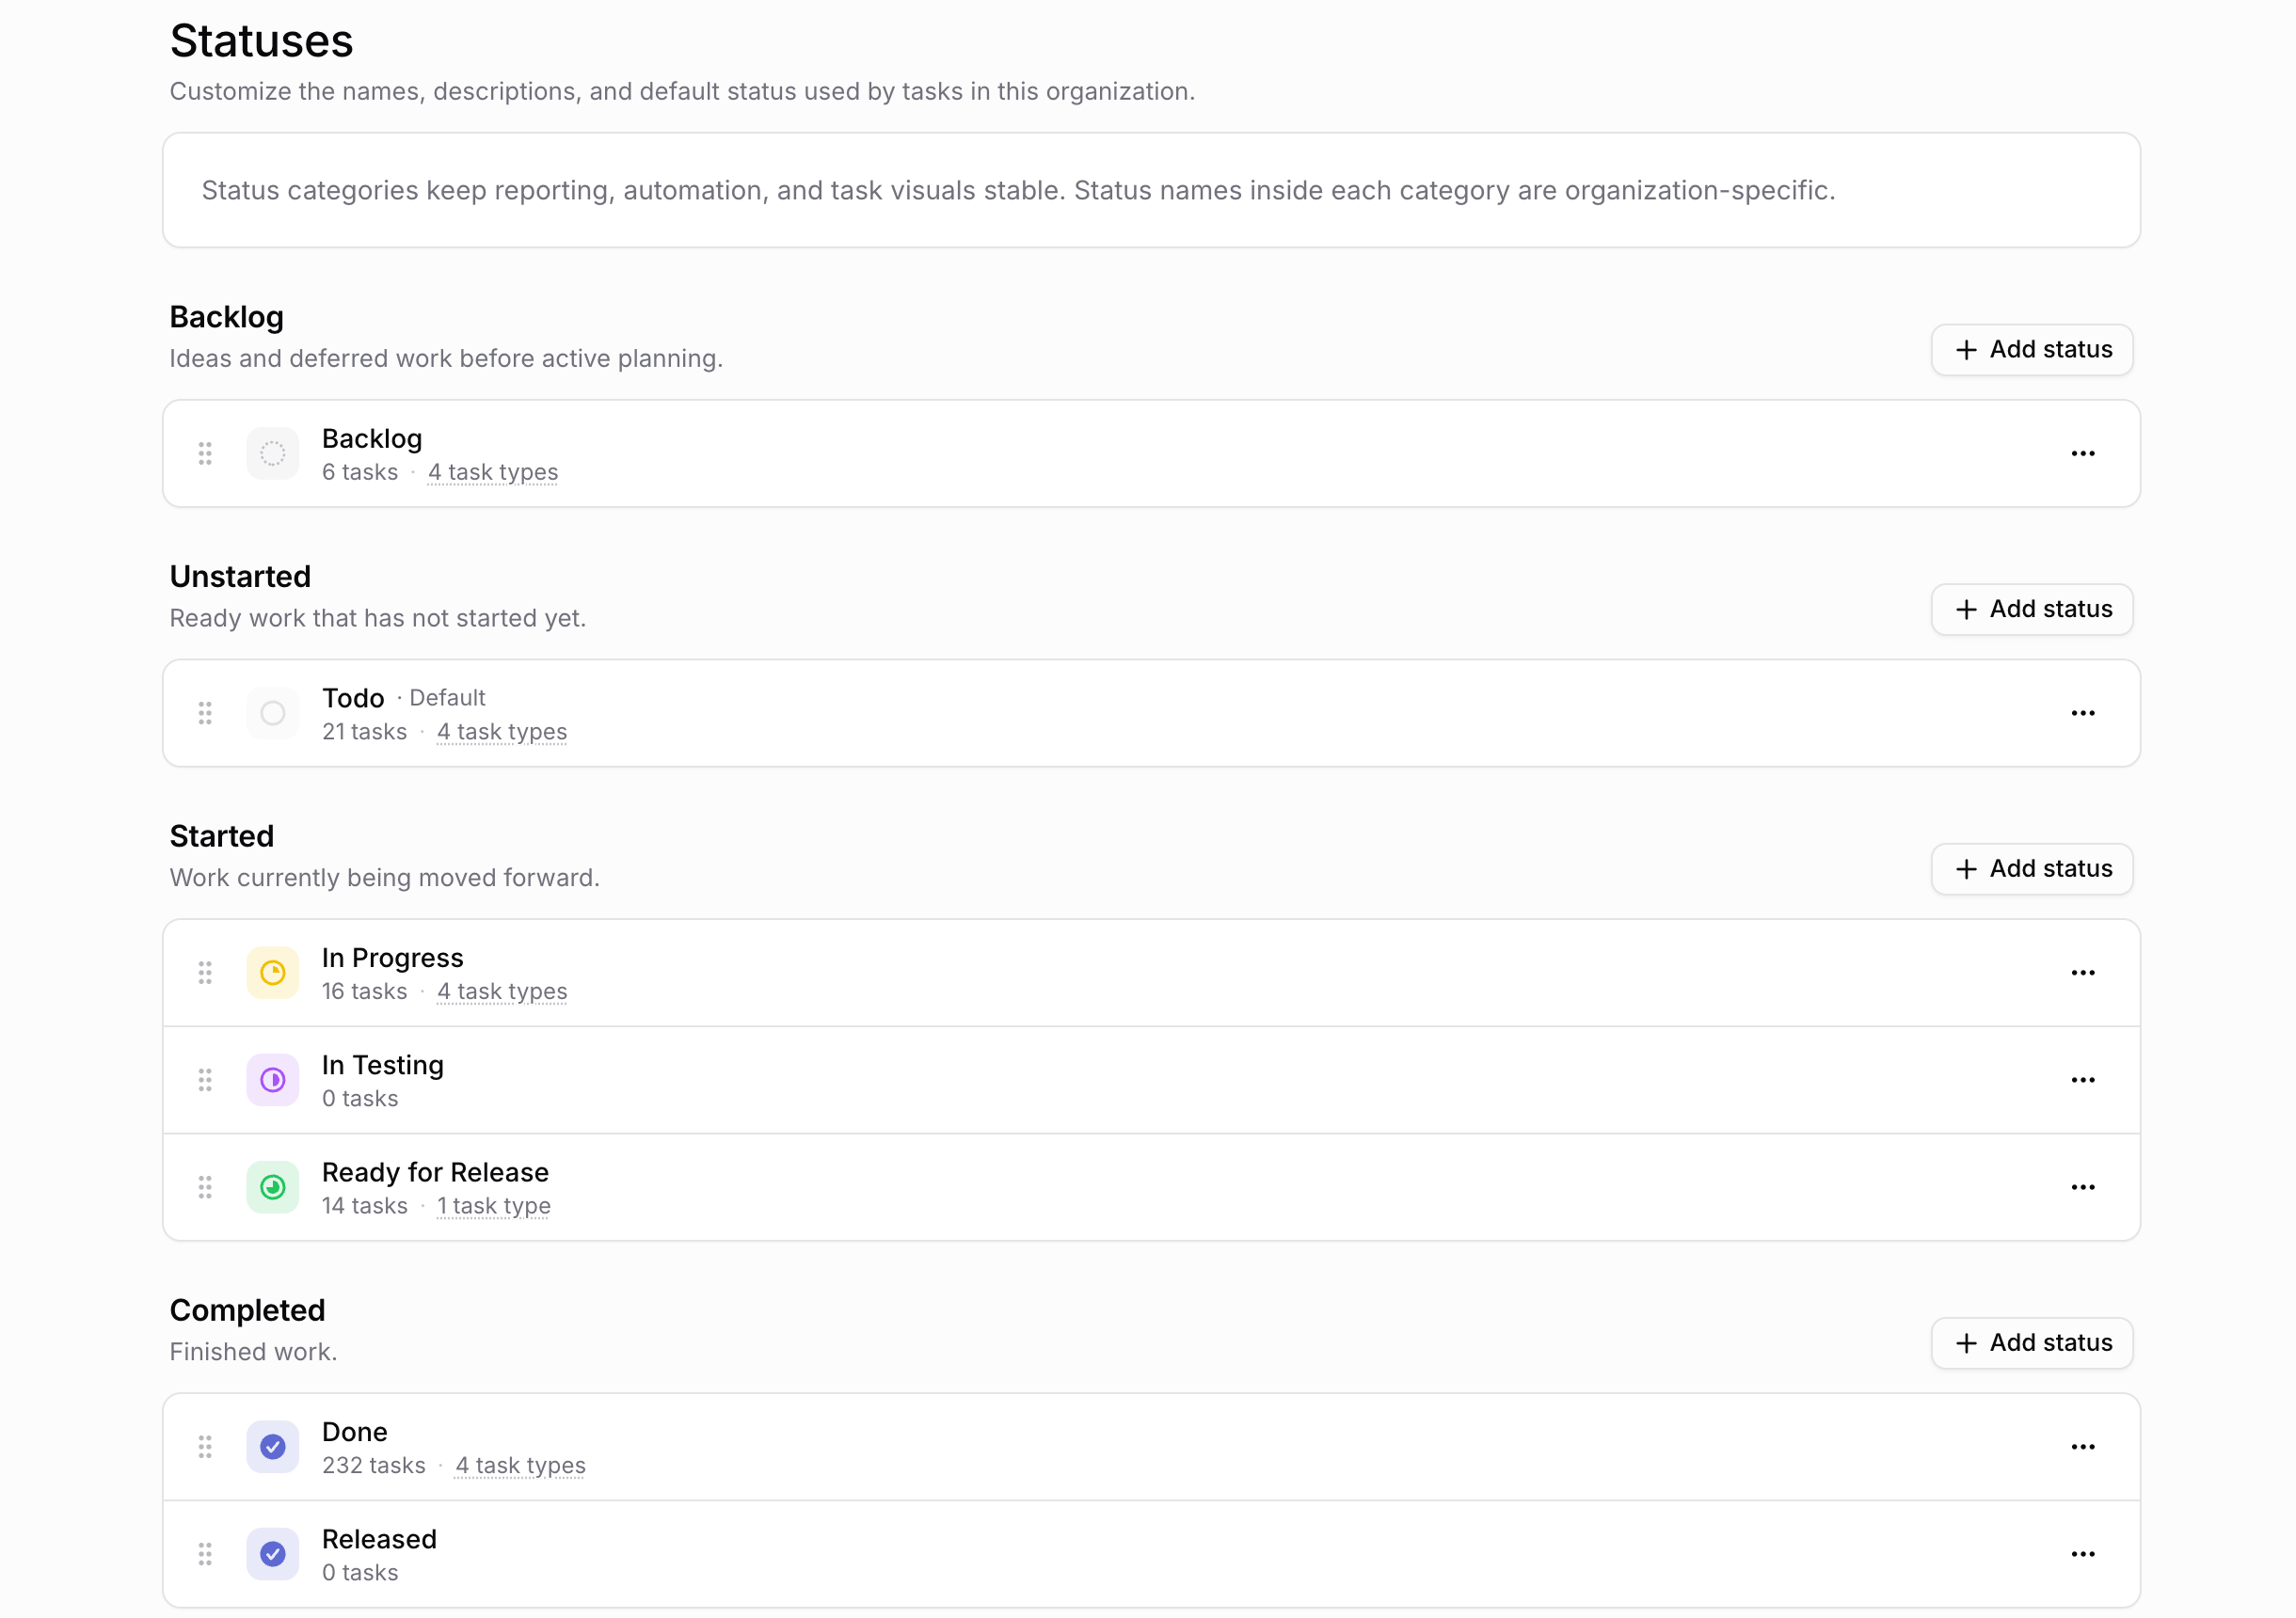
Les statuts étant partagés à l’échelle de l’organisation, ajoutez-en de nouveaux pour ce workflow plutôt que de renommer les états existants.
Une démarcation technique essentielle s’impose ici : un worktree évite les collisions entre tâches, mais ne constitue pas un bac à sable de sécurité étanche. Exécutez les tests de reproduction dans un conteneur ou une machine virtuelle jetable dépourvus de tout secret de production, et n’accordez aux agents que les autorisations Git strictement nécessaires.
Sharkly coordonne ce travail. Claude Code, Codex et d’autres outils similaires assurent l’exécution, l’utilisation des modèles s’effectuant via les abonnements ou clés d’API configurés dans ces environnements. Si vous souhaitez déployer à plus grande échelle, découvrez comment exécuter 10 agents de code IA en simultané.
Pour un petit dépôt, affectez un seul agent par tâche et faites l’impasse sur la Crew. Utilisez une Crew lorsqu’un coordinateur doit orchestrer plusieurs rôles successifs et consolider les résultats au sein d’une même tâche.
Conclusion
Le résultat obtenu par OpenAI fournit une feuille de route claire pour votre équipe : resserrez le périmètre, exigez des preuves tangibles à chaque étape, vérifiez le cheminement emprunté, interrompez au plus vite les tentatives infructueuses et conservez une présence humaine sur le bouton de fusion.
Lancez-vous dès cette semaine. Choisissez un service sous votre responsabilité, listez ses points d’entrée publics et ouvrez une tâche de validation par anomalie suspectée. Le guide de démarrage rapide de Sharkly vous permet d’activer votre premier agent sur une machine connectée, et sharkly.ai vous montre comment structurer la gestion des tâches et de la revue autour de vos agents.
FAQ
Les agents d’OpenAI ont-ils attaqué des systèmes Linux en production ?
Non. Les exploits ont été exécutés dans des machines virtuelles isolées au sein d’un environnement de recherche contrôlé, et des chercheurs humains ont soigneusement analysé les résultats avant toute divulgation.
Les 948 vulnérabilités Linux sont-elles toutes corrigées ?
Non. Beaucoup sont encore en phase de signalement et de correction. Au terme de la phase d’audit de 10 jours, 61 étaient corrigées en amont et 43 disposaient de correctifs en cours d’intégration (staging).
Ces exploits peuvent-ils compromettre un serveur à distance ?
Pas à eux seuls. Il s’agit de failles d’élévation locale de privilèges : un attaquant doit donc d’abord obtenir un accès local sur la machine cible. Maintenez vos systèmes à jour et isolez les charges de travail non fiables.
Combien coûterait ce workflow sur mon propre dépôt ?
Les coûts observés par OpenAI ne sont pas directement transposables, car ils couvrent une analyse à l’échelle du noyau Linux. Démarrez sur un seul service, appliquez des limites d’exécution et mesurez le coût par anomalie validée.
Dois-je impérativement utiliser le modèle cyber d’OpenAI ?
Ce n’est pas possible actuellement, car OpenAI le présente comme un modèle à paraître. Les différentes étapes sont indépendantes du modèle : vous pouvez donc les tester avec les agents de code que votre équipe utilise déjà et évaluer les résultats selon la qualité des preuves fournies.


