
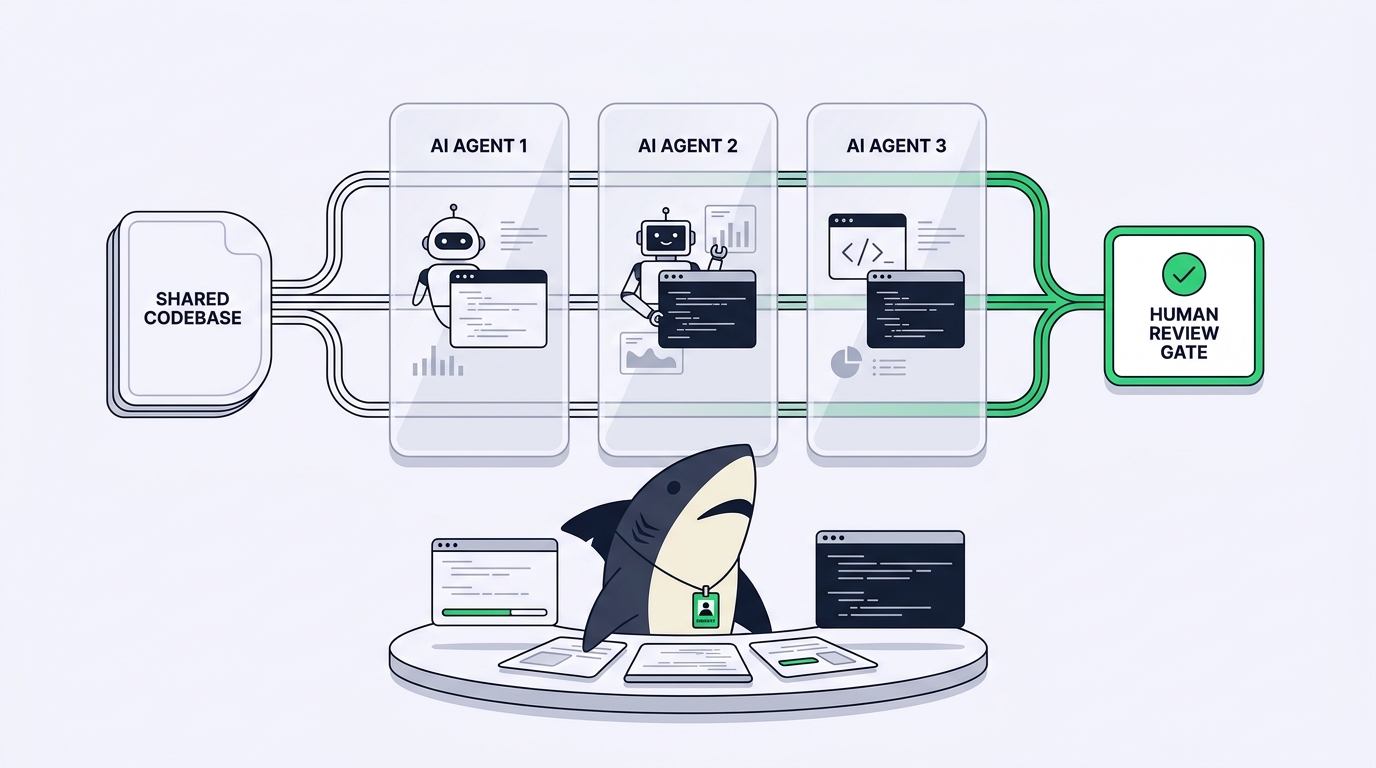
Lancez deux agents de codage dans le même checkout et vous tomberez sur le mode de défaillance en moins d’une heure. Un agent change de branche pendant que l’autre est en pleine modification. Des modifications indexées disparaissent dans un commit auquel elles n’appartiennent pas. Les tests passent sur un fichier que l’autre agent a à moitié réécrit. Rien de tout cela n’est la faute du modèle. Un arbre de travail Git est un état mutable partagé, et deux processus qui modifient un état partagé sans se coordonner finissent par le corrompre.
Le remède classique est bien connu : donner à chaque agent son propre arbre de travail. Les worktrees Git permettent à un seul dépôt de desservir plusieurs répertoires extraits en même temps, de sorte que des branches parallèles ne touchent jamais les mêmes fichiers sur le disque. Beaucoup d’équipes scriptent cela à la main ; notre guide sur l’utilisation des worktrees Git avec des agents de codage IA détaille ce montage maison.
Cet article traite de l’autre voie : ce qui se passe lorsque l’isolation, la préparation des répertoires, les plafonds de concurrence et le nettoyage sont pris en charge par la plateforme plutôt que par vos scripts shell.
TL;DR
Sharkly exécute des agents IA en parallèle sans conflit de fusion en attribuant à chaque exécution de Task son propre répertoire isolé sur un Computer connecté. Un service local installé sur ce Computer reçoit chaque exécution mise en file d’attente, prépare le répertoire de la tâche (pour les travaux adossés à un dépôt, un worktree Git distinct par exécution), démarre le Runtime sélectionné et renvoie en continu la progression, les événements de trace et le résultat vers la Task. Les limites de concurrence définies sur l’Agent et sur le Computer plafonnent le nombre d’exécutions simultanées, et rien ne fusionne tout seul : le résultat revient dans la Task, où une personne examine la modification et décide de l’étape de fusion et de publication. Les agents ne partagent jamais d’arbre de travail, de sorte que des Tasks parallèles ne peuvent pas écraser mutuellement leurs modifications.
Le mode de défaillance que Sharkly est conçu pour prévenir
Il est utile de préciser ce qui ne va pas lorsque des agents partagent un checkout, car chaque symptôme correspond à un élément de la solution.
L’état des branches est global à chaque arbre de travail : lorsque l’agent A extrait sa propre branche, les fichiers de l’agent B changent sous ses pieds en pleine exécution. L’index est global lui aussi, si bien que git add et git commit entremêlent le travail de tâches différentes. L’état non suivi entre en collision : les artefacts de build et les installations de dépendances d’une exécution contaminent les résultats de tests d’une autre exécution. Et la dette de nettoyage s’accumule, car chaque copie de dépôt improvisée pour contourner les trois premiers problèmes reste sur le disque jusqu’à ce qu’un humain se souvienne de son existence.
Un répertoire partagé unique ne peut jamais faire tourner qu’un seul agent en toute sécurité. Si vous jonglez avec cela à coups de fenêtres tmux et de discipline, notre article sur l’exécution de plusieurs agents Claude Code en parallèle explique pourquoi ce plafond est atteint si vite.
La pile d’exécution : Agent, Computer, Runtime, Task
Sharkly ne remplace pas Claude Code, Codex ou d’autres outils d’exécution. Il ajoute la couche de tâche partagée, de Computer, de contexte, de contrôle et de revue autour des outils que votre équipe utilise déjà. Ce positionnement en couche détermine le fonctionnement de l’exécution parallèle, car le rôle de Sharkly est de coordonner les exécutions, pas d’écrire du code.
Quatre rôles se partagent le travail, et chacun a exactement une mission :
- L’Agent définit la manière dont le travail doit être traité : ses instructions, ses Skills, ses dépôts et ses paramètres d’exécution. Un Agent n’est pas l’hôte d’exécution.
- Le Computer fournit l’hôte et les ressources locales : une machine locale, un serveur distant, un conteneur ou un hôte cloud pris en charge. L’article complémentaire sur les Computers dans Sharkly traite de leur connexion.
- Le Runtime exécute la session d’agent proprement dite. C’est l’outil concret installé sur ce Computer, comme Claude Code, Codex ou Gemini CLI.
- La Task reste l’enregistrement partagé de l’équipe : objectif, statut, discussion, trace d’exécution et résultat.
C’est un petit service local installé sur le Computer qui relie le tout. Il enregistre le Computer, détecte les Runtimes installés, reçoit les exécutions mises en file d’attente, prépare le répertoire de tâche pour chaque exécution, démarre le Runtime et remonte les résultats. C’est lui qui initie la connexion au serveur, si bien qu’une installation type ne nécessite aucun port entrant.
C’est cette séparation qui rend le parallélisme gérable. Comme le répertoire de travail est préparé pour chaque exécution par le service local, et non choisi par l’Agent, deux Agents affectés à deux Tasks peuvent viser le même dépôt sur le même Computer sans jamais voir les fichiers de l’autre. Pour savoir comment configurer les Agents, voir les Agents dans Sharkly.
Ce qui se passe au démarrage d’une exécution
Assignez une Task à un Agent et faites-la sortir du Backlog : Sharkly vérifie que l’exécution est possible, met une exécution éligible en file d’attente et la distribue au Computer sélectionné. À partir de là, le service local prend le relais. Avant que le Runtime ne démarre, il peut devoir attendre qu’une place de concurrence se libère, préparer un répertoire temporaire isolé ou attendre qu’un répertoire spécifié se libère, récupérer les dépôts configurés, projeter les variables d’environnement autorisées et construire l’appel au Runtime.
C’est seulement alors que le Runtime démarre. L’exécution passe par des états explicites : En file d’attente, Distribué, En attente d’un répertoire local, En cours, puis Terminé, Échoué ou Annulé. Ces états apparaissent dans le journal d’exécution de la Task, de sorte que la question « pourquoi rien ne s’est-il encore passé ? » a une réponse vérifiable au lieu d’une supposition. Une exécution maintenue dans l’état En file d’attente parce que la limite de concurrence est atteinte n’a pas la même allure qu’une exécution maintenue dans l’état En attente d’un répertoire local, et la différence vous indique quel levier actionner.
Remarquez ce qui est absent : à aucun moment l’Agent ne décide où s’exécuter. L’Agent apporte les instructions ; l’infrastructure apporte l’isolation.
Worktrees isolés : comment fonctionne le mode Temporaire
Les Agents prennent en charge deux modes de répertoire de travail, et celui conçu pour le travail parallèle est le mode Temporaire. Chaque Task dispose d’un répertoire isolé et, pour les travaux adossés à un dépôt, le service local peut préparer un worktree Git distinct pour chaque exécution à partir de ses données de dépôt en cache.
Cette seule phrase résume toute la prévention des conflits. Un worktree donne à chaque exécution son propre répertoire extrait et son propre état de branche, tout en partageant les objets du dépôt sous-jacent. Les quatre modes de défaillance ci-dessus disparaissent par construction : pas de pointeur de branche partagé, pas d’index partagé, pas d’artefacts de build partagés, et des répertoires que la plateforme peut nettoyer plus tard. Comme les worktrees proviennent de données en cache plutôt que d’un clone neuf, le coût de démarrage reste raisonnable, même si une exécution peut encore avoir besoin d’un accès réseau pour rafraîchir le dépôt.
La documentation est claire sur le moment de l’utiliser : le mode Temporaire est recommandé pour les modifications de code en parallèle et pour toute situation où plusieurs Tasks sont susceptibles de modifier la même base de code en même temps.
Une limite mérite d’être énoncée clairement : l’isolation empêche les collisions d’arbres de travail, pas les conflits sémantiques. Si deux Tasks réécrivent la même fonction, les deux exécutions se terminent proprement dans leurs worktrees respectifs, et une personne doit tout de même réconcilier le chevauchement lors de la revue. La solution consiste à délimiter le périmètre des Tasks pour qu’elles ne visent pas le même code le même après-midi : une décision de planification, pas d’infrastructure.
Quand l’isolation n’est pas le bon choix : le mode Spécifié
Le second mode existe parce qu’un répertoire neuf à chaque exécution a un coût. En mode Spécifié, l’Agent s’exécute dans un répertoire local absolu configuré, issu de son pool, en réutilisant le dépôt, les dépendances et les caches déjà présents à cet endroit. Il n’est disponible que sur les Computers locaux.
Ce compromis a une conséquence stricte : un répertoire spécifié ne sert qu’une exécution à la fois, et lorsque tous les répertoires configurés sont occupés, l’exécution suivante attend. Un Agent qui doit exécuter plusieurs Tasks simultanément en mode Spécifié a besoin de plusieurs répertoires dans son pool.
| Mode Temporaire | Mode Spécifié | |
|---|---|---|
| Répertoire par exécution | Répertoire isolé neuf, worktree pour les travaux sur dépôt | Un répertoire absolu configuré issu d’un pool |
| Sécurité en parallèle | Les exécutions ne peuvent pas toucher aux fichiers des autres | Une exécution par répertoire à la fois |
| Coût de démarrage | Prépare le répertoire à chaque exécution, à partir des données de dépôt en cache | Réutilise le code, les dépendances et les caches existants |
| Idéal pour | Les modifications de code en parallèle, la plupart des travaux sur dépôt | Les très gros dépôts, un état local coûteux, des outils liés à un répertoire |
| Disponibilité | Tout Computer connecté | Computers locaux uniquement |
L’isolation achète la sécurité au prix de la préparation ; la réutilisation achète la vitesse au prix de la sérialisation. Sharkly vous oblige à choisir explicitement pour chaque Agent, ce qui vaut mieux que de découvrir le compromis dans un arbre de travail corrompu.
Limites de concurrence : parallèle, mais borné
Le parallélisme illimité est un mode de défaillance en soi. Chaque exécution concurrente consomme du CPU, de la mémoire, du disque, de la capacité de fournisseur de modèles et de la bande passante de dépôt ; huit agents qui saturent un seul portable donnent de moins bons résultats que trois qui travaillent à l’aise.
Sharkly borne la concurrence à deux niveaux. Le Computer, en tant qu’hôte, possède une limite de concurrence de tâches, et chaque Agent a un nombre maximal de Tasks exécutées en parallèle, plus un délai d’expiration par Task. Les valeurs par défaut sont prudentes : en mode Temporaire, un Agent obtient 50 % de la limite du Computer ; en mode Spécifié, il s’aligne sur le nombre de répertoires configurés. Si vous la fixez au-delà du nombre de répertoires, le produit vous avertit que les écritures risquent d’entrer en collision entre les tâches. Cet avertissement, c’est la thèse de cet article compressée dans une boîte de dialogue.
La recommandation de la documentation sur le relèvement des limites est du genre sobre : n’augmentez la concurrence qu’une fois que le Computer et le Runtime actuels traitent la charge existante de manière fiable.
Suivi de progression et revue avant fusion
L’isolation deviendrait un handicap si elle rimait aussi avec invisibilité. Cinq agents dans cinq répertoires cachés, c’est exactement comme cela que le travail disparaît dans des terminaux privés. C’est pourquoi tout ce que produit l’exécution remonte vers l’enregistrement partagé.
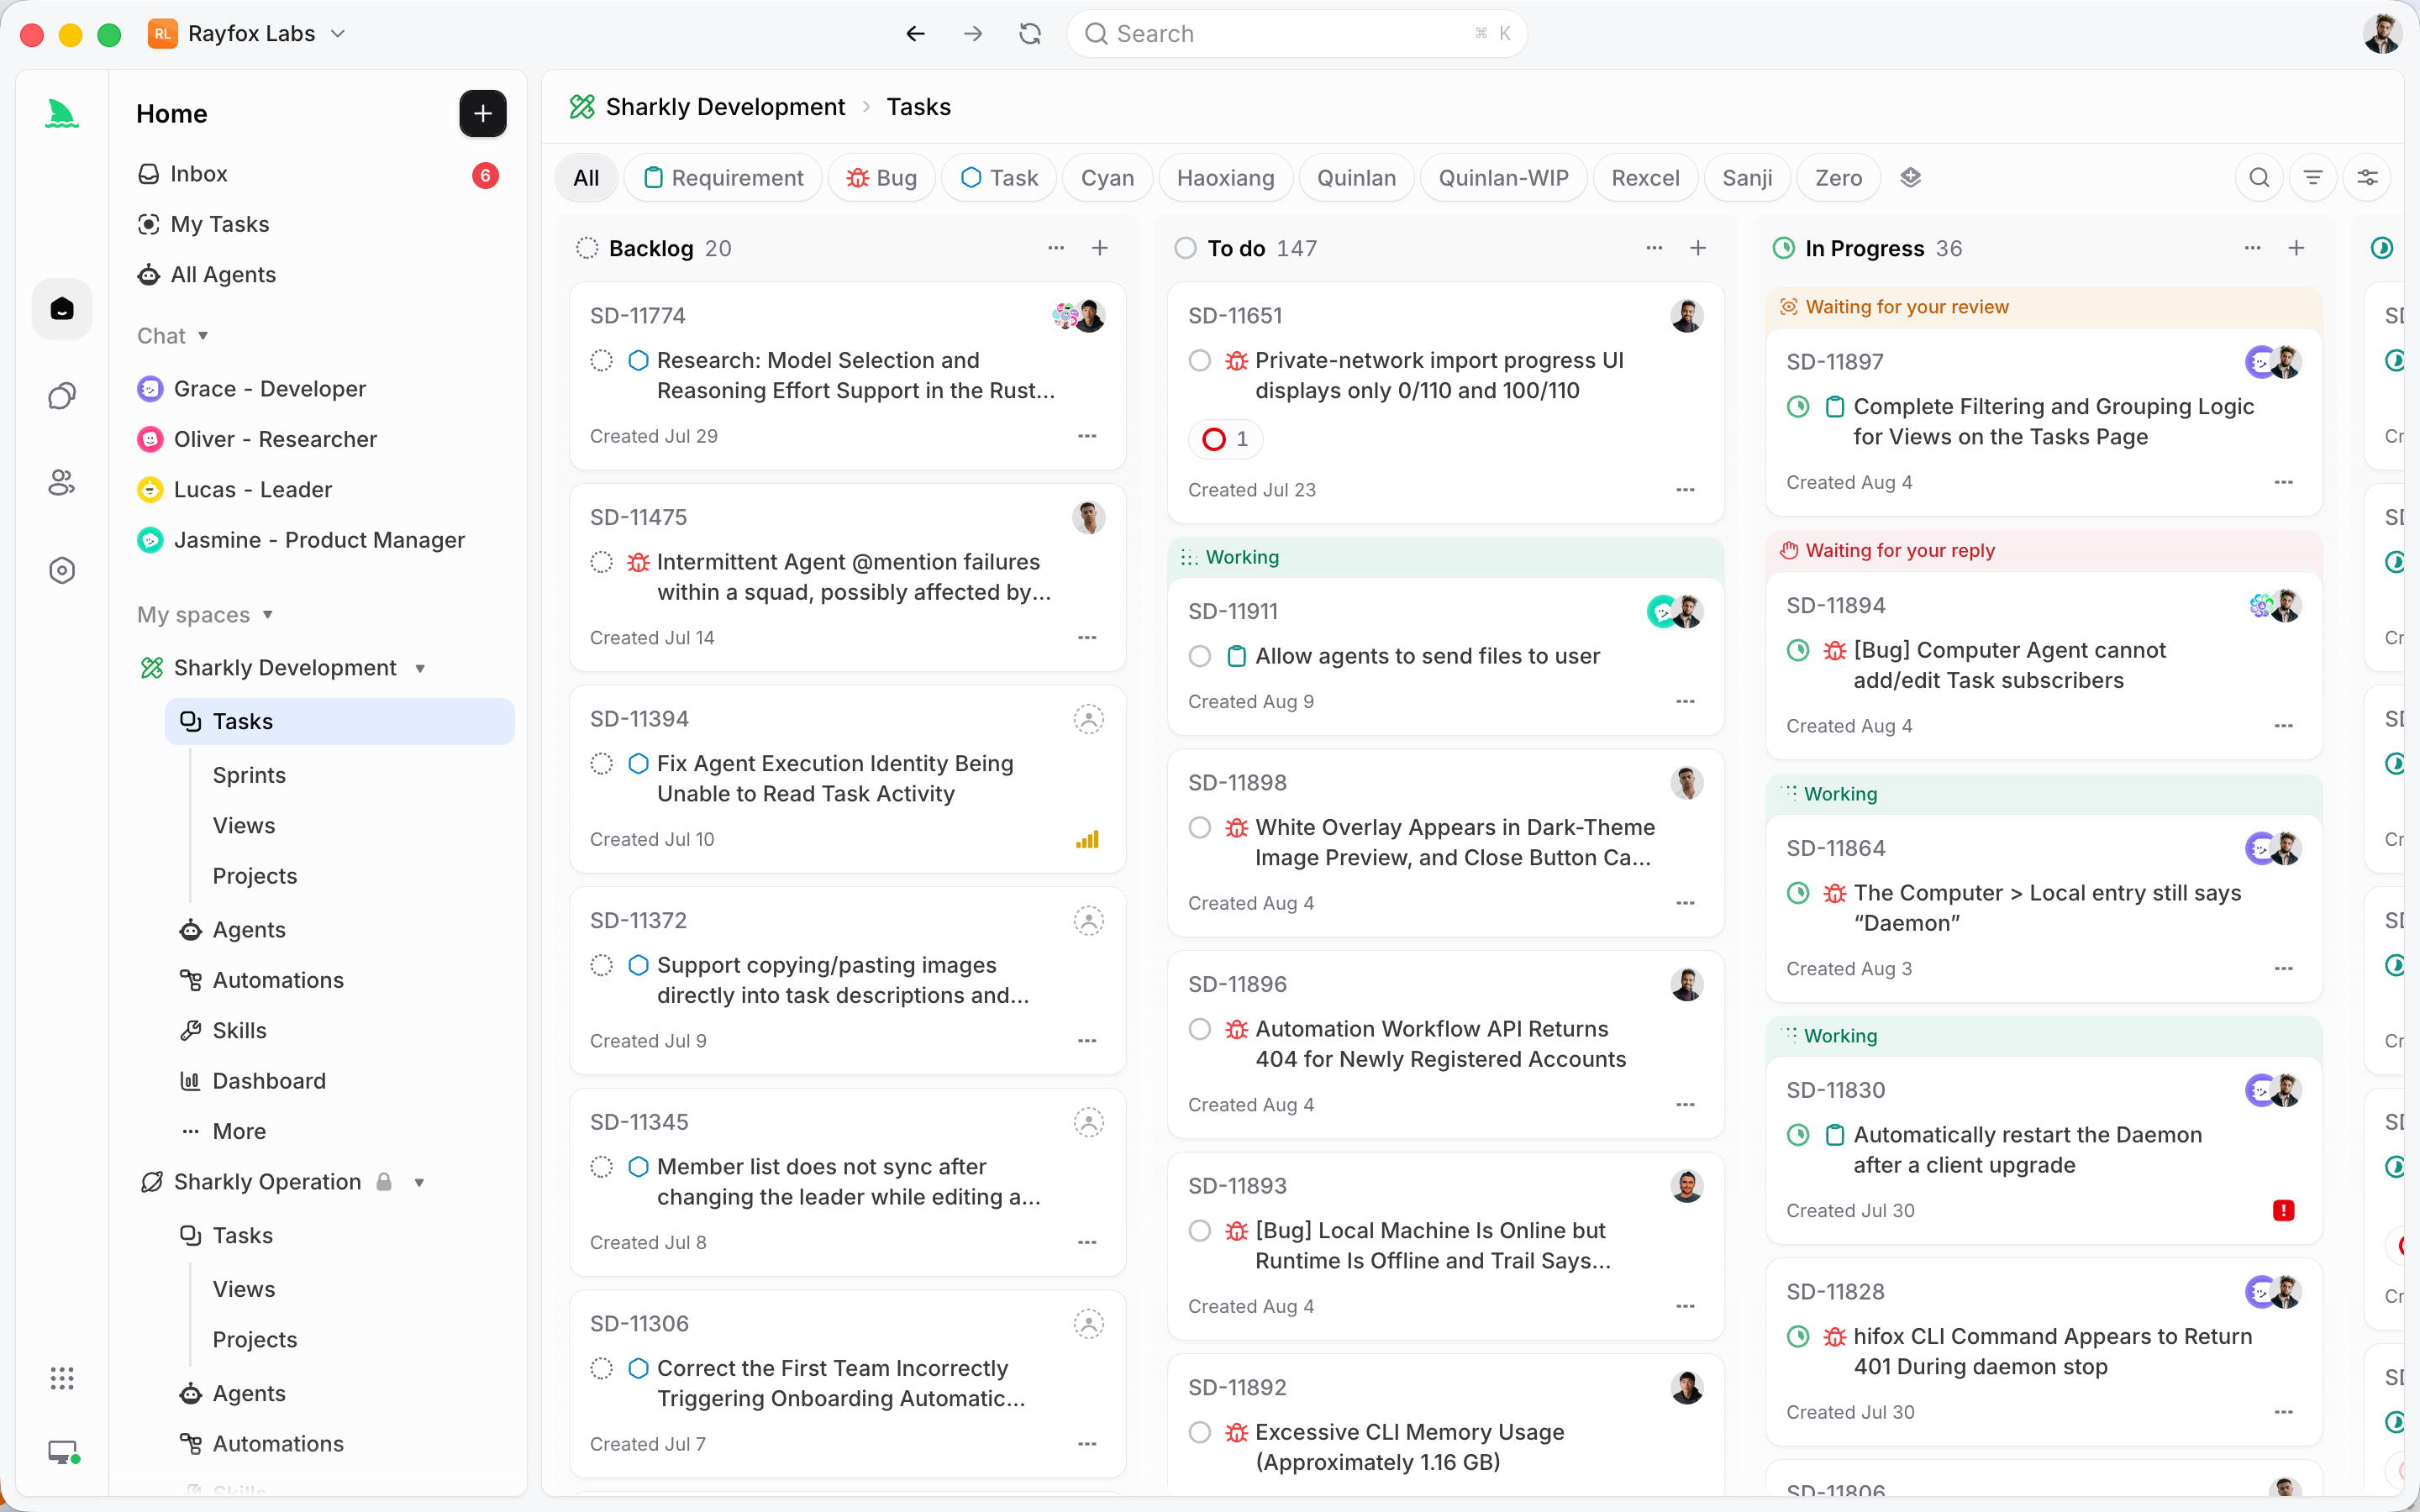
Pendant qu’une exécution est active, la Task affiche son état d’exécution. L’activité rassemble les commentaires et les modifications de la tâche dans une chronologie ; le journal d’exécution consigne le début et la fin de l’exécution, les appels d’outils et les événements du Runtime, la source du déclenchement et les détails d’échec éventuels ; le rapport de l’Agent est conservé sous forme de commentaire lié à sa trace d’exécution. Le contexte, la progression, les blocages et les résultats restent visibles de la demande à la livraison, même si les modifications de fichiers ont eu lieu dans un répertoire que personne n’a jamais ouvert.
Vient ensuite le point de contrôle. Rien ici ne fusionne tout seul. Les agents explorent, exécutent, testent et rendent compte. Les humains donnent la direction, accordent l’autorité et valident le résultat. Lorsqu’une exécution se termine, l’Agent peut laisser la Task en attente d’une revue humaine, ce qui remonte dans la boîte de réception de la personne responsable. Les worktrees isolés rendent l’exécution parallèle sûre ; le point de contrôle de revue la rend fiable.
Une dernière brique referme la boucle : le nettoyage. Les exécutions d’agents laissent des répertoires de travail et des artefacts sur le Computer, et un nettoyage configurable récupère les exécutions terminées après une fenêtre de rétention, avec un seuil minimal d’espace libre comme filet de sécurité. Les travaux en cours ou en file d’attente, les exécutions épinglées et les exécutions échouées qui nécessitent encore une investigation ne sont jamais touchés. C’est la corvée que les montages maison oublient systématiquement jusqu’à ce que le disque soit plein.
Ce que Sharkly automatise par rapport au montage maison
Si vous avez lu notre guide maison sur les worktrees, la correspondance est directe. Le git worktree add que vous scriptez par agent devient le service local qui prépare un répertoire isolé par exécution. Le jugement « combien d’agents, c’est trop » devient des limites de concurrence explicites, avec des avertissements lorsqu’un réglage est risqué. Le git worktree prune que vous oubliez devient un nettoyage fondé sur la rétention. Et la partie qu’aucun script ne vous offre — un enregistrement partagé de ce que chaque exécution a fait et de son acceptation ou non par un humain — c’est la Task elle-même.
L’honnête paire de décisions s’applique ici aussi. Un développeur solo qui fait tourner deux agents sur une seule machine n’a peut-être pas besoin d’une plateforme ; un script de worktree et de la discipline peuvent suffire longtemps. Tournez-vous vers Sharkly lorsque la coordination coûte plus cher que la frappe : plusieurs personnes qui assignent du travail, plusieurs Computers, des exécutions qui nécessitent une mise en file d’attente et une revue. Dans les deux cas, vous conservez les Runtimes que vous utilisez déjà ; l’usage des modèles continue de passer par les abonnements ou les clés API configurés dans ces outils.
Le démarrage se veut volontairement modeste. Connectez un Computer, créez un Agent en mode Temporaire et assignez-lui une Task à faible risque. Le guide de démarrage parcourt la première boucle en une dizaine de minutes, la documentation Sharkly approfondit chaque concept, et l’article sur ce qu’est Sharkly présente la plateforme qui entoure l’exécution.
FAQ
Comment Sharkly évite-t-il les conflits de fusion entre agents parallèles ?
Chaque exécution de Task dispose de son propre répertoire isolé sur le Computer, et les exécutions adossées à un dépôt peuvent chacune bénéficier d’un worktree Git distinct préparé par le service local. Les agents ne partagent jamais de checkout, d’index ni de fichiers non suivis, de sorte que des exécutions concurrentes ne peuvent pas écraser le travail en cours des autres. Les chevauchements où deux Tasks modifient volontairement le même code sont quand même réconciliés par une personne au moment de la revue.
Dois-je configurer des worktrees Git moi-même pour utiliser Sharkly ?
Non. En mode Temporaire, le service local prépare le répertoire de tâche pour chaque exécution, y compris les worktrees pour les travaux adossés à un dépôt. Vous configurez le mode une fois pour toutes sur l’Agent ; aucune commande de worktree n’est à scripter par exécution. Pour comprendre le mécanisme sous-jacent, consultez la documentation sur les worktrees Git.
Combien d’agents peuvent s’exécuter en parallèle sur un même Computer ?
Le Computer a sa propre limite de concurrence de tâches, et chaque Agent a un nombre maximal de Tasks exécutées en parallèle. Par défaut, un Agent en mode Temporaire obtient 50 % de la limite du Computer, et un Agent en mode Spécifié obtient un emplacement par répertoire configuré. Les exécutions au-delà de la limite attendent dans la file d’attente.
Sharkly fusionne-t-il automatiquement les modifications de l’agent ?
Non. Le résultat, les preuves et la trace de l’exécution reviennent dans la Task, et une personne examine le récapitulatif des modifications avant toute mise en production. La personne en charge accepte, demande des modifications ou décide de l’étape de fusion et de publication. L’automatisation s’arrête là où le jugement de l’équipe est requis.
Quand dois-je utiliser le mode Spécifié plutôt que des worktrees isolés ?
Utilisez-le lorsque préparer un répertoire neuf à chaque exécution coûte vraiment cher : un dépôt très volumineux, un état généré ou des caches coûteux, ou des outils liés à un chemin local précis. Acceptez qu’un répertoire spécifié ne serve qu’une exécution à la fois. Pour tout le reste, le mode Temporaire est la valeur par défaut recommandée.


