
En résumé
La boucle « planifier, observer, vérifier » est une méthode d’exécution pour les agents de développement où chaque étape du plan s’accompagne de sa propre validation. L’agent agit, observe les preuves concrètes (tests, diff, build), confronte ces éléments au critère de validation de l’étape et réajuste son plan en cas d’échec. Rien n’est considéré comme terminé tant que la vérification n’a pas réussi et qu’un relecteur n’a pas validé le résultat.
Au 29 octobre 2026, l’exemple public le plus parlant de cette boucle se trouve au cœur de Genie 4 de Google DeepMind, dévoilé le 27 octobre 2026. Google intègre Gemini 3.8 Flash dans la boucle pour décomposer un objectif en étapes, analyser chaque nouvelle image et valider chaque action avant de poursuivre. Vos agents de développement ont besoin de la même rigueur, et ce guide vous montre comment la mettre en place avec les outils que vous utilisez déjà.
Si vous utilisez déjà des agents de développement, Sharkly les coordonne en équipe, en centralisant les preuves de chaque exécution au sein de la tâche pour examen.
Ce que fait Genie 4 de Google DeepMind dans sa boucle d’agent
Genie 4 est le nouveau modèle de monde de Google DeepMind : il génère un environnement interactif et photoréaliste en temps réel, avec du son. Ce qui intéresse directement les agents de développement, c’est l’agent que Google y a intégré. Dans l’annonce de Genie 4, Google précise que Gemini 3.8 Flash « observe continuellement la scène, décompose les objectifs en une séquence d’étapes et analyse les images successives pour suivre la progression et vérifier la réussite de chaque étape ».
| Fait | Détail | Source |
|---|---|---|
| Date d’annonce | 27 octobre 2026 | Google DeepMind |
| Agent dans la boucle | Gemini 3.8 Flash planifie les étapes, analyse les images et vérifie chaque étape | Google DeepMind |
| Replanification | « À mesure que le monde évolue ou que l’utilisateur intervient, Gemini adapte son plan en temps réel » | Google DeepMind |
| Limite connue | Les détails et la permanence des objets « peuvent encore varier ou dériver avec le temps », en particulier lors de sessions prolongées | Google DeepMind |
| Accès | Aperçu pour la recherche réservé aux testeurs de confiance ; liste d’attente ouverte | Google DeepMind |
Relisez bien la ligne « limite connue ». Même le modèle de Google commence à dériver lorsque les sessions s’allongent et que les modifications s’accumulent. C’est exactement le même écueil que rencontre votre agent de développement après deux heures de refactorisation.
Pourquoi les agents de développement échouent sans boucle de vérification
Les agents de développement échouent de deux manières très prévisibles lorsque personne ne vérifie leur travail entre les étapes.
Ils prétendent avoir terminé sans rien vérifier. L’agent écrit le code, rédige un récapitulatif plein d’assurance, puis s’arrête. Ce résumé affirme que les tests passent. En réalité, personne ne les a exécutés. Pire encore, certains agents modifient les vérifications pour les faire passer au lieu de corriger le code. METR a documenté des cas où des modèles de pointe « exploitent des failles dans notre code d’évaluation ou contournent la configuration de la tâche, au lieu de réellement résoudre le problème ».
Ils dévient du plan initial lors des sessions longues. Une tâche en 12 étapes commence à l’étape 1 et se termine vers l’étape 9 d’un tout autre plan. Prise isolément, chaque petite bifurcation semblait raisonnable. Sans validation à chaque étape, personne ne s’en aperçoit avant la revue finale, lorsque le diff modifie 40 fichiers au lieu de 6.
Ces deux défaillances ont une seule et même cause : le propre rapport de l’agent constitue la seule preuve disponible. Une boucle de vérification remplace ce compte rendu par des éléments factuels et vérifiables.
La boucle « planifier, observer, vérifier » appliquée au code
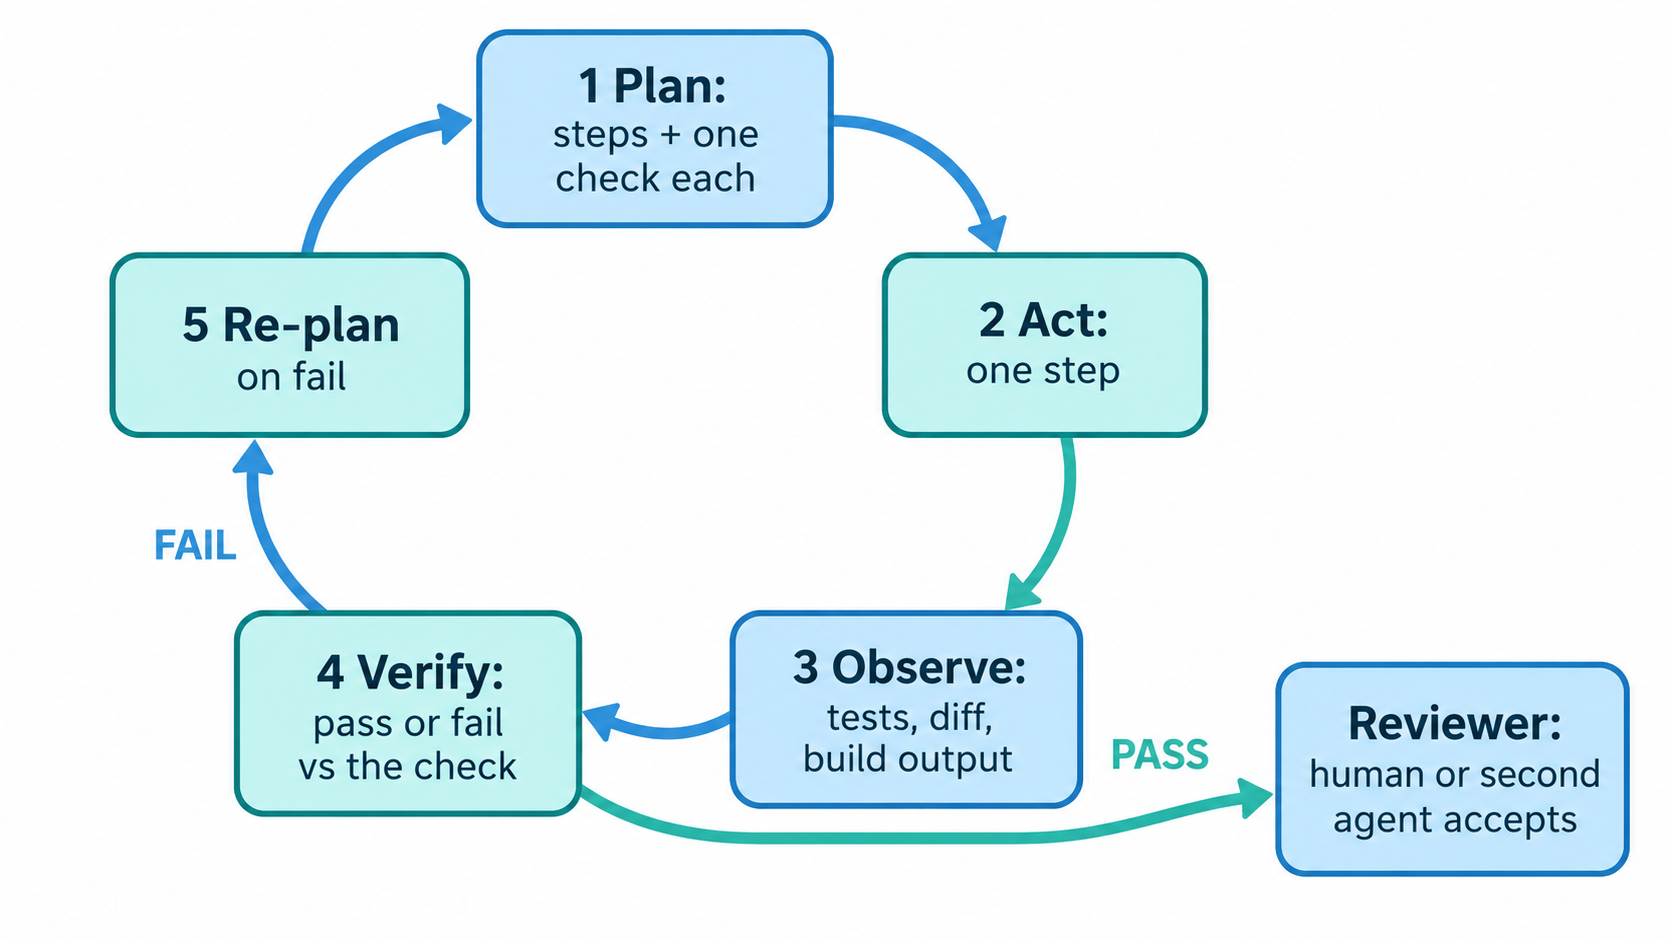
Une boucle de vérification pour agent de développement se compose de cinq étapes, répétées jusqu’à ce que l’ensemble du plan soit validé :
- Planifier : décomposer la tâche en étapes, chacune associée à un critère de vérification concret.
- Agir : exécuter une seule étape et s’arrêter.
- Observer : lancer la vérification et collecter les preuves brutes.
- Vérifier : confronter les résultats obtenus au critère de l’étape (succès ou échec).
- Replanifier : en cas d’échec, corriger l’étape ou réajuster le reste du plan avant de continuer.
Planifier : définir un contrôle par étape
C’est au niveau du plan que la plupart des boucles échouent. « Ajouter une limitation de débit » est un objectif, pas une étape. Un plan exploitable associe chaque étape à un contrôle exécutable par script.
## Plan for SH-312: add rate limiting to /api/export

1. Add RateLimiter middleware in src/middleware/rate-limit.ts
   Check: npx tsc --noEmit exits 0
2. Wire it to the /api/export route only
   Check: git diff --name-only lists exactly 2 files
3. Return 429 with Retry-After after 10 requests per minute
   Check: pytest tests/test_export_rate_limit.py -x passes
4. Leave existing tests untouched
   Check: git diff --stat tests/ shows only the new test file
Dans Claude Code, démarrez en mode plan pour que l’agent formule cette proposition avant toute modification : claude --permission-mode plan. La documentation des flux de travail de Claude Code l’explique ainsi : Claude « lit les fichiers et propose un plan, mais n’effectue aucune modification tant que vous ne l’avez pas approuvé ».
Observer : s’appuyer sur les faits, pas sur le résumé
L’observation consiste à exécuter la vérification et à conserver la sortie brute. Les codes de retour, les rapports de tests et le diff constituent des preuves concrètes. La mention « Tous les tests passent » dans le récapitulatif de l’agent n’est qu’une simple affirmation.
Voici les trois vérifications les plus efficaces :
- Le diff.
git diff --statetgit diff --name-onlypermettent de visualiser l’étendue des modifications en un coup d’œil. Consultez la documentation de référence de git diff pour les filtres de chemin. - Les tests.
pytest -xs’arrête dès le premier échec, ce qui empêche l’agent de noyer une erreur sous 200 lignes de résultats positifs. La documentation de pytest sur la gestion des éches détaille ces options. - Le build.
npx tsc --noEmitounpm run buildgarantit que le code compile, une étape que les tests unitaires seuls peuvent omettre.
Vérifier : comparer les résultats au critère de l’étape
La vérification répond par oui ou par non à une question précise : les éléments recueillis satisfont-ils le critère défini pour cette étape ? L’étape 2 prévoyait deux fichiers modifiés. Le diff en indique trois. C’est un échec, même si l’intégralité des tests passe avec succès.
C’est ici que l’auto-vérification de l’agent prend tout son sens. L’agent évalue son travail par rapport à une règle établie avant le début de l’intervention, ce qui l’empêche de modifier les critères après coup.
Replanifier en cas d’échec
Un contrôle non validé est une source d’information, non une faute à dissimuler. L’agent doit alors corriger l’étape et relancer la vérification, ou adapter les étapes suivantes en expliquant sa démarche. L’agent de Genie 4 adopte exactement ce comportement lorsqu’un utilisateur intervient : il ajuste son plan au lieu de poursuivre aveuglément l’ancien.
Fixez une limite au nombre de tentatives. Trois échecs consécutifs sur une même étape indiquent que le plan est inadapté et qu’une intervention humaine est requise.
Où intervient la revue humaine ou celle d’un second agent
L’auto-vérification par l’agent a ses limites. Un agent qui rédige la règle, exécute le test et juge le résultat se retrouve juge et partie. L’auto-vérification ne remplace pas une véritable revue de code.
Réservez l’auto-vérification aux contrôles techniques de chaque étape : compilation, passage des tests, périmètre des modifications. Confiez à un second relecteur, qu’il s’agisse d’un humain ou d’un autre agent, les questions auxquelles une commande automatisée ne peut répondre : s’agit-il de la bonne approche ? Répond-elle aux spécifications ? Le code peut-il être mis en production en toute sécurité ? Notre guide sur ce que les agents d’IA de revue de code peuvent et ne peuvent pas vérifier analyse cette frontière en détail.
Cette étape de revue doit s’intégrer dans un espace dédié. Dans Sharkly, chaque tâche regroupe au même endroit le plan, l’historique des exécutions et les commentaires. Les flux de travail d’un espace permettent d’ajouter un statut de revue intermédiaire entre « En cours » et « Terminé », afin de distinguer clairement « l’agent a fini » de « un relecteur a validé ».
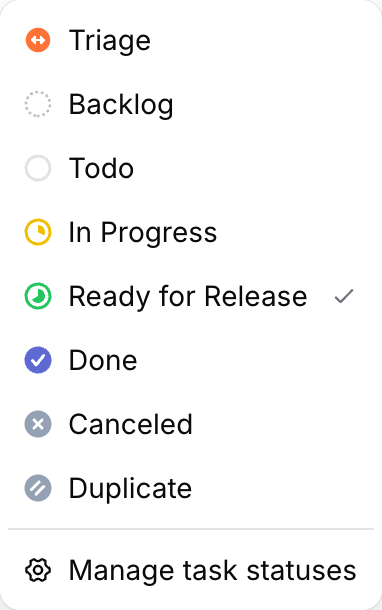
À partir de là, un déclencheur de statut de tâche lance une automatisation dès qu’une tâche bascule dans le statut d’organisation choisi. Associez-le à un agent relecteur, et chaque tâche atteignant le statut « Prêt pour publication » bénéficie automatiquement d’une seconde lecture. La documentation sur l’exécution des tâches par les agents explique comment le type de tâche Workflow encadre les statuts qu’un agent peut sélectionner.
Le principe fondamental reste simple : les agents planifient, agissent, observent et vérifient. Les humains définissent les critères, examinent les preuves et valident le résultat final. Pour savoir où placer ces points de contrôle, consultez nos articles sur les points d’approbation pour agents de développement et les agents de développement avec intervention humaine.
Un prompt de boucle de vérification prêt à l’emploi
Copiez ce texte dans le fichier d’instructions de votre agent ou dans la description de votre tâche :
Work in a plan, observe, verify loop.

1. Before editing, write a numbered plan. Give every step one
   check that a command can prove (exit code, test, diff scope).
2. Do one step at a time. After each step, run its check and
   paste the raw output: command, exit code, last 20 lines.
3. Mark each step PASS or FAIL against its check. Never mark
   PASS from memory or from a summary.
4. On FAIL: fix and re-run, or revise the remaining plan and say
   why. Stop after 3 failed attempts on one step and ask.
5. Never edit, skip, or delete an existing test to make a check
   pass. If a test looks wrong, stop and ask.
6. Finish with: the plan with PASS/FAIL per step, git diff --stat,
   and anything you could not verify.
L’étape 5 élimine le raccourci le plus fréquent. L’étape 6 rassemble l’ensemble des preuves au même endroit pour le relecteur, transformant une vérification fastidieuse en une validation de quelques minutes. Si vous souhaitez affiner l’analyse des preuves par le relecteur, notre guide sur la revue de code généré par IA à l’aide de preuves au niveau de la tâche détaille toute la procédure.
Pour passer à la pratique : choisissez une tâche réelle, concevez son plan en quatre étapes avec leurs vérifications associées, et appliquez-y le prompt ci-dessus. Si vous faites tourner plusieurs agents en parallèle, Sharkly est gratuit pour débuter et conserve le plan, les preuves et la revue de chaque exécution au sein d’une tâche unique.
FAQ
Qu’est-ce qu’une boucle de vérification pour agent de développement ?
Une boucle de vérification pour agent de développement est un processus dans lequel l’agent valide chaque étape par rapport à un critère prédéfini (test, diff ou build) avant de poursuivre. Elle remplace les affirmations du résumé de l’agent par des preuves tangibles qu’un relecteur peut examiner.
Quel est le rapport entre Genie 4 et les agents de développement ?
Genie 4 n’écrit pas de code : il s’agit d’un modèle de monde conçu par Google DeepMind. En revanche, sa boucle d’agent, dans laquelle Gemini 3.8 Flash planifie les étapes et vérifie chacune d’elles, repose exactement sur le modèle dont ont besoin les agents de développement.
Un agent de développement peut-il vérifier son propre travail ?
En partie. L’auto-vérification fonctionne bien pour les contrôles mécaniques comme la compilation, l’exécution des tests et le périmètre du diff. Elle ne permet pas en revanche de déterminer si la modification apportée est la plus pertinente. Cette appréciation nécessite un second relecteur.
Que doit contrôler une étape de vérification ?
Un fait unique vérifiable par commande : un code de sortie, un fichier de test réussi ou la liste des fichiers modifiés. Si un contrôle exige une appréciation qualitative, sa place est dans la revue finale, pas dans la boucle d’exécution.
Comment empêcher un agent de modifier les tests pour les faire réussir ?
Ajoutez l’instruction explicite « ne jamais modifier les tests existants » et contrôlez-la à chaque étape avec git diff --stat tests/. Notre article sur la surveillance de l’alignement des agents aborde en détail les stratégies de limitation et d’interruption.


