
Argon ou Carbon ? Confiez la majorité des tâches de vos agents à Gemini 4 Argon et ne réservez Gemini 4 Carbon qu'aux plus complexes. Google le dit lui-même : Argon demeure le choix par défaut pour la plupart des travaux d'ingénierie logicielle, tandis que Carbon est conçu pour les tâches plus ardues. Les deux modèles coûtent 2 $ en entrée et 10 $ en sortie par million de tokens jusqu'au 30 novembre 2026, mais Carbon consomme davantage de tokens par tâche.
En résumé
- Privilégiez l'option économique par défaut, escaladez sur preuve. Lancez chaque tâche sur le modèle rapide. Ne passez au modèle supérieur que si un critère vérifiable l'exige ou si la tâche a déjà échoué une première fois.
- Le même prix au token ne signifie pas le même coût par tâche. Carbon explore davantage, raisonne plus longtemps et multiplie les vérifications : une même tâche consomme donc plus de tokens.
- Quatre signaux révèlent une tâche complexe : un horizon long, un grand nombre de fichiers, un impact sur la sécurité ou un premier échec.
- Suivez deux indicateurs clés par tâche : le coût et le taux de réussite en revue de code. Basez votre routage là-dessus, et non sur des classements théoriques.
- Faites du modèle une configuration, pas une décision à reprendre à chaque prompt. Dans Sharkly, chaque Agent possède un modèle par défaut que vous pouvez remplacer ponctuellement lors de l'attribution d'une tâche.
Pourquoi « quel est le meilleur modèle » n'est pas la bonne question
Gemini 4 Carbon est devenu généralement disponible le 10 novembre 2026 sous l'identifiant gemini-4-carbon. L'article d'annonce de Google adopte une posture rare pour un lancement. Il vous conseille de ne pas utiliser ce tout nouveau modèle pour la majorité de vos travaux : « Argon demeure le choix idéal pour la majeure partie de l'ingénierie logicielle et du travail intellectuel. »
Carbon, selon ce même article, est « taillé pour les tâches qui repoussent les limites de l'intelligence d'un modèle » et mobilise « davantage de tokens qu'Argon afin d'explorer en profondeur, de raisonner plus intensément et d'exécuter des boucles de vérification étendues. »
Cette approche correspond exactement au mode de fonctionnement d'une équipe exploitant des agents. Vous gérez une file de tâches aux niveaux de difficulté variés, et chacune mérite le modèle le plus économique capable de passer la revue de code avec succès. Imposer un seul « meilleur modèle » à l'ensemble de l'équipe revient à surpayer pour les tâches simples ou à manquer de puissance sur les tâches ardues.
Si vous souhaitez d'abord une présentation détaillée de Carbon, notre article Gemini 4 Carbon pour les agents de code vous explique tout, et notre guide sur Gemini 4 Argon détaille le modèle par défaut.
La règle de routage : économique par défaut, escalade vers le plus robuste
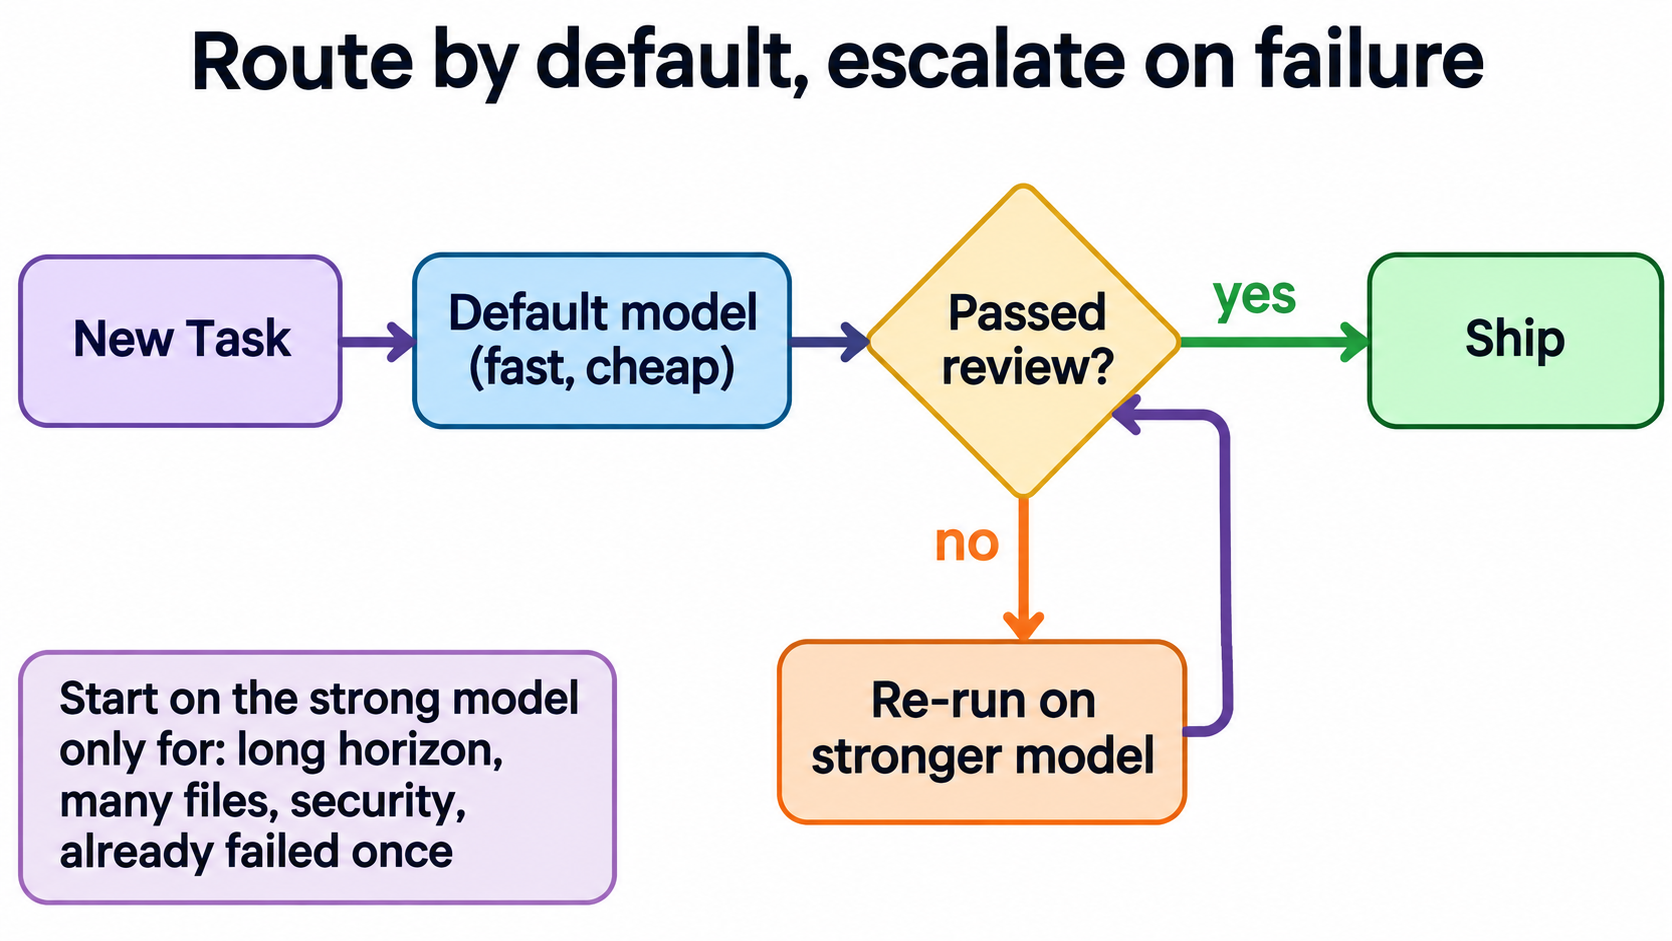
Le routage de modèles pour les agents de code consiste à choisir un modèle par tâche plutôt que par équipe. La règle tient en une phrase : chaque tâche démarre sur le modèle par défaut, et elle ne passe sur le modèle supérieur que si un signal explicite signale sa complexité ou si le modèle par défaut a déjà échoué.
Son efficacité repose sur deux principes fondamentaux :
- Un choix par défaut rapide et adapté à la majorité des tâches. Pour une équipe utilisant Gemini, il s'agit d'Argon, selon les recommandations mêmes de Google.
- Un parcours d'escalade déclenché par un critère vérifiable. « Ça a l'air difficile » n'est pas un déclencheur valable. « Touche au code d'authentification » en est un.
Comment identifier une tâche complexe ?
Il vous faut des signaux observables directement sur une tâche avant son exécution. Ces quatre indicateurs couvrent l'essentiel des cas :
Un horizon long
Une tâche exigeant une longue suite d'étapes successives, telle qu'une migration impliquant dix changements interdépendants, multiplie les risques de dérive pour un modèle plus modeste. Les boucles de vérification étendues de Carbon ciblent précisément ce scénario. Signal : la description de la tâche comporte plus de cinq étapes, ou une intervention similaire a déjà dépassé votre budget temps par le passé.
Un grand nombre de fichiers
Les modifications transversales obligent le modèle à appréhender une plus large part de la base de code en même temps. Signal : le changement s'étend sur plusieurs packages ou concerne plus de dix fichiers.
Un impact sur la sécurité
L'authentification, les paiements, la gestion des secrets et la vérification des permissions ne pardonnent aucune erreur formulée avec assurance. L'article d'annonce de Google indique que Carbon domine les benchmarks SEC-bench Pro et CWE-bench v1 lorsqu'il est utilisé via son programme Fairwind destiné aux professionnels de la cybersécurité. Signal : la tâche modifie un chemin désigné comme sensible.
Un premier échec constaté
C'est le signal le plus direct et le plus économique. Si l'exécution sur le modèle par défaut n'a pas passé la revue, vous disposez d'une preuve tangible que la tâche dépasse ses capacités. Relancez-la sur le modèle plus puissant en joignant les commentaires du relecteur.
Une grille de routage pour démarrer
Utilisez ce tableau comme point de départ, puis ajustez-le après deux semaines à la lumière de vos propres taux de réussite.
| Type de tâche | Modèle initial | Escalade vers | Pourquoi |
|---|---|---|---|
| Correction de coquille, mise à jour de texte, montée de dépendance | Modèle rapide (un Flash ou mini) | Argon | Diff restreint, facile à relire |
| Correction de bug avec un test en échec | Argon | Carbon | Le test fournit un critère de succès sans ambiguïté |
| Fonctionnalité au sein d'un seul module | Argon | Carbon | Le choix par défaut préconisé par Google pour l'ingénierie logicielle |
| Refactorisation touchant de nombreux fichiers | Carbon | Fable 5.2 ou relecture humaine | Horizon long, nombreux fichiers concernés |
| Authentification, paiements, permissions | Carbon | Revue humaine systématique | Impact critique sur la sécurité |
| Toute tâche ayant déjà échoué en revue | Niveau supérieur | Humain | Les faits l'emportent sur les suppositions |
Claude Fable 5.2 est affiché à 8 $ en entrée et 40 $ en sortie par million de tokens, soit quatre fois le tarif de lancement de Carbon : il se positionne donc au-dessus de Carbon comme ultime recours automatisé, et non comme modèle par défaut. Le tarif de Carbon passera quant à lui à 4 $ et 20 $ après le 30 novembre 2026 selon la note de bas de page de Google, ce qui réduira cet écart. Consultez les chiffres actualisés sur la page des tarifs de l'API Gemini avant de définir vos budgets.
Escaladez après échec plutôt que d'emblée
Les équipes ont souvent le réflexe de router préventivement tout ce qui « semble complexe » vers le modèle le plus puissant. Cela donne un sentiment de sécurité, mais coûte cher, car un grand nombre de ces tâches auraient abouti sans encombre sur le modèle par défaut.
L'escalade sur échec permet de ne payer que le tarif du petit modèle sur chaque tâche, et de ne supporter le coût du grand modèle que lorsqu'une tâche a prouvé en avoir besoin. Une exécution économique manquée revient souvent bien moins cher qu'une exécution coûteuse inutile.
Deux cas d'exception dérogent à cette règle, et le tableau ci-dessus les prend déjà en compte. Les travaux de sécurité démarrent directement au niveau supérieur, car un code défaillant risquerait d'être fusionné si la revue de code ne le détecte pas. Les refactorisations lourdes multi-fichiers démarrent également au niveau haut, car un échec y fait perdre une heure entière, et non une minute.
Par ailleurs, un échec n'est instructif que si la revue le repère. Les modèles savent contourner ou manipuler les tests ; associez donc l'escalade aux vérifications décrites dans notre article comment repérer les agents de code qui trichent sur les tests.
Mesurez le coût et le taux de succès par tâche
Un routage sans métriques se résume à une question d'opinion. Mesurez deux éléments pour chaque tâche :
- Le coût par tâche : les tokens d'entrée et de sortie multipliés par le prix du modèle, totalisés sur l'ensemble des exécutions nécessaires (échecs inclus).
- Le taux de validation en revue : le premier essai a-t-il été validé, ou a-t-il nécessité une réexécution ou une correction manuelle ?
Faites ensuite le calcul. Le coût par modification acceptée est l'indicateur clé qui guide vos décisions de routage. Un modèle bon marché qui échoue une fois sur deux peut coûter plus cher qu'un modèle avancé qui réussit dès la première tentative, comme nous l'expliquons dans quand un modèle moins cher coûte plus cher.
Les données indépendantes confirment ce constat. Artificial Analysis rapporte que l'exécution de son Intelligence Index a coûté 7,76 $ sur Gemini 4 Carbon (high) contre 26,54 $ sur Claude Fable 5.2 (max), Fable obtenant un score de 65 contre 60 pour Carbon. Un écart de cinq points pour un coût multiplié par 3,4 ne se justifie que sur les tâches où ces cinq points font véritablement la différence.
Un journal de suivi élémentaire suffit pour commencer :
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
Dans cet exemple, COIN-213 a échoué avec Argon, puis a été escaladée et validée avec Carbon. La tâche a coûté 1,29 $ au total, et cette ligne vous indique clairement si des tâches similaires devraient être lancées directement sur Carbon à l'avenir.
Pilotez le routage tâche par tâche sur un tableau
La règle est simple en théorie, mais difficile à faire respecter quand chaque développeur choisit son modèle dans son propre terminal. Intégrez le routage directement là où vivent les tâches.
Attribuez un modèle dédié à chaque Agent
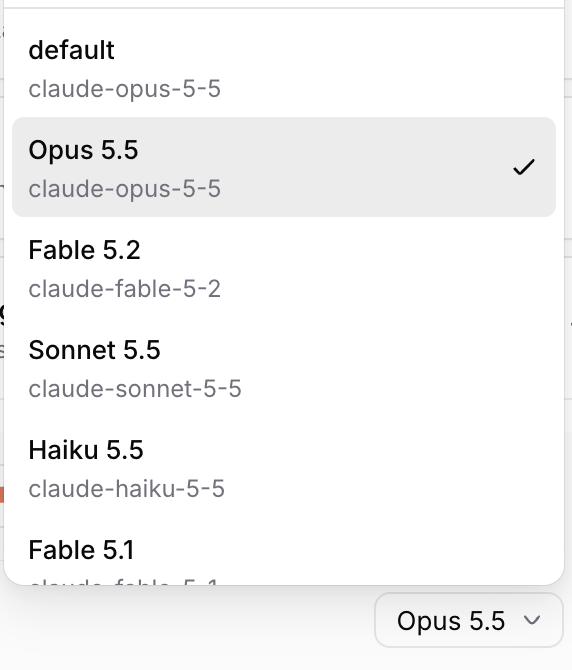
Dans Sharkly, un Agent adopte par défaut le modèle de son Runtime. L'option Modèle dans les paramètres de l'Agent vous permet de sélectionner un autre modèle dans le catalogue de ce Runtime, tout en définissant une profondeur de réflexion (thinking depth) si le modèle le propose. La documentation sur les Agents détaille cette configuration. Vous disposez ainsi d'un Agent par niveau : un Agent par défaut sur le modèle rapide et un Agent d'escalade sur le modèle avancé.
Escaladez une exécution unique
Au moment d'attribuer une tâche, vous pouvez choisir un modèle spécifique pour cette exécution, remplaçant temporairement le réglage par défaut de l'Agent. L'escalade sur échec s'effectue ainsi en une seule étape : le relecteur renvoie la tâche, et la nouvelle tentative est lancée sur Carbon sans perturber l'Agent utilisé par le reste de l'équipe.
Centralisez l'historique
Chaque run conserve son journal d'exécution, garantissant que vos statistiques de coût et de validation reposent sur des tâches réellement livrées, et non sur des impressions. Pour les Crews qui répartissent le travail par rôle plutôt que par difficulté, consultez notre article sur le routage de modèles pour les Crews d'agents. Côté gouvernance, le guide qui garde le contrôle sur vos agents détaille les garde-fous à conserver au sein de votre équipe. Sharkly propose une offre gratuite pour démarrer.
Les alternatives au routage par tâche
- Un modèle unique pour tout. Pratique pour un développeur indépendant, mais dispendieux dès que la complexité des tâches varie.
- Un modèle de routage automatisé. Un modèle léger analyse chaque prompt et sélectionne la cible. Ce mécanisme rend la décision opaque et ne tient pas compte des retours de review.
- Les architectures en équipe d'agents. La preview /swarm de Google dans Antigravity confie la planification et l'audit à Carbon pendant que des modèles plus légers travaillent en parallèle. Il s'agit d'un routage par rôle au sein d'une même tâche, parfaitement complémentaire du routage par tâche.
Conclusion
Google a lui-même formulé la règle de routage lors de son lancement : Argon par défaut, Carbon quand la tâche le justifie. Définissez vos quatre critères de complexité, traitez tout le reste à moindre coût, escaladez en cas d'échec en revue et mesurez le coût ainsi que le taux de validation par tâche. Au bout de deux semaines, vos propres données ajusteront cette répartition avec bien plus de pertinence que n'importe quel benchmark.
Étape suivante : configurez deux Agents dans Sharkly, l'un sur votre modèle par défaut et l'autre sur votre modèle d'escalade, et acheminez vos tâches de la semaine à travers eux.
FAQ
Faut-il utiliser Gemini 4 Carbon ou Argon pour les agents de code ?
Utilisez Argon pour la majorité des tâches et réservez Carbon aux plus exigeantes. L'article de disponibilité générale de Google précise qu'Argon « demeure le choix idéal pour la majeure partie de l'ingénierie logicielle », tandis que Carbon est destiné aux tâches qui repoussent les limites des modèles.
Gemini 4 Carbon est-il plus cher qu'Argon ?
Au token, non : les deux modèles coûtent 2 $ en entrée et 10 $ en sortie par million de tokens jusqu'au 30 novembre 2026. Par tâche, la réponse est généralement oui, car Google indique que Carbon consomme davantage de tokens pour explorer et vérifier ses résultats.
Qu'adviendra-t-il du tarif de Gemini 4 Carbon après le 30 novembre ?
La note de Google précise que le prix de lancement prend fin le 30 novembre 2026, date à laquelle Carbon passera à 4 $ par million de tokens en entrée et 20 $ par million de tokens en sortie.
Qu'est-ce que le routage de modèles pour les agents IA ?
Le routage de modèles consiste à attribuer chaque tâche au modèle adapté selon son niveau de difficulté, dans le but d'obtenir le coût le plus faible par modification validée.
Comment savoir quand escalader une tâche vers un modèle plus performant ?
Passez au modèle supérieur lorsque la tâche s'inscrit sur un horizon long, touche de nombreux fichiers, modifie du code sensible lié à la sécurité ou a déjà échoué en revue de code avec le modèle par défaut.
Peut-on définir un modèle différent pour chaque agent dans Sharkly ?
Oui. Chaque Agent dispose d'un paramètre Modèle permettant de piocher dans le catalogue de son Runtime, et vous pouvez également changer de modèle pour une exécution ponctuelle lors de l'assignation d'une tâche.


