
La plupart des équipes qui font tourner plusieurs agents de codage finissent par fixer un plafond mensuel de dépenses de modèles, généralement après une mauvaise semaine. On choisit un chiffre, on plafonne la concurrence jusqu'à ce que la facture reste en dessous, et on en reparle au trimestre suivant. Le 22 septembre 2026, ce chiffre a discrètement cessé de vouloir dire ce qu'il voulait dire.
OpenAI a livré GPT-6 Sol à 2 $ par million de tokens d'entrée et 10 $ par million de tokens de sortie, identifiant d'API gpt-6-sol, et a publié quelque chose de plus utile qu'un tarif au token : le coût par tâche. Sur AutomationBench 1.0.6, Sol avec un effort de raisonnement extra-élevé obtient 33,2 % pour 0,27 $ par tâche. Claude Opus 5 en effort maximal obtient 26,9 % pour un coût par tâche 11,1 fois supérieur à celui de Sol sur le même banc d'essai.
Alors calculez ce que votre plafond vous achète aujourd'hui, avant de l'augmenter. Pour la plupart des équipes, la réponse est qu'il achète déjà plus d'exécutions terminées que quiconque ne peut en lire. Ce qui signifie que le plafond n'a jamais protégé le budget. Il protégeait vos relecteurs, par accident, et cela est sur le point de cesser.
TL;DR
Le coût par modification acceptée correspond à ce que votre équipe dépense en inférence de modèle pour chaque diff qu'une personne lit et accepte réellement, et c'est le seul indicateur de coût d'agent qui se rattache au travail livré. Aux tarifs publiés, le volume mensuel total qu'une équipe de quatre relecteurs peut relire coûte environ 136 $ de GPT-6 Sol. La contrainte limitante est passée de la facture à l'étape d'acceptation, et aucune sortie de modèle n'y change rien. Les agents font la recherche, exécutent, testent et rendent compte. Les humains donnent la direction, accordent l'autorité et acceptent le résultat.
Les chiffres qu'OpenAI a réellement publiés
OpenAI publie le score à côté du coût par tâche, une honnêteté inhabituelle et bien plus utile qu'une grille tarifaire.
| Modèle, au niveau d'effort utilisé par OpenAI | AutomationBench 1.0.6 | Coût par tâche |
|---|---|---|
| GPT-6 Sol, extra-élevé | 33,2 % | 0,27 $ |
| GPT-6 Astra, faible | 30,3 % | 3,9 × Sol |
| Claude Opus 5, max | 26,9 % | 11,1 × Sol |
| Fable 5.1 avec repli sur Opus 5, max | 31,4 % | plus de 8,9 × Sol |
Le résumé qu'OpenAI fait lui-même des première et troisième lignes : Sol en extra-élevé bat Opus 5 en max pour environ 9 % du coût par tâche d'Opus 5. Le même schéma apparaît ailleurs dans son article. Sur Agents' Last Exam V1, Sol en max obtient 56,4 %, au-dessus du meilleur score d'Opus 5, pour un coût par tâche inférieur de 60 %. Sur DeepSWE 1.1, Sol en max obtient 68,8 %, à 1,1 point de pourcentage de Fable 5 en extra-élevé (69,9 %), pour environ 80 % moins cher par tâche.
Deux réserves accompagnent ces chiffres et les suivent rarement. Le titre d'OpenAI est que Sol et Luna sont chacun 50 % moins chers que le tarif promotionnel de GPT-5.6, et « promotionnel » est le mot d'OpenAI : la comparaison se fait par rapport à un tarif réduit. Et OpenAI a pris Claude Opus 5 comme référence, parce que Claude Opus 5.5 est sorti quelques heures plus tard à 4 $ et 20 $ par million, contre 5 $ et 25 $ pour Opus 5. La colonne Opus 5 est la dernière comparaison publiée, pas la comparaison actuelle.
Convertir un budget en exécutions
Multipliez 0,27 $ par 11,1 et Opus 5 en max atterrit près de 3,00 $ par tâche sur ce banc d'essai. Ce calcul est le nôtre, à partir des deux chiffres d'OpenAI. Divisez un plafond mensuel par chacun et vous obtenez le tableau qui change la lecture du plafond.
| Budget mensuel de modèles | Tâches sur Sol, extra-élevé | Tâches sur Astra, faible | Tâches sur Opus 5, max |
|---|---|---|---|
| 250 $ | environ 925 | environ 240 | environ 83 |
| 1 000 $ | environ 3 700 | environ 950 | environ 330 |
| 5 000 $ | environ 18 500 | environ 4 750 | environ 1 660 |
Le coût par tâche d'un benchmark n'est pas votre coût par tâche. Les tâches d'AutomationBench ont la forme de tâches de benchmark : bornées, courtes, et rien à voir avec un vrai ticket dans un dépôt avec des années d'historique. Vos propres tâches peuvent consommer dix ou cent fois plus de tokens. Ce qui se transpose du benchmark à votre dépôt, c'est le rapport entre les modèles, pas le montant absolu. Considérez le tableau comme la forme du changement, puis mesurez votre propre coût par exécution selon les agents et réajustez l'échelle.
Il existe une seconde correction, et elle joue en sens inverse. Le coût par tâche est par tentative, pas par réussite. Avec les 33,2 % du benchmark lui-même, environ deux tentatives sur trois n'aboutissent pas, donc Sol coûte environ 0,81 $ par réussite au benchmark et Opus 5 en max environ 11,15 $. Encore notre calcul, et approximatif, car un taux de réussite de benchmark n'est pas le taux d'acceptation de votre équipe. C'est la direction qui compte : le coût d'essayer deux fois est désormais assez faible pour que la stratégie de nouvelle tentative relève d'un choix de conception plutôt que d'une décision budgétaire.
Où se situe le plafond aujourd'hui
Appliquons le même raisonnement au versant relecture. Un relecteur qui lit correctement un diff, comprend ce que l'agent a choisi et assume la responsabilité du résultat traite un certain nombre de modifications dans une journée de travail. Disons six, à ajuster selon votre équipe.
| Relecteurs | Modifications acceptées par mois | Coût Sol à 0,27 $ | Coût Opus 5 max à 3,00 $ |
|---|---|---|---|
| 1 | environ 126 | 34 $ | 378 $ |
| 2 | environ 252 | 68 $ | 756 $ |
| 4 | environ 504 | 136 $ | 1 512 $ |
| 8 | environ 1 008 | 272 $ | 3 024 $ |
Six modifications acceptées par relecteur et par jour sur 21 jours ouvrés : notre hypothèse et notre calcul. Mettez vos propres chiffres et la conclusion tient : tout ce qu'une équipe d'ingénierie normale peut réellement accepter en un mois coûte quelques centaines de dollars d'inférence, même en haut de la fourchette de prix. Un plafond de 1 000 $ pour une équipe de quatre n'est pas une contrainte. C'est environ sept fois plus de production d'agents que l'équipe ne peut en absorber.
C'est tout l'intérêt de la baisse des prix pour une équipe qui relit son travail. Elle n'a pas augmenté votre production. Elle a supprimé la dernière excuse pour une file d'attente courte, et a rendu visible un goulot d'étranglement qui a toujours été l'étape de relecture humaine.
Les dépenses internes d'OpenAI constituent le contre-exemple utile, pas une contradiction. Son chercheur médian consomme plus de 600 $ par jour d'inférence d'agents de codage aux tarifs de l'API, et le 90e percentile en consomme 7 000 $ par jour. Ce sont de vrais chiffres, et ils écrasent le tableau ci-dessus, parce que ce travail a une forme différente : un éventail énorme, une notation automatisée, et aucune étape où une personne nommée accepte chaque résultat dans une branche de production. Si votre processus comporte cette étape, votre facture de modèles restera modeste et votre file d'attente ne le sera pas.
Que faire de la marge dégagée
Une fois que le budget n'est plus contraignant, la question n'est plus combien d'exécutions acheter, mais à quoi consacrer la différence. Deux réponses réduisent le travail qui arrive chez le relecteur au lieu de l'augmenter.
Achetez de l'effort, pas du volume. L'effort de raisonnement est un levier de coût, et le tableau d'OpenAI lui-même utilise différents niveaux selon les benchmarks. Le chiffre de 0,27 $ correspond à la ligne « extra-élevé », donc le surcoût pour une exécution plus soignée est déjà inclus dans un montant qui représente 9 % de l'alternative. Le payer sur le même nombre de tâches ne coûte presque rien et produit des diffs plus rapides à vérifier.
Achetez du cache, pas des tokens. GPT-6 applique une remise de 90 % sur les lectures d'entrée mises en cache, maintient par défaut des taux de succès plus élevés et n'invalide plus le cache lorsque vous changez l'effort de raisonnement ou la disponibilité des outils. Les points de rupture explicites vous permettent de décider où se termine un préfixe mis en cache. OpenAI cite GitHub, qui observe plus de 50 % de tokens de prompt en moins à traiter de zéro sur des milliards de requêtes. Pour une Crew, c'est la différence entre le premier agent sur un dépôt et le dixième : ils renvoient presque le même préfixe d'arborescence, de règles maison et de conventions, et ce préfixe est exactement ce à quoi sert un cache. C'est dans le coût en tokens du contexte de dépôt que réside réellement la facture d'une flotte d'agents.
La paire de décisions honnête : augmentez le nombre d'exécutions simultanées lorsque les exécutions supplémentaires convergent vers un seul résultat qu'une personne accepte, par exemple trois tentatives sur une même migration où une suite de tests désigne la gagnante. Ne l'augmentez pas lorsque chaque exécution produit son propre diff, son propre résumé et sa propre décision d'acceptation, aussi bon marché les exécutions soient-elles devenues. Dans le second cas, la facture est la seule chose qui a bien passé à l'échelle.
Rendre le nouveau plafond mesurable
Le budget était un mauvais indicateur de capacité, mais il avait une vertu : c'était un chiffre que quelqu'un surveillait. Remplacez-le par le chiffre qui contraint désormais, à savoir les exécutions terminées en attente d'une personne.
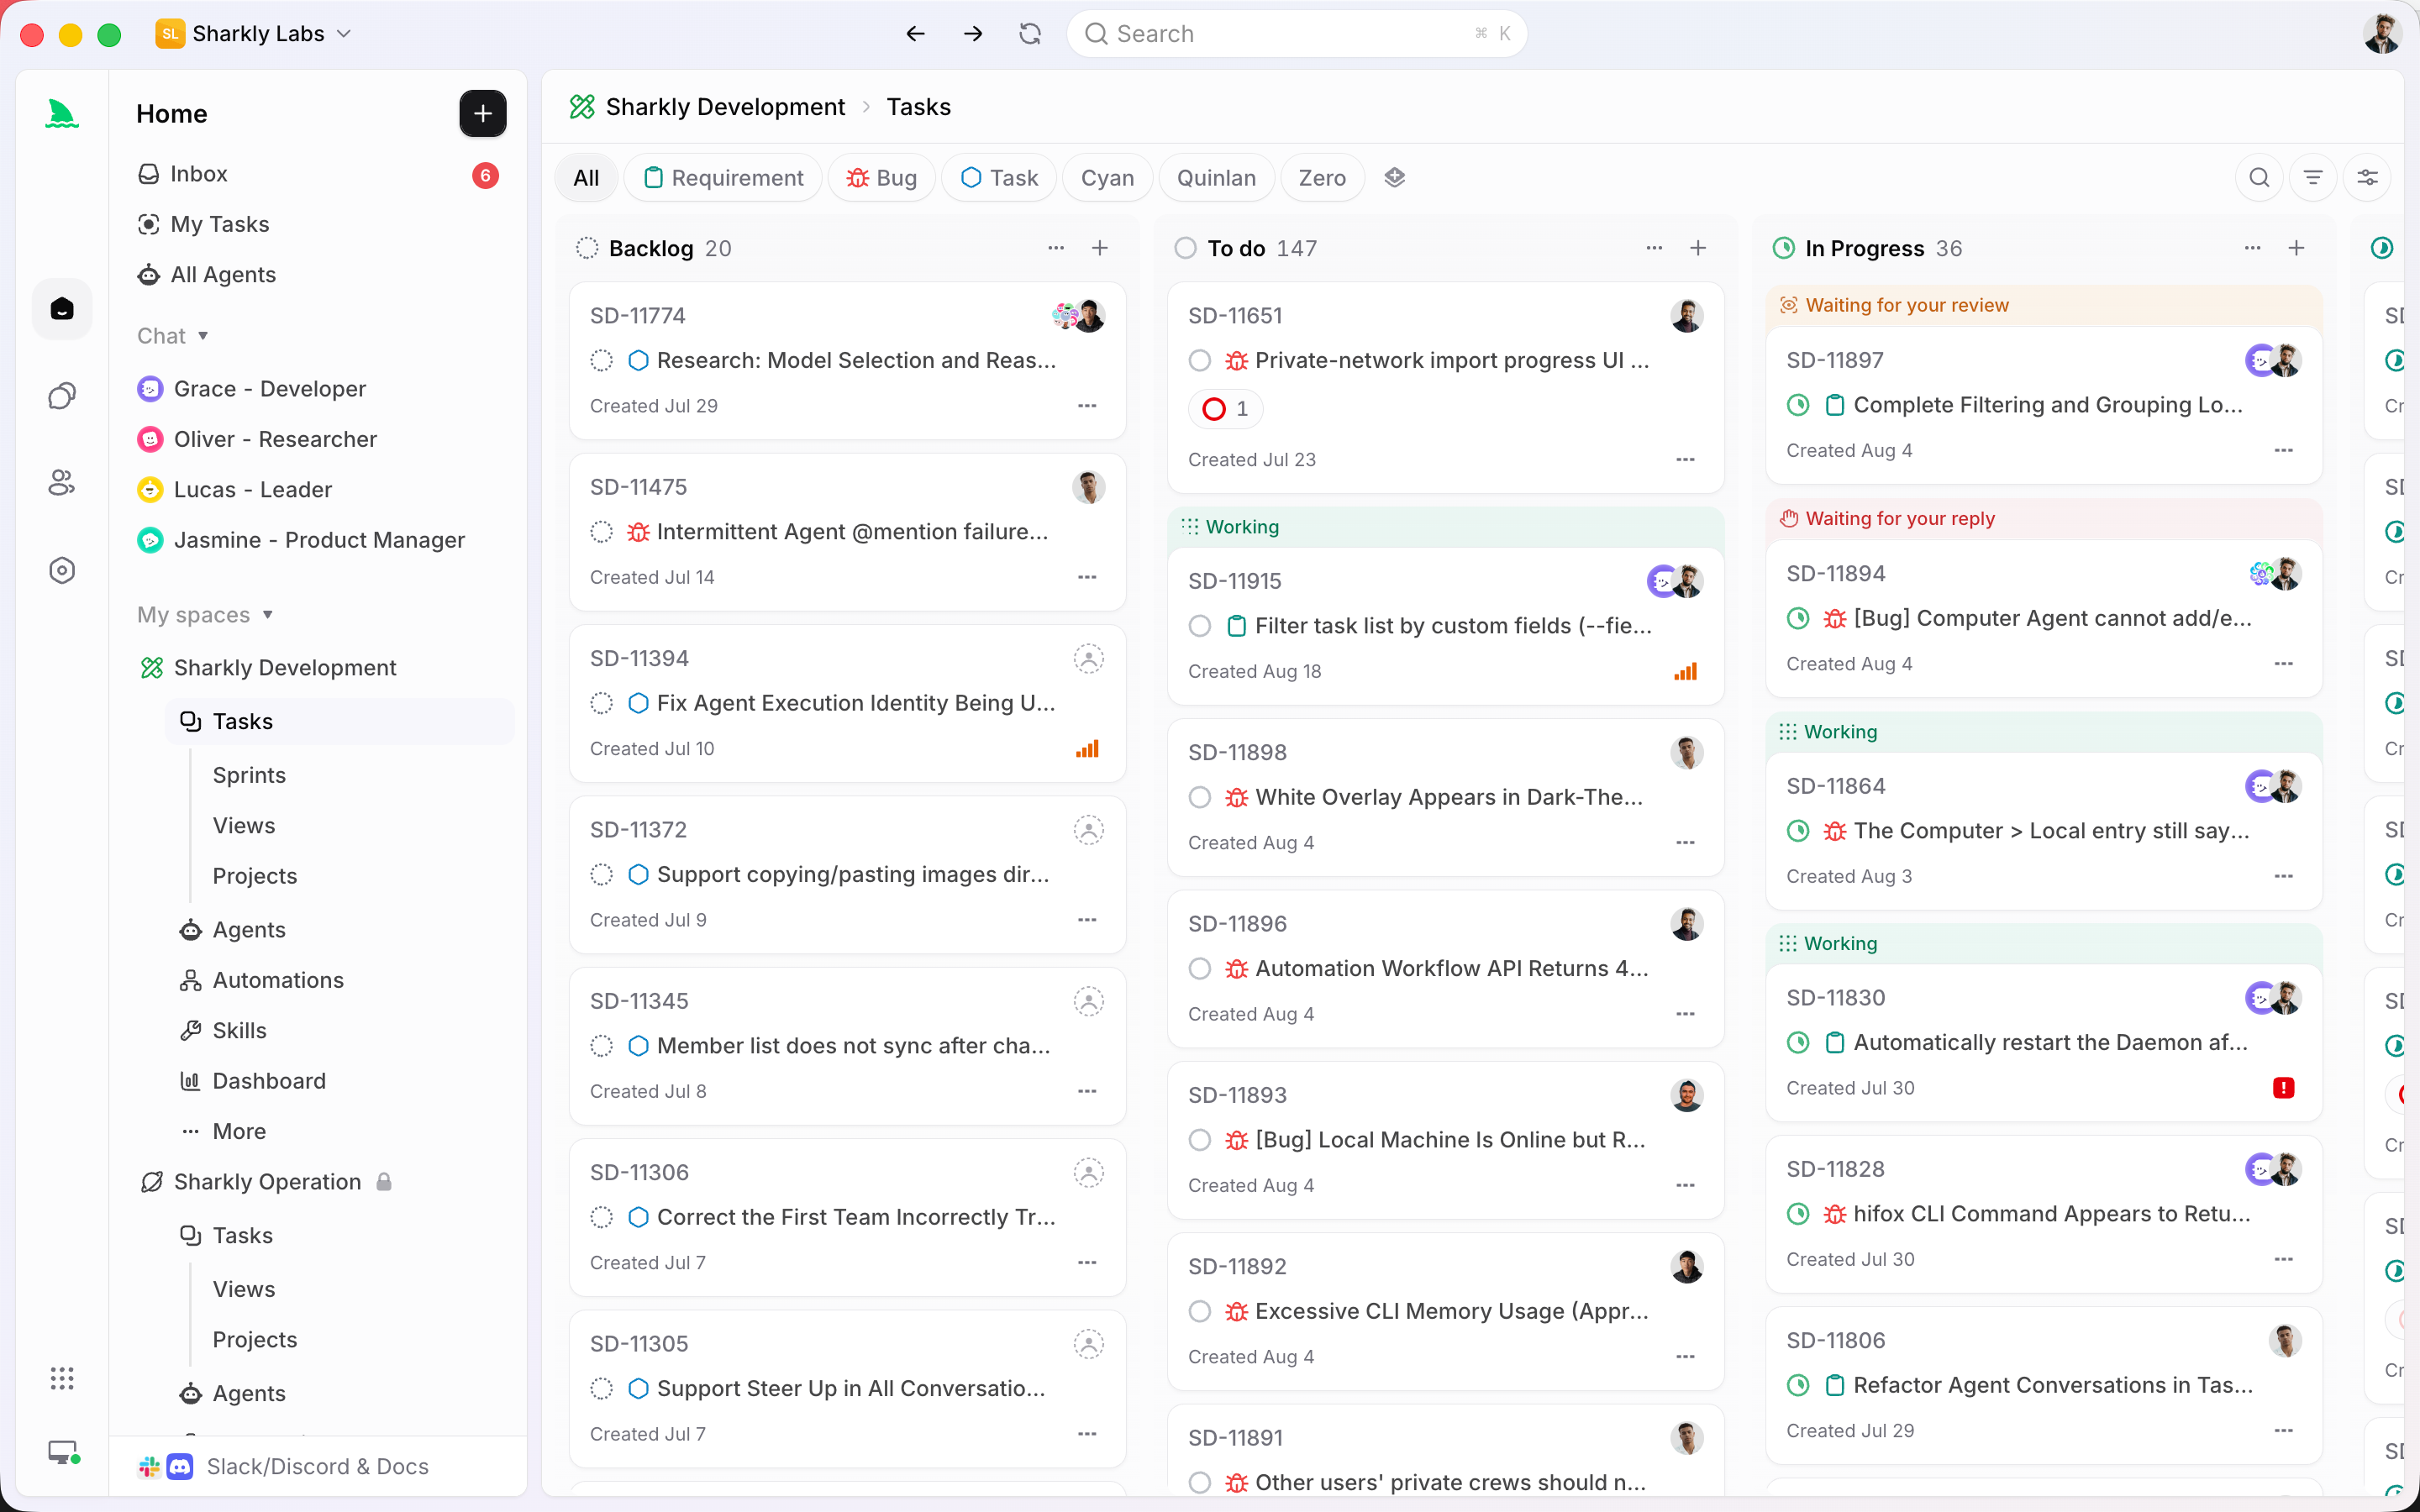
Cela n'est mesurable que si les exécutions cessent de vivre dans des terminaux privés. Sharkly ne remplace pas Codex, Claude Code ou les autres outils qui font tourner ces modèles. C'est la couche qui les entoure, où le contexte, la progression, les blocages, les résultats et la relecture humaine restent visibles de la demande à la livraison. L'exécution et les blocages remontent dans la Task, de sorte que « en attente d'un humain » devient un état que l'on peut compter sur un tableau plutôt qu'une sensation du vendredi après-midi. Le calcul de la capacité de relecture ne fonctionne que si vous pouvez voir la file d'attente.
Si vous faites déjà tourner plusieurs agents de codage, le bon geste cette semaine n'est pas d'augmenter le plafond. C'est de déterminer combien d'exécutions terminées votre équipe accepte au cours d'une semaine normale, de régler la concurrence en conséquence, et de consacrer le budget restant à des exécutions plus faciles à accepter.


