
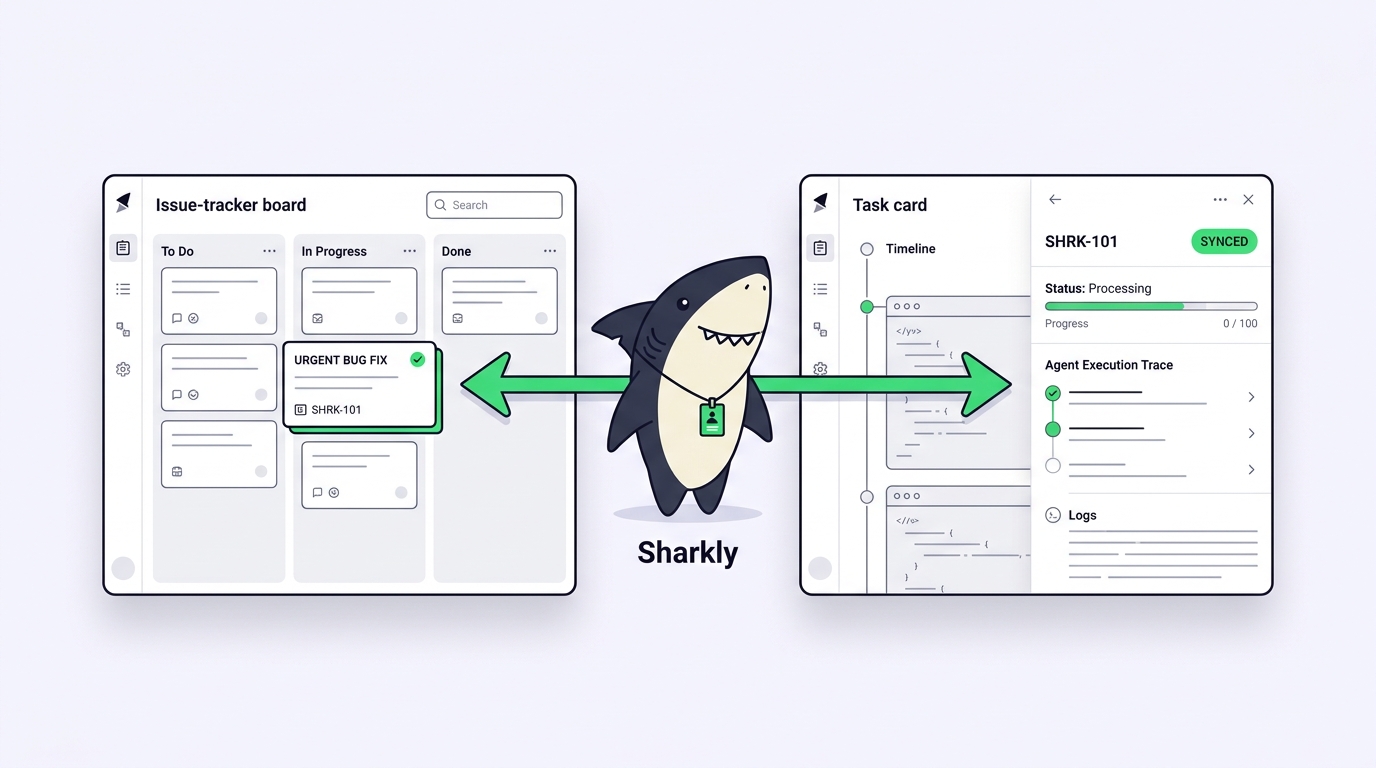
Votre backlog vit dans Jira. Personne n'a l'intention de le déplacer. Les epics y sont, les rapports de sprint remontent à la direction, et trois autres équipes dépendent de ces identifiants d'éléments de travail. Alors quand quelqu'un demande si un agent de codage IA devrait prendre en charge JIRA-4821, la question n'est pas « faut-il remplacer Jira ». Elle est plus étroite et plus concrète : où l'agent s'exécute-t-il réellement, qui relit ce qu'il a produit, et est-ce que tout cela revient dans le ticket ?
Voilà la vraie comparaison. Jira dispose désormais d'agents, et ils fonctionnent. Sharkly exécute aussi des agents, sur les ordinateurs que vous connectez, et resynchronise le résultat dans Jira. Ce guide trace honnêtement la frontière entre les deux, y compris les cas où ajouter Sharkly serait superflu.
TL;DR
Jira est un système de référence auquel on a greffé l'exécution d'agents. Sharkly est une couche d'exécution qui se connecte à votre système de référence. Rovo Dev d'Atlassian gère la planification, le codage et la revue à l'intérieur des environnements Atlassian, et vous pouvez assigner des éléments de travail à des agents depuis la liste déroulante de l'assigné. Sharkly exécute n'importe quel Runtime que votre équipe paie déjà, sur les Computers que vous connectez, conserve la trace d'exécution sur une Task partagée et se synchronise dans les deux sens avec Jira Cloud, Server ou Data Center. Si le travail de vos agents tient dans les environnements pris en charge par Atlassian, Jira seul suffit. Si vos agents doivent tourner sur vos propres machines, avec vos propres runtimes et votre propre étape de validation, Sharkly ajoute cette couche sans déloger Jira.
Ce que Jira fait bien, dit simplement
Donnons à Jira sa meilleure version, car la version honnête est solide.
Jira est l'endroit où une entreprise s'accorde sur le travail qui existe. Cet accord a une vraie valeur : des identifiants partagés, des modèles de permissions, un historique d'audit, du reporting que la finance et la direction lisent déjà. Tout outil qui demande à une équipe de l'abandonner demande quelque chose de coûteux.
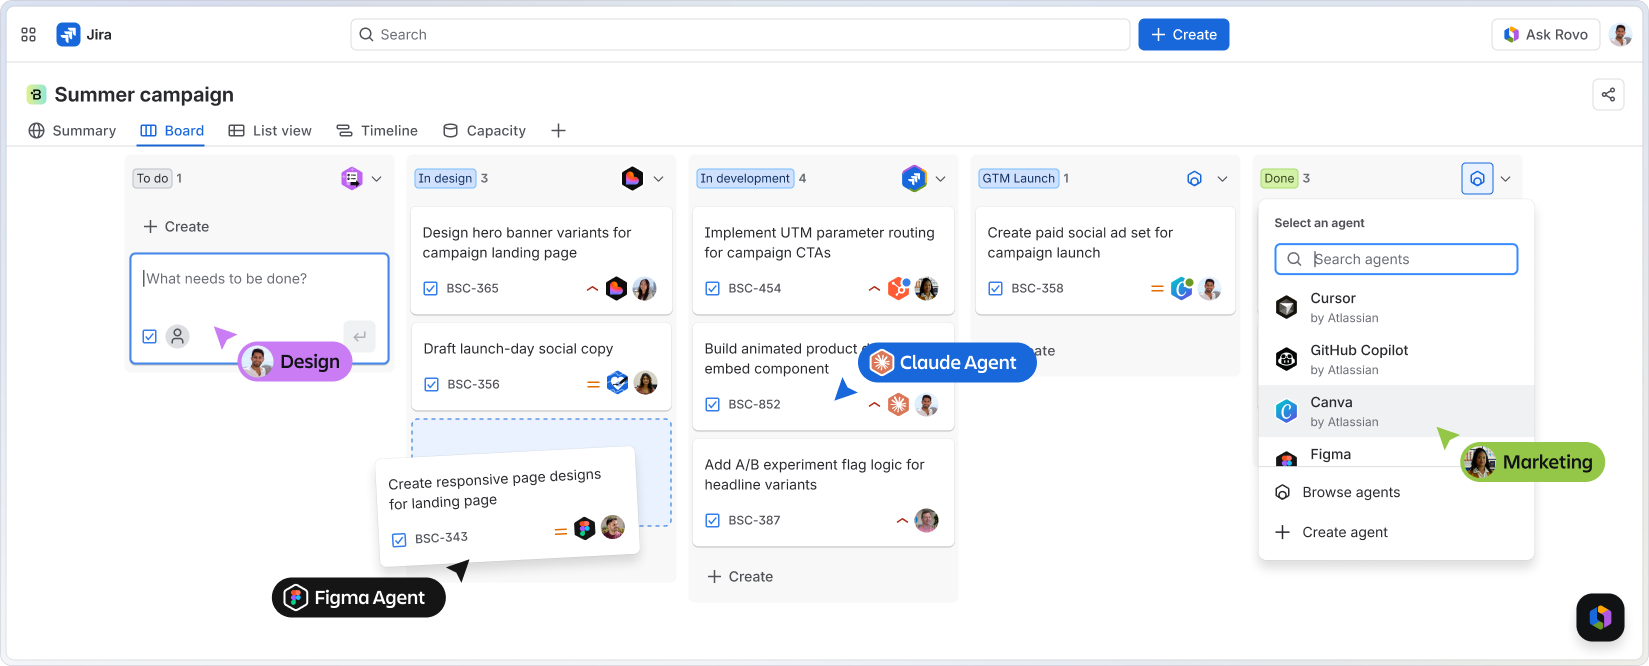
Atlassian n'est pas non plus resté inactif sur le front des agents. Rovo Dev est décrit par Atlassian comme « un agent IA sensible au contexte qui accélère le cycle de développement logiciel en prenant en charge la planification, le codage, les revues et l'automatisation du travail répétitif à grande échelle ». Il valide les modifications de code par rapport aux critères d'acceptation définis dans Jira et fonctionne dans le terminal CLI, Bitbucket Cloud, GitHub et VS Code. Atlassian indique que Rovo Dev Standard est disponible en général pour tous les clients, nouveaux comme existants, avec des crédits mensuels déployés progressivement sur les offres Cloud Standard, Premium et Enterprise.
Le modèle d'attribution est vraiment bon. Vous ouvrez la liste déroulante de l'assigné sur un élément de travail et vous choisissez un agent comme vous choisiriez un collègue, et cette liste inclut des agents tiers comme l'agent de codage GitHub Copilot. L'équipe d'ingénierie d'Atlassian a elle-même publié un retour d'expérience sur la livraison de 120 PR en deux semaines grâce à Rovo Dev dans Jira. Ce n'est pas un chiffre de démonstration. C'est une équipe qui rend compte de son débit sur du travail réel.
Le point de départ n'est donc pas « Jira est à la traîne ». Il est : « Jira a une réponse, et vous devez savoir exactement ce qu'elle couvre ».
Là où la réponse de Jira s'arrête
La limite tient à l'endroit où l'exécution se produit et aux outils qu'elle peut atteindre.
L'exécution d'agents native à Jira se déroule à l'intérieur des environnements pris en charge par Atlassian. C'est un choix de conception assumé, et pour beaucoup d'équipes, c'est le bon. Cela signifie aussi que la question du runtime est tranchée pour vous. Si vos développeurs se sont standardisés sur Claude Code avec une configuration Skills particulière, sur Codex via un abonnement ChatGPT, sur Gemini CLI, sur OpenCode, ou sur un outil maison construit sur un protocole personnalisé, le chemin natif de Jira ne les exécute pas comme vos développeurs les exécutent en local.
Il existe une seconde limite, plus importante que ne l'admettent la plupart des comparaisons : la machine. Le travail d'un agent n'est pas un simple appel à un modèle. Il lui faut un checkout, un gestionnaire de paquets, des variables d'environnement, une base de données locale, la route VPN vers votre API de staging, et les vingt petits détails qui font que votre dépôt se compile sur votre portable mais pas dans un conteneur générique. Les équipes se heurtent à ce mur la deuxième semaine, pas la première.
Et il y a la question de la revue. Quand un agent produit une modification, l'artefact utile n'est pas seulement la pull request. C'est la trace : ce qui a été demandé à l'agent, ce qu'il a lu, ce qu'il a tenté, où il s'est enlisé, et ce qu'un humain a décidé à ce sujet. Cet enregistrement a besoin d'un endroit que la personne suivante peut lire.
Quand choisir l'un, quand ajouter l'autre
La documentation de Sharkly est sans détour sur la répartition du travail, et la même franchise s'applique ici.
Utilisez Jira seul quand le travail de vos agents tient dans les environnements pris en charge par Atlassian, que vos dépôts sont dans Bitbucket ou GitHub, et que les agents que vous voulez sont ceux que Jira sait déjà assigner. Vous avez un système de référence et un chemin d'exécution dans un seul produit, facturé une fois. Ajouter une couche de plus vous achète de la complexité dont vous n'avez pas besoin. C'est une vraie recommandation, pas une précaution de langage.
Ajoutez Sharkly quand l'exécution doit se faire sur du matériel et des runtimes que vous contrôlez. Un Computer dans Sharkly fournit l'hôte d'exécution du travail des Agents, et il peut s'agir d'un ordinateur local, d'un serveur distant, d'un conteneur ou d'un hébergeur cloud pris en charge. Un petit service local relie ce Computer à Sharkly, détecte les Runtimes disponibles, reçoit le travail, prépare le répertoire de la tâche, démarre le Runtime sélectionné et renvoie la progression en continu. C'est précisément ce que Jira ne cherche pas à être.
Une définition, car tout le reste en dépend. Une Task est l'unité de travail principale dans Sharkly. Elle contient l'objectif et la description, la personne responsable, l'Agent ou le Crew chargé de l'exécuter, les commentaires, l'état d'exécution, la trace et le résultat. Là où un ticket Jira consigne l'existence du travail, une Task Sharkly consigne comment le travail a été fait, par quel agent et sur quelle machine.
Pas besoin de choisir : le chemin de synchronisation
C'est le point sur lequel la plupart des comparaisons « Sharkly vs Jira » se trompent. Les deux ne s'excluent pas, et l'intégration est documentée, pas seulement promise.
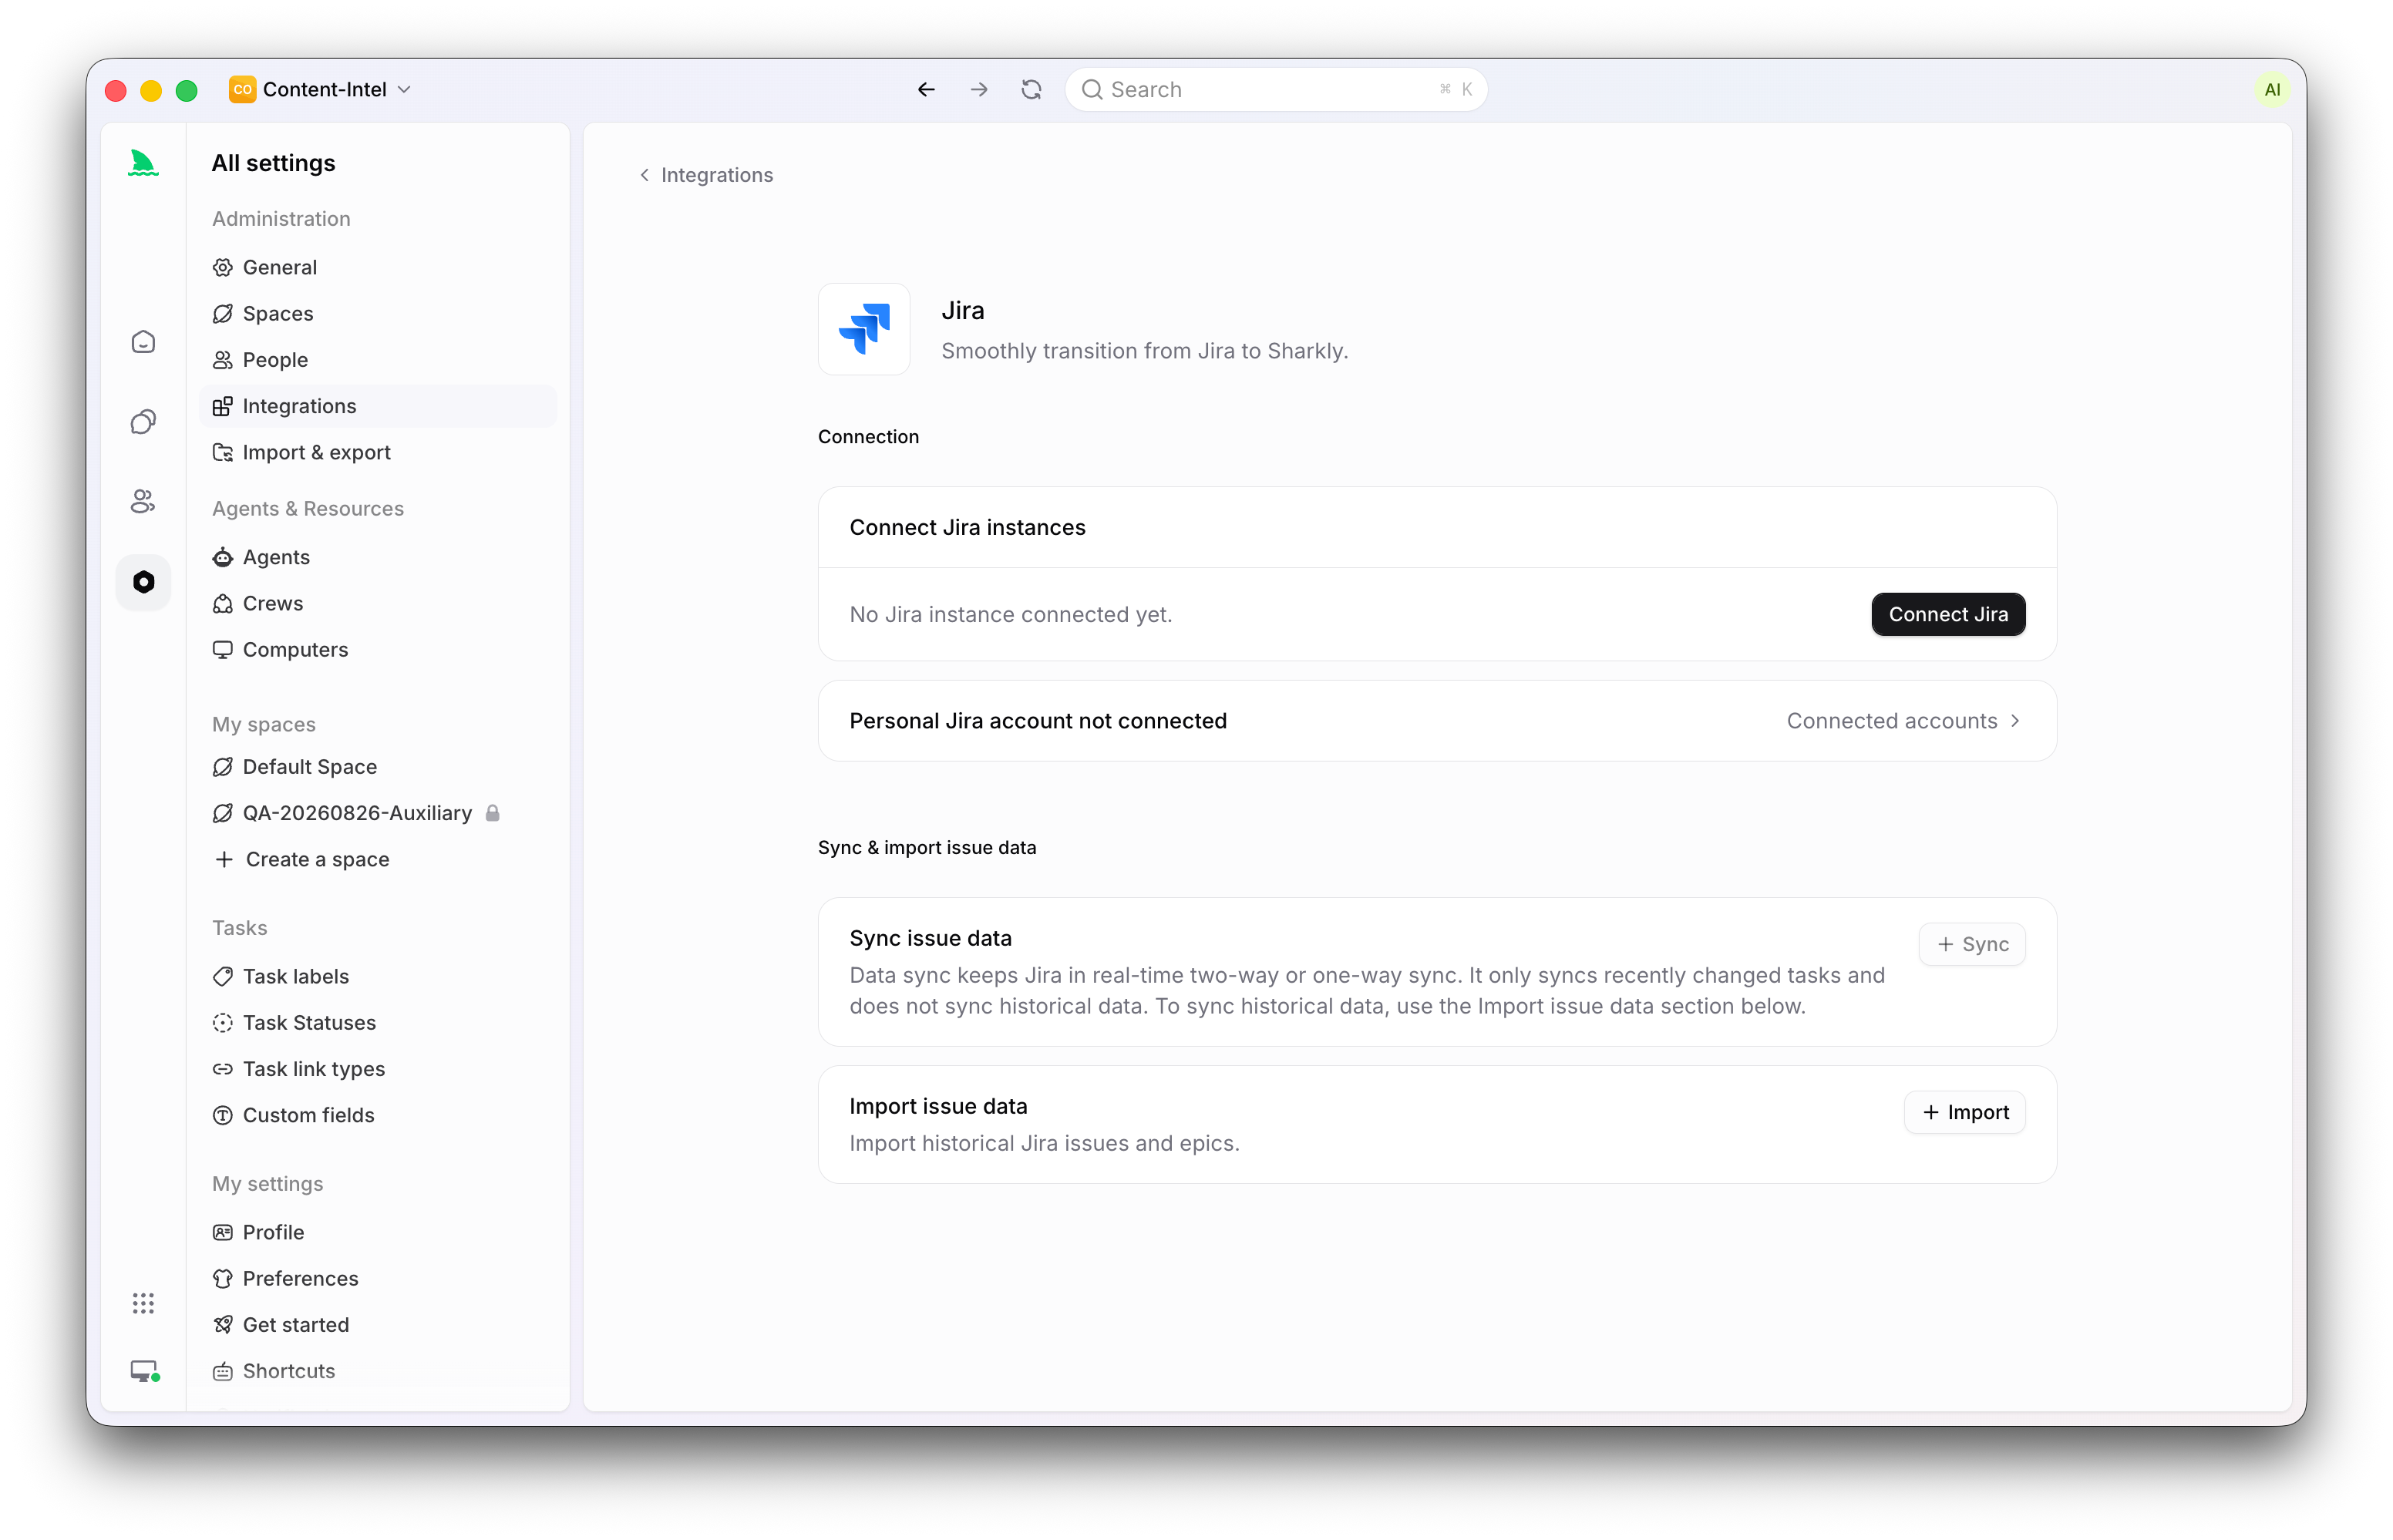
L'intégration Jira de Sharkly prend en charge Jira Cloud ainsi que Jira Server ou Data Center, et propose trois modes :
- Import copie les données Jira existantes dans Sharkly. À utiliser pour l'historique ou une migration maîtrisée.
- Sync relie un projet Jira à un Space Sharkly et maintient les changements récents connectés. La synchronisation n'importe pas l'historique à elle seule.
- Import puis sync transfère l'historique sélectionné et peut activer une synchronisation continue avec les identifiants déjà saisis dans l'assistant.
Un lien de synchronisation associe un projet Jira à un Space Sharkly. Un projet Jira ne peut avoir qu'un seul lien actif, mais plusieurs projets Jira peuvent être liés au même Space. En mode bidirectionnel, les tickets et epics Jira se synchronisent avec les Tasks et Projects Sharkly dans les deux sens, et les nouvelles Tasks et Projects du Space lié peuvent créer des tickets et des epics Jira. Si vous préférez que Jira reste la référence, le mode « Jira vers Sharkly » crée et met à jour les enregistrements Sharkly liés sans renvoyer de nouveaux enregistrements.
Deux points opérationnels à connaître avant de commencer. L'installation automatique du webhook nécessite les droits d'administration Jira, et l'absence de cette permission ne bloque pas la connexion mais empêchera les modifications Jira d'arriver. Supprimer un lien arrête la synchronisation future sans rien supprimer d'un côté comme de l'autre, ce qui rend l'opération réversible si vous décidez de renoncer.
Pour le flux au niveau du ticket, notre guide sur l'attribution d'un ticket Jira à un agent IA couvre la boucle de bout en bout.
Un exemple concret
Une équipe paiements utilise Jira comme standard de l'entreprise. Le support ouvre JIRA-4821 : une tempête de retries de webhooks débite deux fois un petit nombre de clients.
Le lead technique le qualifie dans Jira, définit la priorité et le rattache à l'epic d'incident. Comme le Space lié se synchronise dans les deux sens, le même travail apparaît dans Sharkly sous forme de Task, avec la description et les critères d'acceptation intacts.
C'est là que le routage devient précis. La Task part vers un Agent configuré pour les correctifs backend : un rôle défini, le dépôt paiements et Claude Code comme Runtime, le tout exécuté sur un Computer connecté qui dispose déjà des identifiants de staging et de la route VPN. Un second Agent prend en charge la couverture de tests dans un worktree isolé, afin que les deux ne touchent jamais aux mêmes fichiers. Notre guide sur l'exécution d'agents en parallèle dans des worktrees isolés explique pourquoi cet isolement compte dès que plusieurs agents travaillent.
L'agent lit le ticket, reproduit la tempête de retries sur une relecture locale, propose un changement de clé d'idempotence, lance la suite de tests et rend son rapport. Tout ce qu'il a lu, tenté et raté figure sur la Task, dans la trace, à côté des commentaires. Le lead relit le diff, pose une question de suivi dans un commentaire de la Task — ce qui déclenche une nouvelle exécution — puis valide.
Le résultat revient dans JIRA-4821 pour celles et ceux qui n'ont jamais quitté Jira : le ticket se ferme, le rapport de sprint est exact et le support voit la résolution dans l'outil qu'il utilise déjà. Personne n'a eu à changer d'outil.
Sharkly vs Jira : une comparaison honnête
| Jira (avec Rovo Dev et les agents assignables) | Sharkly | |
|---|---|---|
| Rôle principal | Système de référence pour le travail à l'échelle de l'entreprise | Couche d'exécution et de revue pour les personnes et les agents |
| Attribution des agents | Liste déroulante de l'assigné, agents Rovo et agents tiers pris en charge | Task assignée à un Agent ou à un Crew |
| Où s'exécutent les agents | Environnements pris en charge par Atlassian : CLI, Bitbucket Cloud, GitHub, VS Code | Computers que vous connectez : machine locale, serveur distant, conteneur ou hébergeur cloud pris en charge |
| Choix du runtime | Les agents pris en charge par Jira | Le Runtime détecté sur ce Computer, y compris un Runtime ACP personnalisé que vous configurez |
| Facturation des modèles | Via votre offre Atlassian et ses crédits | Via les abonnements ou clés API déjà configurés dans vos outils |
| Traçabilité de l'exécution | Historique de l'élément de travail et PR liées | Task avec état d'exécution, trace, résultat et commentaires |
| Hôtes multiplateformes | Gérés par Atlassian | Programmes d'installation macOS, Linux et Windows pour la CLI et le service local |
| Relation | L'enregistrement sur lequel tout le monde fait son reporting | Se synchronise dans les deux sens avec Jira plutôt que de le remplacer |
Erreurs fréquentes
Y voir une migration. L'erreur la plus fréquente consiste à présenter l'exécution d'agents comme une raison de quitter Jira. La finance, le support et trois autres équipes lisent ces rapports. Synchronisez, ne délogez pas.
Négliger la question du webhook. Le lien Jira a besoin des droits d'administrateur pour installer son webhook automatiquement. Si vous ne les avez pas, transmettez tôt le pack de configuration à un administrateur Jira plutôt que de déboguer un silence plus tard.
Relier plusieurs projets Jira à un même Space par inadvertance. Un projet Jira ne peut avoir qu'un seul lien de Space actif, et l'association ne peut plus être modifiée après sa création. Décidez du mapping avant de créer les liens, car corriger une erreur implique de supprimer puis de recréer.
Assigner du travail qui n'est pas prêt pour un agent. Un ticket qui dit « corriger le bug de paiement » produit une mauvaise exécution, quelle que soit la plateforme. Ce sont les critères d'acceptation qui font la différence — la même discipline que de bons tickets ont toujours exigée. Notre aperçu de la gestion de projet avec des agents IA couvre ce qui change quand l'assigné n'est pas une personne.
Conclusion
Jira répond à la question « quel travail existe et à qui appartient-il ». Avec Rovo Dev et les agents assignables, il répond désormais aussi en partie à « qui fait le travail », dans les environnements pris en charge par Atlassian. Si cela couvre votre stack, vous avez terminé, et vous pouvez arrêter de lire des articles comparatifs.
Sharkly répond à une autre question : où l'exécution des agents se produit-elle lorsqu'elle a besoin de vos machines, de vos runtimes et de votre étape de validation, et comment cet enregistrement reste-t-il lisible pour l'équipe. Ce n'est pas un remplacement de Claude Code ou de Codex, et ce n'est pas non plus un remplacement de Jira. Sharkly ajoute la tâche partagée, le Computer connecté, le contexte, le contrôle et la couche de revue autour des outils que votre équipe utilise déjà, puis synchronise le résultat vers le ticket que tout le monde lit.
Si c'est ce manque que vous ressentez, commencez par Sharkly et reliez un projet Jira à un Space avant de toucher à quoi que ce soit d'autre.
FAQ
Sharkly remplace-t-il Jira ? Non. Il se connecte à Jira par import, synchronisation à sens unique ou synchronisation bidirectionnelle. Supprimer un lien arrête la synchronisation future sans supprimer les tickets Jira, les epics Jira, les Tasks Sharkly ni les Projects Sharkly.
Puis-je conserver Jira comme source de vérité ? Oui. Le sens Jira vers Sharkly crée ou met à jour les enregistrements Sharkly liés sans créer de nouveaux enregistrements Jira depuis Sharkly. Les mises à jour prises en charge des enregistrements déjà liés peuvent néanmoins être réécrites vers Jira.
Est-ce compatible avec un Jira auto-hébergé ? Jira Cloud et Jira Server ou Data Center sont tous deux pris en charge. Les installations Server et Data Center exposent en outre une option de proxy réseau privé que Jira Cloud n'affiche pas.
Qu'en est-il du coût des modèles ? L'usage des modèles continue de passer par les abonnements ou les clés API configurés dans vos outils de codage. Le quota de modèles dépend des outils de codage IA, des offres et des comptes API que votre équipe connecte.
Quels agents Jira peut-il assigner nativement ? Les agents Rovo, ainsi que des agents tiers pris en charge comme l'agent de codage GitHub Copilot, sélectionnés depuis la liste déroulante de l'assigné de l'élément de travail. Consultez la documentation actuelle d'Atlassian, car la liste des agents pris en charge évolue.
Faut-il les deux outils pour commencer ? Non. Vous pouvez d'abord utiliser Sharkly avec ses propres Spaces et connecter Jira plus tard. Les équipes déjà bien installées dans Jira trouvent généralement la synchronisation plus facile à justifier une fois qu'une squad dispose d'une boucle d'agents fonctionnelle. Notre comparatif des alternatives à Jira pour les équipes mêlant humains et agents traite du cas où Jira n'est pas encore solidement ancré.


