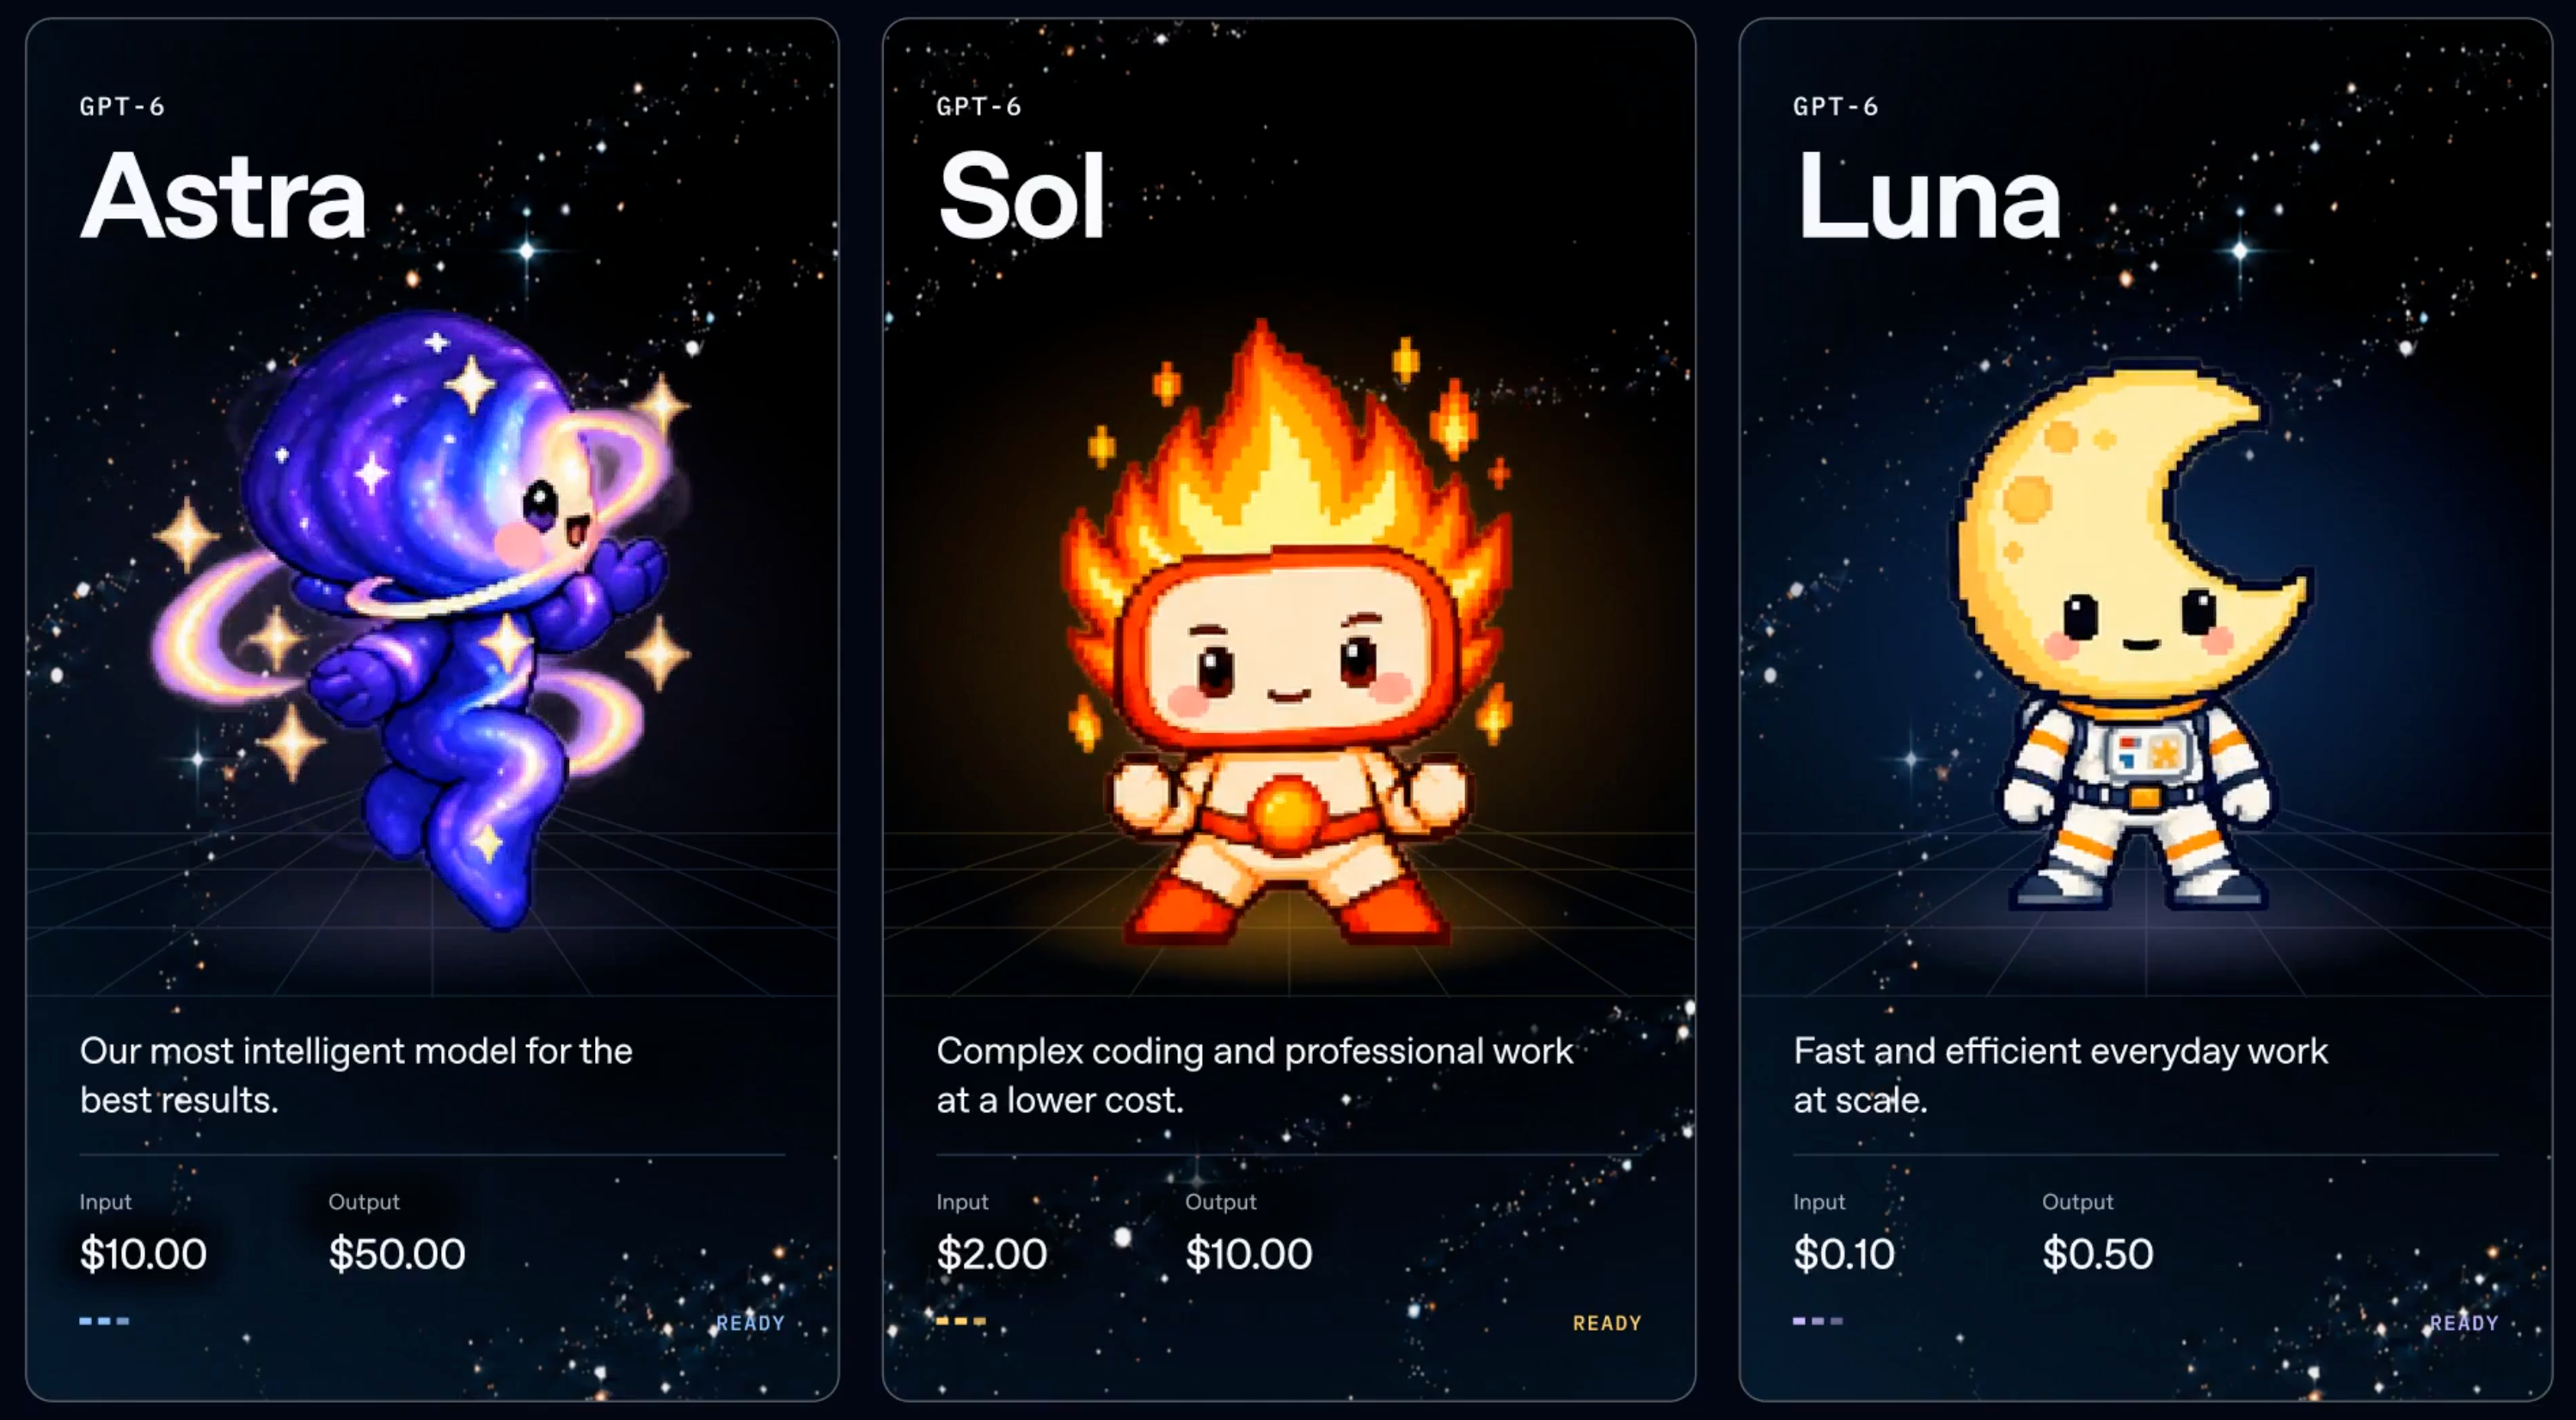
La facture est le chiffre le plus facile à faire baisser, mais aussi le moins intéressant à analyser. Confiez les tâches de routine de votre Crew à GPT-6 Luna à 0,10 $ et 0,50 $ par million de tokens, et la ligne consacrée aux modèles s’effondre en moins d’une journée. Deux semaines plus tard, la facture reste basse, le tableau de bord affiche plus d’exécutions terminées que jamais, et les quatre modifications de mardi dernier attendent toujours que quelqu’un veuille bien les valider.
Rien ne s’est mal passé. Vous avez simplement transféré des coûts d’une ligne que vous surveilliez vers une ligne que personne ne chiffre.
Le coût par modification acceptée correspond au total des dépenses financières et du temps humain consacrés à chaque tentative ayant abouti à une modification validée par une personne. Il englobe les exécutions qui ont échoué, le code produit que personne n’a fusionné et les minutes passées à statuer sur les deux. Aucun fournisseur ne le publie, aucun benchmark ne le mesure, et c’est pourtant le seul indicateur qui évolue au rythme de ce que votre équipe livre réellement.
En résumé
Un modèle plus économique réduit le coût d’une tentative, mais augmente trois éléments dont le prix se règle en attention humaine : le nombre de tentatives par modification livrée, le volume généré par tentative et le nombre de décisions par modification livrée. Or, l’attention n’est pas devenue moins chère le 22 septembre 2026. L’offre d’entrée de gamme est réellement plus avantageuse lorsqu’une machine juge de la réussite d’une tentative, mais devient insidieusement coûteuse dès qu’un humain doit intervenir. Les agents explorent, exécutent, testent et rendent compte. Les humains fixent le cap, accordent les autorisations et valident le résultat. La solution relève d’abord d’un ajustement comptable avant d’être une stratégie de routage : mesurez les tentatives et les minutes humaines par modification acceptée, pour chaque Runtime, et faites du travail en attente de validation humaine un état quantifiable plutôt qu’une vague impression le vendredi après-midi.
Trois unités de mesure, dont une seule compte pour vous
| Unité | Utilisateurs | Ce qu’elle indique | Ce qu’elle ignore |
|---|---|---|---|
| Par million de tokens | Grilles tarifaires des fournisseurs | Le coût d’un token en entrée et en sortie | Le volume de tokens nécessaire à votre tâche |
| Par tâche terminée | Tableaux de benchmarks | Le coût d’une tentative évaluée | Les échecs, votre propre base de code, la revue |
| Par modification acceptée | Votre équipe | Le coût de bout en bout d’une modification déployée | Rien, et c’est précisément pourquoi personne ne la publie |
Les deux laboratoires ont publié leurs nouveautés le 22 septembre 2026, et tous deux ont communiqué sur la colonne du milieu. Ne lisez surtout pas ces chiffres comme s’il s’agissait de la colonne de droite.
Ce que coûte l’offre économique et ce qu’elle vaut sur les benchmarks
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| Identifiant API | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Entrée / sortie par 1M | 0,10 $ / 0,50 $ | 2 $ / 10 $ | 4 $ / 20 $ |
| Tokens en cache (entrée) | -90 % sur la lecture | -90 % sur la lecture | 0,20 $ en lecture, 5 $ en écriture |
| Contexte | 1M | 872k | 1M |
| DeepSWE 1.1 (raisonnement max) | 66,6 % | 68,8 % | Absent des annonces de lancement |
| Indice Artificial Analysis | 37 | 48 | 58, 1er sur 212 |
Anthropic affiche un score de 40,0 % sur AutomationBench pour Opus 5.5. OpenAI annonce 33,2 % pour Sol avec un niveau de raisonnement très élevé sur AutomationBench 1.0.6, à un coût de 0,27 $ par tâche. Deux laboratoires, deux bancs d’essai distincts, un coût par tâche affiché. Cette comparaison n’a rien d’un véritable face-à-face, et l’impossibilité de les comparer directement résume tout le problème : aucun tableau de fournisseur ne vous donnera le coût par modification acceptée.
Premier coût caché : les tentatives par modification acceptée
OpenAI attribue à Luna en raisonnement maximal un score de 66,6 % sur DeepSWE 1.1, contre 68,8 % pour Sol au maximum. Selon nos calculs, cela représente environ une tentative sur trois pour Luna qui n’aboutit pas à un résultat concluant. Votre base de code n’est pas DeepSWE et vos taux seront différents, mais la dynamique reste la même : un modèle économique affichant quelques points de moins n’est pas simplement un peu moins bon à chaque run, il a surtout plus de risques de vous renvoyer un résultat qui exigera un tour de piste supplémentaire.
L’impact financier de ce cycle supplémentaire reste minime. OpenAI indique que Luna en raisonnement maximal est 93 % moins cher par tâche que Claude Opus 5 sur le même benchmark. Doublez le nombre de tentatives et, toujours selon nos estimations, vous restez environ 86 % moins cher. Ce n’est jamais la facture de tokens qui pose problème.
En revanche, cet échec est loin d’être gratuit pour le reste de l’équipe. Il a généré une branche, un récapitulatif des modifications et une décision qui incombe à un être humain. Une exécution ratée n’a rien de neutre : c’est un élément supplémentaire à passer en revue qui n’aboutira à aucune modification concrète.
Deuxième coût caché : l’entrée de gamme compense par un temps de réflexion accru
Regardez d’où proviennent les bons scores de Luna. Ces 66,6 % sont obtenus avec un raisonnement maximal, et la note d’OpenAI sur la fiabilité factuelle précise que Luna, poussé à un niveau d’effort supérieur, égale GPT-5.6 Sol pour environ un centième de son coût. L’entrée de gamme n’atteint un niveau de qualité acceptable qu’en fournissant davantage d’efforts, et ces efforts se traduisent directement en tokens de sortie et en temps d’attente réel.
Artificial Analysis, un tiers indépendant des deux fournisseurs, mesure pour les variantes à raisonnement maximal un débit de 153,9 tokens de sortie par seconde pour Luna avec 124,23 secondes avant le premier token, contre 115,2 tokens par seconde pour Sol avec un délai de 102,15 secondes. Ces chiffres sont à prendre à titre indicatif : ils émanent d’une source tierce, portent précisément sur les versions poussées au maximum et évoluent à mesure que le laboratoire ajuste ses mesures.
Deux répercussions directes pèsent sur votre équipe, et non sur votre facture. Une exécution qui reste silencieuse pendant deux minutes ressemble à s’y méprendre à un processus bloqué, ce qui pousse quelqu’un à aller vérifier. De plus, une trace d’exécution plus verbeuse accompagnée d’un diff plus long demande plus de lecture, à chaque tentative, avant que quiconque ne puisse valider. Or, le temps de lecture est une ressource rare, et vous venez justement d’accroître ce qui la consomme.
Troisième coût caché : des décisions plutôt que des diffs
Comptez le nombre de décisions humaines nécessaires entre l’attribution d’une tâche et la validation finale d’une modification. Avec un Runtime performant, le parcours habituel se résume à une étape : relire, puis valider. Avec un Runtime économique effectuant un travail difficilement vérifiable, le flux bifurque, et chaque embranchement requiert un être humain :
- L’exécution a échoué. Faut-il relancer sur le même Runtime ou escalader vers un modèle plus puissant ?
- L’exécution a validé ses tests, mais a retenu une approche que vous n’auriez pas choisie. Faut-il accepter ou renvoyer la copie ?
- L’exécution a généré trois résultats partiels. Lequel constitue la modification définitive ?
- L’exécution s’est interrompue pour poser une question. Qui répond, et où consigner la réponse ?
Rien de tout cela ne figure sur une facture de tokens. Mais tout cela surcharge l’agenda de la personne responsable de la revue humaine.
Le calcul appliqué à vos propres chiffres
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
Faites le calcul avec vos propres données, pas les nôtres. À 0,10 $ et 0,50 $ par million de tokens, le coût du modèle entre parenthèses est quasiment nul, de sorte que l’équation est entièrement dominée par les minutes de revue multipliées par le nombre de tentatives. Passer à un Runtime moins cher allège une ligne budgétaire déjà négligeable tout en démultipliant celle qui ne l’était pas. C’est parfois un compromis valable, mais ce n’est jamais une décision que vous pouvez évaluer à partir d’une simple grille tarifaire.
Quand l’entrée de gamme est réellement plus avantageuse
Faites appel à un Runtime économique lorsqu’une machine peut juger de la réussite de la tentative. Vérification des types, tests unitaires, build, règles de linter, validation de schéma : le verdict tombe avant même qu’un humain n’y consacre la moindre attention, et les tentatives superflues sont absorbées par le banc d’automatisation plutôt que par votre vendredi après-midi. C’est ce qui représente la majeure partie du volume au sein d’un Crew opérationnel, et c’est l’argument le plus solide pour déléguer les tâches répétitives à Luna.
En revanche, évitez les Runtimes économiques lorsque la validation repose sur un jugement humain. Décisions d’architecture, migrations de données, aspects touchant à la sécurité ou toute question où la justesse ne peut pas être tranchée par une commande. Dans ces cas-là, l’écart de performance se répercute directement en minutes de revue, et la solution la plus économique reste une tentative que vous n’aurez à relire qu’une seule fois.
Formalisez vos règles d’escalade par écrit au lieu de vous en remettre aux préférences individuelles, car face à un prix plus bas, la simple préférence ne fait jamais le poids. Le routage des modèles doit d’abord reposer sur la vérifiabilité, et seulement ensuite sur le coût.
Pourquoi aucun fournisseur ne vous le dira
Les deux laboratoires se sont livrés à une guerre de benchmarks le même jour, OpenAI prenant comme point de référence Claude Opus 5, qu’Anthropic a remplacé par Opus 5.5 quelques heures plus tard. Pour chaque fournisseur, l’offre d’entrée de gamme constitue le haut de son entonnoir de conversion. Aucun n’écrira : « notre modèle économique nécessitera une relecture supplémentaire de la part de vos réviseurs ». Et personne ne peut leur reprocher de l’omettre, car ce chiffre dépend entièrement de votre base de code et de vos équipes.
Sharkly ne vend pas de tokens. La consommation de modèles passe par les abonnements ou les clés d’API configurés dans les outils que votre équipe utilise déjà, de sorte que nos intérêts ne dépendent en rien du Runtime que vous choisissez. C’est la seule position permettant de tenir ce discours en toute objectivité, et c’est aussi pour cette raison que votre flux de travail doit pouvoir traverser l’arrivée du prochain modèle économique sans avoir à être reconstruit de zéro.
Ce qu’il faut afficher sur votre tableau de bord à la place
Les minutes humaines par modification acceptée, par Runtime. Si ce chiffre a augmenté après la transition, le modèle prétendument plus économique vous coûte en réalité plus cher, et vous en avez désormais la preuve. Le coût en dollars par exécution répond à une problématique qui a cessé d’être pertinente le 22 septembre 2026.
Le nombre de tentatives par modification acceptée, par Runtime. C’est ce facteur qui conditionne tout le reste, et aucun fournisseur ne peut vous le donner. Vous l’obtenez en consignant quel Runtime a produit chaque tentative, directement sur la tâche concernée.
L’attente d’une intervention humaine comme un véritable état. L’exécution, les blocages, les résultats et les échanges de suivi remontent dans la chronologie de la tâche, transformant la file d’attente humaine en une donnée mesurable plutôt qu’en une simple impression informelle. Exigez que chaque exécution soit accompagnée de ses éléments de preuve :
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
Vous n’avez pas besoin de tout cela à petite échelle. Si une seule personne pilote deux agents et relit tout dans l’après-midi, continuez ainsi : formaliser des états et des files d’attente ne ferait qu’ajouter de la complexité à un problème que vous n’avez pas encore. Cette rigueur comptable devient indispensable le jour où plus personne n’est capable de dire de mémoire combien d’exécutions terminées attendent d’être traitées.
Ce qui n’a pas baissé de prix
Deux laboratoires ont cassé le prix unitaire d’une tentative le même jour. Mais aucun n’a créé d’outil capable d’analyser un diff à votre place, et la responsabilité finale de la modification repose toujours sur un être humain. Un modèle moins cher ne signifie pas un flux de travail plus économique. Il permet seulement des tentatives moins coûteuses, qui viennent alimenter un processus dont l’étape la plus onéreuse reste humaine.
Si vous utilisez déjà plusieurs agents de développement, Sharkly centralise la visibilité sur vos flux : identifiez quel Runtime a produit chaque tentative, consultez les preuves associées et visualisez précisément le volume de travail en attente d’une intervention humaine en ce moment même.