
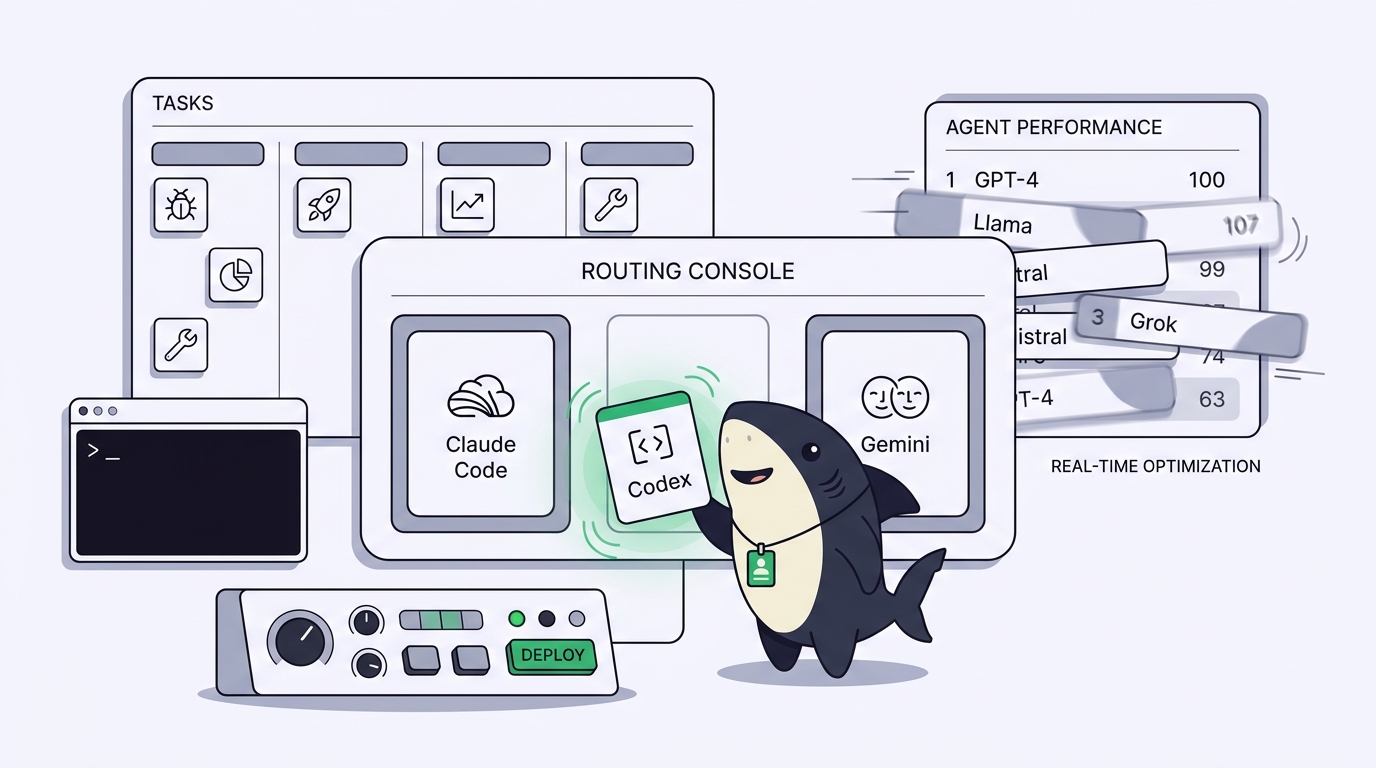
Vous cherchez à choisir le meilleur agent de codage. Vous consultez le classement, vous regardez les annonces de sortie, vous passez le même prompt dans Claude Code, Codex et Gemini CLI pour voir lequel semble le plus affûté. Puis un nouveau modèle sort, le classement est rebattu, et l'agent que vous aviez standardisé le mois dernier se retrouve soudain en milieu de tableau. Alors vous changez encore.
Le point dérangeant, c'est que l'agent que vous choisissez change moins votre semaine que vous ne le pensez. Ce qui détermine la quantité de travail que vous livrez réellement, c'est ce qui se passe autour de l'agent. Quel agent travaille sur quelle tâche, ce qui est terminé, ce qui a échoué, ce qui attend votre relecture. La plupart des développeurs subissent l'attraction du classement sans jamais remarquer que le classement n'a jamais été le goulot d'étranglement.
Sharkly repose sur ce constat. Sharkly est une plateforme tout-en-un de commande et de gestion d'Agents : vous connectez votre propre Ordinateur, vous assignez une Tâche à n'importe quel Agent que vous utilisez déjà, et chaque exécution renvoie son diff, sa sortie de tests et sa relecture au même endroit. Elle se place au-dessus des agents, pas à côté. Cet article explique pourquoi la couche de gestion détermine votre production plus que le modèle, et ce qu'il faut faire dès ce trimestre au lieu de courir après le prochain classement.
Le meilleur agent est une cible mouvante
Un classement d'agents de codage mesure un ensemble fixe et partagé de problèmes à un instant précis. Ces deux constats vieillissent mal. L'ensemble de problèmes n'est pas votre base de code, et l'instant n'est pas le mois prochain.
Regardez le rythme. Anthropic, OpenAI et Google ont chacun publié plusieurs mises à jour de modèles capables de faire du codage agentique au cours de l'année écoulée, et le classement relatif entre eux a basculé plus d'une fois [À VÉRIFIER : la cadence exacte des sorties et le classement actuel changent chaque mois ; à confirmer avant de citer des chiffres précis]. Si vous considérez « utiliser le meilleur agent » comme une décision, vous vous engagez à refaire cette décision à chaque sortie d'un laboratoire. Chaque changement a un coût : nouvelle configuration, nouveaux fichiers de contexte, nouvelles habitudes, un nouvel ensemble de modes de défaillance que votre équipe doit apprendre.
Voici une prédiction, et je l'assume comme telle. L'écart entre les meilleurs agents de codage va continuer à se réduire, pas à s'élargir. Quand trois agents corrigent le même bug dans votre dépôt, la question cesse d'être « lequel est le meilleur » pour devenir « à quel agent je confie cette tâche précise, et comment je vois le résultat ». Le facteur différenciant quitte le modèle pour le flux de travail. Ce basculement est déjà visible dans la façon dont les équipes parlent des agents ; il deviendra la norme avant d'être l'exception.
La défense contre une cible mouvante n'est pas une meilleure visée. C'est un flux de travail qui survit au déplacement de la cible. Comparer les agents sur votre propre base de code, pas sur un benchmark vous dit lesquels valent la peine d'être exécutés aujourd'hui ; cela ne vous enferme pas dans cette réponse demain.
Ce qui détermine réellement ce que vous livrez
Regardez où une tâche passe son temps. L'agent génère un diff en quelques minutes. Tout le reste — décider quel agent reçoit la tâche, garder ses modifications isolées des quatre autres agents, découvrir qu'il s'est bloqué sur une étape de build, lire ce qu'il a produit, l'accepter ou le rejeter — occupe votre journée. Rien de tout cela n'est une propriété du modèle.
Voilà le problème de gestion, et il apparaît dès que vous faites tourner plus d'un agent. Quel agent travaille sur quoi ? Lequel doit recevoir la tâche suivante ? Qu'est-ce qui est terminé, qu'est-ce qui a échoué, qu'est-ce qui demande un humain ? Comment empêcher trois agents qui modifient un même dépôt de toucher les mêmes fichiers ? Plus chaque agent pris individuellement gagne en capacité, plus vous en faites tourner en parallèle, et plus ces questions deviennent aiguës.
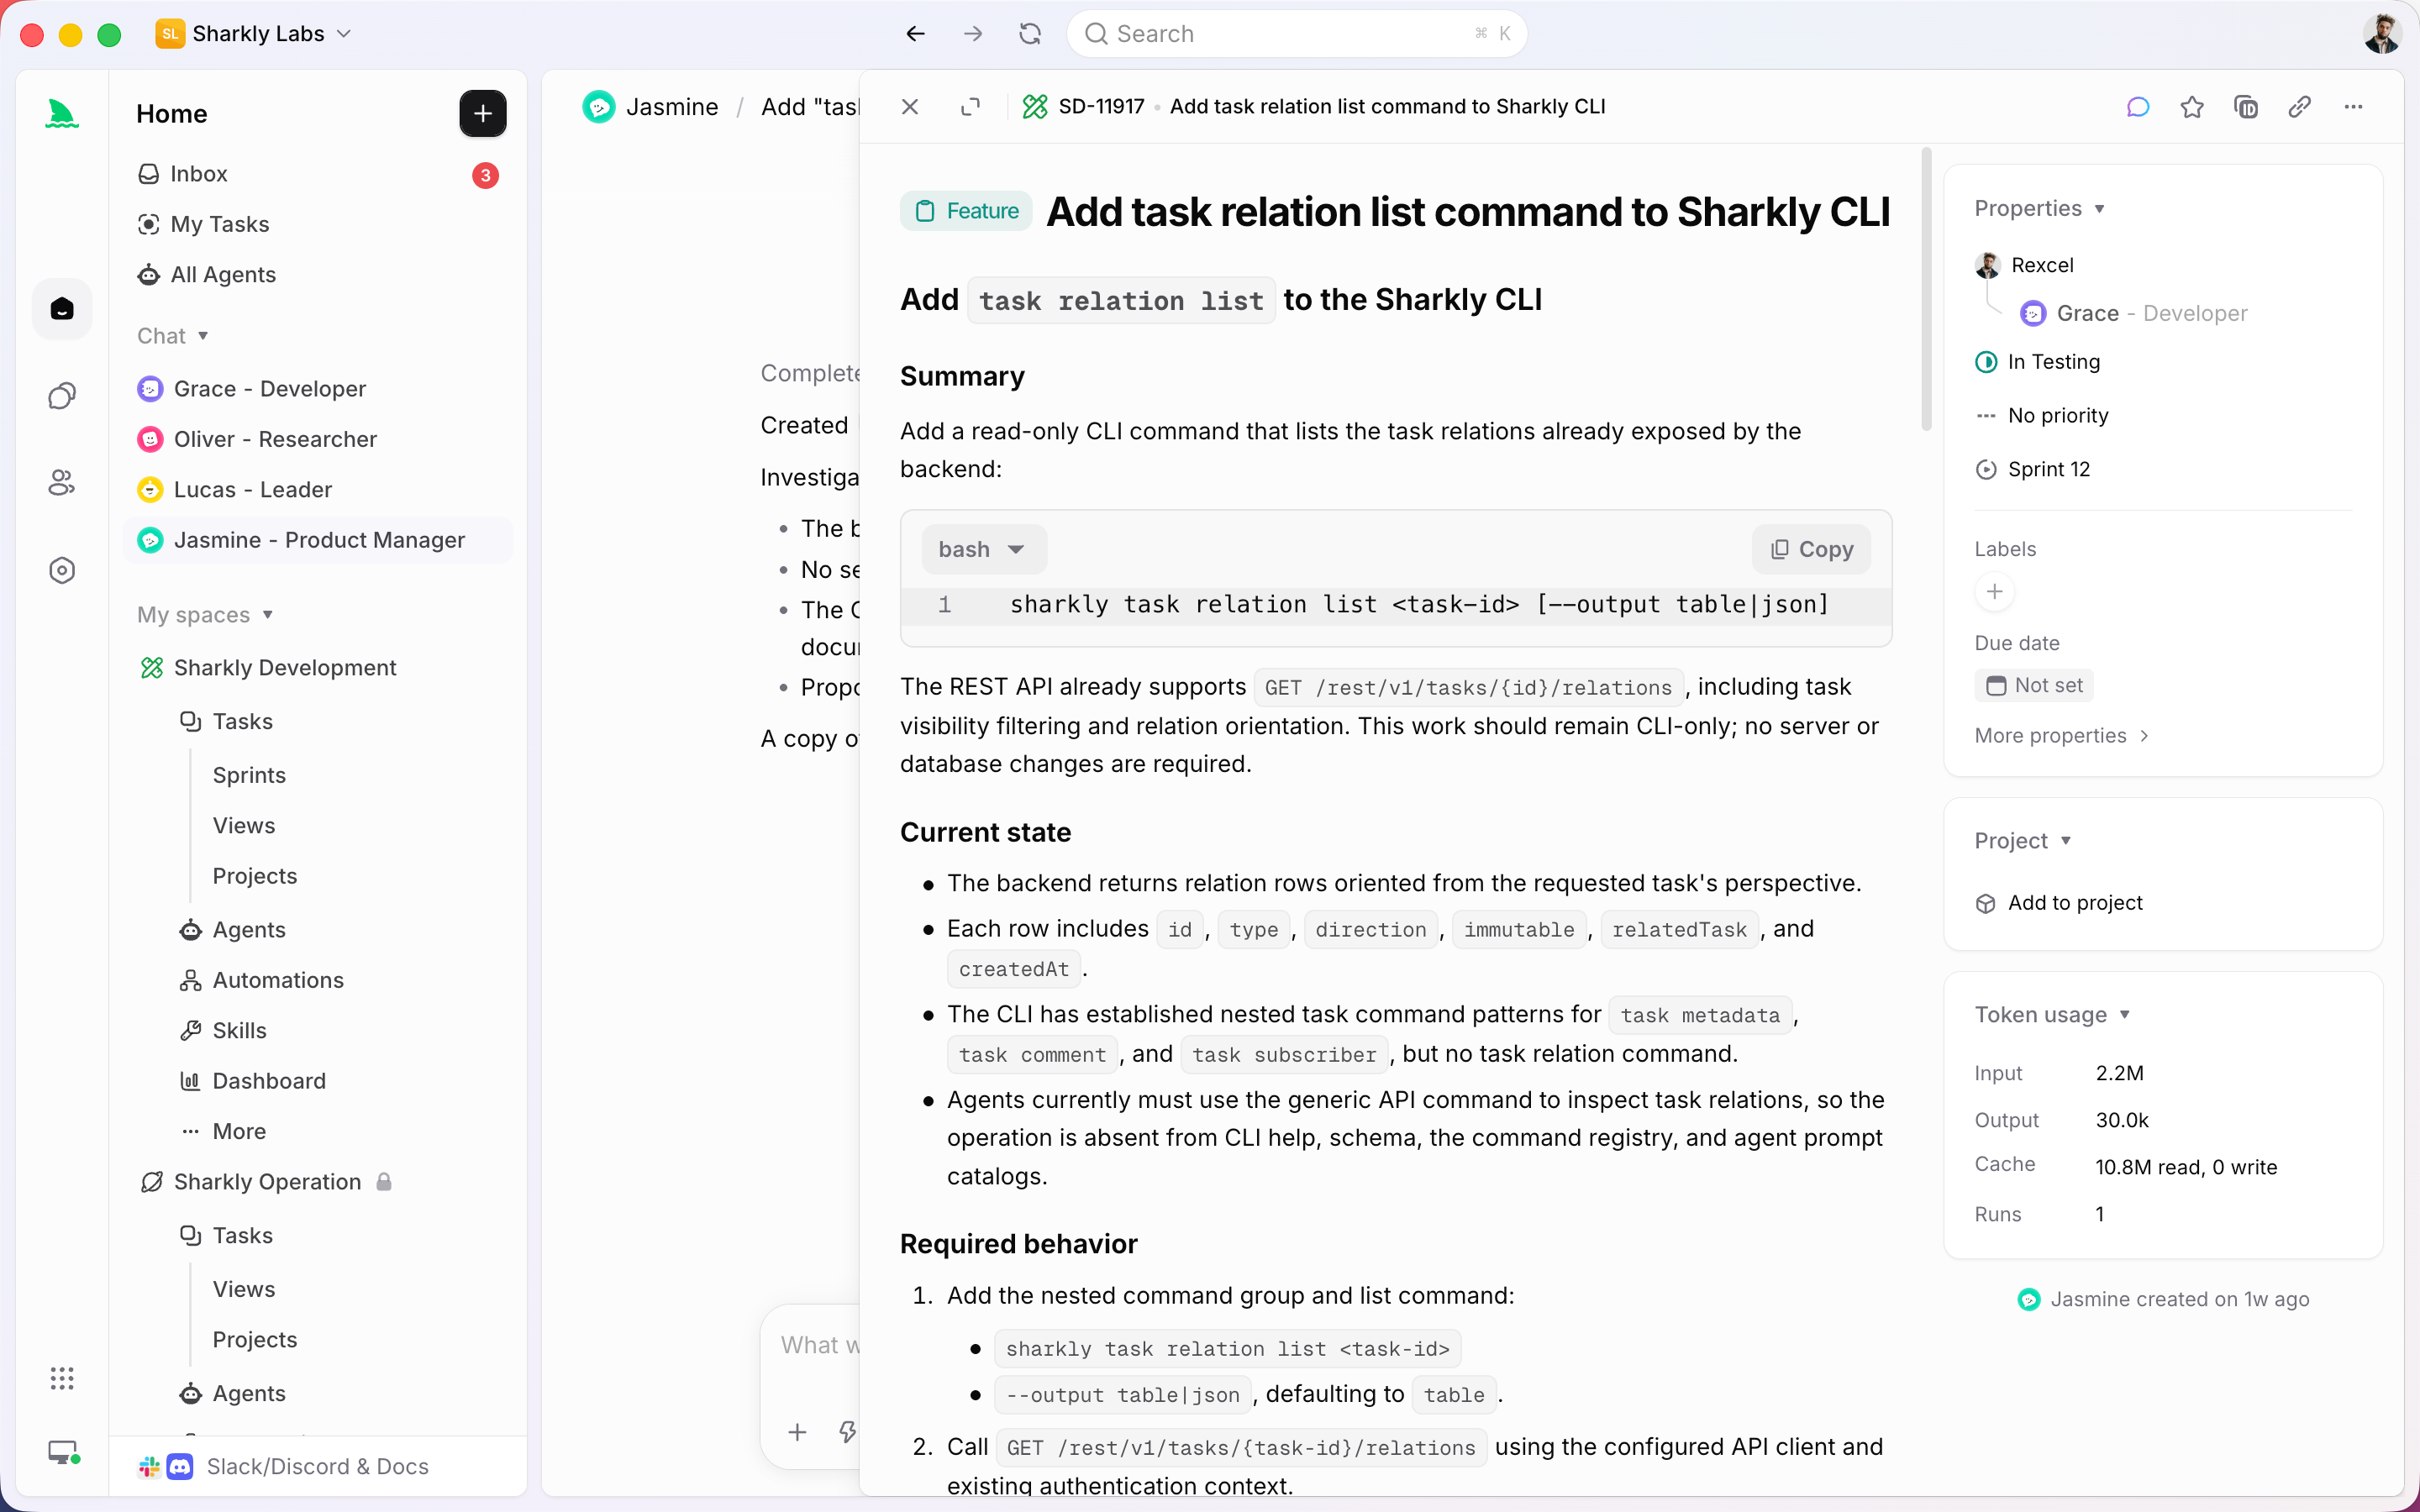
Sharkly y répond sous forme de couche, pas d'outil. Une Tâche est l'unité de travail principale : vous l'assignez à un Agent, l'Agent s'exécute sur un Ordinateur connecté dans un worktree isolé, et l'exécution, les blocages, les résultats et le suivi reviennent tous à la Tâche. L'agent qui a fait le travail est un paramètre de la Tâche, pas l'architecture de toute votre installation. Remplacez Claude Code par Codex sur la tâche suivante et rien d'autre ne change dans votre processus. C'est ce que vous apporte la neutralité vis-à-vis des fournisseurs : votre flux de travail survit à l'agent qui gagne actuellement.
La capacité de relecture est le vrai plafond
Un agent qui affiche « terminé » n'a rien livré. Un humain doit encore lire le diff, vérifier les tests et décider. C'est cette étape de relecture, et non la génération de code, qui constitue la contrainte que presque toutes les équipes rencontrent en premier.
Le calcul est sans appel. Si un agent produit une journée de travail à relire en vingt minutes, cinq agents produisent cinq jours de relecture dans ces mêmes vingt minutes, et vous n'avez toujours qu'une seule paire d'yeux. Un agent plus rapide ou plus intelligent aggrave la situation au lieu de l'améliorer, parce qu'il remplit votre file d'attente plus vite. Choisir le meilleur agent revient à optimiser l'étape qui n'a jamais été le goulot d'étranglement tout en laissant le vrai goulot intact. La capacité de relecture est la véritable limite du volume de travail d'agents en parallèle qu'une équipe peut absorber, et aucune mise à jour de modèle ne change cette arithmétique.
La vraie alternative n'est donc pas « Claude Code ou Codex ». La voici. Utilisez un agent plus rapide quand votre contrainte est de générer une première version d'une modification. Investissez dans votre processus de relecture quand votre contrainte est de décider si une modification est correcte. Pour la plupart des équipes qui font tourner des agents en parallèle, la seconde contrainte se manifeste bien avant la première. La solution consiste à rendre chaque exécution facile à relire grâce à des preuves au niveau de la tâche : un diff, la sortie du typecheck et des tests, un résumé des modifications et les limites que l'agent reconnaît, le tout au même endroit plutôt qu'éparpillé entre plusieurs terminaux.
C'est là que le contrat humain-agent prend tout son sens. Les agents font la recherche, exécutent, testent et rendent compte. Les humains donnent la direction, accordent l'autorité et acceptent le résultat. L'automatisation s'arrête là où le jugement de l'équipe est requis. Un meilleur agent en fait plus sur la première phrase ; il n'en fait rien sur la seconde. Le plafond se situe de votre côté de cette ligne.
Faire du choix d'agent un paramètre, pas une architecture
Voici la frontière, énoncée clairement pour que personne ne se méprenne : Sharkly n'est pas un agent de codage et ne remplace ni Claude Code, ni Codex, ni aucun autre runtime. Il n'écrit pas de meilleur code qu'eux. Il ajoute la Tâche partagée, l'Ordinateur, le contexte et la couche de relecture autour des outils que votre équipe utilise déjà.
Cette distinction est tout l'intérêt. Quand le choix de l'agent est un paramètre, essayer un nouvel agent vous coûte une tâche, pas une migration. Vous connectez le runtime, vous lui assignez un vrai besoin et vous lisez ce qui revient, à côté des résultats de l'agent que vous utilisiez hier. Quand le choix de l'agent est inscrit dans votre architecture, chaque expérience coûte cher et chaque remaniement du classement devient une menace.
Soyez honnête sur le moment où vous n'avez pas besoin de tout cela. Si vous n'utilisez qu'un seul agent de codage et que vous êtes parfaitement heureux dans un seul terminal, une session Claude Code bien réglée dans son propre worktree suffit, et la couche de gestion est une surcharge dont vous pouvez vous passer. L'équation change dès que vous faites tourner deux agents ou plus, sur plusieurs tâches ou dépôts, et que vous voulez les résultats dans une forme qu'un collègue peut lire sans que vous ayez à lui raconter votre historique de terminal. C'est le seuil à partir duquel la gestion des agents de codage devient une couche dont vous avez réellement besoin plutôt qu'une bonne idée.
Ce qu'il faut faire autrement ce trimestre
Arrêtez de passer la semaine à courir après le classement. Passez-la à construire la couche qui fait du classement un simple détail.
Trois actions concrètes. D'abord, choisissez vos agents de la façon la plus ennuyeuse possible : faites-en tourner deux sur une vraie tâche de votre backlog et gardez celui dont le résultat se lit le mieux sur votre code, en sachant que vous y reviendrez. Ensuite, mesurez honnêtement votre débit de relecture ; si les agents terminent plus vite que vous ne pouvez accepter leur travail, la prochaine mise à niveau d'agent ne vous aidera pas, alors qu'un meilleur flux de relecture, si. Enfin, cessez d'inscrire en dur un seul agent dans votre processus. Faites passer le travail par une couche qui traite l'agent comme interchangeable, pour que la prochaine sortie de modèle soit une option que vous testez, et non une reconstruction que vous redoutez. Si vous hésitez encore sur le modèle à utiliser pour chaque agent, associer les modèles aux rôles d'agent est un meilleur usage d'un après-midi que de rafraîchir un classement.
Si vous voulez continuer à utiliser plusieurs agents de codage plutôt que de vous engager dans un seul écosystème, c'est précisément le problème autour duquel Sharkly est conçu. Téléchargez Sharkly, connectez un Ordinateur et assignez la même vraie tâche à deux agents. Le meilleur changera. Votre façon de les gérer, non.


