
Biaya per tugas Gemini 4 Neon tidak hanya ditentukan oleh harga $3 / $15 per juta token. Google menyatakan bahwa Neon pada tingkat berpikir high (default) berbiaya 32% lebih murah per tugas dibanding Gemini 4 Carbon. Per token, Neon 50% lebih mahal daripada harga perkenalan Carbon dan 25% lebih murah daripada harga Carbon mulai 1 Desember 2026. Mana yang lebih murah untuk agent Anda bergantung pada jumlah token per tugas dan berapa banyak percobaan yang tim Anda terima.
TL;DR
- Harga resmi Neon: $3 per 1M token input, $15 per 1M token output (termasuk thinking), $0,15 per 1M input dari cache. Hanya tersedia di tier berbayar.
- Harga resmi Carbon: $2 / $10 hingga 30 November 2026, lalu $4 / $20 mulai 1 Desember.
- Klaim Google: biaya per tugas 32% lebih rendah daripada Carbon pada
high, berdasarkan grafik Artificial Analysis Intelligence Index. Postingan itu tidak menyebutkan harga Carbon mana yang dipakai dalam grafik tersebut. - Artinya: Neon hanya mengungguli harga perkenalan Carbon jika menyelesaikan tugas yang sama dengan kurang dari dua pertiga token Carbon. Mulai 1 Desember, Neon menang kecuali menggunakan sepertiga token lebih banyak daripada Carbon.
- Yang perlu diukur: biaya per perubahan yang diterima, bukan biaya per percobaan.
Harga Gemini 4 Neon dibandingkan Carbon dan Hydrogen
Gemini 4 Neon adalah model menengah dalam keluarga Gemini 4 milik Google, dirilis 18 November 2026 dengan nama gemini-4-neon. Model card menjelaskannya sebagai model yang diadaptasi dari Carbon dan dirancang untuk menyeimbangkan "kedalaman dan efisiensi". Berikut tarif standar tier berbayar per 1M token dari halaman harga Gemini API:
| Model | Input | Output (termasuk thinking) | Input cache | Batch input / output | Tier gratis |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | Tidak |
| Gemini 4 Carbon, hingga 30 Nov | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | Tidak |
| Gemini 4 Carbon, mulai 1 Des | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | Tidak |
| Gemini 4 Hydrogen (tier berbayar) | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Ya |
Ketiganya hanya mendukung implicit caching. Panduan AI Studio untuk Neon menyebutkan bahwa implicit caching aktif untuk prompt dengan minimal 4.096 token dan memberikan potongan 95% untuk input yang di-cache. Neon tidak punya explicit caching, jadi hapus semua field cached_content saat memindahkan konfigurasi Carbon.
Google menagih "setiap token yang diproses model, termasuk token thinking, instruksi sistem grounding internal, dan deklarasi fungsi". Untuk agent yang berat menggunakan tool, deklarasi tersebut terbawa di setiap giliran.
Cara Google mengukur biaya per tugas Neon
Biaya per tugas adalah total pengeluaran sebuah model untuk menyelesaikan satu tugas benchmark: token yang digunakan dikalikan harganya. Dalam postingan peluncurannya, Google menyatakan bahwa pada high, Neon "memadukan skor Artificial Analysis Intelligence Index yang tinggi dengan biaya per tugas 32% lebih rendah daripada Carbon". Grafiknya diberi label "AA Index v5.01 cost per task".
Artificial Analysis adalah pihak ketiga, bukan Google. Postingan itu memuat dua klaim biaya lainnya, dan keduanya bukan tentang Carbon:
- Neon berjalan dengan "biaya per tugas sekitar 50% hingga 80% lebih rendah daripada model frontier pesaing terbaik", tanpa menyebutkan pesaingnya.
- Pada
xhigh, Neon tetap "36%+ lebih murah per tugas daripada model pesaing pada pengaturan tertingginya".
Postingan itu tidak mempublikasikan jumlah token maupun harga Carbon yang melandasi angka 32% tersebut. Kesenjangan ini lebih penting dari biasanya, karena harga Carbon berlipat ganda kurang dari dua minggu setelah Neon diluncurkan.
Apakah Gemini 4 Neon lebih murah daripada Carbon? Tergantung tanggalnya
Per token, Neon berada di antara dua harga Carbon: 1,5 kali harga perkenalan Carbon dan 0,75 kali harga Desembernya. Jadi angka 32% itu hanya bisa berasal dari penggunaan token Neon yang lebih sedikit per tugas. Mari kita hitung klaimnya dari dua arah:
| Jika grafik Google menghitung Carbon dengan harga | Token Neon yang tersirat vs Carbon | Neon vs Carbon hingga 30 Nov | Neon vs Carbon mulai 1 Des |
|---|---|---|---|
| $2 / $10 (perkenalan) | sekitar 45% | 32% lebih murah | sekitar 66% lebih murah |
| $4 / $20 (Desember) | sekitar 91% | sekitar 36% lebih mahal | 32% lebih murah |
Kedua baris mengasumsikan kedua model membagi token input dan output dalam rasio yang sama, yang merupakan penyederhanaan. Apa pun caranya, mulai 1 Desember Neon lebih murah per tugas menurut angka Google sendiri. Hingga 30 November, jawabannya bergantung pada detail yang tidak dipublikasikan Google.
Berapa biaya satu tugas agent pada harga resmi
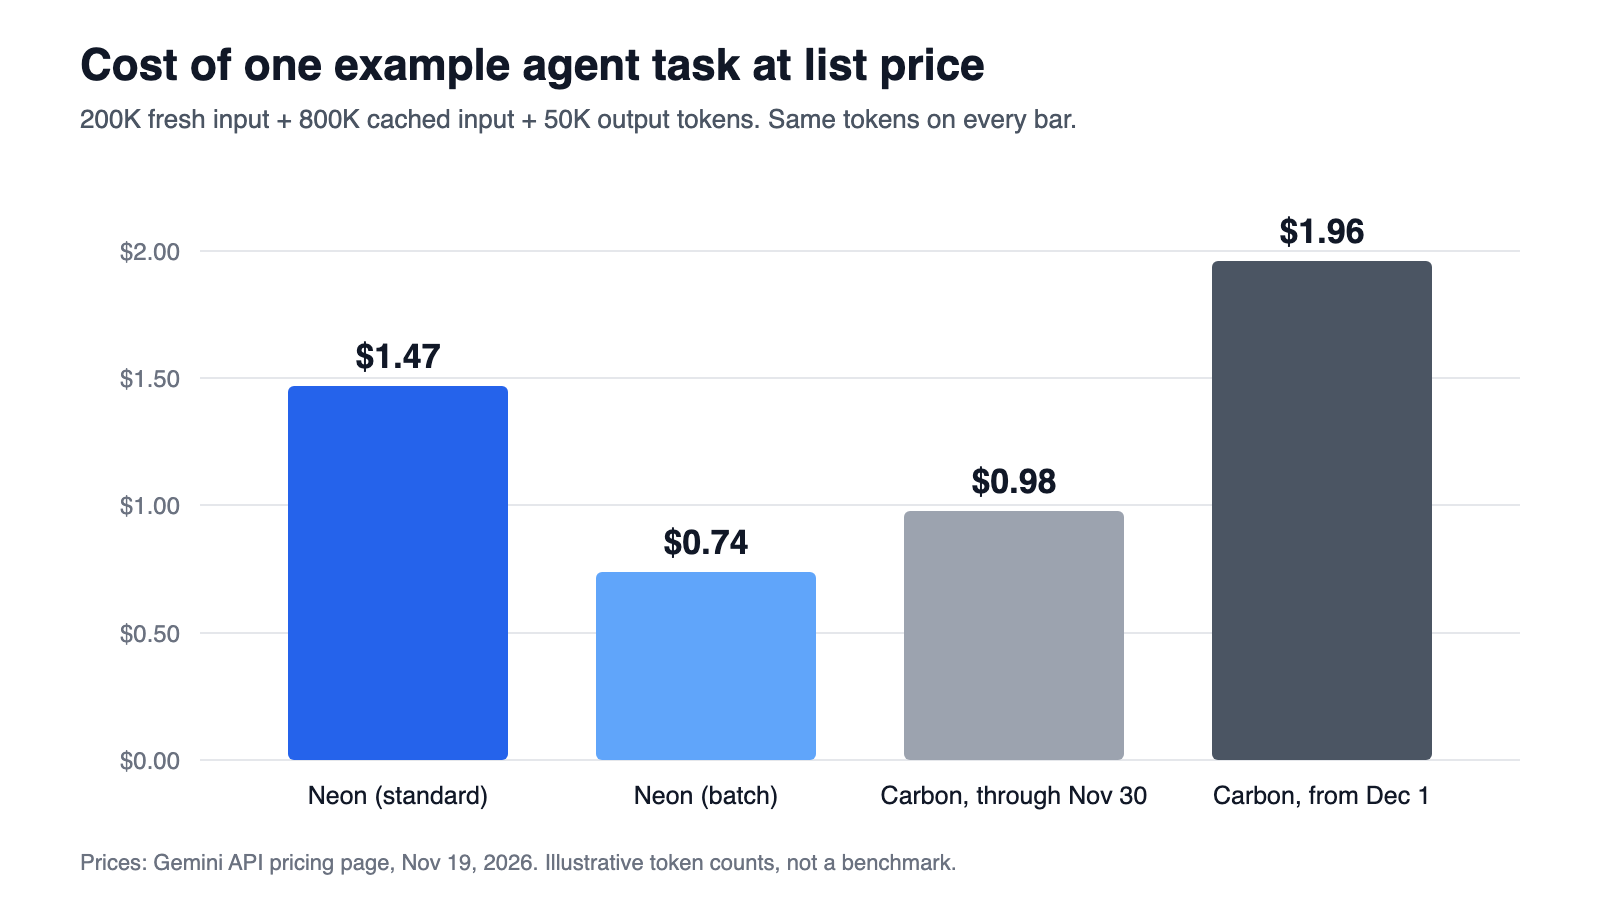
Berikut contoh perhitungan dengan angka bulat, bukan benchmark. Bayangkan sesi agent coding yang mengirim 200K token input baru, mendapat 800K token cache hit saat membaca ulang repositori, dan menghasilkan 50K token output termasuk thinking.
| Model | Input baru | Input cache | Output | Total |
|---|---|---|---|---|
| Neon (standar) | $0.60 | $0.12 | $0.75 | $1.47 |
| Neon (batch) | $0.30 | $0.06 | $0.375 | $0.74 |
| Carbon, hingga 30 Nov | $0.40 | $0.08 | $0.50 | $0.98 |
| Carbon, mulai 1 Des | $0.80 | $0.16 | $1.00 | $1.96 |
Pada jumlah token yang sama, Neon kalah dari harga perkenalan Carbon dan mengungguli harga Desembernya. Aturan break-even-nya sederhana. Dibanding harga perkenalan, Neon harus menyelesaikan tugas dengan kurang dari 67% token Carbon. Dibanding harga Desember, Neon tetap lebih murah kecuali membutuhkan lebih dari 133% token Carbon.
Output adalah separuh dari tagihan Neon pada contoh ini, dan token thinking ditagih sebagai output. Itulah mengapa tingkat thinking yang Anda pilih memengaruhi biaya lebih besar daripada harga resminya.
Tingkat thinking: faktor penentu biaya per tugas Neon
Neon mendukung empat tingkat thinking: low, medium, high (default) dan xhigh. Panduan Google menjelaskan trade-off-nya secara langsung: xhigh "meningkatkan latensi dan penggunaan token", dan Anda sebaiknya "memilih thinking_level terendah yang memenuhi standar kualitas Anda".
Pengaturan routing yang praktis untuk pekerjaan agent adalah sebagai berikut:
low: pertanyaan tentang codebase, ringkasan diff, catatan triage.medium: perbaikan terbatas yang penilaiannya sebenarnya ada pada test suite.high: refaktorisasi, debugging, dan sesi panggilan tool yang panjang. Di sinilah klaim 32% dari Google berlaku.xhigh: hanya untuk tugas yang sudah gagal review padahigh.
Atur per permintaan dalam kode:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Find why test_checkout_retry flakes and propose a fix.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
Neon menolak tingkat minimal yang lama dengan pesan error dan mengabaikan temperature, top_p, serta top_k. Google juga merekomendasikan client timeout minimal 15 menit untuk prompt yang sulit, yang pertama kali tercapai pada run agent yang panjang.
Mengapa biaya per tugas tetap bukan angka Anda
Tugas benchmark selesai ketika grader memberi nilai. Tugas Anda selesai ketika seseorang menggabungkan perubahannya. Percobaan ulang, diff yang ditolak, dan waktu review berada di antara keduanya, dan tidak ada grafik biaya per tugas yang menunjukkannya.
Angka yang sesuai dengan anggaran Anda adalah biaya per perubahan yang diterima: total pengeluaran model untuk sebuah tugas, mencakup semua percobaan, dibagi jumlah perubahan yang Anda rilis. Kami menguraikan argumen lengkapnya di kapan model yang lebih murah justru lebih mahal. Singkatnya:
biaya per perubahan yang diterima = biaya per percobaan / tingkat penerimaan
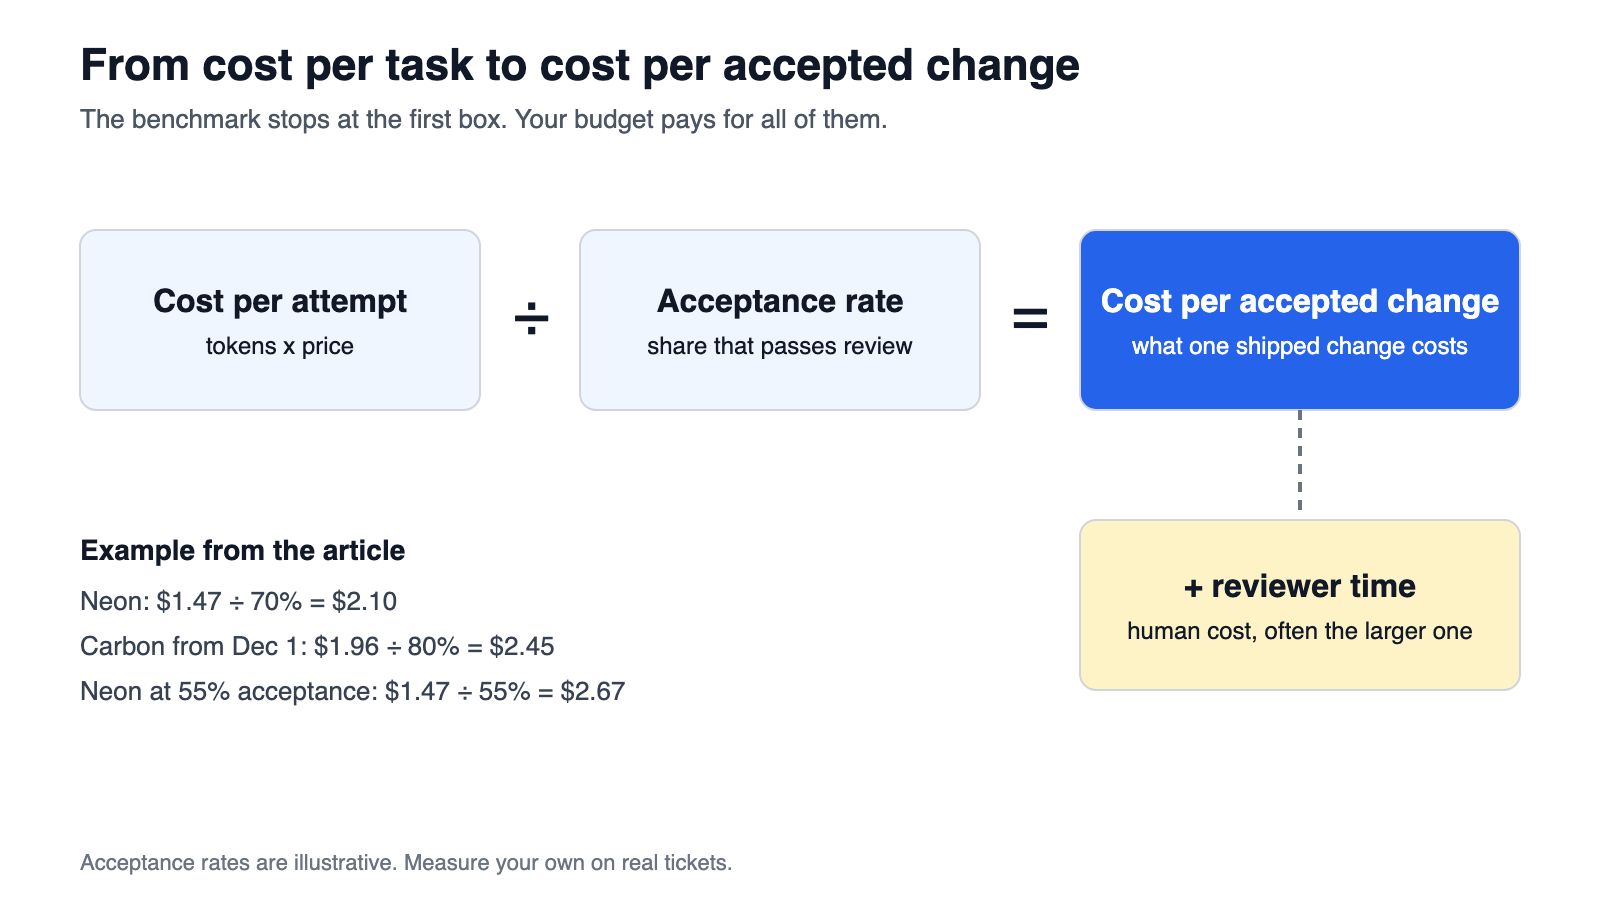
Coba jalankan contoh di atas. Jika Neon lolos review pada 70% percobaan pertama, $1,47 per percobaan menjadi $2,10 per perubahan yang diterima. Jika Carbon pada harga Desember lolos 80%, $1,96 menjadi $2,45. Neon masih unggul. Namun jika tingkat penerimaan Neon turun ke 55%, biayanya menjadi $2,67 per perubahan yang diterima, dan Carbon menang. Tingkat penerimaan Anda, bukan grafik Google, yang menentukan pilihan rutenya.
Waktu reviewer berada di luar rumus itu dan biasanya lebih mahal daripada token. Review manusia adalah bottleneck bagi agent paralel, jadi lebih sedikit diff yang ditolak berarti menghemat bagian yang paling mahal.
Cara menguji Neon melawan Carbon pada tugas Anda sendiri
Anda tidak butuh benchmark baru. Anda butuh dua minggu tiket nyata dan cara untuk mengetahui model mana yang mengerjakan apa. Sharkly menyediakan papan untuk itu: setiap tugas menyimpan run agent, hasilnya, dan status reviewnya di satu tempat.
- Pilih 20 hingga 30 tugas biasa dari backlog Anda: perbaikan bug, refaktorisasi kecil, penambahan test.
- Buat dua Agent. Sharkly Agent mengikuti model default Runtime-nya dan tidak memiliki pemilih model, sesuai dokumentasi Agents. Jadi arahkan setiap Agent ke Runtime yang dikonfigurasi dengan model berbeda: satu dengan
gemini-4-neon, satu dengangemini-4-carbon. - Bagi tugas-tugasnya ke kedua Agent dengan tingkat kesulitan yang serupa di kedua sisi.
- Catat tiga angka per tugas: token dari penggunaan Gemini API Anda, jumlah percobaan hingga diterima, dan menit reviewer.
- Hitung biaya per perubahan yang diterima untuk setiap model, pada kedua harga Carbon jika pengujian Anda melewati tanggal 1 Desember.
Sharkly tidak menjual token model. Run Anda ditagihkan ke kunci Gemini API yang sudah dikonfigurasi di Runtime, sehingga perbandingan tetap jujur: tidak ada bagian dari platform yang memengaruhi harga ke salah satu model. Untuk gambaran besar, baca mengapa platform agent tidak sebaiknya menjual token kepada Anda dan melacak pengeluaran lintas Claude Code, Codex, dan Gemini.
Di mana Neon, Carbon, dan Hydrogen masing-masing paling cocok
Model card Google menempatkan Carbon untuk "proyek terberat Anda dengan horizon panjang" dan Hydrogen untuk "eksekusi harian yang cepat", dengan Neon di antara keduanya. Dari sisi biaya, hal ini memberi tim agent tiga jalur:
- Hydrogen pada $1,50 / $7,50 untuk pekerjaan bervolume tinggi berisiko rendah. Lihat Gemini 4 Hydrogen untuk agent coding.
- Neon pada
highsebagai jalur default untuk tiket kompleks, dan sebagai lead yang mengarahkan subagent Hydrogen paralel. - Carbon untuk pekerjaan horizon panjang yang gagal diselesaikan Neon bahkan pada
xhigh. Ulasan Carbon kami membahas di mana ia layak dengan harganya.
Panduan pairing Carbon dan Hydrogen menunjukkan papan planner-dan-worker; mulai 1 Desember, Neon mengambil posisi planner dengan biaya lebih murah. Untuk routing lintas vendor, lihat model routing untuk kru agent.
Kesimpulan
Gemini 4 Neon lebih murah daripada Carbon per tugas mulai 1 Desember dengan penafsiran apa pun atas angka Google. Sebelum tanggal itu, semuanya bergantung pada harga Carbon mana yang dipakai di balik grafik 32%, dan Google tidak menyebutkannya. Bagaimanapun, harga resmi memang tidak pernah menjadi angka penentu: token per tugas, tingkat thinking, dan tingkat penerimaan itulah yang menentukan.
Jalankan pengujian dua minggu pada backlog Anda sendiri dan hitung harga kedua model per perubahan yang diterima. Jika Anda sudah menjalankan beberapa agent coding, Sharkly menyediakan satu papan untuk menugaskan tugas, membandingkan hasil para Agent, dan mengelola review dalam satu antrean. Dokumentasi Sharkly memandu Anda menghubungkan sebuah Computer dan membuat Agent.
FAQ
Berapa biaya Gemini 4 Neon?
$3 per 1M token input, $15 per 1M token output termasuk thinking, dan $0,15 per 1M token input cache pada tier berbayar Gemini API. Batch dan Flex memotongnya menjadi setengah: $1,50 / $7,50. Tidak ada tier API gratis.
Apakah Gemini 4 Neon lebih murah daripada Gemini 4 Carbon?
Per token, tidak hingga 30 November ($3 / $15 dibanding $2 / $10), dan ya mulai 1 Desember ($3 / $15 dibanding $4 / $20). Per tugas, Google melaporkan Neon pada high 32% lebih murah daripada Carbon, tanpa mempublikasikan harga Carbon mana yang digunakan.
Apakah Gemini 4 Neon punya tier gratis?
Tidak. Halaman harga mencantumkan "Not available" untuk tier gratis Neon di semua tingkat layanan. Gemini 4 Hydrogen memang punya tier gratis.
Apakah token thinking ditagihkan untuk Gemini 4 Neon?
Ya. Google menagih token thinking dengan harga output $15 per 1M, bersama deklarasi fungsi dan instruksi sistem grounding. Menurunkan thinking_level adalah cara utama untuk menghemat token.
Tingkat thinking mana yang paling murah untuk agent coding?
low menggunakan token paling sedikit dan xhigh paling banyak. Google merekomendasikan menguji keempat tingkat pada set evaluasi Anda dan memilih tingkat terendah yang memenuhi standar kualitas Anda. Mulailah dengan high untuk perubahan kode yang kompleks.
Kapan harga Gemini 4 Carbon naik?
Pada 1 Desember 2026. Input naik dari $2 menjadi $4 per 1M token dan output dari $10 menjadi $20, menurut halaman harga Gemini API.


