

GPT-6.2 Astra vs Fable 5.2 lebih berimbang daripada yang digambarkan judul berita. Keduanya dipatok $8 per juta token input dan $40 per juta token output. Anthropic mempublikasikan skor agentic coding yang lebih tinggi untuk Fable 5.2; OpenAI tidak mempublikasikan benchmark coding apa pun untuk Astra. Harga cache, biaya tambahan konteks panjang, dan tingkat perubahan yang diterima tim Anda sendiri yang menentukan pemenangnya.
OpenAI merilis GPT-6.2 Astra pada 17 November 2026, delapan hari setelah Anthropic meluncurkan Claude Fable 5.2. Keduanya adalah model frontier yang ditujukan untuk pekerjaan agent yang panjang dan sulit. Jika Anda menjalankan coding agent, kini ada dua opsi unggulan dengan harga yang sama.
Papan peringkat tidak bisa menyelesaikan ini untuk Anda. Dependensi, test suite, dan reviewer Andalah yang bisa. Panduan ini membandingkan angka-angka yang dipublikasikan, menunjukkan di mana tagihan berbeda, dan memberi Anda uji head-to-head yang bisa dijalankan di repositori Anda sendiri. Jika Anda sudah menjalankan Codex dan Claude Code secara berdampingan, Sharkly adalah tempat Anda menugaskan tugas yang sama ke keduanya dan menyimpan hasilnya bersama.
GPT-6.2 Astra vs Fable 5.2: perbandingan spesifikasi
GPT-6.2 Astra adalah model frontier OpenAI dalam keluarga GPT-6.2; GPT-6.2 Sol adalah saudara kandungnya yang lebih murah untuk penggunaan sehari-hari. Claude Fable 5.2 adalah model tersedia umum teratas dari Anthropic, dengan Mythos 5.2 dibatasi sebagai rilis akses terbatas. Berikut yang dipublikasikan masing-masing vendor, diperiksa pada 20 November 2026.
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Dirilis | 17 November 2026 | 9 November 2026 |
| ID model API | gpt-6.2-astra |
claude-fable-5-2 |
| Input, per 1 juta token | $8 | $8 |
| Output, per 1 juta token | $40 | $40 |
| Input ter-cache (cache hit) | $0,40 | $0,20 |
| Cache write | $10 (30 menit) | $10 (5 menit), $16 (1 jam) |
| Batch | 50% dari standar | $4 input, $20 output |
| Fast mode | 2x standar | $16 input, $80 output |
| Jendela konteks | 1.050.000 token (maks input 922.000) | 1 juta token dengan harga standar |
| Output maksimal | 128.000 token | 128.000 token |
| Biaya tambahan input panjang | Di atas 272K input: tarif input dan cache menjadi dua kali, output 1,5x | Tidak ada yang tercantum |
| Coding agent yang biasa dipakai | Codex | Claude Code |
Sumber: halaman model GPT-6.2 Astra dari OpenAI, dokumentasi harga dan ikhtisar model dari Anthropic.
Dua baris paling penting bagi agent. Coding agent mengirim ulang konteksnya setiap putaran, jadi tingkat cache hit membentuk sebagian besar tagihan. Dan agent yang telah membaca repositori besar bisa melewati 272K token input, di mana tarif Astra berubah.
Apa yang dikatakan benchmark coding, dan apa yang tidak
Pengumuman Fable 5.2 dari Anthropic melaporkan 69,9% pada FrontierSWE v2 dan 49,1% pada FrontierCode 2.0 pada tingkat effort Xhigh. Dalam tabel yang sama, kolom perbandingan OpenAI diberi label GPT-6 Astra, generasi sebelumnya, dengan 65,5% dan 42,8%.
Tabel itu tidak menyertakan GPT-6.2 Astra. Halaman model OpenAI juga tidak mencantumkan skor coding bergaya SWE untuknya. Tulisan peluncuran Simon Willison mencatat bahwa "Astra 6.2 tidak mencetak skor setinggi Fable 5.2 pada berbagai benchmark," dan bahwa sebagian pengguna merasa gaya komunikasinya "bisa membingungkan."
Jadi pembacaan yang jujur punya tiga bagian:
- Fable 5.2 memiliki skor agentic coding yang dipublikasikan dan dijalankan vendor, di atas Astra terakhir.
- Tidak ada vendor yang telah mempublikasikan perbandingan coding langsung terhadap GPT-6.2 Astra.
- Setiap angka di atas dijalankan oleh vendor model itu sendiri, pada harness-nya sendiri, dengan tingkat effort yang dipilih.
Perlakukan benchmark sebagai filter daftar pendek. Artikel ini tidak menyertakan hasil uji independen untuk kedua model.
Di mana tagihan berbeda
Harga daftar yang sama tidak berarti tagihan yang sama. Tiga mekanisme memisahkannya.
Cache hit
Fable 5.2 menagih $0,20 per juta token pada cache hit. Astra menagih $0,40. Untuk agent yang mengirim ulang prefiks ter-cache 100.000 token sebanyak 50 kali dalam satu sesi, prefiks itu menelan biaya $1,00 pada Fable dan $2,00 pada Astra, sebelum input dan output baru. Simon Willison tetap menyebut harga ter-cache Astra "kabar baik untuk sesi agent yang berjalan lebih lama"; nilainya jauh di bawah tarif tanpa cache $8.
Konteks panjang
Tarif Astra naik begitu permintaan melewati 272K token input. Anthropic mencantumkan konteks 1M penuh dengan tarif standar untuk Fable. Jika agent Anda rutin memuat setengah monorepo, hitung ambang batas itu sebelum Anda berkomitmen.
Effort dan token per tugas
Kedua model mengekspos tingkat effort, dan effort yang lebih tinggi membakar lebih banyak token. Uji SVG informal Simon menunjukkan sebarannya pada satu prompt: GPT-6.2 Astra menelan biaya 11,55 sen pada effort High dan 88,71 sen pada Max. Itu satu prompt mainan, bukan benchmark coding, tapi selisih 7x menunjukkan mengapa Anda harus menetapkan tingkat effort sebelum membandingkan biaya.
Rincian harga Fable 5.2 kami membahas retry dan waktu review; panduan rate limit GPT-6.2 mencakup batas token-per-menit yang pertama kali ditemui agent Astra.
Cara menjalankan uji GPT-6.2 Astra vs Fable 5.2 di repositori Anda sendiri
Uji head-to-head pada kode Anda sendiri mengalahkan tabel terbitan mana pun. Metode di bawah ini mengikuti panduan yang lebih panjang tentang mengevaluasi Fable 5.2 pada basis kode Anda; di sini dijalankan sebagai duel dua model.
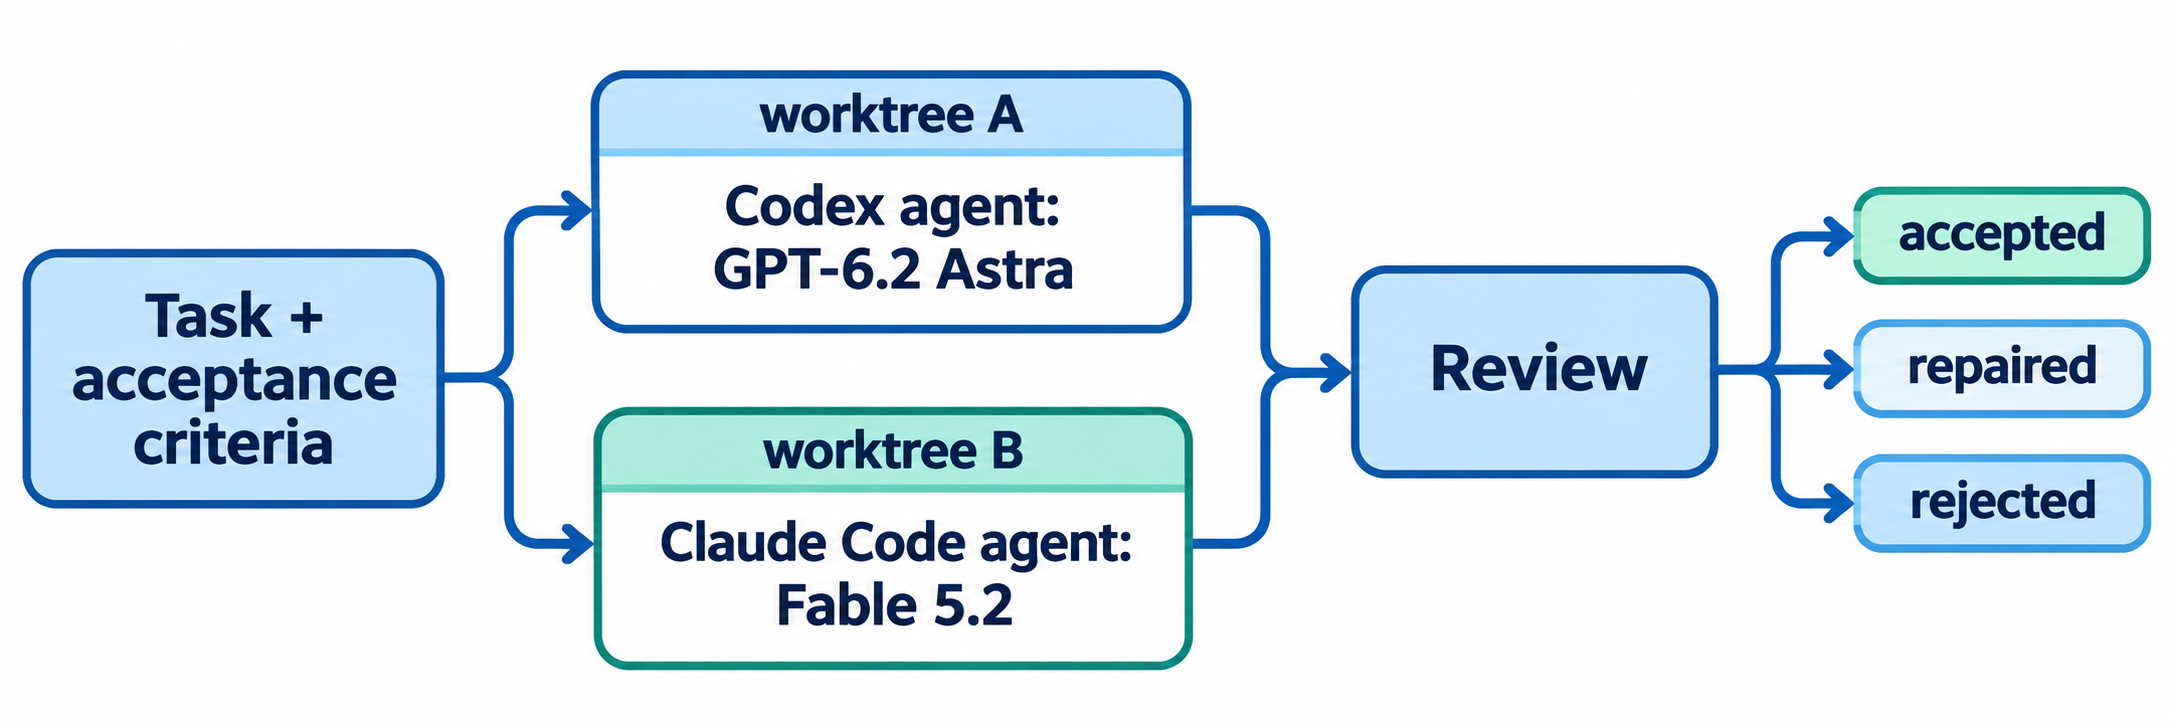
- Pilih 10 hingga 12 tugas terkini dari backlog Anda: perbaikan bug, penambahan kecil, satu refactor, dan satu investigasi.
- Tulis kriteria penerimaan terlebih dahulu, sebelum salah satu agent berjalan, agar tidak ada hasil yang membentuk standarnya.
- Tetapkan harness-nya. Astra berjalan paling baik di Codex dan Fable di Claude Code, jadi Anda membandingkan dua alur kerja lengkap. Sebutkan hal ini dalam laporan Anda.
- Tetapkan tingkat effort. Pilih High pada keduanya, atau sebutkan pengaturan persisnya yang Anda gunakan.
- Isolasi setiap percobaan dalam worktree git yang baru, agar tidak ada agent yang mewarisi editan agen lain.
- Jalankan setiap tugas pada kedua model, bergantian mana yang lebih dulu.
- Lakukan review secara buta jika memungkinkan, dan beri skor setiap hasil sebagai diterima, diterima setelah perbaikan, atau ditolak.
- Bagi total pengeluaran dengan perubahan yang diterima, termasuk percobaan yang gagal.
Biaya per perubahan yang diterima adalah angka yang menentukan. Model yang 20% lebih murah per token tetapi butuh satu siklus perbaikan tambahan per tugas adalah model yang lebih mahal bagi tim Anda.
Jalankan kedua model sebagai Agent di Sharkly
Sharkly menjalankan coding agent yang sudah Anda gunakan; Sharkly tidak menggantikannya. Agent di Sharkly adalah rekan AI yang dikonfigurasi untuk mengeksekusi Task melalui Runtime, seperti Codex atau Claude Code, pada Computer yang Anda hubungkan.
Siapkan duel dengan dua Agent:
- Astra Agent: Runtime Codex yang dikonfigurasi untuk
gpt-6.2-astra. - Fable Agent: Runtime Claude Code yang dikonfigurasi untuk
claude-fable-5-2.
Setiap Agent punya model default, yang dipilih di bagian Computer, Runtime, dan Working directory dari model yang dilaporkan Runtime-nya. Periksa pusat bantuan Sharkly untuk pengaturan Agent terkini.
Tetapkan batas run yang sama pada kedua Agent, agar tidak ada yang mendapat lebih banyak run paralel atau anggaran waktu yang lebih panjang dari yang lain.

Gunakan mode working-directory Temporary, agar setiap Task mendapat direktori terisolasi dan run yang didukung repositori dapat menyiapkan worktree baru. Letakkan kriteria penerimaan di deskripsi Task. Setiap Agent melaporkan patch dan pemeriksaannya kembali ke Task-nya sendiri, yang menjaga setiap percobaan dekat dengan putusan reviewer.
Penggunaan model tetap pada langganan dan kunci API Anda sendiri. Sharkly tidak menjual token, dan kuota model bergantung pada alat, paket, dan akun API yang dihubungkan tim Anda.
Alternatif selain memilih langsung antara Astra vs Fable
Anda tidak harus memahkotai satu model.
- Bagi berdasarkan jenis tugas. Gunakan Fable 5.2 pada kategori di mana ia menang dalam uji Anda, Astra pada sisanya.
- Pimpin dengan satu, isi staf dengan yang lain. Model frontier merencanakan dan mereview; model yang lebih murah mengerjakan bagian rutin, seperti pola dalam GPT-6 Astra sebagai pemimpin Crew Anda.
- Turunkan satu tingkat. GPT-6.2 Sol dipatok $2 input dan $10 output per juta token. Untuk pemeliharaan rutin, ia mungkin memenuhi standar Anda dengan seperempat harga.
- Pertahankan keduanya tetap aktif. Netralitas penyedia adalah intinya: tidak ada satu model pun yang tetap terbaik untuk waktu lama, seperti yang dikemukakan Argon, Astra, dan Opus.
Kasus penggunaan dunia nyata
- Migrasi panjang. Anthropic melaporkan tim agent Fable 5.2 memindahkan layanan produksi dari Python ke Rust. Uji pekerjaan semacam itu dengan potongan Anda sendiri sebelum Anda memercayakan pekerjaan itu ke salah satu model.
- Investigasi repositori besar. Lewati 272K token input dan harga Astra berubah. Jalankan model biaya pada ukuran konteks nyata Anda.
- Antrean bug paralel. Sepuluh perbaikan kecil yang dibagi ke kedua Agent memberi Anda tingkat perubahan yang diterima per model dalam waktu seminggu.
Kesimpulan
GPT-6.2 Astra dan Fable 5.2 berbiaya sama per token di atas kertas. Fable memiliki skor coding terpublikasi yang lebih kuat dan cache hit yang lebih murah; Astra memiliki jendela konteks yang sedikit lebih besar tetapi tarifnya lebih curam di atas 272K input. Tidak satu pun dari fakta itu memberi tahu Anda mana yang mengirim lebih banyak kode yang diterima di repositori Anda.
Jalankan duel-nya. Hubungkan satu Computer ke Sharkly, buatlah Codex Agent pada GPT-6.2 Astra dan Claude Code Agent pada Fable 5.2, lalu tugaskan keduanya lima tugas yang sama minggu ini. Pertahankan model yang menang dalam hal biaya per perubahan yang diterima.
FAQ
Apakah GPT-6.2 Astra lebih murah dari Claude Fable 5.2?
Tidak. Keduanya dipatok $8 per juta token input dan $40 per juta token output. Cache hit Fable lebih murah ($0,20 vs $0,40), dan tarif Astra naik di atas 272K token input.
Mana yang lebih baik untuk coding, GPT-6.2 Astra atau Fable 5.2?
Anthropic melaporkan skor agentic coding yang lebih tinggi untuk Fable 5.2 dibandingkan GPT-6 Astra sebelumnya. Tidak ada benchmark terpublikasi yang membandingkan Fable 5.2 secara langsung dengan GPT-6.2 Astra, jadi ujilah keduanya pada tugas Anda sendiri.
Berapa jendela konteks GPT-6.2 Astra dan Fable 5.2?
GPT-6.2 Astra mencantumkan 1.050.000 token dengan batas input 922.000 token. Fable 5.2 menyertakan konteks 1 juta token dengan harga standar. Keduanya membatasi output pada 128.000 token.
Bisakah saya menggunakan GPT-6.2 Astra di Claude Code atau Fable 5.2 di Codex?
Setiap model biasanya dijalankan di coding agent vendornya sendiri: Astra di Codex, Fable di Claude Code. Membandingkannya biasanya berarti membandingkan dua alur kerja lengkap, model plus harness.
Bagaimana cara membandingkan dua model coding secara adil?
Gunakan tugas yang sama, kriteria penerimaan tertulis, tingkat effort tetap, dan worktree yang terisolasi. Beri skor hasil yang diterima, diperbaiki, dan ditolak, lalu bagi total pengeluaran dengan perubahan yang diterima.
Apakah Sharkly memilih model untuk Agent saya?
Tidak. Anda memilih model default setiap Agent dari model yang dilaporkan Runtime-nya. Sharkly tidak merutekan tugas antar model secara otomatis.


