
TL;DR: Untuk memberikan suara pada agen AI Anda, tempatkan GPT-Live-1.1 milik OpenAI di depannya sebagai front end suara dan biarkan pekerjaan sesungguhnya tetap berjalan di agen yang sudah Anda kelola. GPT-Live mendengarkan sambil berbicara dan menyerahkan penalaran serta pemanggilan tool ke backend melalui delegasi. Dalam mode client delegation, aplikasi Anda menangkap setiap serah terima, memulai Sharkly Automation melalui webhook-nya, dan membacakan hasilnya kembali.
Apa itu GPT-Live-1.1?
GPT-Live-1.1 adalah model suara full-duplex dari OpenAI untuk percakapan multibahasa: ia bisa mendengarkan sambil berbicara, sehingga orang dapat memotongnya seperti mereka memotong pembicaraan seorang rekan kerja. Model ini berjalan di endpoint v1/live/sessions, mendukung function calling dan streaming, serta dapat mendelegasikan penalaran dan penggunaan tool ke agen backend alih-alih mengerjakannya sendiri.
Halaman model GPT-Live-1.1 milik OpenAI menyatakan bahwa model ini mentranskripsi ucapan lebih akurat dibandingkan GPT-Live-1 serta mempertahankan aksen dan suara yang lebih konsisten di berbagai bahasa. Input dan outputnya berupa audio dan teks. Model ini tidak menerima gambar secara langsung.
Bagian yang penting bagi tim agen adalah delegasi. Model suara ini dirancang untuk berbicara, bukan untuk menjalankan refaktorisasi selama 20 menit. Ia menyerahkan pekerjaan tersebut kepada pihak lain dan tetap menjaga percakapan berlanjut sambil menunggu.
Jika tim Anda sudah membagikan pekerjaan ke agen coding di board bersama, Sharkly bisa menjadi "pihak lain" tersebut. Panduan ini menunjukkan cara menghubungkannya.
Mengapa agen suara membutuhkan tim backend
Antarmuka suara memiliki anggaran latensi yang ketat. Orang mengharapkan jawaban dalam satu detik atau sekitar itu, dan keheningan lebih lama dari itu terasa seperti ada yang rusak. Pekerjaan agen yang sesungguhnya tidak muat dalam jendela waktu tersebut: membaca sebuah repositori, menjalankan pengujian, atau memprioritaskan antrean butuh waktu beberapa menit.
Jadi, agen suara yang mencoba mengerjakan semuanya sendiri akan gagal dengan salah satu dari dua cara: menjawab cepat tapi dangkal, atau terdiam sambil berpikir. Keduanya tidak berguna saat Anda sedang berjalan menuju rapat dan ingin tahu apakah pekerjaan agen semalam berhasil.
Solusinya adalah pemisahan yang mungkin sudah Anda gunakan untuk teks: front end yang cepat menangani percakapan, dan backend yang lebih lambat mengerjakan pekerjaannya. GPT-Live membangun pemisahan itu langsung di dalam API-nya. Jika Anda telah membaca tulisan kami tentang handoff agen-ke-agen dan agen-ke-manusia, ini adalah pola yang sama dengan tambahan mikrofon.
Cara kerja delegasi GPT-Live
GPT-Live memiliki dua mode delegasi, dipilih saat Anda membuat sesi. Untuk mengganti mode, Anda harus memulai sesi baru.
| Responses delegation | Client delegation | |
|---|---|---|
| Siapa yang menjalankan backend | OpenAI, melalui Responses API | Aplikasi Anda |
| Konfigurasi | delegation.type: "responses" ditambah model, instructions, tools |
delegation.type: "client" |
| Model backend | Yang Anda konfigurasikan, misalnya gpt-6-luna |
Apa pun yang bisa Anda panggil |
| Cara hasil dikembalikan | Ditangani untuk Anda | session.commentary.append atau session.thinking.append |
| Cocok untuk | Pencarian dan pemanggilan tool yang dapat dijalankan OpenAI | Pekerjaan yang berada di sistem Anda sendiri |
Responses delegation adalah jalur tercepat. Anda menentukan model backend, dan OpenAI menjalankannya dengan tool yang Anda daftarkan. Panduan delegasi menyarankan untuk memulai dengan gpt-6-luna dan mencoba gpt-6-sol untuk tugas backend yang lebih kompleks.
Client delegation adalah jalur untuk agen yang sudah Anda jalankan. Ketika model suara memutuskan bahwa ia butuh bantuan, aplikasi Anda menerima event session.delegation.created yang berisi delegation ID. Event tersebut tidak membawa kata-kata pengguna, sehingga aplikasi Anda harus menyusun ulang permintaan dari event transkrip dan state-nya sendiri. Setelah pekerjaan selesai, Anda mengirim hasilnya kembali dengan delegation ID yang sama dan GPT-Live mengucapkannya kembali dengan kalimat sendiri.
Polanya: GPT-Live berbicara, tim agen Anda bekerja
Berikut bentuk front end suara di atas Sharkly. Sharkly berada di atas agen coding Anda (Claude Code, Codex, Gemini CLI, dan lainnya) sebagai lapisan tempat pekerjaan ditugaskan, dijalankan di Computer yang terhubung, dan ditinjau. Model suara tidak pernah menyentuh repositori. Ia hanya meminta pekerjaan, dan board mencatatnya.
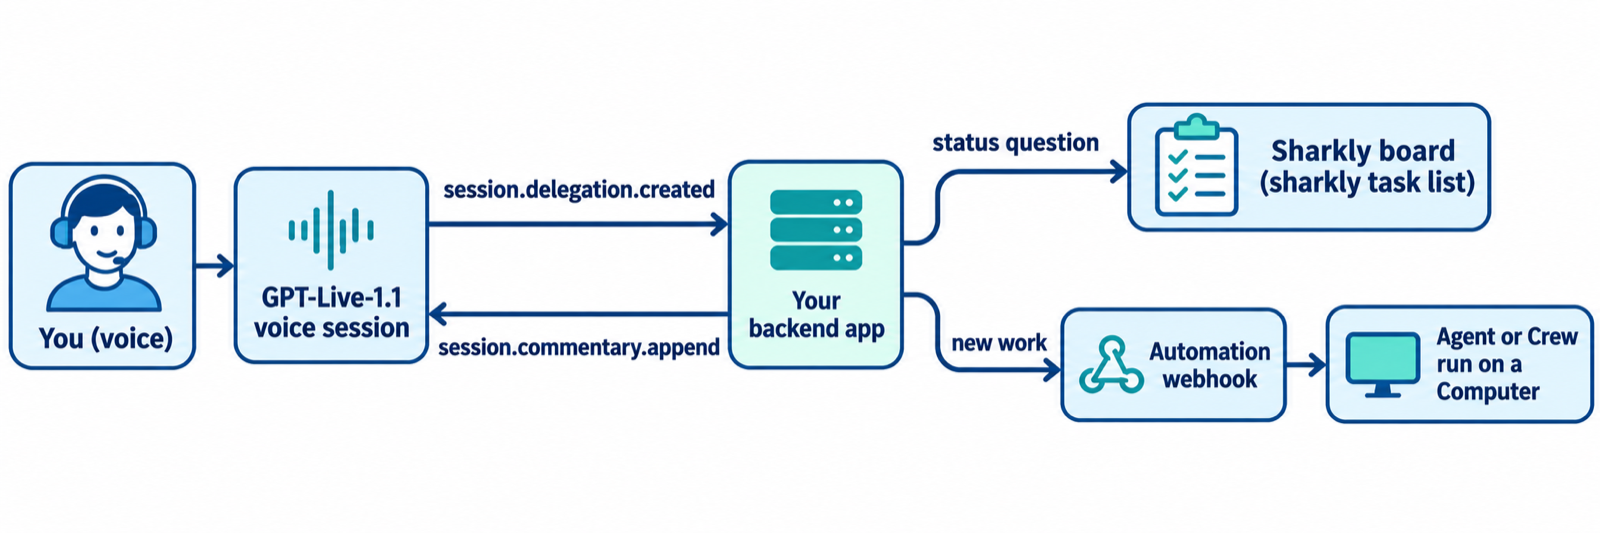
Tiga jenis permintaan mencakup sebagian besar hal yang orang tanyakan kepada agen suara tentang tim agen mereka:
- Pertanyaan status ("Apakah pengujian nightly lalu berhasil?"). Backend Anda membaca board dengan CLI
sharklydan menjawab dalam hitungan detik. - Pekerjaan baru ("Suruh satu agen memeriksa pengujian login yang sering gagal"). Backend Anda memanggil webhook Sharkly Automation, dan satu Agent atau Crew memulai run.
- Keputusan ("Merge saja"). Backend Anda menolak dan mengarahkan orang ke tempat peninjauan. Suara adalah tempat yang buruk untuk menyetujui perubahan.
Aturan ketiga tersebut adalah pilihan desain, bukan keterbatasan salah satu produk. Jawaban lisan "ya" mudah salah dengar dan sulit diaudit. Simpan persetujuan di tempat buktinya berada, seperti yang dibahas mendalam dalam panduan kami tentang human-in-the-loop coding agents.
Memberikan suara pada agen AI Anda: penyiapan langkah demi langkah
Langkah 1: Buat Automation dan trigger webhook-nya
Di Sharkly, Automation adalah definisi milik Space untuk pekerjaan Agent atau Crew yang dapat diulang: instruksi, penerima tugas, trigger, dan riwayat run. Trigger webhook membuat URL rahasia yang menerima permintaan POST dari layanan eksternal. Dokumentasi Automations mencatat bahwa URL lengkap hanya ditampilkan sekali, saat trigger dibuat atau dibuat ulang, jadi simpan sebagai secret segera.
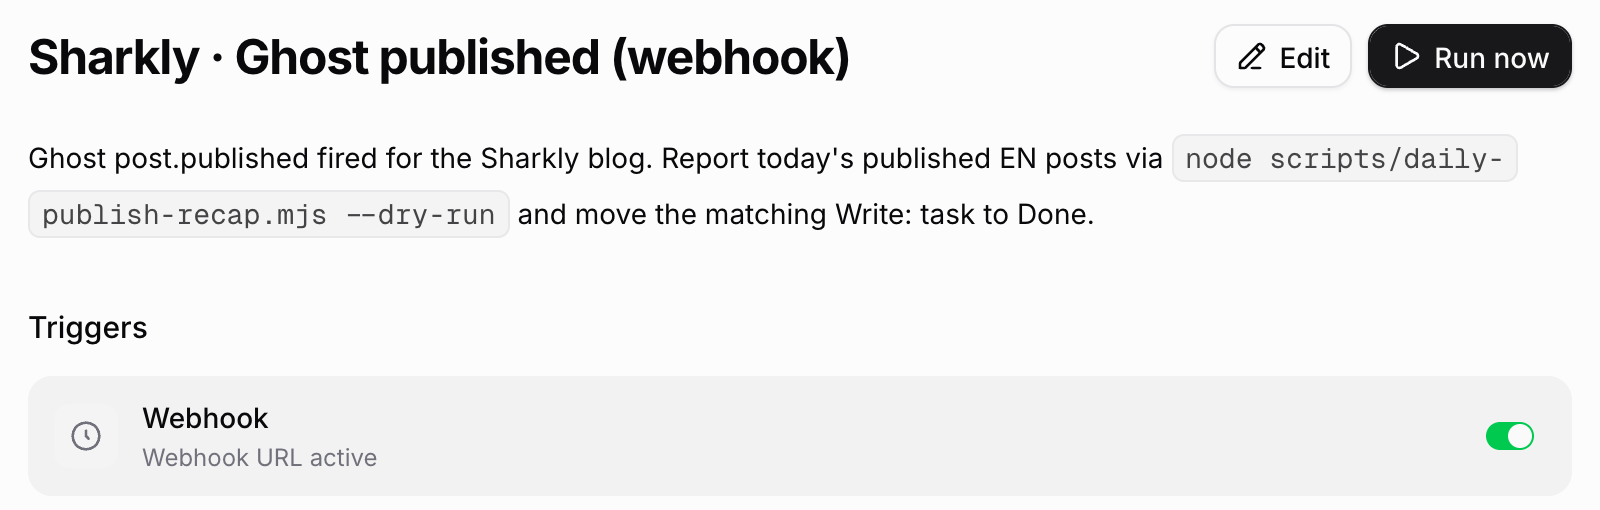
Tulis instruksinya agar Agent membaca permintaan dari payload trigger dan mencatat hasilnya sebagai komentar tugas. Nyatakan apa saja yang boleh diubahnya dan kapan manusia harus mengambil keputusan. Kemudian gunakan Run now untuk menguji Agent dan Computer-nya sebelum menghubungkan lalu lintas suara apa pun. Panduan kami tentang Automations di Sharkly menunjukkan jenis trigger lainnya.
Langkah 2: Buat sesi GPT-Live dalam mode client
Konfigurasi sesi Anda menentukan model suara dan mengaktifkan client delegation. Pengaturan acknowledgement_delay_ms memberi waktu bagi aplikasi Anda untuk mengirim pembaruan sendiri sebelum GPT-Live mengucapkan pengakuan generik.
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
OpenAI merekomendasikan WebRTC untuk audio di aplikasi browser, mobile, dan server, dengan WebSockets sebagai alternatif yang didukung. Panduan memulai GPT-Live membahas penyiapan koneksi.
Langkah 3: Arahkan setiap delegasi ke Sharkly
Saat session.delegation.created tiba, simpan delegation ID, susun ulang permintaan dari transkrip, dan tentukan jalur mana yang ditempuhnya. Sketsa Node berikut mengirim pekerjaan baru ke webhook Automation dan menjawab pertanyaan status dari board.
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
Perhatikan apa yang dijanjikan oleh balasan suara. Ia menyatakan bahwa sebuah run telah dimulai, bukan bahwa pekerjaan sudah selesai. Panduan OpenAI menyampaikan poin yang sama tentang pemesanan: hanya kirim hasilnya setelah aksi benar-benar berhasil.
Langkah 4: Baca hasilnya di board, bukan dengan telinga
Run agen membutuhkan waktu beberapa menit, dan sesi suara mungkin berakhir sebelum pekerjaannya selesai. Karena itu, board adalah catatannya. Agent mengirimkan hasilnya ke tugas, riwayat run menampilkan payload trigger dan output, dan seseorang meninjaunya di sana. Saat Anda bertanya "apa yang terjadi dengan pengujian yang sering gagal itu?", jalur status akan membacakan hasil tersebut untuk Anda.
Biaya dan batasan yang perlu direncanakan
| Item | GPT-Live-1.1 (dokumentasi OpenAI, 2026-11-20) |
|---|---|
| Endpoint | v1/live/sessions |
| Sesi aktif | $0,05 per menit |
| Standby | $0,02 per menit (sesi WebRTC saat inferensi dijeda) |
| Penagihan | Berdasarkan durasi; halaman harga OpenAI menyatakan GPT-Live ditagih per detik |
| Sesi bersamaan | Batasan terpisah dari GPT-Live-1; lihat halaman batasan organisasi Anda |
| Panggilan backend | Ditagihkan sesuai tarif normal model yang dikonfigurasikan |
Check-in standup 10 menit berbiaya $0,50 untuk waktu suara pada tarif aktif, belum termasuk panggilan backend. Sebagai perbandingan, halaman model GPT-Live-1 mencantumkan 50, 300, dan 500 sesi bersamaan pada tingkat Build, Launch, dan Grow, serta tidak ada akses pada tingkat Free. GPT-Live-1.1 memiliki batasannya sendiri.
Run agen di sisi Sharkly ditagihkan ke paket Claude Code, Codex, atau API yang sudah terhubung ke setiap Runtime. Sharkly tidak menjual token. Jika Anda mengarahkan pertanyaan status ke model backend yang murah, catatan kami tentang menjalankan agen GPT-6 Luna di Sharkly berlaku langsung.
Pengaman yang layak ditambahkan sejak hari pertama
- Interupsi tidak membatalkan pekerjaan. Panduan OpenAI menyatakan bahwa memotong percakapan lisan tidak menghentikan pekerjaan backend. Jika seseorang berkata "sudah saja", backend Anda harus menanganinya, jika tidak, run akan terus berjalan.
- Perlakukan URL webhook seperti kata sandi. Dokumentasi Sharkly menggambarkannya sebagai bearer secret secara default. Tambahkan signing secret dan buat ulang URL jika bocor.
- Batasi cakupan Automation. Mulailah dengan pekerjaan yang dapat diamati dan dapat dibatalkan, seperti yang disarankan dokumentasi Sharkly, dan tinjau beberapa run sebelum memperluasnya.
- Simpan delegasi Crew di dalam Sharkly. Jika satu permintaan membutuhkan beberapa agen, arahkan webhook ke Sharkly Crew dan biarkan leader-nya membagi pekerjaan.
Kapan front end suara bukan alat yang tepat
Hindari penggunaannya ketika permintaan memerlukan diff, log, atau tangkapan layar untuk dipahami. Suara tidak bisa menunjukkan pengujian yang gagal. Ini juga bukan kanal yang tepat untuk apa pun yang memerlukan tanda tangan: persetujuan, deployment, dan perubahan akses seharusnya berada di tugas tempat buktinya berada.
Suara menunjukkan nilainya untuk pemeriksaan status cepat, memulai run yang terdefinisi dengan baik, dan saat tangan sedang sibuk. Anggap itu sebagai remote control untuk board agen Anda, bukan penggantinya.
Kesimpulan
GPT-Live-1.1 menangani bagian dari agen suara yang sulit dibangun sendiri: percakapan full-duplex dengan interupsi. Delegasi menyerahkan semua hal lainnya ke backend. Letakkan tim agen yang sudah ada di belakang backend tersebut, dan Anda dapat bertanya tentang run dan memulai run baru secara lisan, sementara setiap hasil tetap masuk ke board yang ditinjau oleh manusia.
Langkah Anda berikutnya: buat satu Automation dengan trigger webhook di Sharkly, uji dengan Run now, lalu arahkan sesi GPT-Live mode client ke sana. Dokumentasi Sharkly membahas Agents, Computers, dan Automations secara mendetail.
FAQ
Bagaimana cara memberikan suara pada agen AI saya?
Tempatkan model suara seperti GPT-Live-1.1 di depan agen dan biarkan ia mendelegasikan. Model suara menangani mendengarkan dan berbicara, sementara backend Anda menjalankan agen dan mengembalikan hasil singkat untuk diucapkan oleh model suara.
Apakah GPT-Live-1.1 tersedia di API?
Ya. OpenAI mencantumkan gpt-live-1.1 dengan endpoint v1/live/sessions, function calling, dan streaming. Model ini tidak mendukung v1/realtime atau v1/responses secara langsung.
Berapa biaya GPT-Live-1.1?
OpenAI mencantumkan $0,05 per menit untuk sesi aktif dan $0,02 per menit dalam mode standby. Panggilan model backend melalui delegasi ditagihkan terpisah sesuai tarif normalnya.
Apa perbedaan antara Responses delegation dan client delegation?
Pada Responses delegation, OpenAI menjalankan model backend yang Anda konfigurasikan. Pada client delegation, aplikasi Anda menerima setiap permintaan dan mengembalikan hasilnya dengan session.commentary.append atau session.thinking.append.
Apakah GPT-Live-1.1 bisa menjalankan agen coding secara langsung?
Tidak. Ia hanya mendelegasikan. Backend Anda yang menentukan apa yang dijalankan, misalnya dengan memanggil webhook Sharkly Automation yang memulai run Agent atau Crew di Computer yang terhubung.
Apa yang terjadi jika saya memotong agen suara di tengah tugas?
Percakapan berhenti, tetapi pekerjaan backend tidak. Tangani pembatalan di backend Anda, misalnya dengan menjeda run atau memberi komentar pada tugas.


