Ringkasan: Harga GPT-6.2 adalah $8 per juta token input dan $40 per juta token output untuk Astra, serta $2 dan $10 untuk Sol. Pembacaan input yang di-cache berharga $0,40 dan $0,10. Satu contoh tugas agen 20 giliran berbiaya sekitar $3,23 di Astra dan $0,81 di Sol dengan prompt caching berfungsi, dan empat kali lipatnya tanpa caching.
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 17 November 2026. Astra adalah model frontier untuk pekerjaan paling berat. Sol adalah model sehari-hari, dan halaman modelnya menyatakan bahwa model ini dibuat untuk "menjalankan agen dalam skala besar."
Harga per juta token tidak banyak memberi gambaran tentang berapa yang akan dibelanjakan tim agen. Agen mengirim ulang konteksnya di setiap giliran, sehingga tagihan bergantung pada caching, panjang konteks, dan berapa banyak agen yang berjalan bersamaan. Panduan ini mengubah daftar harga GPT-6.2 menjadi angka per tugas dan per bulan, lalu menunjukkan batasan yang membuatnya tetap terprediksi. Jika Anda sudah menjalankan agen coding secara berdampingan, Sharkly adalah tempat Anda mengatur batasan tersebut per Agent.
Harga GPT-6.2 untuk Astra dan Sol
Berikut adalah daftar harga API standar dari halaman model Astra dan halaman model Sol, dicek pada 20 November 2026. Semua harga per juta token.
| Harga per 1 juta token | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Input | $8.00 | $2.00 |
| Input ter-cache (pembacaan) | $0.40 | $0.10 |
| Penulisan cache (retensi 30 menit) | $10.00 | $2.50 |
| Penulisan cache (retensi 12 jam) | $20.00 | $5.00 |
| Output | $40.00 | $10.00 |
| Context window | 1.050.000 | 1.050.000 |
Sol berharga tepat seperempat Astra di setiap baris. Kedua model memiliki context window dan rate limit yang sama, sehingga harga-lah yang membedakannya dalam tagihan.
Aturan harga yang mengubah total
Lima aturan di halaman model memengaruhi tagihan agen lebih besar daripada tarif utamanya:
- Biaya tambahan konteks panjang. Permintaan dengan lebih dari 272K token input membayar dua kali lipat untuk input dan cache, serta 1,5 kali lipat untuk output, pada seluruh permintaan.
- Penulisan cache berbiaya tambahan. Menulis prefix ke cache berharga 1,25 kali input normal untuk 30 menit, atau 2,5 kali untuk 12 jam.
- Pembacaan cache murah. Di GPT-6.2, pembacaan cache berharga 0,05 kali input normal, menurut panduan prompt caching OpenAI.
- Batch berharga 50 persen dari tarif standar.
- Kecepatan berbiaya lebih. Mode Fast berharga 2 kali tarif standar. Ultrafast berharga 3 kali hingga 28 Februari 2027, dan 6 kali mulai 1 Maret 2027.
GPT-6.2 tidak mendukung Flex processing. Penggantinya adalah jendela penyelesaian latar belakang dengan diskon, yang dibahas di bawah.
Berapa biaya satu tugas agen di GPT-6.2
Ambil satu contoh tugas coding: 20 giliran, 60.000 token input per giliran, dan 2.000 token output per giliran. Itu berarti 1,2 juta token input dan 40.000 token output untuk seluruh tugas. Angka Anda akan berbeda, jadi ganti dengan angka Anda sendiri.
| Skenario | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Tanpa cache hit | $11.20 | $2.80 |
| 90 persen cache hit | $3.23 | $0.81 |
| 90 persen cache hit, jendela latar belakang 8 jam | $1.94 | $0.49 |
Baris dengan cache mengasumsikan 90 persen input dibaca dari cache dan 10 persen sisanya ditagih sebagai penulisan cache 30 menit. Itu adalah skenario paling pesimistis, sehingga eksekusi yang benar-benar di-cache seharusnya berada di atau di bawah angka-angka ini.
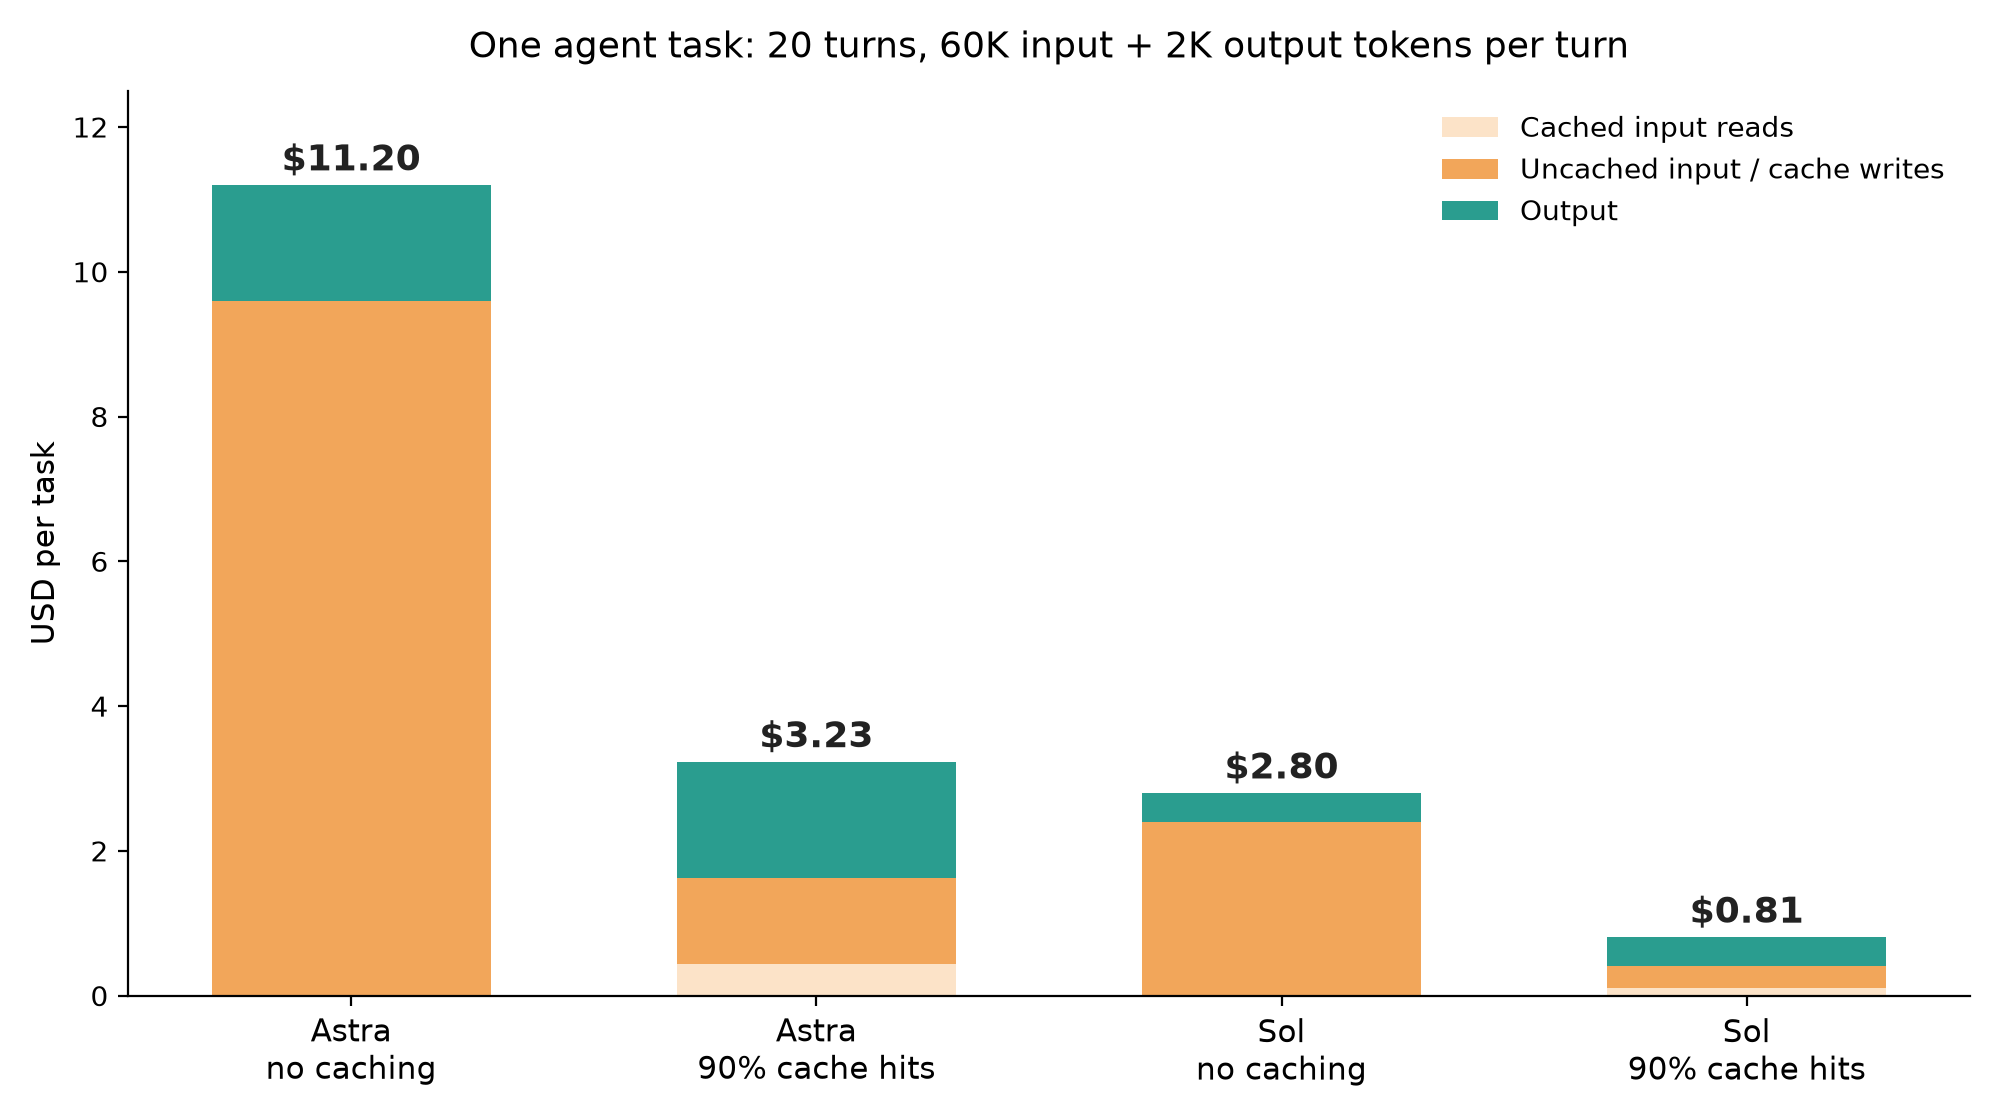
Dua angka menonjol. Caching memangkas biaya tugas sekitar 71 persen di kedua model. Dan satu tugas Astra yang di-cache hanya sedikit lebih mahal daripada satu tugas Sol tanpa cache. Model murah dengan cache yang rusak hampir sama mahalnya dengan model mahal yang cachanya berfungsi.
Di mana biaya tambahan konteks panjang menggigit
Agen coding yang membaca separuh repositori bisa melewati 272K token input per giliran. Bandingkan dua giliran Sol, keduanya dengan 2.000 token output dan tanpa cache:
- 270.000 token input: $0,54 input plus $0,02 output, total $0,56.
- 300.000 token input: $1,20 input plus $0,03 output, total $1,23.
Konteks 11 persen lebih besar berbiaya lebih dari dua kali lipat. Jika harness agen Anda memampatkan konteks, jaga agar tetap di bawah 272K. Logika yang sama ada di balik tulisan kami tentang mengapa model murah bisa lebih mahal: harga per perubahan yang diterima lebih penting daripada harga per token.
Biaya GPT-6.2 untuk tim agen per bulan
Sekarang skala-kan angka dengan cache. Katakanlah lima agen masing-masing menyelesaikan 8 tugas per hari selama 22 hari kerja. Itu 880 tugas per bulan.
| Konfigurasi tim | Tugas per bulan | Biaya model bulanan |
|---|---|---|
| Kelima agen di Astra | 880 | $2,842 |
| Satu Astra sebagai lead, empat agen Sol | 176 + 704 | $1,139 |
| Kelima agen di Sol | 880 | $713 |
Konfigurasi campuran berbiaya 60 persen lebih murah daripada semua-Astra. Konfigurasi ini menempatkan model frontier pada perencanaan dan review sulit, serta mengirim pekerjaan rutin ke Sol. Kami membahas peran lead di GPT-6 Astra sebagai leader Crew Anda, dan penalaran yang sama mendorong anggaran sama, agen lebih banyak dengan GPT-6 Sol.
Harga hanyalah satu batasan. Token per menit bisa menghentikan tim agen sebelum uang habis pada tier penggunaan yang lebih rendah, yang dibahas tuntas di panduan rate limit GPT-6.2 tier demi tier.
Paket Codex versus API key
Jika agen Anda menjalankan Codex pada paket ChatGPT, Anda tidak membayar per token. Anda menghabiskan jatah. Halaman harga Codex memperkirakan 6 hingga 50 pesan lokal per jendela lima jam untuk GPT-6.2 Astra di paket Plus dan Standard Business, serta 17 hingga 180 untuk Sol. Sesi panjang menguras jatah lebih cepat, sehingga perhitungan token di atas tetap memprediksi tugas mana yang habis lebih dulu.
Panduan GPT-6.2 Codex kami membahas setup untuk kedua model.
Cara memangkas biaya GPT-6.2 untuk tim agen
Urutan di bawah memindahkan uang terbanyak lebih dulu:
- Buat caching berfungsi. Letakkan instruksi yang stabil dalam pesan
developerdi awal input, dan jangan pernah menulis ulang giliran sebelumnya. Prefix yang berubah berarti cache miss. - Gunakan Sol sebagai default. Promosikan tugas ke Astra hanya jika tugas tersebut melewati batas layanan atau Sol gagal dua kali pada jenis tugas yang sama.
- Tetap di bawah 272K token input per permintaan.
- Dorong pekerjaan massal ke jendela latar belakang saat memanggil API dari harness Anda sendiri.
- Gunakan Batch untuk eval dan pekerjaan offline, bukan untuk agen interaktif.
- Biarkan Fast dan Ultrafast mati kecuali ada yang menunggu hasilnya.
Jendela latar belakang berdiskon menggantikan Flex
Panduan mode latar belakang OpenAI mencantumkan dua jendela penyelesaian berdiskon untuk Responses API, dalam beta publik di GPT-6.2: 2h dengan diskon 30 persen dan 8h dengan diskon 40 persen. Keduanya berbagi rate limit Batch, bukan limit token live Anda.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
Polling response ID nanti, atau gunakan webhook. Ini cocok untuk pembuatan test, peningkatan dependency, dan penyempurnaan dokumentasi yang tidak dibutuhkan siapa pun sebelum pagi hari.
Kendalikan pengeluaran GPT-6.2 per Agent di Sharkly
Sharkly tidak menjual ulang token. Setiap eksekusi ditagihkan ke paket Codex atau API key yang sudah terpasang di Runtime, sehingga faktur OpenAI Anda tetap menjadi satu-satunya sumber kebenaran. Yang diberikan Sharkly adalah kendali atas seberapa banyak pekerjaan yang masuk ke faktur tersebut.
Setiap Agent memiliki baris Default model yang mencantumkan model yang dilaporkan oleh Runtime-nya. Atur Agent rutin Anda ke Sol dan Agent lead Anda ke Astra. Saat satu tugas membutuhkan lebih, dokumentasi Sharkly menjelaskan override per tugas: arahkan kursor ke Agent di pemilih Assignee dan pilih model hanya untuk eksekusi itu.
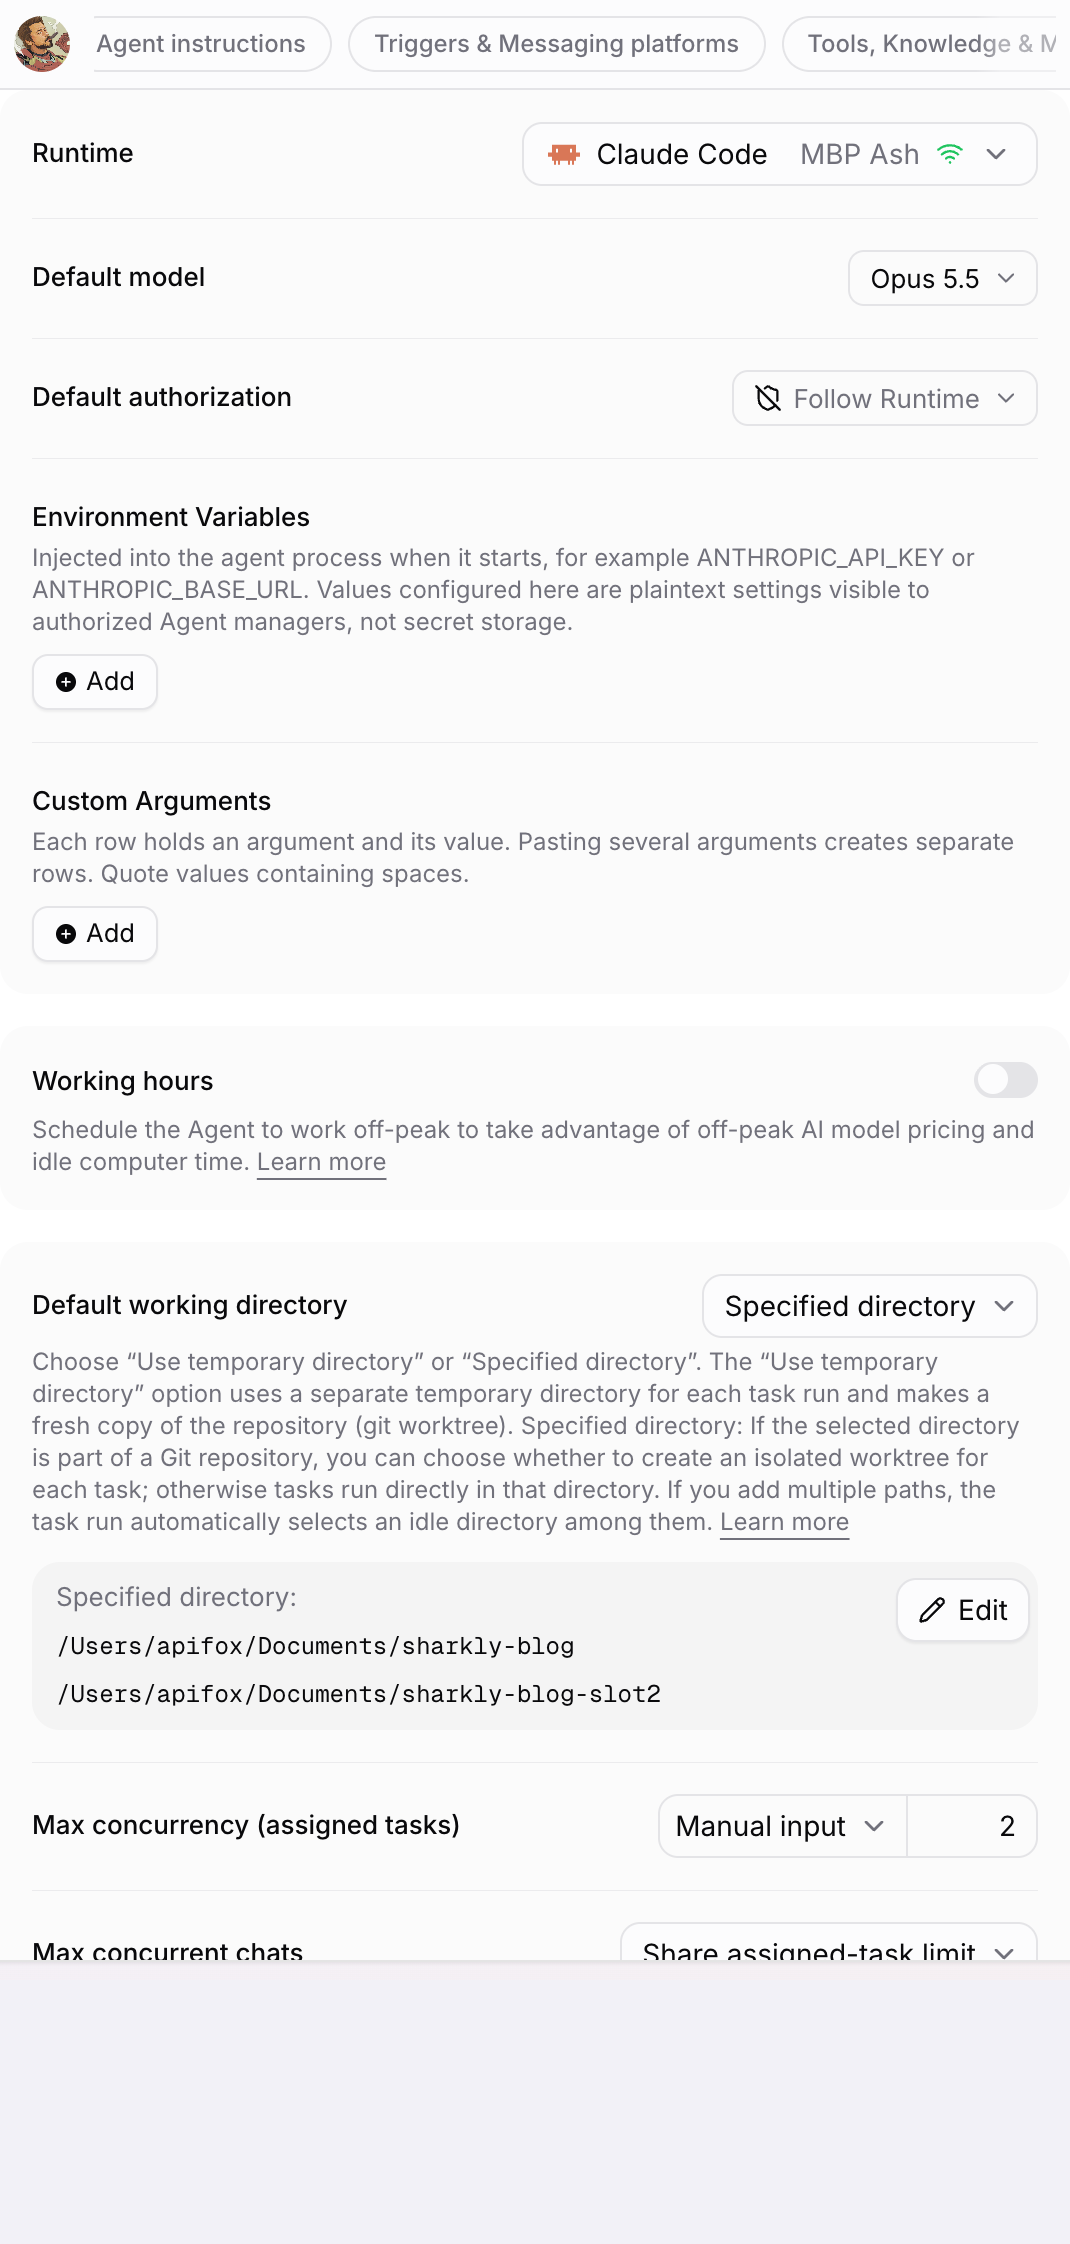
Panel yang sama memuat Environment Variables, yang disuntikkan ke proses agen saat mulai. Beri setiap grup Agent API key dari proyek OpenAI-nya masing-masing, dan halaman penggunaan OpenAI Anda akan memisahkan pengeluaran per grup. Working hours menjadwalkan Agent ke jendela di luar jam sibuk, sehingga tugas massal berjalan pada malam hari dan menyisakan kapasitas siang hari untuk orang-orang yang sedang menunggu.
Pengeluaran juga butuh batas atas. Max concurrency membatasi berapa banyak tugas yang dijalankan satu Agent sekaligus, Max run duration menghentikan eksekusi yang berulang tanpa henti, dan Queue timeout membuang pekerjaan yang menunggu terlalu lama.
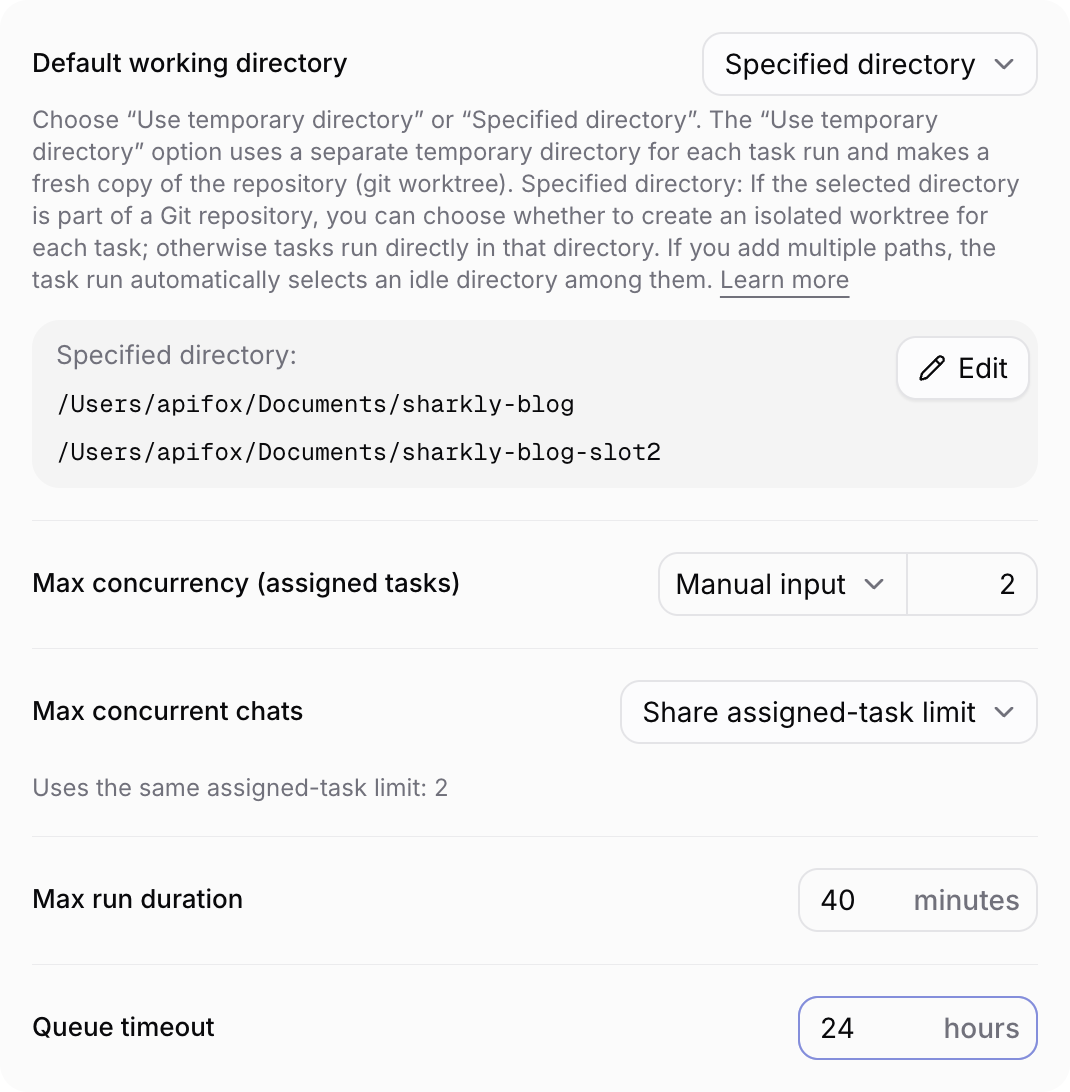
Batas eksekusi 40 menit pada Agent Sol membatasi skenario terburuk. Daftar eksekusi di setiap Agent menunjukkan token yang digunakan setiap eksekusi, sehingga Anda bisa menemukan jenis tugas yang membakar tiga kali lipat token dibanding yang lain. Tugas itu membutuhkan deskripsi yang lebih ketat atau model yang lebih murah.
Kesimpulan
Harga GPT-6.2 terlihat sederhana: Astra berharga empat kali Sol di setiap baris. Tagihan agen tidak sederhana. Caching menggeser biaya tugas sekitar 71 persen, ambang 272K bisa menggandakan satu giliran, dan konkurensi melipatgandakan semuanya. Ukur satu tugas nyata, tingkatkan cache hit rate Anda, taruh pekerjaan rutin di Sol, dan batasi apa yang berjalan sekaligus.
Coba dulu pada satu Agent. Hubungkan sebuah Computer, buat Agent Codex di GPT-6.2 Sol, atur Max concurrency ke 2 dan Max run duration ke 40 menit, lalu tetapkan satu tugas rutin padanya. Setelah itu, baca token pada eksekusinya. Lebih lanjut tentang menjalankan tim secara berdampingan di cara menjalankan 10 agen coding AI sekaligus.
FAQ
Berapa harga GPT-6.2?
GPT-6.2 Astra berharga $8 per juta token input dan $40 per juta token output. GPT-6.2 Sol berharga $2 dan $10. Pembacaan input ter-cache berharga $0,40 di Astra dan $0,10 di Sol.
Apakah GPT-6.2 Sol lebih murah daripada Astra?
Ya. Sol berharga seperempat Astra untuk input, output, pembacaan cache, dan penulisan cache. Keduanya memiliki context window 1.050.000 token dan rate limit yang sama.
Berapa harga konteks panjang GPT-6.2?
Permintaan di atas 272K token input membayar dua kali lipat untuk input dan cache, serta 1,5 kali lipat untuk output, pada seluruh permintaan, bukan hanya token di atas ambang batas.
Apakah GPT-6.2 mendukung Flex processing?
Tidak. OpenAI mengarahkan pekerjaan jangka panjang ke jendela penyelesaian latar belakang berdiskon: 2h dengan diskon 30 persen dan 8h dengan diskon 40 persen, dalam beta publik.
Berapa harga GPT-6.2 Batch?
Batch berharga 50 persen dari tarif standar di kedua model. Cocok untuk eval dan pekerjaan offline, bukan untuk agen interaktif.
Apakah Sharkly mengenakan biaya untuk token GPT-6.2?
Tidak. Sharkly menjalankan agen coding yang sudah Anda gunakan, dan penggunaan model ditagihkan ke paket Codex atau API key Anda sendiri. Sharkly mengontrol model mana yang digunakan setiap Agent dan berapa banyak tugas yang berjalan sekaligus.