
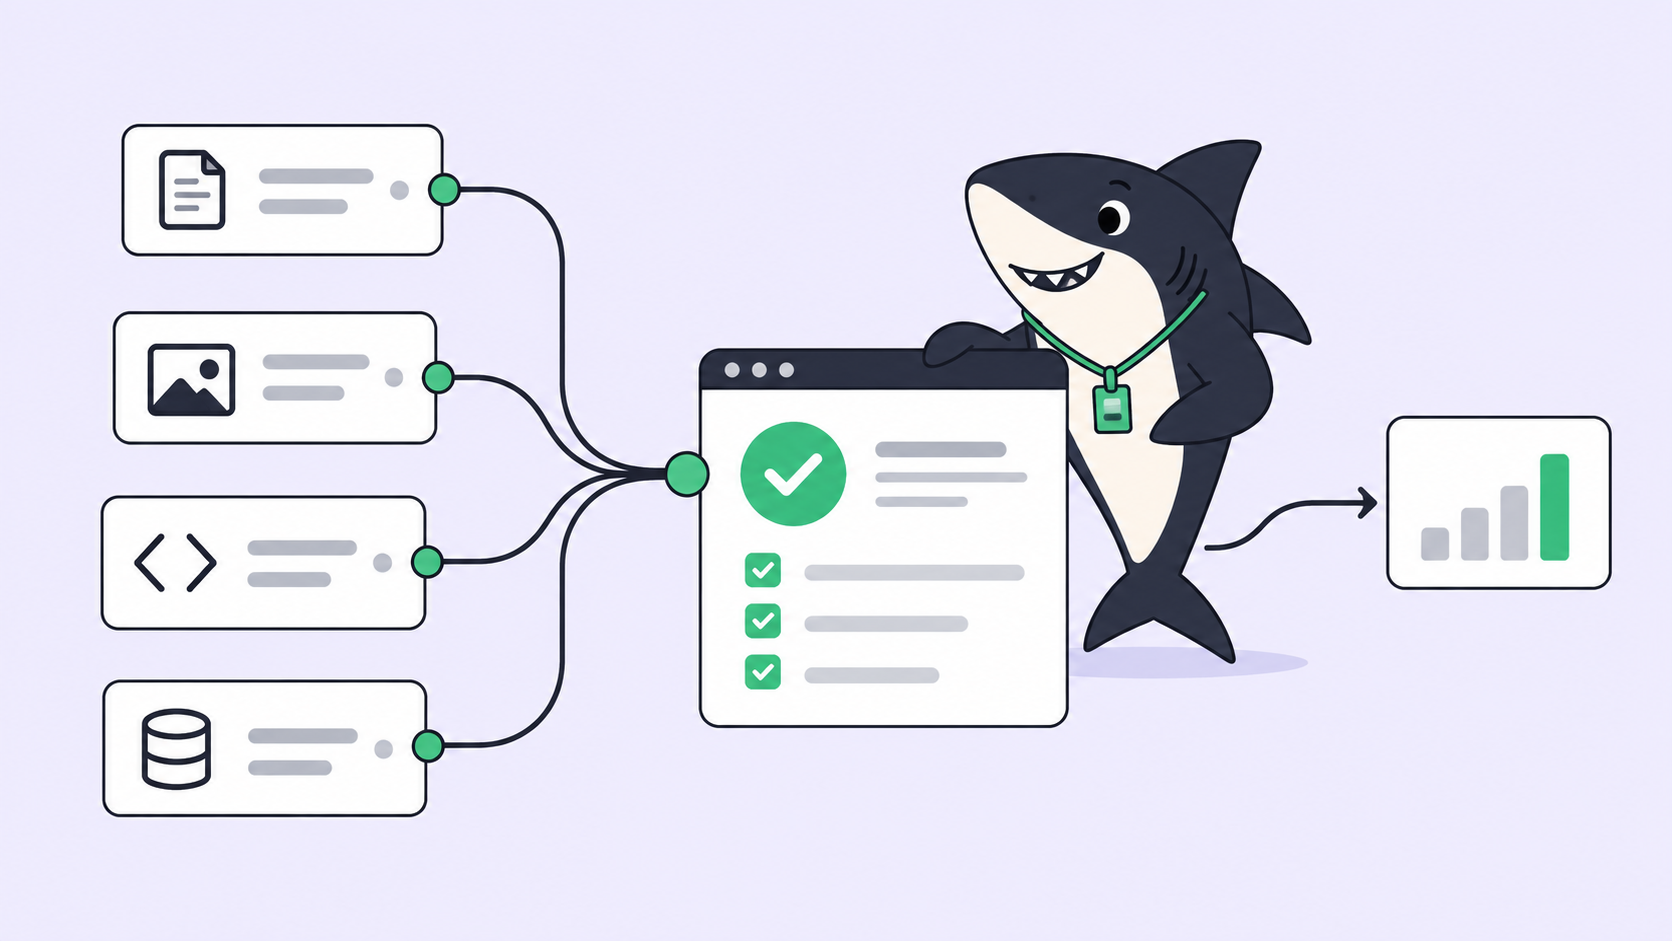
Tabel harga per 2026-09-22 menunjukkan pola yang sudah jelas. Tempatkan GPT-6 Luna di $0.10 per juta token input untuk pekerjaan yang tidak disukai siapa pun, tempatkan Claude Opus 5.5 di $4 pada Agent yang memeriksanya, dan Anda tetap mempertahankan sebagian besar throughput dengan sebagian kecil biaya. Banyak tim sedang merangkainya minggu ini, dan sebagian besar akan membangun sesuatu yang tampak seperti review padahal bukan.
Kegagalannya bukan pada salah satu model. Kegagalannya ada pada apa yang melintasi celah di antara keduanya. Reviewer yang membaca ringkasan pekerja tentang pekerjaannya sendiri sedang membaca sebuah klaim, dan satu-satunya hal yang bisa ia kembalikan adalah penilaian atas klaim tersebut. Diff-nya lolos, kata worker itu. Kelihatannya bagus, kata reviewer. Seseorang menyetujuinya karena dua model sepakat, dan itu adalah jenis kesepakatan yang paling minim informasi.
Jadi pertanyaan yang menarik dalam Crew multi-model bukanlah model mana yang ditempatkan di mana. Melainkan apa yang harus dibawa oleh handoff.
Apa itu Crew multi-model
Crew multi-model adalah sekelompok Agent yang Runtime-nya dipilih per peran, bukan per tim, dan setidaknya ada satu peran yang hanya bertugas memeriksa output Agent lainnya.
Agent reviewer bukanlah sebuah persetujuan. Ia adalah pendapat kedua yang memiliki biaya, dihasilkan sebelum manusia melihat, sehingga manusia hanya membaca daftar yang lebih pendek. Agent meneliti, mengeksekusi, menguji, dan melaporkan. Manusia menetapkan arah, memberikan wewenang, dan menerima hasilnya. Menambahkan model mahal di tengah kalimat itu tidak mengubah klausa terakhirnya.
Tiga tingkatan, seperti yang dipublikasikan para vendor
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| ID API | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Input / output per 1 juta | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| Input cached | $0.20 baca, $5 tulis | Diskon 90% untuk pembacaan | Diskon 90% untuk pembacaan |
| Konteks | 1M | 872k | 1M |
OpenAI menyebut Sol dan Luna 50% lebih murah daripada harga promosi GPT-5.6, dan "promosi" adalah kata yang perlu digarisbawahi: baseline-nya sudah berupa tarif diskon. OpenAI juga menyatakan GPT-6 Astra "tetap menjadi model terbaik kami di semua lini".
Satu peringatan sebelum ada yang membaca peringkat dari pembagian itu. Posting peluncuran OpenAI membandingkan Sol dan Luna dengan Claude Opus 5, karena Opus 5.5 belum ada saat posting itu ditulis dan baru dirilis beberapa jam kemudian dengan biaya operasional 40% lebih murah daripada Opus 5 menurut pengakuan Anthropic sendiri. Belum ada yang mengulang perbandingan itu, dan kedua vendor tidak memakai harness yang sama. Pilih peran berdasarkan harga dan perilaku yang Anda amati di repositori Anda sendiri.
Apa yang masing-masing vendor katakan tentang modelnya sendiri sudah cukup untuk menetapkan peran. Untuk Luna, OpenAI melaporkan 66.6% pada DeepSWE 1.1 dengan reasoning effort maksimum, 93% lebih murah per tugas dibanding Claude Opus 5 dan 96% lebih murah dibanding Fable 5, serta pada effort lebih tinggi menghasilkan skor faktualitas yang setara GPT-5.6 Sol dengan biaya sekitar seperseratusnya. Itu model yang bisa Anda arahkan ke volume pekerjaan. Untuk Opus 5.5, Anthropic melaporkan 66.4% pada Terminal-Bench 4.0, 54.4% pada FrontierCode v1.1, 81.8% pada OSWorld 2.0, output maksimum 128k, dan mampu bertahan pada sebuah tugas selama 18 jam atau lebih. Itu model yang bisa Anda andalkan untuk menilai.
Membaca adalah separuh murah dari model mahal
Alasan pola ini bertahan saat berhadapan dengan tagihan adalah caching, dan asimetrinya yang menentukan desainnya.
Pembacaan input cached Opus 5.5 adalah $0.20 per juta. Itu seperduapuluh dari tarif input tanpa cache-nya sendiri dan dua kali tarif tanpa cache Luna. Output-nya $20 per juta, empat puluh kali lipat $0.50 milik Luna. Jadi reviewer yang membaca dalam jumlah sangat besar dan menulis dua puluh baris hampir gratis, sedangkan yang bercerita panjang lebar tidak.
Dari situ Anda mendapat aturan yang didukung bukti: reviewer membaca semuanya dan hampir tidak mengatakan apa pun. Berikan padanya prefix repositori, konvensi, diff, dan packet di bawah ini, lalu batasi apa yang ia kembalikan.
Sisi worker juga melakukan caching. GPT-6 meningkatkan hit rate secara default dengan diskon 90% untuk pembacaan input cached, menambahkan breakpoint eksplisit sehingga Anda bisa menentukan di mana prefix cached berakhir, dan tidak lagi membatalkan cache ketika Anda mengubah reasoning effort atau ketersediaan tool. GitHub melaporkan lebih dari 50% lebih sedikit token prompt yang perlu diproses ulang dari miliaran permintaan. Untuk sekumpulan worker Luna yang membaca ulang repositori yang sama sepanjang hari, itu adalah sebagian besar dari tagihannya.
Apa yang harus dibawa oleh handoff
Inilah artefaknya, sebuah template handoff yang dirancang untuk pembaca berupa model. Worker mengembalikannya ke Task saat berhenti, dan reviewer hanya membaca ini plus diff-nya.
SH-312  Add retry with backoff to the webhook sender
Worker:   Agent "backend-worker" - Runtime Codex on gpt-6-luna
Attempts: 2 (attempt 1 failed on lint)
Diff:     4 files, +118 / -12   (worktree sh-312, commit a91f4c2)

Commands run, verbatim:
  $ pnpm lint            exit 0
  $ pnpm typecheck       exit 0
  $ pnpm test -- sender  exit 0   14 passed, 0 failed, 3 skipped
  $ pnpm build           exit 0

Not done:
  - The 3 skipped tests need a live webhook endpoint. Not run.
  - Did not touch the queue consumer, which has the same bug.

Assumptions made:
  - Max 5 retries, ceiling 30s. No spec said. Copied the values
    already used in payments/retry.ts.

Stopped because: acceptance criteria met.
Ada empat sifat yang membuat packet itu sepadan dengan token yang dihabiskannya.
Isinya artefak, bukan narasi. Perintah dan exit code bisa dijalankan ulang. "Saya sudah memverifikasi perilakunya" tidak bisa diperiksa oleh siapa pun.
Isinya menyatakan apa yang tidak dikerjakan. Tes yang dilewati dan consumer yang tidak disentuh adalah dua hal yang akan dihilangkan oleh sebuah ringkasan, dan justru itu dua hal yang paling dibutuhkan reviewer. Mintalah hal-hal yang absen secara eksplisit, kalau tidak ringkasan yang rapi tidak akan memuatnya.
Isinya mencatat asumsi. Setiap Task yang dibatasi memuat keputusan yang tidak diambil oleh spesifikasi. Kalau ditulis, itu menjadi item review. Kalau dihilangkan, itu menjadi kejutan di produksi sebulan kemudian.
Isinya menyebutkan alasan berhenti. Selesai, terblokir, kehabisan anggaran, dan gagal dua kali terlihat identik di repositori tetapi berarti hal yang berbeda di board.
Apa yang dikembalikan reviewer
REVIEWER  Agent "review" - Runtime Claude Code on claude-opus-5-5
Reads:  repository prefix (cached), the packet, the full diff
Writes: at most 20 lines

VERDICT      changes requested
CHECKED      4 commands re-run, all exit 0. Backoff ceiling honoured.
UNVERIFIED   3 skipped tests. No evidence the retry path ever runs.
BLOCKING     Retry wraps the 4xx branch. A 422 will be retried 5 times.
FOR A PERSON Queue consumer has the same bug and is out of scope.
             Split SH-312, or widen it?
Baris UNVERIFIED-lah yang membuat reviewer layak dibayar mahal. Worker murah tidak akan memberi tahu Anda klaim mana yang tidak berdasar sama sekali, sebagian karena ia memang tidak mengetahuinya. Model mahal yang membaca packet terstruktur dapat memisahkan apa yang ia konfirmasi dari apa yang ia terima begitu saja, dan pemisahan itulah hasil dari langkah review. Baris FOR A PERSON adalah separuh lainnya: reviewer tidak memutuskan lingkup, ia mengembalikan pertanyaan itu ke Task.
Batas yang menjaga ini tetap jujur: Agent reviewer dapat menjalankan ulang perintah, membaca diff, dan menandai perbedaan antara bukti dan klaim. Ia tidak bisa memberi tahu Anda apakah fitur ini yang tepat. Apa yang bisa dan tidak bisa diverifikasi Agent review adalah daftar tetap, dan daftar itu menjadi lebih pendek, bukan lebih panjang, ketika reviewer-nya mahal.
Dua mode kegagalan yang perlu diwaspadai
Latensi adalah yang pertama, dan ini kontra-intuitif. Artificial Analysis, pihak ketiga dan bukan salah satu vendor, mengukur varian reasoning "max" pada 124.23 detik untuk token pertama pada Luna dan 102.15 detik pada Sol. [VERIFY] Konfirmasi angka-angka itu dengan daftar terkini sebelum mengandalkannya. Polanya lebih penting daripada angkanya: pada reasoning effort tinggi, model murah bukanlah model yang cepat memulai, sehingga Crew multi-model memiliki worker yang tampak macet dan reviewer yang menungguinya. Itu masalah status, bukan masalah model.
Volume review adalah yang kedua. Sepuluh worker Luna menghasilkan sepuluh packet. Jika reviewer menyetujui sembilan dan mengeskalasi satu, Anda telah mengubah sepuluh kali eksekusi agent menjadi satu keputusan manusia, dan itulah tujuannya. Jika ia mengeskalasi enam, Anda sudah membayar review-nya dan masih berutang enam keputusan, sementara antrean review memang sudah menjadi bottleneck. Lacak tingkat eskalasi per Agent worker selama satu Sprint. Itu akan memberi tahu Anda apakah packet-nya terlalu tipis atau Task-nya terlalu besar, jauh sebelum tagihannya melakukannya.
Kapan sebaiknya tidak melakukan ini
Gunakan satu model untuk semuanya ketika satu orang menjalankan satu atau dua Agent di satu repositori. Packet-nya hanya menambah beban, reviewer adalah tagihan kedua, dan Anda sendiri toh sudah menjadi reviewer-nya.
Gunakan Crew multi-model ketika beberapa Agent berjalan paralel, ketika lebih dari satu orang bisa memulai eksekusi, atau ketika pekerjaan yang sudah selesai melampaui waktu yang dimiliki siapa pun untuk membacanya.
Dan jangan menempatkan model mahal pada posisi review ketika pekerjaannya sendiri yang sulit. Migrasi yang harus mempertahankan konteks selama berjam-jam sebaiknya langsung ditangani Opus 5.5, dengan Agent murah yang menulis packet setelahnya. Memilih per peran berarti memilih per Task, bukan sekali per tim, itulah sebabnya mencocokkan model dengan peran agent adalah aturan yang Anda tuliskan, bukan kebiasaan yang disimpan diam-diam oleh enam orang.
Angka yang tidak berubah
Biaya per tugas yang selesai turun tajam di kedua sisi peluncuran ini. OpenAI melaporkan peneliti median-nya menghabiskan lebih dari $600 sehari untuk coding agent, dengan persentil ke-90 di atas $7,000. Tim di bawah garis itu kini mampu membiayai pekerjaan agent beberapa kali lebih banyak daripada minggu lalu.
Jam kerja reviewer tetap persis sama seperti sebelumnya. Crew multi-model layak dipertahankan karena mengubah lebih banyak output murah menjadi lebih sedikit keputusan manusia, dan itu hanya terjadi jika handoff membawa bukti alih-alih ringkasan. Pertahankan tujuan, diff, perintah, penghambat, klaim yang belum diverifikasi, dan review manusia yang kembali ke Task dari permintaan hingga rilis, maka pembagian model menjadi sekadar pengaturan yang bisa Anda ubah kuartal depan tanpa mengubah cara siapa pun bekerja.
Sharkly tidak menjalankan model dan tidak memilihkannya untuk Anda. Sharkly adalah lapisan Task, Computer, konteks, dan review bersama di sekitar tool yang menjalankannya, dan di situlah handoff harus berada jika reviewer dan manusia sama-sama akan membacanya. Jika Anda sudah menjalankan beberapa coding agent: hubungkan satu Computer, buat satu Agent worker dan satu Agent reviewer, lalu buat worker mengembalikan packet tersebut untuk pekerjaan yang membosankan.


