
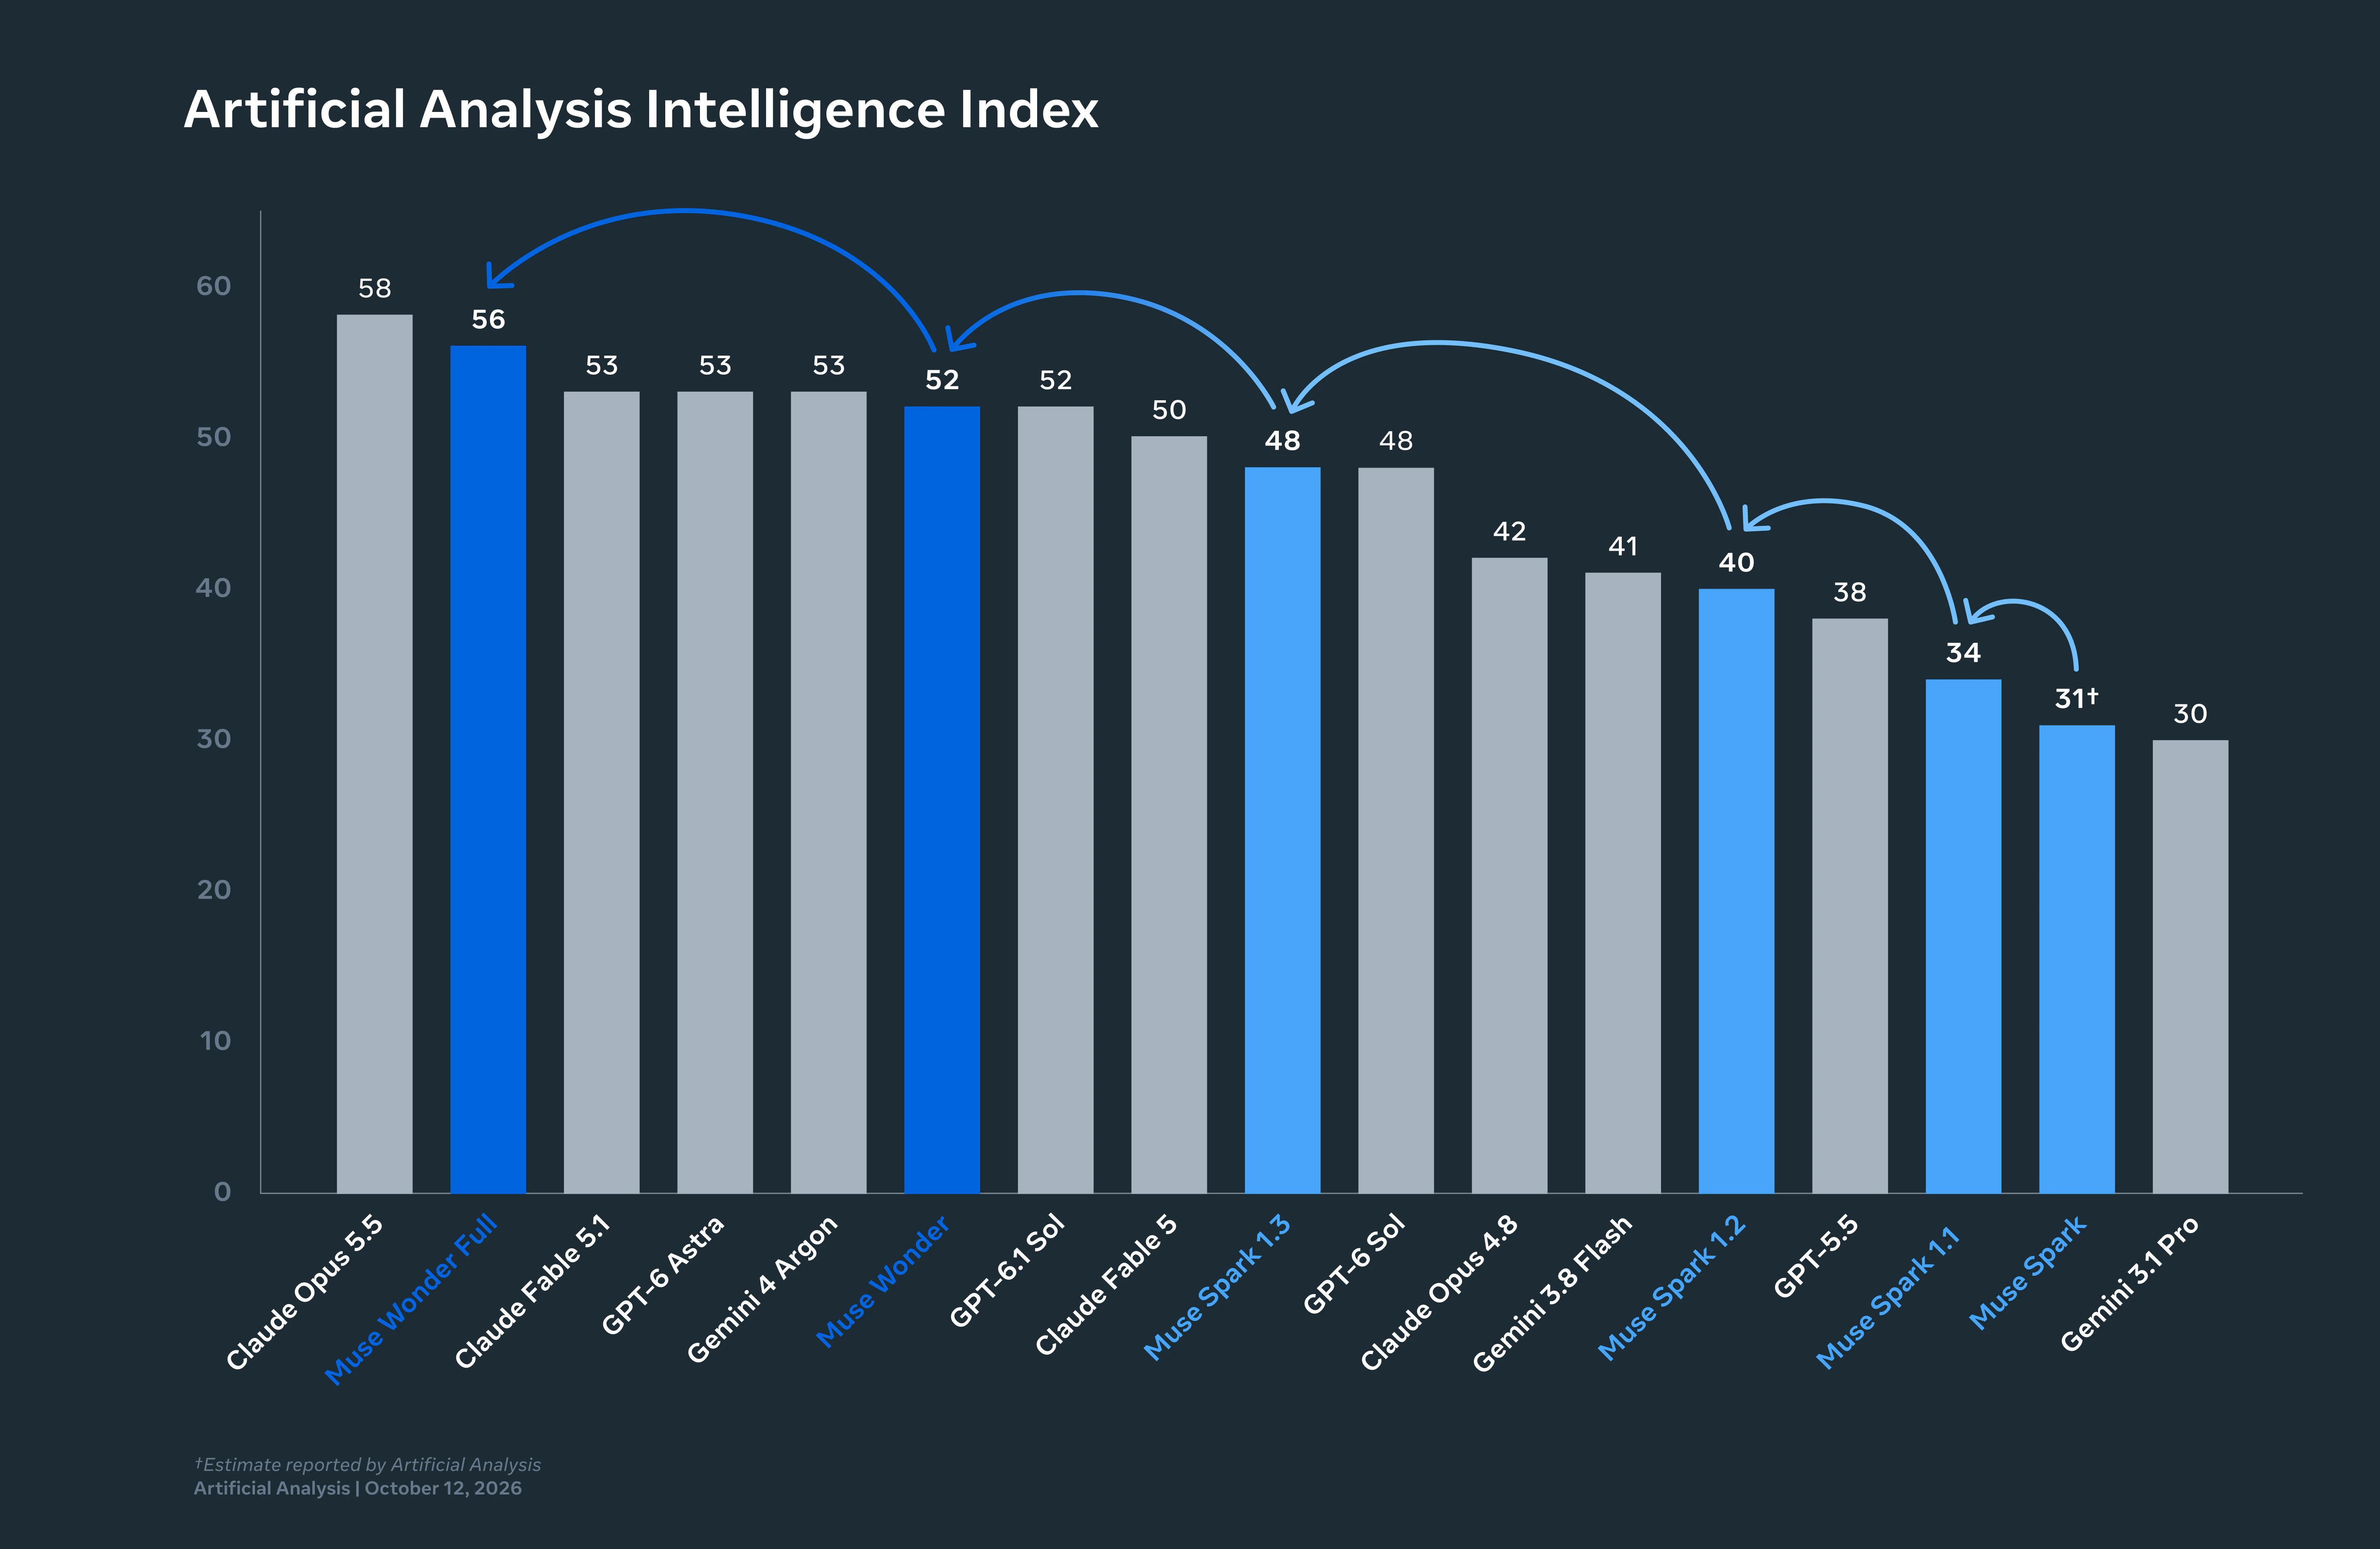
Muse Wonder dan Claude Opus 5.5 memiliki biaya yang sama, yaitu $4 per satu juta token input dan $20 per satu juta token output. Oleh karena itu, bagi sebuah Crew, pilihan di antara keduanya bukan lagi masalah anggaran, melainkan aturan perutean (routing rule). Model card milik Meta menunjukkan bahwa Wonder lebih unggul dalam tolok ukur pengodean berdurasi panjang (SWE-Marathon, 53,1 berbanding 46,3), sedangkan Opus memimpin dalam pekerjaan terminal (59,6 berbanding 52,0), kecerdasan umum (58 berbanding 52 pada indeks independen), serta pengetahuan (46 berbanding 25). Keempat angka ini menggambarkan dua Agent yang berbeda, dan papan kerja yang merutekan tugas berdasarkan metrik tersebut akan mendapatkan hasil optimal dari keduanya dibandingkan hanya mengandalkan satu model default.
Artikel ini menerjemahkan angka-angka tersebut menjadi pembagian tugas: Task mana yang cocok untuk Agent Muse Wonder, mana yang sebaiknya tetap ditangani oleh Opus 5.5, bagaimana pengaruh keduanya terhadap antrean peninjauan (review queue), dan bagaimana menilai efektivitas aturan ini setelah satu minggu berjalan. Panduan penyiapan untuk jalur (lane) Meta dapat dilihat di cara menjalankan agent Muse Wonder di Sharkly.
Angka-angka penting untuk perutean
| Metrik | Muse Wonder | Claude Opus 5.5 | Sumber |
|---|---|---|---|
| SWE-Marathon (tugas pengodean panjang) | 53.1 | 46.3 | Meta model card |
| DeepSWE 1.1 | 78.8 | 74.2 | Meta model card |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Meta model card |
| AA-Omniscience (pengetahuan) | 25 | 46 | Artificial Analysis |
| Tingkat halusinasi | 27% | lebih rendah, menurut peringkat AA | Artificial Analysis |
| Indeks Kecerdasan | 52 | 58 | Artificial Analysis |
| Indeks Coding Agent | 63 | 66 (Claude Code) | Artificial Analysis |
| Biaya per task indeks | $4.52 | $5.98 | Artificial Analysis |
| Input | Teks, gambar, video, audio | Teks, gambar, PDF | Dokumentasi vendor |
Lihatlah tabel ini sebagai dua profil yang berbeda. Wonder: gigih, berbiaya lebih murah per task karena outputnya ringkas, daya ingat (recall) lebih lemah, serta mendukung input video dan audio. Opus: lebih cerdas secara keseluruhan, lebih andal di shell terminal, memiliki pengetahuan lebih luas, tetapi berbiaya lebih tinggi per task. Tidak ada profil yang lebih unggul secara mutlak; keduanya cocok untuk jenis Task yang berbeda.
Task untuk Agent Muse Wonder
Karakteristik utamanya adalah proses pengerjaan yang panjang dengan banyak rintangan (blockers). Meta melatih model ini untuk apa yang mereka sebut Active Focus—mencoba berbagai pendekatan alternatif dan mengatasi hambatan—dan tolok ukur SWE-Marathon dirancang khusus untuk mengukur kemampuan tersebut.
- Refaktorisasi multi-berkas dengan test suite yang harus tetap hijau (lulus). Terdiri dari banyak tahapan, masing-masing dapat diverifikasi, serta kegagalan yang membutuhkan pendekatan kedua dan ketiga.
- Migrasi dependensi dan framework. Skenario klasik pengerjaan panjang: tingkatkan versi, ada yang rusak, perbaiki, ulangi—di mana tugas utama model adalah tidak menyerah di langkah ke sebelas.
- Siklus perbaikan dan verifikasi (fix-and-verify) pada test suite yang flaky. Proses pengerjaan yang perlu membedakan antara bug buatannya sendiri dan bug bawaan dari test suite.
- Task dengan input video atau audio. Rekaman layar mengenai sebuah bug, atau rekaman panggilan berisi kebutuhan sistem (requirements). Opus 5.5 tidak dapat memprosesnya.
Tulis kriteria penerimaan (acceptance criterion) sedemikian rupa agar sistem dapat memeriksanya secara mandiri. Wonder bekerja optimal saat Task menyatakan secara jelas “semua pengujian di packages/api lolos dan changelog telah diperbarui”, dan bekerja paling buruk saat ia harus menentukan sendiri apa arti "selesai".
Task yang tetap ditangani Opus 5.5
- Pekerjaan yang intensif di terminal. Skrip infrastruktur, pipeline penerapan (deploy), atau apa pun saat agent lebih banyak bekerja di lingkungan shell. Selisih tujuh setengah poin pada Terminal-Bench merupakan celah performa yang signifikan.
- Segala hal yang bergantung pada wawasan dan pengetahuan luas. Skor Omniscience 25 berbanding 46 menunjukkan bahwa Wonder dua kali lebih berpeluang kehilangan suatu fakta. Untuk API pustaka yang belum pernah dilihat sebelumnya, kode eror yang tidak umum, atau pengetahuan domain khusus, Opus dapat menjawab langsung dari ingatannya, sedangkan Wonder harus mencarinya terlebih dahulu atau menebak.
- Posisi peninjau (reviewer). Agent yang membaca diff dari Agent lain dan memutuskan kebenarannya haruslah model terpintar yang Anda miliki. Pada indeks gabungan, Opus adalah yang terunggul, dan pola Crew multi-model memang sudah menempatkan model mahal pada posisi tersebut.
- Task yang singkat dan spesifik. Pada DeepSWE, skor keduanya berdekatan; namun pada kecerdasan umum, Opus memimpin. Jika proses pengerjaan hanya memakan waktu sepuluh menit, keunggulan persistensi Wonder tidak akan terlihat.
Dampak masing-masing model terhadap antrean peninjauan
Perutean mengubah apa saja yang sampai di hadapan para peninjau, dan itulah biaya riil yang sebenarnya.
Eksekusi Wonder pada Task yang panjang menghasilkan alur yang lebih berliku: lebih banyak percobaan, lebih banyak pendekatan yang dibatalkan (reverted), dan lebih banyak commit. Ini adalah hal wajar saat model bekerja keras, tetapi itu juga berarti diff kode tidak menceritakan semuanya. Peninjau membutuhkan log eksekusi, itulah sebabnya instruksi Agent harus memintanya mencatat secara berkala apa saja yang sudah dicoba. Prinsip bahwa peninjauan manusia adalah penghambat utama berlaku semakin kuat: model yang gigih menghasilkan lebih banyak hal untuk ditinjau per Task, bukan lebih sedikit.
Kesenjangan pengetahuan Wonder muncul berupa detail teknis yang tampak meyakinkan padahal keliru: opsi (flag) yang sebenarnya tidak ada, atau metode yang sudah berganti nama dua versi sebelumnya. Tingkat halusinasinya memang tergolong rendah di kelasnya, yaitu 27% menurut metrik Artificial Analysis, tetapi 27% bukanlah nol. Beri instruksi kepada Agent untuk mengonfirmasi apa pun yang tidak pasti di dalam repositori dan menyatakan secara terbuka jika tidak dapat memastikannya, lalu minta peninjau memeriksa secara acak (spot-check) bagian-bagian tersebut.
Eksekusi Opus pada Task yang sama cenderung menghasilkan alur yang lebih ringkas dan tegas, dengan biaya per task yang lebih tinggi. Beban peninjauan per eksekusi menjadi lebih ringan. Namun, ketika Task berdurasi panjang dan memiliki banyak rintangan, Opus lebih berisiko berhenti di tengah jalan, yang kemudian memunculkan masalah berbeda di antrean: Task yang kembali dalam kondisi baru selesai separuh dan perlu didefinisikan ulang cakupannya (re-scoping).
Tiga contoh Task dan peruteannya
Contoh nyata membuat aturan ini lebih mudah diterapkan saat pembagian tugas.
“Tingkatkan ORM dari v5 ke v7 di seluruh layanan; semua uji integrasi harus lolos.” Wonder. Memiliki puluhan langkah, test suite yang berpotensi memunculkan eror baru di setiap tahapan, dan garis akhir yang jelas. Kegigihan model adalah aset utamanya, dan proses eksekusi dapat memverifikasi sendiri kriteria penerimaannya.
“Tulis kode Terraform untuk lingkungan staging baru dan terapkan (apply).” Opus. Membutuhkan interaksi shell yang intensif, pengetahuan infrastruktur yang spesifik, dan tindakan yang berdampak besar. Nilai Terminal-Bench mengunggulkan Opus; selain itu, cakupan dampak (blast radius) mengharuskan Agent berhenti dan meminta konfirmasi sebelum menjalankan perintah apply, model mana pun yang digunakan.
“Jelaskan mengapa webhook pembayaran terpanggil dua kali (double-fires) dan usulkan solusinya.” Opus untuk bagian penjelasan, karena ini membutuhkan pemahaman mendalam tentang bagaimana semantik retry penyedia layanan bekerja—yang merupakan ranah ingatan (recall). Jika solusi yang diusulkan berkembang menjadi perubahan pada banyak berkas beserta pengujiannya, Task lanjutan tersebut dapat dialihkan ke Wonder.
Polanya jelas: gunakan Wonder untuk Task yang ditentukan oleh garis akhir yang jelas, dan gunakan Opus untuk Task yang ditentukan oleh pengetahuan yang dibutuhkan. Jika sebuah Task mencakup keduanya, bagi Task tersebut. Sharkly dibangun khusus untuk pembagian seperti ini—satu Task per Agent per lajur (lane), dengan proses serah terima yang tercatat di papan kerja alih-alih hanya diingat di kepala seseorang.
Menjalankan keduanya dan mengevaluasi hasilnya
Terapkan aturan ini di papan kerja Anda selama seminggu dan biarkan performa pengerjaan Task yang menunjukkannya.
- Buat Agent Muse Wonder dan pertahankan Agent Opus 5.5. Berikan instruksi pada kedua Agent untuk menyertakan model id di bagian atas laporan, karena Sharkly tidak menampilkannya secara langsung.
- Bagi tugas berdasarkan aturan di atas, bukan preferensi pribadi. Task berdurasi panjang dan sarat rintangan ke Wonder; task berbasis terminal dan pengetahuan luas ke Opus; serta proses review ke Opus.
- Setelah satu minggu, kumpulkan Task yang berhasil diselesaikan oleh masing-masing Agent dan hitung tiga parameter: berapa banyak yang membalas dengan pertanyaan alih-alih hasil, berapa banyak yang membutuhkan eksekusi ulang, dan berapa banyak komentar tinjauan yang didapatkan masing-masing model.
Jika Task panjang milik Wonder selesai dengan lebih sedikit pengulangan (re-run) dan Task terminal milik Opus selesai dengan lebih sedikit koreksi, berarti aturan perutean Anda sudah tepat. Jika Task milik Wonder justru menghasilkan lebih banyak komentar tinjauan dibanding penghematan eksekusi ulangnya, batasi jenis task yang Anda kirimkan kepadanya. Angka-angka pada tabel di atas hanyalah rata-rata dari berbagai tolok ukur; Task di dunia nyata Anda sendirilah tolok ukur yang paling menentukan.
Semua biaya ini tidak masuk ke dalam tagihan Sharkly. Penggunaan model berjalan melalui kunci API Meta dan Anthropic yang dikonfigurasikan di Computer, dan dengan harga katalog resmi yang identik, satu-satunya perbedaan biaya hanyalah apa yang dilaporkan oleh blok usage di setiap eksekusi.
Model-model ini diperbarui bulan ini. Konteks, progres, hambatan, hasil, dan peninjauan manusia tetap transparan dari awal permintaan hingga rilis. Anda dapat menerapkannya secara manual menggunakan worktree, atau menggunakan Sharkly untuk mengelola alur kerja tersebut.


