
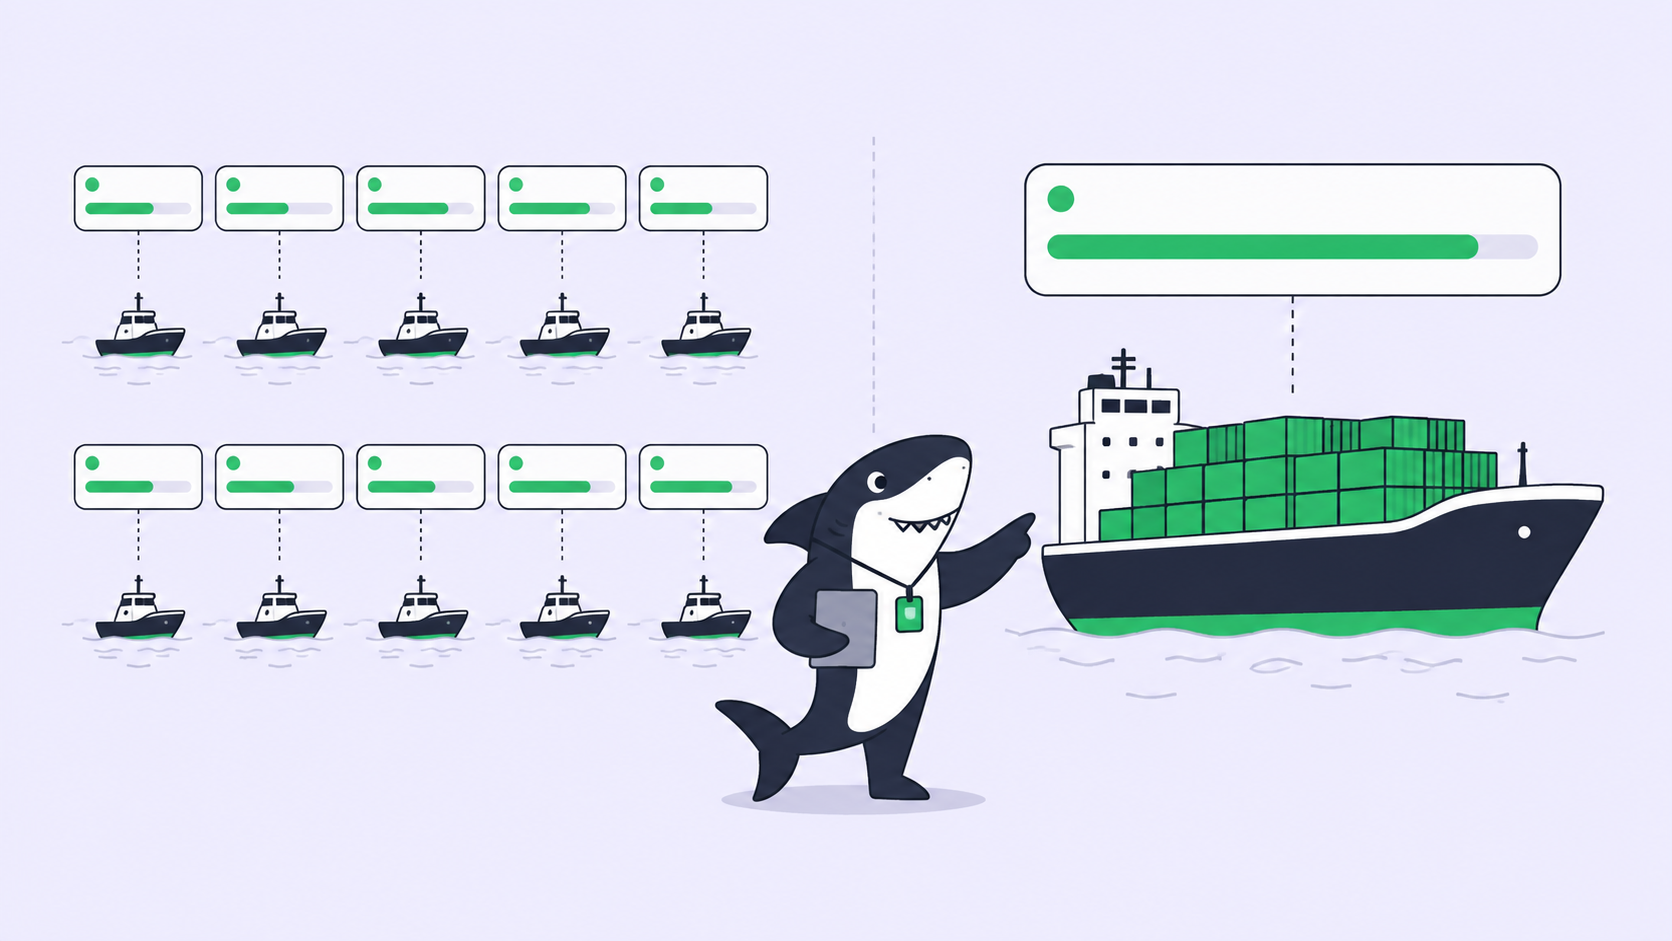
Anda punya jumlah reviewer yang tetap, dan sejak 2026-09-22, tagihan model yang tidak lagi menentukan apa pun bagi Anda. GPT-6 Luna dibanderol $0,10 per juta token input dan $0,50 per juta output, dengan id API gpt-6-luna. Claude Opus 5.5 dipatok $4 dan $20, id API claude-opus-5-5. Itu selisih 40 kali lipat di kedua sisi meteran, hasil hitungan kami dari harga daftar resmi kedua vendor, dan itu mengubah pertanyaan yang dulu teoretis menjadi keputusan penjadwalan mingguan. Dengan uang yang sama, mana yang Anda jalankan: sepuluh Agen murah atau satu Agen mahal?
Kedua konfigurasi ini bukan pengganti satu sama lain. Yang membedakan keduanya bukanlah kualitas model, dan perbedaannya baru terlihat di akhir proses, bukan di awal: masing-masing menaruh beban kerja yang berbeda di depan manusia.
Hitungan yang membuat pertanyaan ini nyata
OpenAI mempublikasikan biaya per tugas berdampingan dengan skor, dan itu jauh lebih berguna daripada sekadar daftar harga. Pada DeepSWE 1.1, Luna dengan effort penalaran maksimum mencetak skor 66,6%, yang menurut OpenAI setara dengan Claude Opus 5 dan Fable 5 pada effort medium, dengan biaya per tugas 93% lebih rendah daripada Opus 5 dan 96% lebih rendah daripada Fable 5.
Balik saja angka pertama, dan satu tugas Opus 5 setara dengan sekitar empat belas tugas Luna. Jadi, sepuluh kali menjalankan Luna hanya menghabiskan sekitar tujuh persepuluh dari biaya satu kali menjalankan Opus 5 pada harness tersebut. Perkalian itu kami yang hitung sendiri, berdasarkan angka 93% yang disebut OpenAI.
Anthropic menyebut Opus 5.5 40% lebih murah untuk dijalankan dibanding Opus 5. Kalau itu diterapkan, rasionya turun ke sekitar sembilan banding satu. Angka itu merangkai dua pengukuran dari vendor berbeda yang dilakukan pada harness berbeda, jadi anggap saja sebagai arah, bukan angka pasti: sepuluh percobaan murah dan satu percobaan mahal kini biayanya kurang lebih sama, mau dihitung dengan cara apa pun.
| GPT-6 Luna | Claude Opus 5.5 | |
|---|---|---|
| Id API | gpt-6-luna |
claude-opus-5-5 |
| Input / output per 1 juta | $0,10 / $0,50 | $4 / $20 |
| Input cache | potongan 90% untuk pembacaan | $0,20 baca, $5 tulis |
| Jendela konteks | 1M | 1M |
| Klaim vendor soal long-horizon | tidak disebutkan | tetap mengerjakan tugas 18+ jam |
| Artificial Analysis Index | 37 | 58, peringkat #1 dari 212 |
Ada dua catatan penting yang menyertai tabel itu. Judul utama OpenAI adalah bahwa Sol dan Luna masing-masing 50% lebih murah dibanding harga promosi GPT-5.6, dan “promosi” adalah kata OpenAI sendiri: perbandingannya dilakukan terhadap tarif diskon, bukan tarif daftar. Dan kedua tulisan peluncuran itu bukanlah perbandingan head-to-head. Kedua vendor melaporkan skor AutomationBench, pada versi harness dan tingkat effort yang berbeda, di hari yang sama. Menempatkan kedua persentase itu dalam satu baris akan menghasilkan perbandingan yang tidak pernah dijalankan oleh lab mana pun. Rasio biaya per tugas di atas tetap valid karena berasal dari pengukuran satu vendor sendiri.
Tiga konfigurasi yang tampak seperti satu pilihan
“Sepuluh agen atau satu” sebenarnya adalah tiga susunan berbeda, dan ketiganya berperilaku berbeda pada tahap review.
| Konfigurasi | Apa yang tiba di tahap review | Siapa yang memilih pemenangnya | Cocok dipakai saat |
|---|---|---|---|
| Sepuluh Agen murah, sepuluh Task | Sepuluh diff, sepuluh keputusan | Manusia, sepuluh kali | Backlog-nya lebar dan setiap item bisa diterima secara independen |
| Sepuluh Agen murah, satu Task | Satu diff, satu keputusan | Test suite Anda | Mesin bisa memberi peringkat pada setiap percobaan tanpa perlu dibaca manusia |
| Satu Agen mahal, satu Task | Satu diff, satu keputusan | Manusia, sekali | Horizon panjang, sinyal otomatis lemah, atau perubahan yang butuh pertimbangan di sepanjang proses |
Baris tengah adalah yang sebenarnya terbuka berkat pemotongan harga, dan justru itu yang paling sering dilewatkan tim. Menjalankan Task yang sama sepuluh kali lalu menyimpan percobaan yang lolos typecheck, tes, dan build adalah strategi yang baru terjangkau setelah satu percobaan tidak lagi memakan biaya nyata. Dengan tingkat kelulusan benchmark mendekati dua pertiga, sepertiga dari percobaan tunggal akan gagal. Kalau setiap percobaan gagal secara independen, sepuluh kali coba hampir tidak mungkin semuanya gagal. Kenyataannya tidak independen: tugas dengan kebutuhan yang ambigu atau fixture yang hilang akan menggagalkan semua percobaan dengan cara yang sama. Fan-out memberi Anda variasi, bukan jaminan.
Baris pertama adalah yang paling sering dipilih tim, dan itulah yang mahal. Bukan mahal dalam dolar. Sepuluh Agen pada sepuluh Task menghasilkan sepuluh diff, dan setiap diff perlu dibaca manusia, dipahami apa yang dipilih Agen, dan dipertanggungjawabkan saat merge. Biaya itu tidak turun pada 2026-09-22 dan tidak ada rilis model yang menyentuhnya. Kami pernah menulis tentang kenapa review manusia jadi hambatan dalam kerja agen paralel dan tentang berapa hari kerja agen yang bisa diserap satu hari kerja manusia; hitungan di sana tidak berubah hanya karena token lebih murah.
Sepuluh Agen di Luna bukan berarti sepuluh kali output. Itu sepuluh kali pekerjaan yang datang. Model yang lebih murah membeli percobaan. Ia tidak membeli kapasitas review, dan keduanya mudah tertukar ketika satu-satunya angka yang diperhatikan adalah tagihan.
Biaya per perubahan yang diterima adalah angka yang bisa dipakai
Biaya per perubahan yang diterima adalah berapa yang dikeluarkan tim Anda untuk inference pada setiap diff yang benar-benar dibaca dan diterima manusia. Itu satu-satunya angka biaya agen yang berkaitan dengan pekerjaan yang benar-benar rilis, karena percobaan yang tidak direview siapa pun belum menghasilkan apa pun.
Definisi itu langsung memilah ketiga konfigurasi tadi. Fan-out pada satu Task membagi sepuluh percobaan ke dalam satu keputusan review, sehingga percobaan yang lebih murah menurunkan biaya per perubahan yang diterima secara linear. Melebar ke sepuluh Task membagi satu percobaan ke dalam satu keputusan review sebanyak sepuluh kali, jadi percobaan yang lebih murah menurunkan biaya inference sementara biaya review tetap datar dan justru menjadi hambatannya. Kedalaman pada satu Agen mahal memberi peluang lebih besar bahwa satu-satunya percobaan yang ada di depan reviewer Anda adalah yang layak di-merge.
Ada efek kedua yang baru terlihat dalam praktik. Bekerja dengan sepuluh percobaan murah dan satu percobaan mahal terasa berbeda. Artificial Analysis mengukur varian penalaran maksimum dari model-model ini: 124,23 detik ke token pertama untuk Luna dan 102,15 detik untuk Sol, angka pihak ketiga yang khusus untuk varian max, dan sebaiknya dikonfirmasi dulu sebelum Anda menjadikannya dasar perencanaan. Sepuluh Agen yang masing-masing diam dua menit sebelum mengeluarkan satu karakter bukanlah pipeline yang cepat. Itu sepuluh proses yang sekaligus terlihat menggantung, dan ini masalah status, bukan masalah model.
Pasangan keputusan
Gunakan sepuluh Agen murah ketika mesin yang memutuskan. Artinya Task tersebut punya sinyal penerimaan nyata yang berjalan tanpa manusia: tes yang hari ini gagal dan harus lulus, typecheck, build, aturan lint, skrip reproduksi. Triage, pelabelan, scaffolding tes, dan refactor mekanis termasuk. Begitu juga perubahan apa pun yang pertanyaan “berhasil atau tidak” dijawab dengan perintah, bukan pendapat.
Gunakan satu Agen mahal ketika manusia yang memutuskan. Kalau untuk menerima perubahan itu Anda harus membaca kode dan membentuk penilaian, percobaan tambahan tidak membantu — justru melipatgandakan bacaan. Hal yang sama berlaku untuk pekerjaan long-horizon: Anthropic menyatakan Opus 5.5 tetap mengerjakan tugas selama 18 jam atau lebih, dan satu proses yang mempertahankan tujuan sepanjang satu sore lebih bernilai daripada sepuluh proses yang masing-masing memulai ulang dari pemahaman parsial yang sama.
Jangan pakai fan-out untuk menghindari penulisan sinyal penerimaan. Sepuluh diff yang tampak masuk akal tanpa penilai otomatis lebih buruk daripada satu diff, karena memilih di antara sepuluh diff yang tampak masuk akal lebih sulit daripada mereview satu, dan pekerjaan itu justru jatuh ke orang yang ingin Anda lindungi.
Apa yang dibutuhkan konfigurasi lebar dari lapisan di atasnya
Menjalankan sepuluh Agen sekaligus adalah masalah koordinasi sebelum menjadi masalah biaya. Komponennya sudah diketahui: setiap proses berjalan di worktree-nya sendiri agar dua Agen yang mengedit file yang sama bukan jadi insiden, satu Assignee per Task supaya kepemilikannya tidak pernah ambigu, dan status yang membedakan running, waiting, dan failed.
Agent mendefinisikan bagaimana pekerjaan harus ditangani. Computer menyediakan host dan sumber daya lokal. Runtime menjalankan sesi. Task tetap menjadi catatan bersama. Ketika sepuluh proses selesai dalam rentang satu jam satu sama lain, bagian terakhir itulah yang mencegah jam tersebut berubah menjadi perburuan di sepuluh terminal.
Proses Luna yang selesai seharusnya mengembalikan sesuatu seperti ini ke Task-nya, bukan ke log sesi pribadi:
SH-312  Add retry with backoff to the webhook dispatcher
Runtime   gpt-6-luna (fan-out, 8 attempts, 3 passed the suite)
Selected  attempt 6, smallest diff of the passing set
Evidence  typecheck ok, 214 tests pass, build ok, coverage +0.4%
Known limit  no test for the 429 path, dispatcher is not idempotent yet
Status    Ready for review, waiting on a human
Baris Selected adalah bagian yang penting. Baris itu menyatakan apa yang memutuskan, sehingga reviewer tahu apakah mereka sedang mengonfirmasi pilihan mesin atau membuat pilihan sendiri. Sepuluh percobaan tanpa catatan pemilihan adalah sepuluh kali pekerjaan yang berpura-pura menjadi satu Task.
Jawabannya
Sepuluh Agen murah menghasilkan lebih banyak saat suite yang memutuskan dan backlog-nya cukup lebar untuk membuat mereka tetap sibuk. Satu Agen mahal menghasilkan lebih banyak ketika keputusan penerimaan ada di tangan manusia, horizon-nya panjang, atau sinyal otomatisnya lemah. Sebagian besar tim menginginkan keduanya, dipilih berdasarkan jenis Task, bukan preferensi, dan itulah argumen dalam mencocokkan model dengan peran agen.
Tidak ada dari kedua konfigurasi itu yang mengubah langkah terakhir. Agen meneliti, mengeksekusi, menguji, dan melaporkan. Manusia menetapkan arah, memberikan otoritas, dan menerima hasilnya. Harga model bergerak 40 kali lipat dalam sehari, sementara jumlah perubahan yang bisa diterima tim Anda secara bertanggung jawab tidak bergerak sama sekali.
Jika Anda sudah menjalankan beberapa agen, Sharkly menyediakan satu tempat untuk menjaga konteks, progres, blocker, hasil, dan review manusia tetap terlihat dari permintaan sampai rilis, apa pun runtime yang menghasilkan diff-nya.


