

コーディングエージェントに「この関数はどこで呼ばれている?」と尋ねてみてほしい。何が起きるか見てみよう。grep して、3つのファイルを読み、別のパターンでまた grep して、さらに4つ読んで、ようやく正しく答える。その頃には、セッションが終われば忘れてしまうソースコードでコンテキストが埋め尽くされている。追加で質問すれば、同じことをまた最初から繰り返す。
codebase-memory-mcp は、そのループをなくす。スター数41,536、MITライセンス、C言語で書かれたこのツールは、今年のエージェントツールの波の中で、ワークフローへの変更が最小でありながら最もリターンの大きいものだ。エージェントにコードの記憶を与える。ただし、チームに「仕事の記憶」を与えるわけではない。この2つは別の問題である。
TL;DR
これは、コーディングエージェントを拡張するオープンソースツールのまとめ記事に含まれる5つの詳細解説のうちの1つだ。
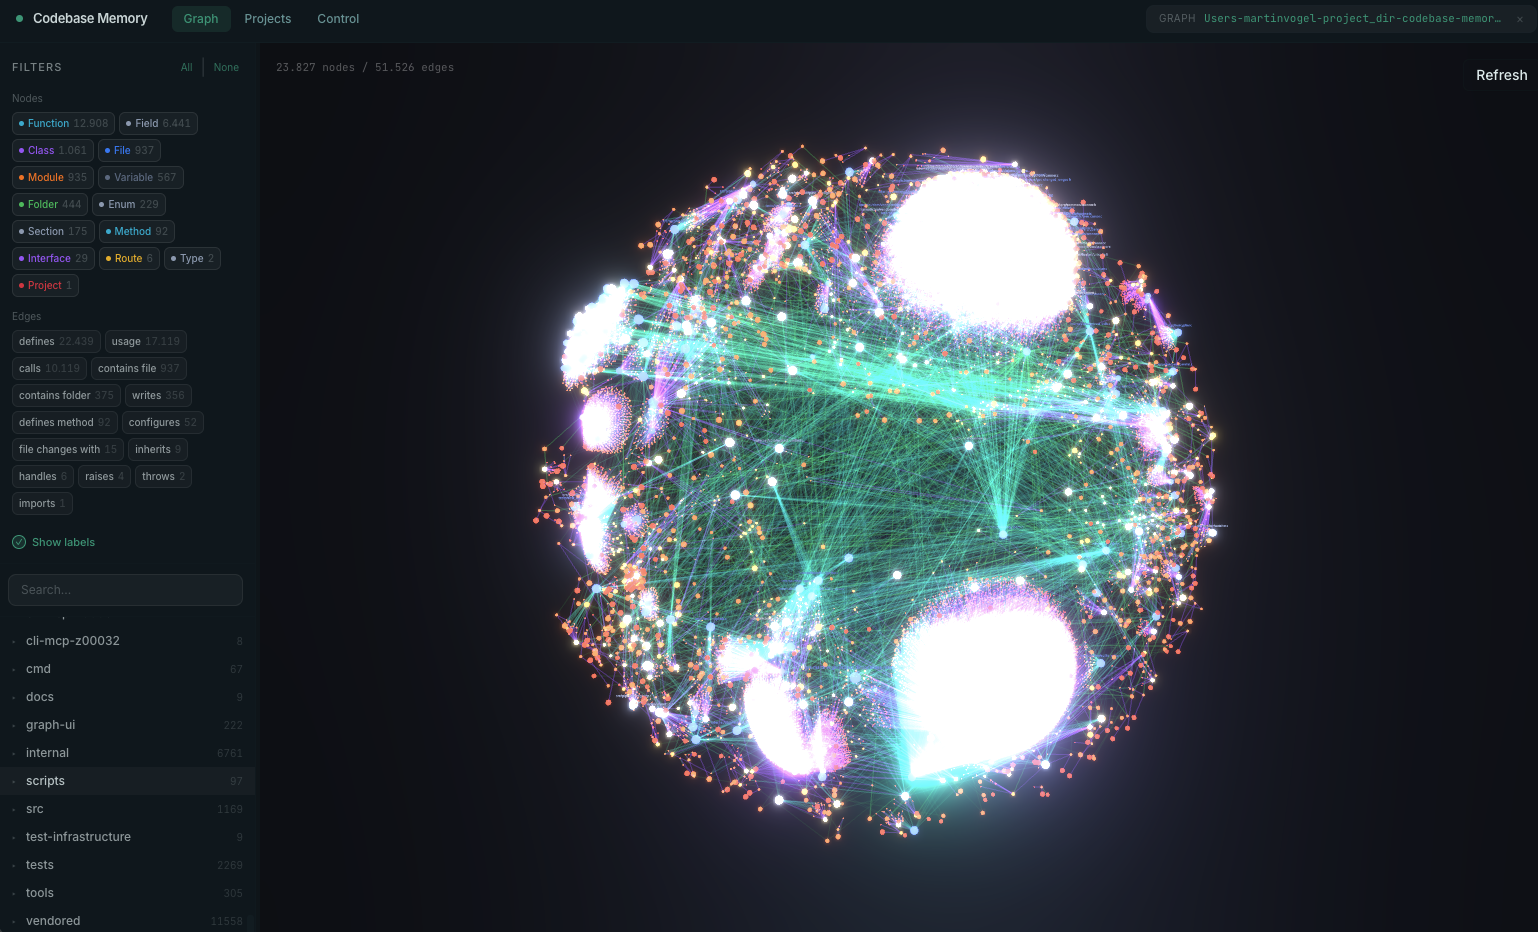
codebase-memory-mcp はリポジトリを、関数、クラス、呼び出しチェーン、ルートからなる永続的なナレッジグラフとしてインデックス化し、構造に関する質問には grep ではなくグラフから答える。プロジェクトの計測では、5つの構造クエリがグラフ経由で約3,400トークン、ファイルを1つずつ読む方法では約412,000トークンとなっている。単一のネイティブバイナリで、ランタイムもAPIキーも不要、完全にローカルで動作し、あらゆる MCP クライアントで使える。まずこれをインストールしよう。そのうえで、エージェントが行った作業の記録をどこに置くかは、別の問題として考えよう。
できること
パースは tree-sitter を通じて160以上の言語に対応し、Python、TypeScript と JavaScript ファミリー、Go、Java、Rust、C#、C++ といった主要言語には意味的な型解決も追加される。その結果は、検索、呼び出しチェーンの追跡、アーキテクチャの全体像、影響分析、デッドコード検出、グラフクエリ、サービス間のHTTP連携をカバーする15のMCPツールとして公開される。Model Context Protocol に対応したクライアントならどれでも使え、プロジェクトでは45の対応エージェント環境が挙げられている。
| 指標 | 報告値 |
|---|---|
| 5つの構造クエリ | 約3,400トークン vs ファイル単位で約412,000トークン |
| 査読済みの比較 | トークン数10分の1、ツール呼び出し2.1分の1、回答品質83% |
| Linuxカーネルのインデックス | 2,800万行、75,000ファイル、3分 |
| 構造クエリのレイテンシ | 1ミリ秒未満 |
この2つのトークン数の数字はセットで見てほしい。99%削減というのは5つの構造クエリの場合、つまりグラフにとって最良のケースだ。31のリポジトリを対象としたプレプリントの数字は10分の1。10分の1を前提に計画し、それより良ければ上振れと捉えよう。
インストール方法
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash
Windows には PowerShell インストーラーがあり、プロジェクトは実行前に読むことを推奨している。インストーラーはコーディングエージェントを検出し、それぞれのMCPエントリを書き込む。エージェントを再起動して、プロジェクトをインデックス化するよう指示しよう。
初日から設定しておく価値のある2つの項目がある:
codebase-memory-mcp config set auto_index true
codebase-memory-mcp --ui=true --port=9749
グラフビューアはバイナリに組み込まれており、インデックスが想定どおりの範囲をカバーしたかを確認するのに役立つ。
プロジェクト自身が文書化している注意点が2つあり、どちらも30秒ほど目を通す価値がある。Microsoft Defender がリリースバイナリを誤検知として警告することがあり、プロジェクトによれば通常62エンジン中61エンジンはクリーンと判定し、同じ検出ファミリーは GitHub CLI や Microsoft 自身の Go ツールチェーンにも反応するという。そして、このツールはコードベースを読み、エージェントの設定ファイルに書き込む。それが役割であり、率直にそう述べられている。シェルにパイプする前にインストールスクリプトを読もう。
なぜこれを最初に導入すべきか
現在のツールの波にある他のものはすべて、働き方を変えることを求めてくる。ロールライブラリはプロンプトの書き方を変える。並列ワークツリーは作業の進め方を変える。Webアクセスは何を尋ねるかを変える。
これは何も変えずに、あらゆるセッションを安くする。覚える習慣はない。
品質への効果は過小評価されがちなもう半分だ。ファイルを読むのに400,000トークンを使うエージェントは、あなたの問題について推論する余地がそれだけ減り、長いセッションでは早い段階で読んだ内容の記憶が薄れていく。グラフから答えることで、コンテキストを空けておける。
この変化は、何を尋ねるかに表れる。以前は50,000トークンと2分かかるからと避けていた質問が、今ではほぼ無料になる。シグネチャ変更前の影響分析は、「たぶん安全だと思う」をリストに変える。慣れないリポジトリでの呼び出しチェーン追跡は、エントリポイントを探して5つのファイルを逆向きに読み進めるより優れている。
コードの記憶は仕事の記憶ではない
ここに境界線があり、それは明確だ。
グラフはあなたのコードから作られるので、コードが何であるかは把握している。リトライヘルパーが決済クライアントを呼び出していることは教えられる。しかし、7月になぜバックオフが変わったのか、誰が決めたのか、代替案は何だったのか、誰かがレビューしたのかは教えられない。その履歴は、すでに消えたターミナルセッションの中にあった。
チームはこれを奇妙な非対称性として感じる。エージェントはチーム内の誰よりもコードベースをよく覚えているのに、それを生み出した決定についてはまったく記憶していない。
インデックスはマシンごとでもある。1つのアカウントのキャッシュディレクトリに存在し、コーディネーションデーモンを介してローカルセッション間で共有されるが、そのマシンの境界で止まる。
作業の記録がどこに存在するか
タスクは Sharkly における作業の基本単位だ。リクエスト、コンテキスト、実行、ブロッカー、結果を、個人的なプロンプトやターミナルセッションに分散させるのではなく、1つの共有された場所で保持する。
それぞれの要素には1つの役割がある。エージェントは作業をどう扱うかを定義する。コンピュータはホストとローカルリソースを提供する。ランタイムは、そこにすでにインストールされているコーディングツールを使って、実際のエージェントセッションを実行する。タスクは共有された記録として残る。
この分離によって、組み合わせが具体的になる。インデックスはコンピュータ上のローカルリソースなので、インデックス済みのリポジトリを持つコンピュータでは、冷たい状態から3分かけて起動するのではなく、温まったグラフが存在する。エージェントは保存された設定なので、エージェントがインデックスと適切な権限を持つ構成は、マシンごとに作り直すのではなく再利用される。そして実行、ブロッカー、結果、フォローアップの議論はタスクのタイムラインに戻る。ここにこそ、変更の背後にある推論が生き残る。
Sharkly は Claude Code や Codex、codebase-memory-mcp の代替ではない。それらを囲む形で、共有タスク、コンピュータ、コンテキスト、制御、レビューのレイヤーを追加する。モデルの利用は、それらのツールで設定されたサブスクリプションやAPIキーを通じて引き続き行われる。
コードの記憶と仕事の記憶の組み合わせが重要だ。一方はエージェントにリポジトリの記憶を与える。もう一方はチームに、エージェントがその中で何をしたかの記憶を与える。
それぞれが必要になる場面
チームの規模にかかわらず、今すぐ codebase-memory-mcp をインストールしよう。ローカルで動作し、ワークフローの変更も不要で、コスト削減効果は開発者1人でも20人でも同じように得られる。
推論がセッションより長く生き残る必要がある場合、つまりリリース前にレビューが行われる場合、複数の人が同じリポジトリに触れる場合、3か月後に誰かが「なぜこの変更をしたのか」と尋ねる場合には、共有された作業システムを追加しよう。グラフはコードが何をするかを答えてくれる。しかし「なぜ」は決して答えない。
エージェントは調査し、実行し、テストし、報告する。人は方向性を定め、権限を与え、結果を受け入れる。
よくある質問
Claude Code 以外のエージェントでも動作しますか? はい。MCPサーバーなので、あらゆるMCPクライアントで動作します。プロジェクトでは Cursor、Codex、Windsurf、OpenCode、Aider など45の対応エージェント環境が挙げられています。
コードがマシンの外に出ることはありますか? いいえ。処理は完全にローカルで行われ、プロジェクトによれば独自のネットワークリクエストは行わず、バックグラウンドでのアップデート確認も行いません。信じるのではなく自分で確認したい場合は、ソースが公開されています。
99%のトークン削減は現実的ですか? その数字は5つの構造クエリという最良のケースです。31のリポジトリを対象とした査読済みの数字は、トークン数が10分の1、ツール呼び出しが2.1分の1です。10分の1を前提に計画してください。
どのくらい大きなリポジトリまで扱えますか? 公表されている上限のケースは、2,800万行のLinuxカーネルを3分で処理するというものです。通常のアプリケーションリポジトリならミリ秒単位でインデックス化されます。
複数のエージェントを同時に動かす場合にも役立ちますか? はい、通常以上に役立ちます。5つのエージェントが同じリポジトリを grep するのは、5倍の無駄です。各タスクの実行はそれぞれ独立したワークツリーを持ちますが、構造インデックスはコンピュータ上で共有されます。
まとめ
これは2026年の波の中で最も目立たないツールであり、最もリターンの大きいツールだ。単一のネイティブバイナリ、ワークフローの変更なし、そして本来 grep する必要のない質問に答えるためにエージェントが消費するトークンを、実測で桁違いに削減する。インストールしてプロジェクトをインデックス化し、グラフビューアを一度開いて何が構築されたかを見てみよう。
そして、限界について明確にしておこう。記憶するのはリポジトリであり、仕事ではない。変更の背後にある決定は、何かが保持しない限りセッションとともに消える。Sharkly はそれを保持する。タスクが共有された記録となり、実行はすでに支払っているランタイムを通じて接続したコンピュータ上で行われ、結果は人がレビューして受け入れられる場所に戻る。


