

JevはTypeSafe AIが発表した新しいモデルで、コードも文章も書きません。プログラムの状態を渡し、答えてほしい質問を宣言すると、型付きの答えを較正済みの確率とともに返してくれます。TypeSafeはこれを「System One Model」と呼んでいます。2026年9月16日にVercel AI Gatewayで公開され、それが突然あらゆるフィードで見かけるようになった理由です。
複数のコーディングエージェントを動かしているチームにとって、面白いのはモデルそのものではありません。意思決定モデルがスタックのどこに位置するかです。作業を生み出すのはエージェントです。難しいのは、人的レビューがボトルネックである理由で論じたように、5つの実行の出力を同時にどう扱うかを決めることです。どれに人が必要か、どれはマージできるか、どれが行き詰まっているか。Jevはまさにそうした問いのために作られています。本記事では、Jevとは何か、何ではないか、そしてエージェントの上位層のどこに収まるのかを説明します。
Jevとは何か
System One Modelとは、テキストの代わりに意思決定を返すモデルです。TypeSafeの発表記事では「非構造化状態を入力し、型付きの確率的な意思決定を出力する」と表現されています。重要な特性は3つあります。
出力の形は呼び出しの前に宣言します。各質問の型をあらかじめ定義し、モデルはその範囲内でしか答えられません。パースすべきテキストも、検出すべきスキーマの不一致もありません。
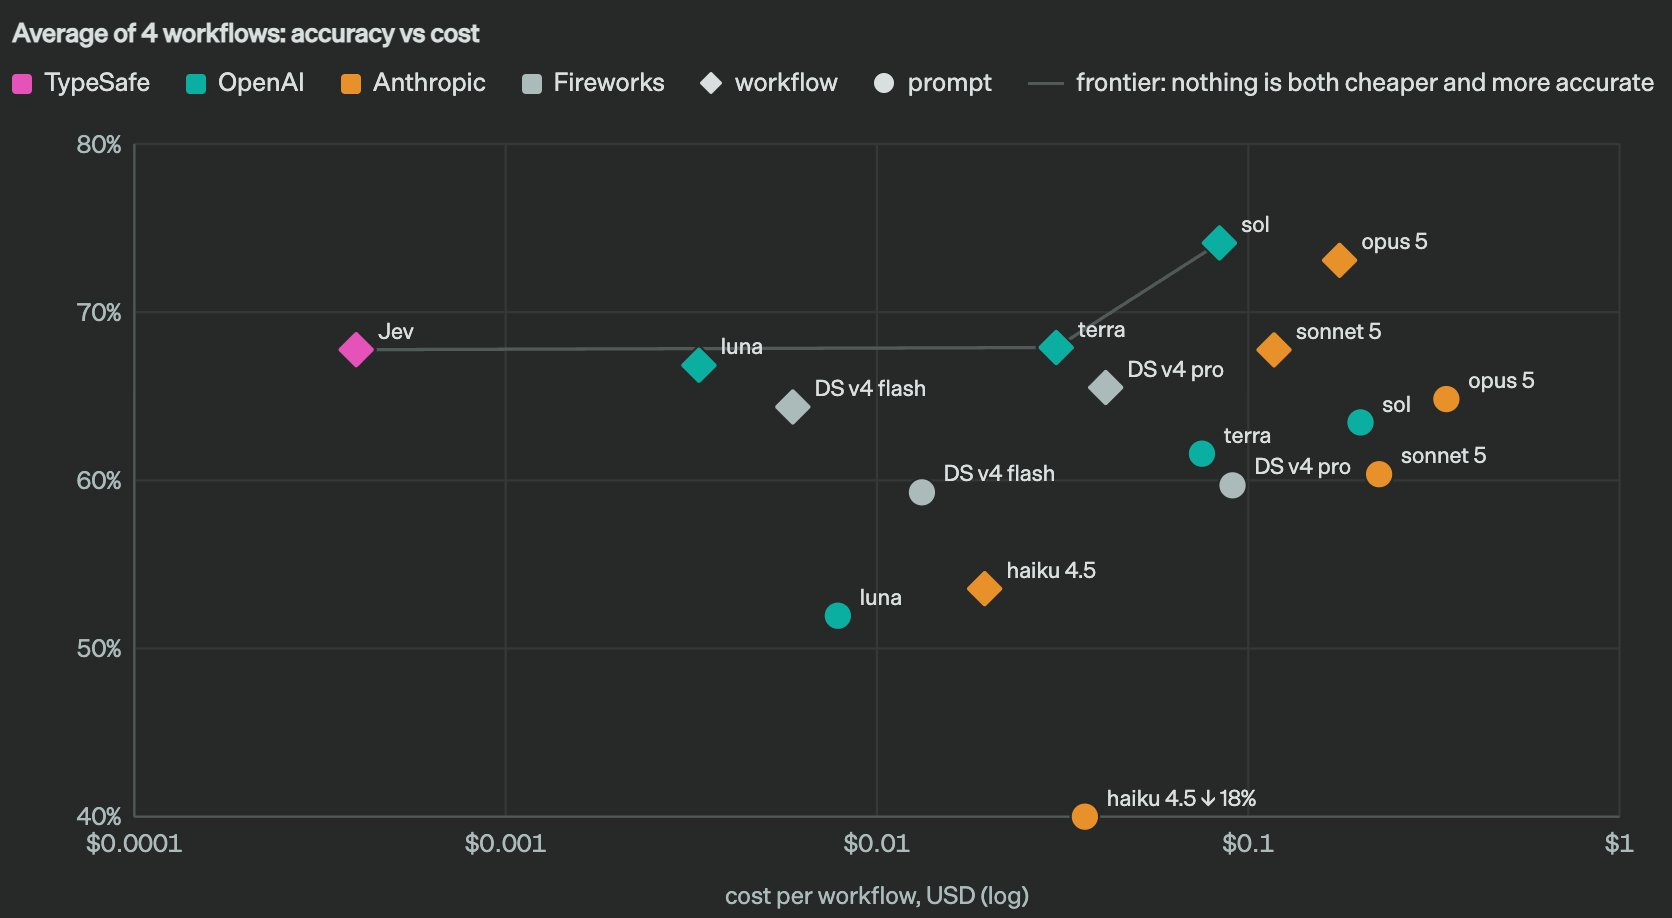
すべての答えには確率が付きます。yes/noの質問はtrueではなく0.97を返します。選択の質問は選択肢全体の分布を返します。TypeSafeはこれを「Reinforcement Learning for Calibrated Decisions(較正された意思決定のための強化学習)」と呼ぶ手法で学習させたといい、信頼度が高いほど精度も高くなるため、しきい値を設定できると主張しています。しきい値を超えたら自動化し、残りは人に回す、というわけです。
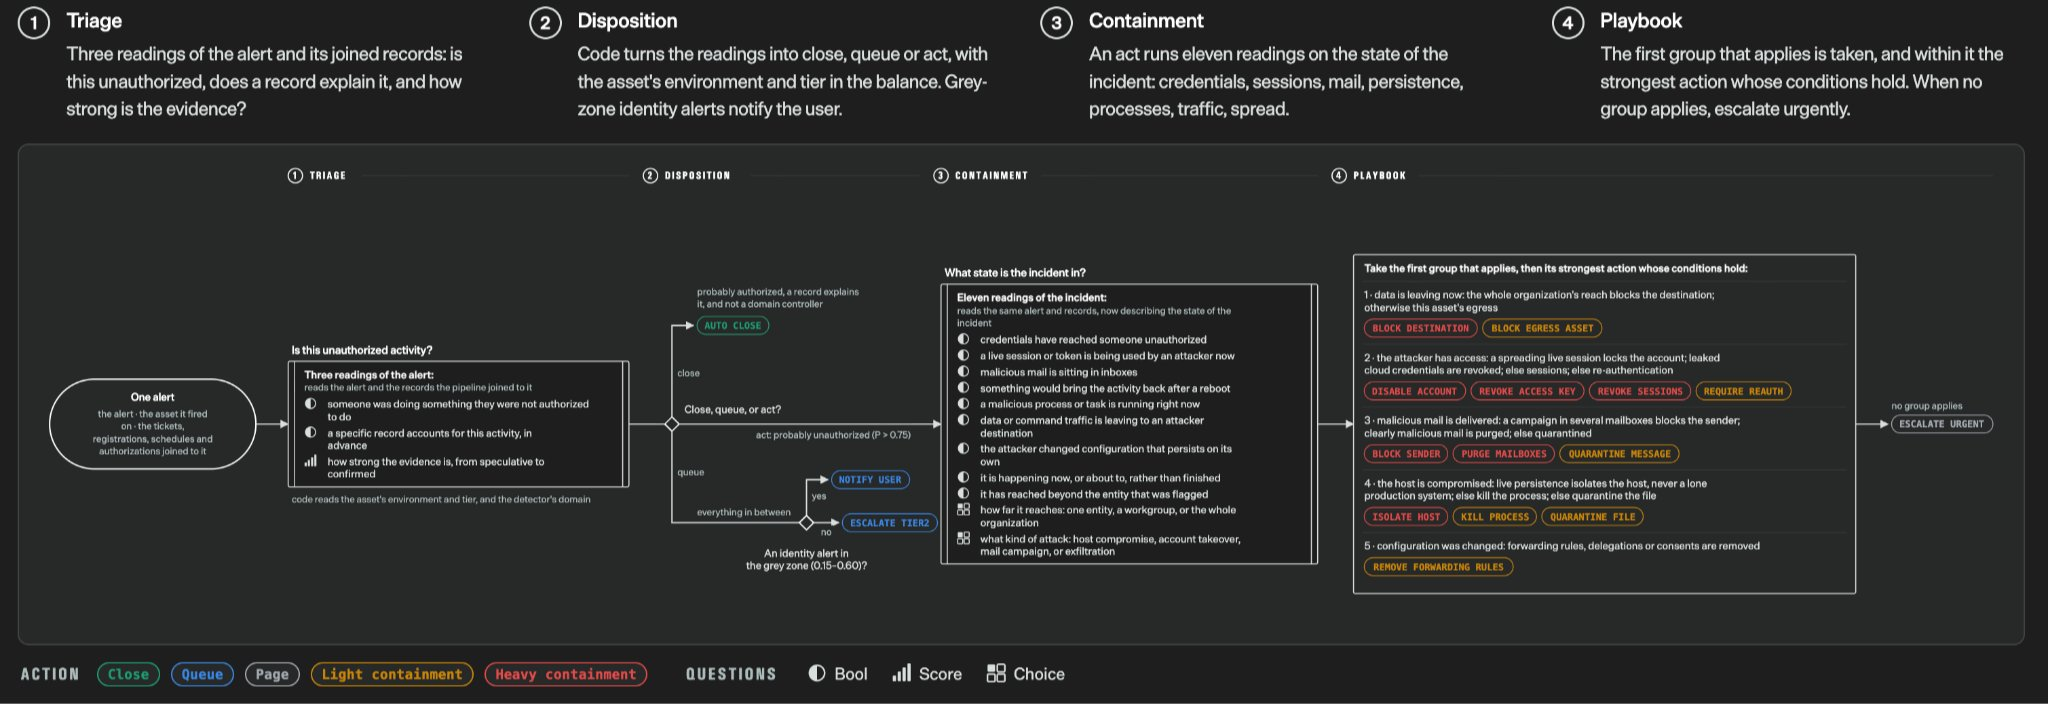
すべての質問は1回のリクエストで並列に処理されます。TypeSafeがエンドツーエンドで70ms〜500msという数値を挙げているのはそのためです。これはベンダーの数値であり、独立したベンチマークではありませんが、アーキテクチャを見れば納得できます。トークンを1つずつ生成する処理が一切ないからです。
3種類の質問タイプ
JevのAPIは3つのプリミティブを提供します。それぞれが任意のキーの下に置くJSONオブジェクトで、すべて同じstateに対して評価されます。
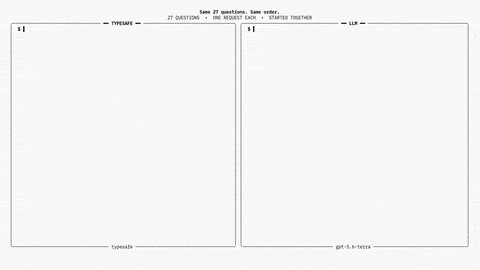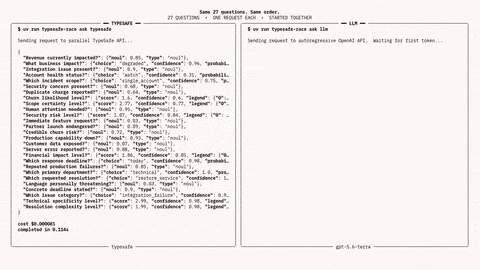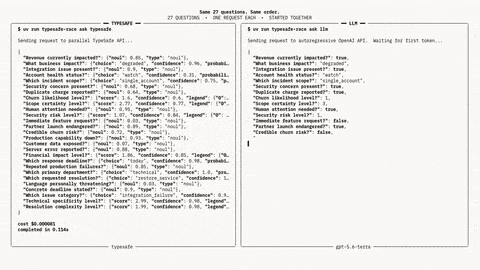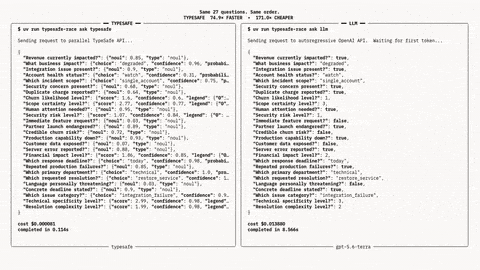
Noulはyes/noの確率です。{"type": "noul", "instructions": "Does this run need a human before merge?"}は{"noul": 0.91}を返します。しきい値の判定はコード側で行います。
Choiceは最大255個の名前付き選択肢から1つを選びます。選択肢名と説明を対応させたcriteriaを渡すと、答えには選択結果、分布全体、信頼度が含まれます。
Scoreは状態を2〜10段階の順序付きルーブリック上に位置づけます。答えは確率で重み付けされた位置になるため、あるバグが「回避策あり」と「ブロッキング」の間の1.3というスコアになることもあります。
Vercel AI SDK経由ではyes/noタイプはbooleanと呼ばれ、フィールドはprobabilityです。TypeSafe自身のエンドポイントに対してはnoulになります。同じ考え方で、キーが違うだけです。
意思決定モデルはエージェントの上位層のどこに位置するか
私たちが使っているメンタルモデルはこうです。モデルはトークンを生成します。コーディングエージェント(Claude Code、Codex、Gemini CLI、OpenCode)はトークンをComputer上の変更に変換します。管理レイヤーは、誰が何に取り組むか、結果をどう扱うかを決めます。Jevは中間層ではなく、この最上位レイヤーに属します。エージェントではなく、ファイルを編集することもできません。管理上の問いに対する、高速で型付きの答えです。
エージェントを並列で動かすどのボードでも必ず出てくる3つの問いがあり、それぞれがJevのプリミティブに対応します。
このTaskはどのAssigneeが担当すべきか? Agentsを対象にしたChoiceで、criteriaにはそれぞれが得意なことを記述します。状態はTaskのタイトル、説明、リンクされたリポジトリです。これはAIバックログ管理とトリアージで説明したトリアージのステップを、人が40件のチケットを読む代わりに100msの1回の呼び出しで行うものです。
この実行はマージ前に人が必要か? 実行のdiffサマリー、テスト結果、変更されたパスに対するNoulです。0.85を超えればレビューのために保留し、0.15未満なら承認ゲートを通過させ、その間ならフラグを立てます。狙いはレビュアーをなくすことではなく、レビュアーの午後を本当に必要な実行に確実に充てることです。
この変更はどれくらいリスクが高いか? 「見た目だけ」から「認証や決済に触れる」までのScoreを、同じ状態に対して適用します。この数値がレビューキューを並べ替えます。これはコーディングエージェントが完了した作業を追跡することの主な目的でもあります。
コミュニティのほうが先にたどり着いていました。ローンチ後の1週間で、開発者たちはJev上に構築された段階的なコードレビューワークフロー、どのツール呼び出しを残すかについてのJevの判断でコンパクションのサマリーを置き換えるClaude Codeプラグイン、そしてJevで作業を振り分ける「ソフトウェアファクトリーの現場監督」を公開しました。そのどれもがエージェントの上位にある意思決定レイヤーであり、これこそが重要なパターンです。
正直な意思決定ルール
Jevは、答えの選択肢が固定されていて、確率も必要な問いに使います。ルーティング、深刻度、「レビューが必要か」、「行き詰まっているか」、「このPRの説明は正直か」。これらはボードが1日に何百回も尋ねる問いです。
状態に含まれない判断を要する問いにはJevを使いません。「このアーキテクチャは正しいか」はChoiceではありません。「顧客はこれを受け入れるか」はScoreではありません。そうした問いに対する確率は、意思決定に見えるただの数値です。その線の向こう側には、人か、推論を説明できる言語モデルを置いておきましょう。
また、確率でレビューゲートを置き換えてはいけません。「マージしても安全」に対する0.96は、その実行を人のキューの先頭に置く強いシグナルであって、人を飛ばす理由ではありません。Sharklyが引く境界は、チームの判断が必要なところで自動化を止めるというものです。意思決定モデルがその線を動かすことはありません。線の人側にあるキューを短くし、より適切に並べるだけです。
呼び出し方
直接呼び出す場合:console.typesafe.aiのBearerキーを使ってPOST https://api.typesafe.ai/v1/systemone、モデルはjev-latest(現在はjev-1.13.0)。Vercel AI Gateway経由の場合:AI SDK 7のexperimental_evaluateでモデルtypesafe-ai/jevを指定します。なお、Gatewayのドキュメントによると、評価はAI SDK経由でのみ利用可能で、OpenAI互換エンドポイントでは使えません。
3つの質問すべてに一度に答えるトリアージ呼び出しは次のとおりです。
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
TypeSafeのモデルページによる価格は、入力100万トークンあたり$0.042、出力は課金なし、1リクエストあたり64kトークン(うち状態に32k)、テキストのみです。この価格なら上のトリアージ呼び出しは1セントの何分の一かにしかならず、すべてのTaskとすべての実行で動かすことが現実的になります。
Sharklyとの関係
Sharklyはあなたの代わりにJevを呼び出すことはなく、それ自体が意思決定モデルでもありません。Sharklyは、すでに動かしているエージェントを取り巻く、共有されたTask、Computer、コンテキスト、レビューのレイヤーです。Jevのようなモデルが与えてくれるのは、そのレイヤーが表面化させるルーティングとレビューの意思決定を、安価で型付きの方法で行う手段です。どのAssigneeか、どのキューか、どれくらい緊急か。Taskを作成してAgentを選ぶAutomationに組み込むことも、完了した実行の出力をレビュアーに届く前に処理させることもできます。どちらの場合も、意思決定は人が見られる場所に残ります。確率が何と言おうと、これは守られなければならない部分です。
複数のエージェントを動かしていて、レビューキューが痛手になっているなら、Sharklyをはじめるで、意思決定モデルが組み込まれるボード、Computers、レビューフローについて説明しています。
FAQ
Jevはコーディングエージェントですか?
いいえ。コードを生成したりファイルを編集したりはできません。与えられた状態について宣言された質問に、確率とともに答えるだけです。作業を生み出すのはエージェントで、Jevはその扱いを決める手助けをします。
コードレビューを置き換えられますか?
いいえ、置き換えるべきでもありません。レビューキューを順位付けし、明らかなケースをそこから取り出すことはできます。マージするかどうかの判断は人に残ります。このワークフロー全体が依存している境界がそこにあります。
較正済みとはどういう意味ですか?
Jevが0.9と言ったら、その種の質問で約90%の確率で正しいはずです。しきい値を信頼する前に、自分の実行で検証してください。数十件のラベル付きdiffがあれば、その数値が言うとおりの意味を持つかどうかを確認できます。
使うのにVercelは必要ですか?
いいえ。直接APIはBearerキーで使えます。Gatewayは、すでにAI SDKを使っている場合の便利な手段です。


