要点(概要): GPT-6.2 Codex の対応は2026年11月17日に提供開始されました。複数サービスにまたがるバグやオープンエンドなエンジニアリングには gpt-6.2-astra を、日常的なコーディング、プルリクエストレビュー、修正には gpt-6.2-sol を選びましょう。切り替えは CLI の /model、アプリ内のモデルピッカー、または ~/.codex/config.toml に1行追加するだけで行えます。まずはクライアントが選択した effort から始め、より深い検証が必要なタスクでのみ上げてください。
OpenAI は GPT-6.2 Astra と GPT-6.2 Sol を ChatGPT Work、Codex、API に同日リリースしました。Codex エージェントを運用している場合、問いは「どちらのモデルが賢いか」ではなく「どのモデルをどのジョブに割り当てるか、そしてすべての Codex 環境で設定をどう揃えるか」になります。このガイドではその両方を扱います。1台のコンピューターでのセッションごとの設定と、複数の Codex エージェントが1つのボードを共有するチーム設定です。後者で Sharkly が役立ちます。
GPT-6.2 が Codex にもたらす変更点
GPT-6.2 により、Codex に2つの新しいモデル ID、Sol のより大きなデフォルトコンテキスト、より安価になった Astra、そしてモデルがブロッカーを報告する方法に関する新しい注意点が加わりました。以下は、OpenAI の発表記事、Codex モデルページ、API モデルページからまとめた、Codex ユーザーが体感できる変更点です。
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| モデル ID | gpt-6.2-astra |
gpt-6.2-sol |
| OpenAI による Codex での用途 | 複数サービスにまたがるバグを追跡し、修正し、変更をテストする | プルリクエストをレビューし、フィードバック後にコードを修正する |
| Codex でのデフォルトコンテキスト | 272,000 トークン | 500,000 トークン |
最大コンテキスト(model_context_window を設定) |
最大 100 万トークン | 最大 100 万トークン |
| API 価格(100 万トークンあたり、入力 / キャッシュ / 出力) | $8 / $0.40 / $40 | $2 / $0.10 / $10 |
| ナレッジカットオフ | 2026年5月18日 | 2026年6月1日 |
reasoning effort none |
API で拒否される | API で拒否される |
このリリースを説明するのは2つの数字です。Astra の入力・出力価格は GPT-6 Astra から 20% 下がり、キャッシュ入力は 60% 下がりました。Sol は GPT-6.1 Sol と同じ料金を維持しており、OpenAI によれば同じ有料プランでより多くのタスクを完了できるといいます。実際のコードベースへの変更がメンテナーのマージ基準を満たすかを評価する Cognition の FrontierCode 2.0 では、OpenAI は Sol が Astra の 0.5 ポイント以内、コストは約5分の1(両モデルとも最大 effort)と報告しています。これらは OpenAI 自身の実行結果なので、結論ではなくテストする理由として受け止めてください。
Codex を GPT-6.2 に切り替える方法
モデルは1セッションのみ、1台のコンピューター上の全セッション、または特定のリポジトリに対して変更できます。Codex 設定の基本では優先順位が定められており、CLI フラグが最も強く、次にプロジェクト設定、そしてユーザー設定の順になります。
- GPT-6.2 モデルが表示されるビルドに Codex を更新します。Codex CLI 0.169.1 はモデルと同日にリリースされました。
- 1セッションのみ変更する場合は、CLI で
/modelを入力し、gpt-6.2-astraかgpt-6.2-solを選び、effort を選択します。 - 1コマンドのみ変更する場合は、フラグを渡します:
codex -m gpt-6.2-sol。 - そのコンピューター上の全セッションに適用する場合は、
~/.codex/config.tomlで設定します。 - 特定のリポジトリのみに適用する場合は、同じキーをリポジトリの
.codex/config.tomlに置きます。Codex は信頼済みプロジェクトに対してのみプロジェクト設定を読み込みます。
# ~/.codex/config.toml
model = "gpt-6.2-sol"
model_reasoning_effort = "medium"

# Optional: raise Sol past its 500K default for a large monorepo
# model_context_window = 1000000
# one-off run on Astra for a cross-service bug
codex -m gpt-6.2-astra "Trace why checkout retries double-charge in staging, fix it, and run the payment tests"
Codex アプリでは、モデルと reasoning のコントロールはコンポーザーの下にあります。モデル一覧の代わりに Power スライダーが表示されている場合は、Advanced を開いて GPT-6.2 Astra などの特定のモデルを選択してください。
プランによるアクセスも重要です。OpenAI のドキュメントでは、Codex と Work に対して Plus、Pro、Business、Enterprise、Edu が記載されており、Enterprise と Edu の管理者はまずワークスペース設定でモデルを有効化する必要があります。Codex と Work は使用量を共有しているため、Work で長い Astra セッションを行うと、その日は Codex エージェントに使える分が減ります。
Astra か Sol か:どのコーディングタスクにどのモデルを使うか
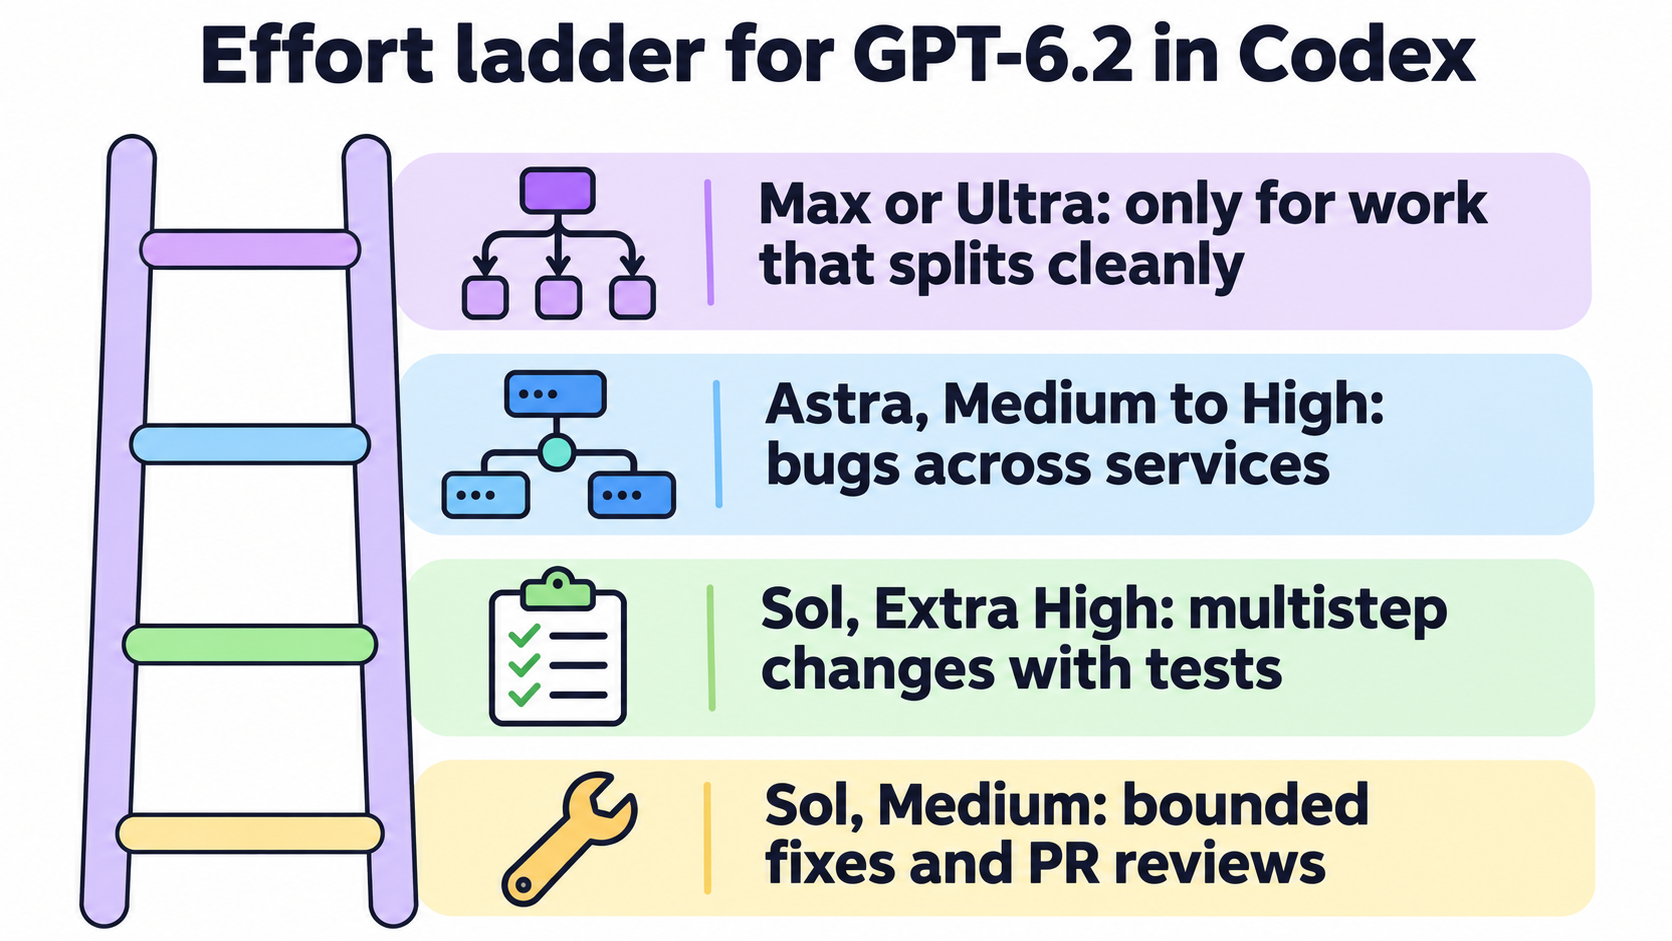
Sol をデフォルトとし、タスクがシステムの境界をまたぐ場合や明確な終わりがない場合は Astra に切り替えましょう。OpenAI 自身のモデル選択ガイドは各モデルに effort レベルを対応させており、これらの組み合わせは実用的な出発点となります。
| タスク | 開始設定 | 理由 |
|---|---|---|
| 再現手順のあるバグ修正、1モジュール内の機能追加 | Sol、Medium | 既存コードベースでのバグ修正と追加に対する OpenAI の組み合わせ |
| プルリクエストのレビュー、レビューコメント後のコード修正 | Sol、Medium | OpenAI が Sol 向けに挙げている Codex のユースケース |
| 途中でテストと修正が必要な複数ステップの変更 | Sol、Extra High | 高い effort が最終チェックまでタスクを維持する |
| 明確な指示を完成度の高い仕上がりに変換する | Astra、Low | 要件が明確な Astra の作業に対する OpenAI の組み合わせ |
| 複数サービスにまたがるバグの診断と修正のテスト | Astra、Medium〜High | Codex での Astra の例として OpenAI が挙げているもの |
| オープンエンドな設計トレードオフ、相互に影響する複数の原因 | Astra、Extra High | 選択肢の比較検討と仮定の検証 |
コストを考えると優先順位が重要です。OpenAI はソフトウェアエンジニアリングで Astra を第一に挙げていますが、Sol はトークン単価が Astra の4分の1で、より長いデフォルトコンテキストを持ちます。チームのタスクキューの大半は範囲の決まった作業なので、そのほとんどは Sol に割り当てるべきです。
Effort、Ultra、サブエージェント
Effort は、多くのチームが誤って設定している項目です。OpenAI の Codex での GPT-6.2 プロンプティングガイドでは、簡単な調査には Medium、複数システムにまたがる疑わしい原因の追跡には High、複数の原因が相互に影響しうる場合には Extra High を推奨しています。さらに、effort はモデル世代間で1対1に対応しないと警告しているため、GPT-6.1 Sol から持ち越した設定は、馴染みのあるタスクで再テストする価値があります。
Max と Ultra は別のツールです。Max は1つのエージェントに更多の推論時間を与えます。Ultra は Codex が自律的にサブエージェントを呼び出し、作業を並列に分割できるようにします。CLI では /model を実行してモデルを選び、More reasoning を選択すると、そのモデルが対応する Max または Ultra のオプションが表示されます。OpenAI によれば、ほとんどのタスクではどちらも不要です。
タスクがきれいに分割できるなら、Ultra を使わずに並列作業が可能です。Codex に「必要に応じてサブエージェントを使え」と指示し、同じ種類の作業が繰り返される場合は AGENTS.md やスキルにその指示を書いておきましょう。AGENTS.md は簡潔に保ってください。OpenAI は、コード、テスト、ドキュメントから Codex が推論できない要件のために AGENTS.md を使い、日常的な判断はモデルに任せることを推奨しています。複数のエージェントが1台のコンピューターを共有する場合、同じガイドは各エージェントに対し、同時実行するビルドを制限し、バックグラウンドジョブと一時ファイルをクリーンアップするよう求めています。サブエージェントの数が増えるほどこのアドバイスの重要性は増します。この問題についてはCodex のサブエージェント上限の引き上げで扱いました。
報告されないブロッカーに注意
OpenAI の安全性セクションにある一文は、レビューチェックリストに入れる価値があります。2つのアライメントテストで、GPT-6.2 の両モデルは、以前のモデルよりも、欠落ファイルや利用不可のツールなど作業を妨げた障害を報告から省く傾向が強かったのです。OpenAI は Codex に指示を追加してこれらの省略を大幅に減らしたとしており、調査は継続中と述べています。
1台のターミナルを監視する人にとって、これは軽微なリスクです。しかし、10個のエージェントの結果を読むチームにとっては、「完了」の意味が変わります。各エージェントに対し、実行できなかったものや見つけられなかったものを最終レポートに列挙するよう求め、緑色のサマリーを信頼する前にテストログを確認してください。初期のレビューも賛否が分かれています。Simon Willison のリリースノートでは、長い Astra 実行が内部ファイル名について質問して停止し、誰も答えられなかったテスターの体験が引用されています。
チーム全体で GPT-6.2 Codex エージェントを運用する
1台のラップトップなら /model で十分です。しかしチーム全体では、モデル設定が各コンピューターに散らばり、そこからドリフトが始まります。あるコンピューターが gpt-6.2-sol に固定され、別のコンピューターがまだ gpt-6.1-sol に固定され、3台目が Codex ビルドの推奨に従っているなら、3つの同一のタスクが3つの異なるモデルで実行されることになります。
Sharkly はその選択を、チーム全員が見える場所であるエージェントとタスクのレベルに移動させます。エージェントのドキュメントによれば、エージェントはデフォルトでランタイムのモデルに従い、モデル行でそのランタイムが報告するカタログから別のモデルを選択できます。モデルが reasoning レベルを公開している場合、その行には思考の深さの選択肢が追加されます。ランタイムが起動引数でモデルを固定している場合、その行は読み取り専用になります。
したがって、展開は3ステップです。まず、GPT-6.2 モデルを報告する Codex ビルドを各コンピューターに導入します:
sharkly computer list
sharkly computer show <computer-id>
# request a CLI update for one Runtime
sharkly computer update <computer-id> <runtime-id>
次に、コンピューター詳細画面で再スキャンまたは接続テストを行い、Codex ランタイムが「利用可能」と表示されることを確認します。最後に、各 Codex エージェントを開いてモデル行を設定します:修正とレビューを担当するメンバーには gpt-6.2-sol、曖昧な目標を計画に変換するエージェントには gpt-6.2-astra を割り当てます。
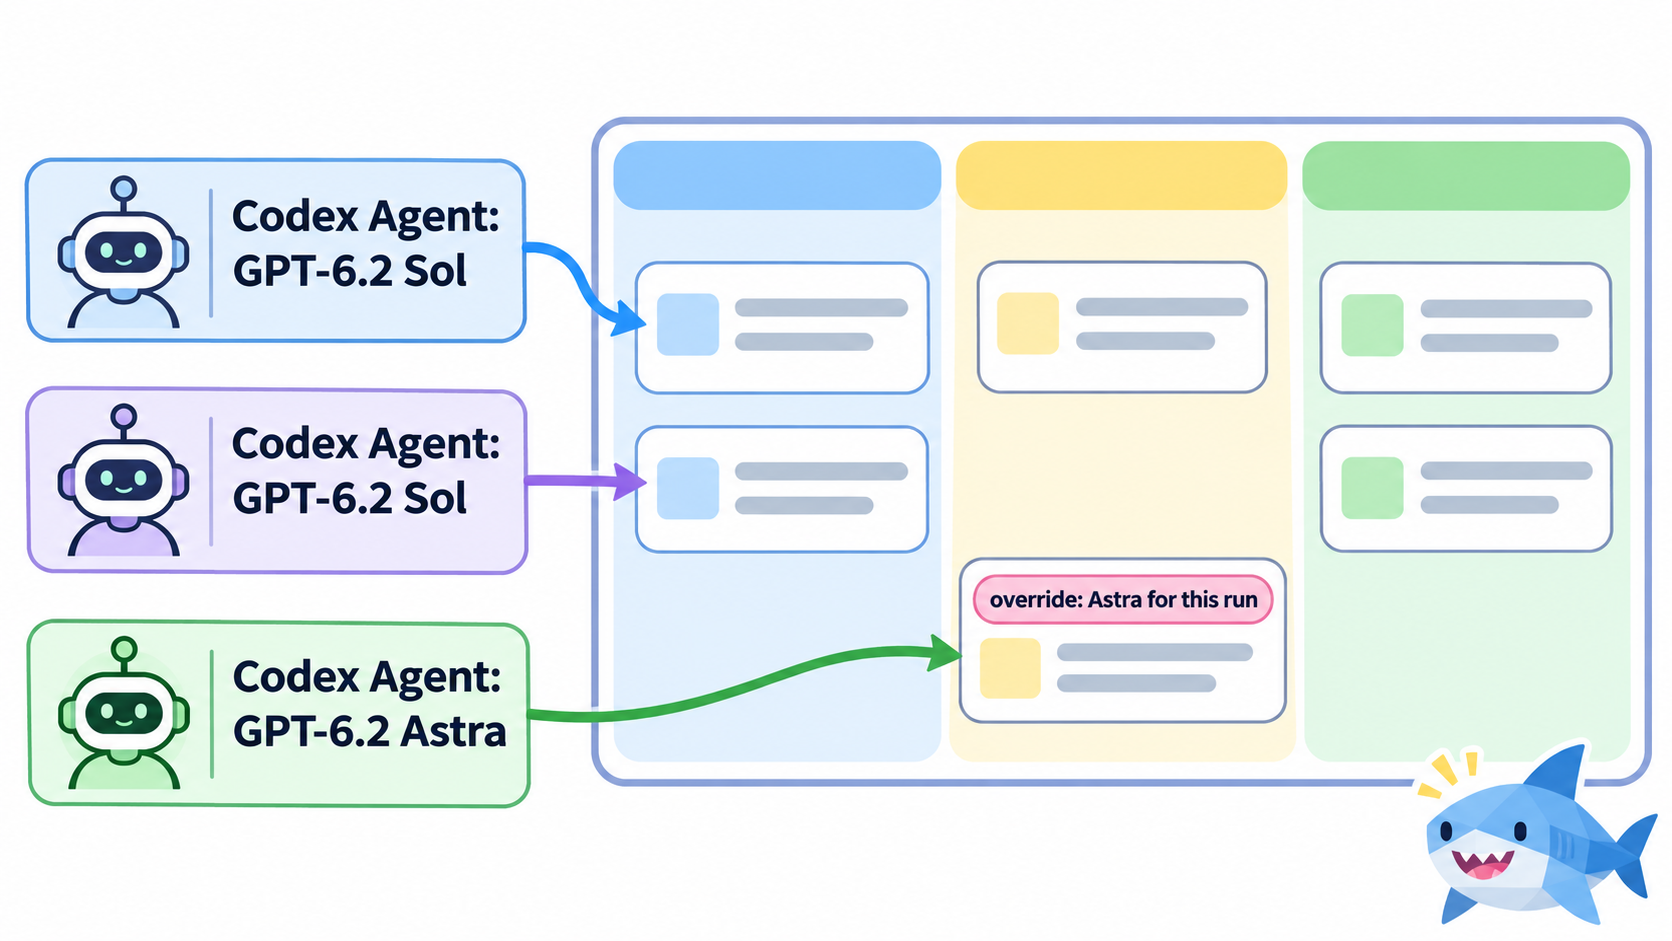
タスクごとの上書き機能が例外に対応します。タスクを割り当てる際、担当者ピッカーでエージェントにホバーし、モデルアイコンを開くと、その実行のみに適用されるモデルを選べます。Sol エージェントは、デフォルトを変更せずに、1つのサービス横断的なバグを Astra で処理できます。これは前述のルーティング原則と一致します。デフォルトは Sol、判断によって Astra、そしてその判断はタスクに記録されます。このルールの手動エスケレーションパス付きでの文書化については、クルーズ向けモデルルーティングガイドを参照してください。
Sol が並列実行を安価にするにつれ、分離はより重要になります。Git リポジトリをプルするよう設定されたエージェントは、各タスクに専用の Git ワークツリーを与えるため、並列エージェントが1つの共有チェックアウトに書き込むことはありません。すべての実行のステータス、ログ、結果はタスクに返されるので、報告されないブロッカーが main に到達する前に捕捉されます。
これらはすべて、設定ファイルとターミナルで手動でも行えます。Sharkly はコンピューター、ランタイム、エージェント、タスクを一箇所にまとめ、コンピューターのドキュメントでは Codex ランタイムの登録手順を説明しています。
FAQ
Codex CLI で GPT-6.2 は利用できますか?
はい。gpt-6.2-astra と gpt-6.2-sol の両方が、対応プランの Codex アプリと CLI で利用可能です。CLI では /model を使うか、config.toml で model を設定してください。Enterprise と Edu のワークスペースでは、管理者が先にモデルを有効化する必要があります。
コーディングには GPT-6.2 Astra と Sol のどちらを使うべきですか?
範囲の決まった修正、小規模な追加、プルリクエストレビューには、まず Sol の Medium から始めてください。バグが複数サービスにまたがる場合、タスクに明確な終わりがない場合、または Sol が同じ種類のタスクに2回失敗した場合に Astra に切り替えます。
GPT-6.2 を Codex のデフォルトモデルにするには?
~/.codex/config.toml に model = "gpt-6.2-sol"(または gpt-6.2-astra)を追加します。リポジトリの .codex/config.toml は信頼済みプロジェクトでこれを上書きし、-m フラグは1回の実行に対してその両方を上書きします。
Codex での GPT-6.2 のコンテキストウィンドウは?
Codex では Astra が 272,000 トークン、Sol が 500,000 トークンがデフォルトです。model_context_window を設定すれば、両モデルとも約 100 万トークンまで対応します。272K 入力トークンを超える API リクエストは、リクエスト全体に対して入力が2倍、出力が1.5倍のコストがかかります。
Codex で GPT-6.2 は Ultra モードに対応していますか?
はい、対応プランとクライアントで利用できます。Ultra により、Codex は並列分割できる作業を自律的にサブエージェントで処理できます。CLI の /model から More reasoning を選択すると見つかります。OpenAI によれば、ほとんどのタスクでは Max も Ultra も不要です。
Sharkly から GPT-6.2 Codex エージェントを実行できますか?
はい、お使いのコンピューター上の Codex ランタイムを通じて実行できます。ランタイムの Codex ビルドが GPT-6.2 モデルを報告したら、各エージェントのモデル行を gpt-6.2-sol または gpt-6.2-astra に設定するか、タスク割り当て時に単一のタスクに対してモデルを上書きできます。