結論から言うと: AIが生成したコードはオープンソースにすべきか? 法的に義務付けたルールは存在しません。オープンソース化を支持する論拠は2点あります。モデルがオープンソースコードから学習していること、そしてAIのみで書かれたコードには著作権が認められない可能性があることです。どちらの立場を取るにせよ、チームにまず必要なのは、「どのエージェントが、どのタスクから何を書き、誰がレビューしたか」という記録です。
2026年11月17日、「All AI-generated code should be Open Source(すべてのAI生成コードはオープンソースであるべき)」というタイトルの投稿が1,200ポイント超、コメント650件以上でHacker Newsのトップに立っていました。スレッドは熱い議論になっていますが、その根底にある問いは実務的なものです。コードベースのうちエージェントが書く割合が増え続けるなら、そのコードの所有者は誰で、どんなライセンスの下に置かれ、壊れたときに誰が責任を負うのか?
「AI生成コードはオープンソースであるべき」という主張の内容
AI生成コードをオープンソース化すべきという主張は、倫理的な主張と法的な主張の組み合わせです。モデルはオープンソースやCreative Commonsのコードで学習されているのだから、その出力をクローズドにするのはライセンスの「洗浄」に当たる、また、人間の作者のいないコードにはそもそも著作権が成立しない可能性が高いのだから、オープンライセンスかCC0で公開すべきだ、というものです。
Jakub Jankiewiczの投稿は、4つの論点から成り立っています:
- 学習データ。 モデルは何十年分ものオープンソースコードや、帰属表示を義務付けるCreative Commonsライセンスの下にあるStack Overflowの回答から学習した。それをクローズドなコードに変えるのは「ライセンスの洗浄のように感じられる」、と彼自身が言っています。
- 作者性。 純粋にAIが生成したコードには人間の作者がいないため、著作権保護を受けられないはずだ。彼は「猿の自撮り」をめぐる紛争や、米国著作権局のAIに関する立場を引用しています。
- 法域の違い。 英国など一部の国では、コンピュータ生成の著作物に限定的な保護を与えており、ルールは世界中で統一されていない。
- 救済策。 開発者はAI生成コードをオープンソースライセンスで公開するか、CC0でパブリックドメインに捧げるべきだ。少なくとも、人間がプロンプトを書く以上のことをほとんどしていないコードについては。
この最後の点がチームにとって最も重要です。彼が問題視しているのは、誰もレビューも変更もしていないコードであって、人間が設計しエージェントがタイピングしたコードではありません。
著作権とAI生成コード: 法律は今どうなっているか
この主張の法的な側面は、米国では一定の支持がありますが、その他の国では支持が弱いのが現状です。
2025年1月、米国著作権局はAIに関する報告書のパート2(著作権適格性について)を公表しました。その立場はこうです。著作権には人間の作者性が必要である、プロンプトだけでは通常、出力に対する十分なコントロールを人間に与えたとは言えない、ただし出力の選択、配置、修正といった人間の貢献は保護されうる、というものです。2025年3月には、D.C.巡回区控訴裁判所がThaler v. Perlmutterにおいて、著作権法は人間の作者を要求するとの判断を確定させました。
英国は異なる立場を取っています。Copyright, Designs and Patents Act 1988第9条(3)は、コンピュータ生成の著作物の作者を、その作成に必要な手配を行った者とみなしています。
つまり米国では、エージェントが生成し人間が実質的な編集を加えていないファイルは、著作権保護が弱いか、あるいは一切ない可能性があります。開発者が構造を変更し、削り、拡張したファイルには、おそらく保護が成立します。ほとんどの本番コードはその中間に位置し、境界線はレビュープロセスの中を通っています。
反論を並べて比較する
スレッドで最も力のある反論は、「著者は法律を間違えている」というものではありません。それは、その主張から何が導かれるかに関するものです。
| 主張 | 反論 |
|---|---|
| モデルはオープンソースで学習したのだから、出力もオープンにすべき | 学習データに関する主張は現在も法廷で争われており、出力へのライセンス付与で決着はつかない |
| 著作権が成立しないコードは公開すべき | 「著作権が成立しない」は「公開済み」と同義ではない。著作権局の報告書にはコードの公開を義務付ける内容は何もない |
| 労力のかかっていないコードは保護に値しない | 労力ゼロの本番コードはほぼ存在しない。仕様、レビュー、テスト、編集はすべて人間の作業 |
| オープンライセンスはコモンズへの敬意 | 一括したCC0適用は、同じファイルに混在した人間の貢献から保護を奪う恐れがある |
| ルールは国際的に統一されるべき | 著作権法は国ごとのもの。前述の英国のルールはすでに米国と異なる |
両方の列が何を前提としているかに注目してください。どの行も、ある変更のうちどれだけがエージェント由来で、どれだけを人間が形にしたかを知っていることに依存しています。その記録なしには、ライセンスポリシーを決めることも、顧客からの由来に関する質問に答えることも、作者性を主張することもできません。
エージェントが書いたコードの責任は誰が負うのか?
ライセンスをめぐる議論は未決着です。しかし説明責任の問題は未決着ではありません。変更をマージした人がその責任を負います。最初の草稿を何が書いたかは関係ありません。
これが、エージェントの作業の人間による所有についての当社の投稿の中核となる考え方です。エージェントが書いたコードのバグも、あなたのバグです。エージェントのプルリクエストで秘密情報が漏れたら、それはあなたのインシデントです。
エージェントは調査し、実行し、テストし、報告します。人間は方向性を定め、権限を与え、結果を受け入れます。オープンソースをめぐる議論はこの役割分担を変えるものではなく、その見失いのコストを高めるだけです。
AI生成コードの由来記録: 何を記録すべきか
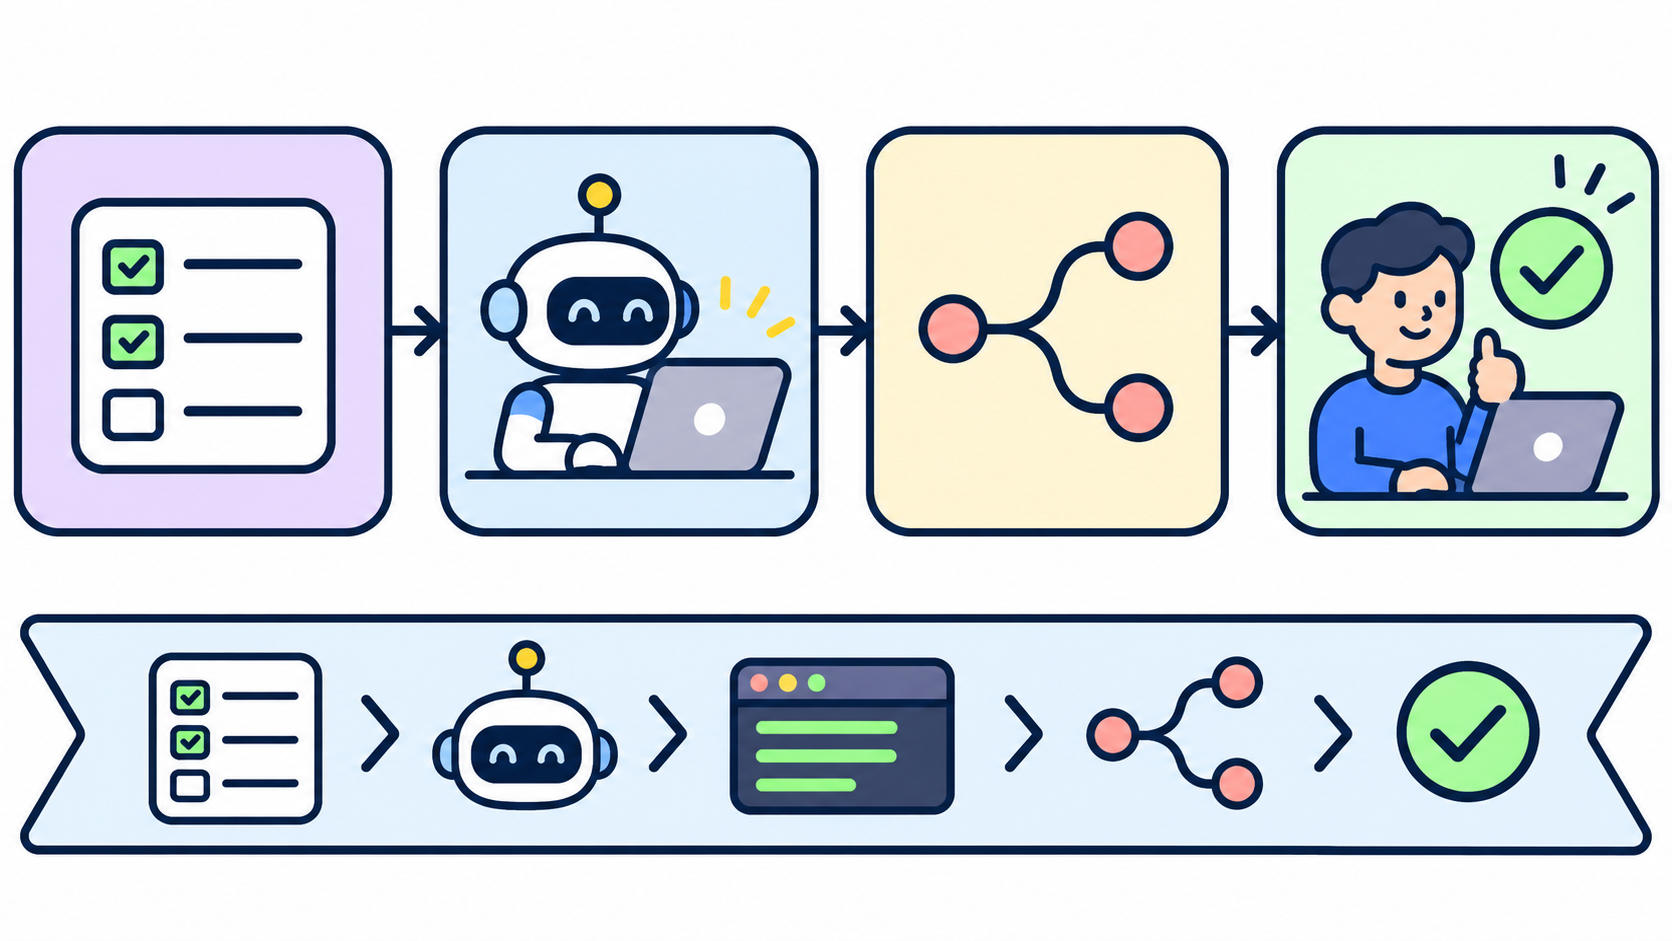
由来(プロビナンス)とは、ある変更がどこから来たかを示す記録です。エージェントが書いたコードについては、有用な記録は次の6つの問いに答えるものです:
- どのタスクがその変更を要求したか。要件と受け入れ基準を含めて。
- どのエージェントが作業を行ったか。どのランタイムとモデル上でか。
- どの実行がそれを生成したか。開始時刻、終了時刻、トリガー元を含めて。
- どのプルリクエストがそれをリポジトリに取り込んだか。
- 誰がレビューしたか、承認前に何を変更したか。
- どのライセンスがリポジトリでそのコードに適用されているか。
ほとんどのチームは、この一部をすでに持っています。プルリクエストにはdiffとレビュアーが記録されています。Gitはコミットトレーラーで構造化されたメタデータを運べます。Claude Codeをはじめ一部のコーディングエージェントはデフォルトで共同作作者のトレーラーを追加しており、その慣習に独自のキーを追加することもできます:
fix(auth): return 401 instead of 500 on expired refresh token

Refresh tokens past their TTL threw an unhandled TokenExpiredError
in the session middleware. Map it to a 401 with a retry hint.

Co-Authored-By: Claude <[email protected]>
Agent-Task: COIN-1287
Agent-Run: 3f9c2a71-0b4e-4c8a-9d51-6e2f4b7a1c09
Reviewed-By: Priya Shah
Human-Edits: renamed handler, added regression test
トレーラーはコミットと共に移動するため、リポジトリの移転後も残ります。しかし実行そのもの、つまりツール呼び出し、失敗した試行、最終的な形に至った議論までは保持できません。
ファイルレベルでのライセンス管理には、SPDX識別子とREUSEの規約が、ツールで検証可能なライセンスヘッダーを各ファイルに与えてくれます。生成されたアセットの一部をCC0で公開するとチームが決めたなら、その決定が検証可能になるのはまさにここです。
Sharklyがタスク上に記録を保持する仕組み
Sharklyは、人間とコーディングエージェントのためのワークマネジメントシステムです。タスクは人間に割り当てるのと同じようにエージェントに割り当てることができ、タスクがチーム全体の共有記録であり続けます。
その記録こそ、ほとんどのチームに欠けている由来の履歴です:
- タスクには、要件、担当者、コメント、添付ファイル、タスク変更のアクティビティタイムラインが記録されます。
- 実行ログには、実行ごとに、キューに入れられた理由、開始・終了時刻、ツール呼び出しとランタイムイベント、トリガー元、失敗の詳細が記録されます。タスク実行のドキュメントに説明があります。
- エージェントのコメントはチーム向けのものとして実行に紐付いたコメントとして保存され、説明が証拠の隣に置かれます。
- レビューシグナル: エージェントはタスクを人間のレビュー待ちの状態にでき、黙ってマージされるのではなく、責任者にルーティングされます。
- プルリクエストのリンク: GitHubインテグレーションはプルリクエストをリンクし、イシューをスペースに同期するため、コード変更とタスクが互いを指し示します。
Sharklyはライセンスを決めるものではなく、コンプライアンス製品でもありません。ライセンスの判断が依存する事実を、プライベートなターミナルセッションの代わりに一箇所に保持します。
今週から導入できる由来記録ポリシー
上記の6つの問いに答えられる、最小限のポリシーを使いましょう。まずはこれから:
- エージェントの変更1件につきタスク1件。 タスクIDなしでエージェントの作業を行わない。雑談的なチャットでの調査は構いませんが、リリースされるものにはタスクを付ける。
- タスクIDをブランチ名とコミットに入れる。 トレーラーかブランチ名のプレフィックスがあれば、後で検索するのに十分。
- 担当レビュアーの名前を必須にする。 レビュアーの名前はプルリクエストとタスクに記載し、その編集内容も記録する。
- リポジトリごとにライセンスの一文を書く。 エージェントが書いたコードがリポジトリの既存ライセンスに従うか(ほとんどのチームのデフォルト)、別のライセンスとするかを決め、
CONTRIBUTING.mdに記載する。 - ライセンスが異なるファイルにはタグを付ける。 生成アセットにCC0やその他のライセンスを選ぶ場合はSPDXヘッダーを使う。
- 実行ログはプルリクエストと同じ期間保持する。 レビュースレッドを残すつもりなら、そのdiffを生成した実行も残す。
より踏み込んだレビューの仕組みについては、タスクレベルの証拠を使ったAI生成コードのレビュー方法とコーディングエージェントの承認ゲートの設置場所を参照してください。
エージェントが社内ツールとテストにしか触れないなら、軽量なポリシーで構いません。エージェントのコードが顧客に提供される場合、規制対象の環境で動く場合、すでにオープンソースライセンスで公開しているリポジトリに入る場合は、6ステップすべてを実施してください。
エージェントが書いたコードをオープンソース化すべきか?
おそらく、デフォルトではそうすべきではありません。このスレッドだけが理由ではなく、法律はまだ動いている途中であり、レビュー付きワークフローでのエージェントの出力のほとんどには実際の人間の貢献が含まれており、一括したCC0での公開は意図以上のものを手放すことになりかねないからです。
より良い対応は、この問いに答えられる状態にしておくことです。顧客や法務チームから「このうちどれだけをエージェントが書き、誰が確認したのか」と聞かれたとき、記録をひとつ開けば、タスク、実行、プルリクエスト、レビュアーを示せます。
すでにClaude Code、Codex、その他のコーディングエージェントを運用しているなら、1台のComputerをSharklyに接続し、低リスクのタスクを1つエージェントに割り当てて、実行が終わったときにタスク記録に何が表示されるかを確認してみてください。その記録こそがあなたの由来の履歴です。オープンソースをめぐる議論がどこに着地しようと、それは変わりません。
FAQ
AI生成コードには著作権が成立しますか?
米国では、実質的な人間の貢献のないAI生成コードには、著作権局の2025年報告書とThaler v. Perlmutter判決によれば、おそらく著作権は成立しません。ただし、出力の人間による選択、配置、修正は保護されうります。英国を含むその他の国では、コンピュータ生成の著作物への扱いが異なります。
AIエージェントが書いたコードをオープンソース化する義務はありますか?
義務付ける法律はありません。Hacker Newsの投稿は、倫理的な理由からそうすべきだと主張しているだけです。著作権が成立しないコードは自動的に公開されるものではなく、非公開のまま保持することも可能です。
AI生成コードのバグの責任は誰が負いますか?
それをマージしたチームです。エージェントが変更を書くことはあっても、プルリクエストを承認した人がその結果の責任を負います。その人をタスクとプルリクエストに記録しておきましょう。
どのコードをAIエージェントが書いたか追跡するには?
エージェントのすべての変更をタスクに紐付け、タスクIDと実行IDをコミットトレーラーに追加し、プルリクエストをタスクにリンクし、人間のレビュアーを記録します。エージェントの実行ログを保持するタスクボードがあれば、残りはそれが担ってくれます。
AI生成コードにCC0は理にかなっていますか?
フィクスチャやスキャフォールディングのような、明確に分離できる生成アセットには理にかなう場合があります。混在ファイルへのCC0適用は人間が書いた部分まで公開するリスクがあるため、リポジトリ全体のライセンスを変更するのではなく、そうしたファイルにSPDXヘッダーを付けてください。