

昼前に3つのrunを投入する。90秒後、3つのターミナルのうち2つは何も出力していない。1つはリポジトリを対象に推論している。もう1つは途中で504を踏み、二度と戻ってこない。座っている場所から見れば、どちらもカーソルが点滅する同じスクロールバックの矩形でしかない。
これは新しい問題ではないが、2026-09-22のローンチが、特定の・測定可能な形で事態を悪化させた。新しいモデルの最高推論設定は、何か言う前に長時間考えることで精度を買っている。Artificial Analysisの計測では、GPT-6 Solの「max」推論バリアントは初回トークンまで102.15秒、GPT-6 Lunaは124.23秒だった。これらは特定の構成に対する第三者計測であり、ベンダー公表値ではない。この但し書きは重要だが、方向性は疑いようがない。run開始時の沈黙は、失敗と見分けがつかないほど長くなっている。
TL;DR
Time to first tokenとは、リクエストを送信してから返信の最初の文字が届くまでの遅延のことだ。高effortの推論モデルでは、思考の大部分はこの遅延の中で行われる。ターミナルは、考えているrun、人間の返答を待っているrun、2分前に死んだrunを区別できない。どれも何も出力しないからだ。ステータスなら区別できる。エージェントは調査し、実行し、テストし、報告する。人間は方向性を示し、権限を与え、結果を受け入れる。この契約が機能するために必要なのは、誰かが見張っていなくても可視化されるrun状態だ。Sharkly は、リクエストからリリースまでコンテキスト、進捗、ブロッカー、結果、人によるレビューをTask上に保持する。だから長い思考と死んだrunが同じに見えることはもうない。
待ち時間は長くなった。そして安いモデルが速いモデルとは限らない
最大推論設定における新しいGPT-6の2モデルについて、第三者の計測結果はこうなっている。
| Model | API id | Output speed | Time to first token | Input / output per 1M tokens |
|---|---|---|---|---|
| GPT-6 Sol (max) | gpt-6-sol |
115.2 tokens/s | 102.15s | $2 / $10 |
| GPT-6 Luna (max) | gpt-6-luna |
153.9 tokens/s | 124.23s | $0.10 / $0.50 |
最後の2列を合わせて見てほしい。LunaはトークンあたりのコストがSolの20分の1なのに、話し出すまでの待ち時間は長い。コストとレイテンシは別々の軸であり、「安いモデルほどキビキビ動く」という直感はここでは単純に当てはまらない。
この数値でダッシュボードを作る前に、正直な但し書きを2つ。第一に、数値はOpenAIではなくArtificial Analysisによるもので、「max」推論バリアントに固有のものだ。より低いeffort設定はまったくの別物であり、実際の数値はプロンプトサイズ、利用可能なツール、トラフィックの処理先によって変わる。第二に、time to first tokenは出力速度と同じ指標ではない。Anthropicは Claude Opus 5.5 がOpus 5より約30%速く出力を生成すると述べているが、これは最初のトークンより後のトークンについての話だ。モデルは素早くストリーミングしながら、こちらの視界を1分半ものあいだ空白のままにしておける。
静かなターミナルはステータスではない
ターミナルが沈黙する理由は少なくとも4つあり、ターミナルはそのすべてを同じように表示する。
- Runtimeが動作中。推論が進行中で、まだ出力はない。
- runはずいぶん前に終了しており、人間が質問に答えるのを待っている。
- リクエストが失敗した。Sharklyのドキュメントは、これがいかに誤読されやすいかを率直に述べている。「Timeout / 408 / 504 は、リクエストが遅かった、キャンセルされた、またはゲートウェイによって遅延させられたことを意味します。Computerがオフラインであることとは同じではありません。」
- Computerが本当に落ちている、あるいはrunが必要としていたディレクトリが最後まで空かなかった。
エージェント1体、ターミナル1つなら、もう1分待てば解決する。3つのリポジトリ、2台のComputerにまたがる5体のエージェントなら、ウィンドウを切り替えながら当て推量で片付けることになる。これが エージェントの混沌 の普通の姿だ。劇的な失敗ではなく、チームが1時間に何度も「こいつは生きているのか?」という問いに注意を奪われる、ただそれだけのことだ。
人がとっさにやってしまうのは、プロセスを殺して再実行することだ。高い推論effortでは、その反射は二重に高くつく。初回トークンまでの待ち時間を丸ごと払い直すうえ、もうすぐ届くはずだった思考を捨ててしまう。
ステータスが切り分けるべきもの
Sharkly自身のモデルは、Sharklyを使うかどうかに関わらず参考にする価値がある。ターミナルがごちゃ混ぜにしてしまう2つのものを切り分けているからだ。これは runのステータス、ログ、障害シグナル をそもそも読み取れるものにしているのと同じ分割だ。runには実行状態がある。Queued、Dispatched、Waiting for local directory、Running、Completed、Failed、Canceled。Taskにはライフサイクルステータスがあり、さらにその上にAgentの動作状態が乗る。Working、Waiting for human reply、Waiting for human review、Error。ドキュメントはこの境界を明確に述べている。これらのrun状態は「Taskが同じワークフローステータスであることを自動的に意味するものではない」。
この分割こそが、詰まっているのか考えているのかという問いへの完全な答えだ。
| What the terminal shows | What it may actually be | What tells them apart | Who acts next |
|---|---|---|---|
| Nothing, 100s in | Running, pre-first-token | Run state is Running, log has a dispatch timestamp | Nobody. Leave it. |
| Nothing, 10 min in | Waiting for human reply | Working state changed, Task raises an attention item in Inbox | The Assignee answers in context |
| Nothing, forever | Failed | Run state is Failed, execution log carries the title and the original model-service response | The Assignee reads the log before retrying |
| Nothing, never started | Queued or Waiting for local directory | Run state, plus which directory pool is busy | Free a directory or raise parallel capacity |
この4行のどれも、状態が変わった瞬間に誰かが見ている必要はない。そこが要点だ。状態は記録されるので、「考えているのか、それとも詰まっているのか?」という問いは、じっと耐えるものではなく、調べるものになる。
3月に設定したTaskごとのタイムアウト
Sharklyの Agent には、並列実行できるTaskの最大数と、Taskごとのタイムアウトがある。ほとんどのチームはこのタイムアウトを、初期に一度だけ、ターミナルをどれだけ眺めていられるかを基準に設定する。その値が2分で、その後Agentをmax推論設定に移したなら、思考フェーズ中のrunをキャンセルし、それを失敗として報告するポリシーを設定してしまったことになる。
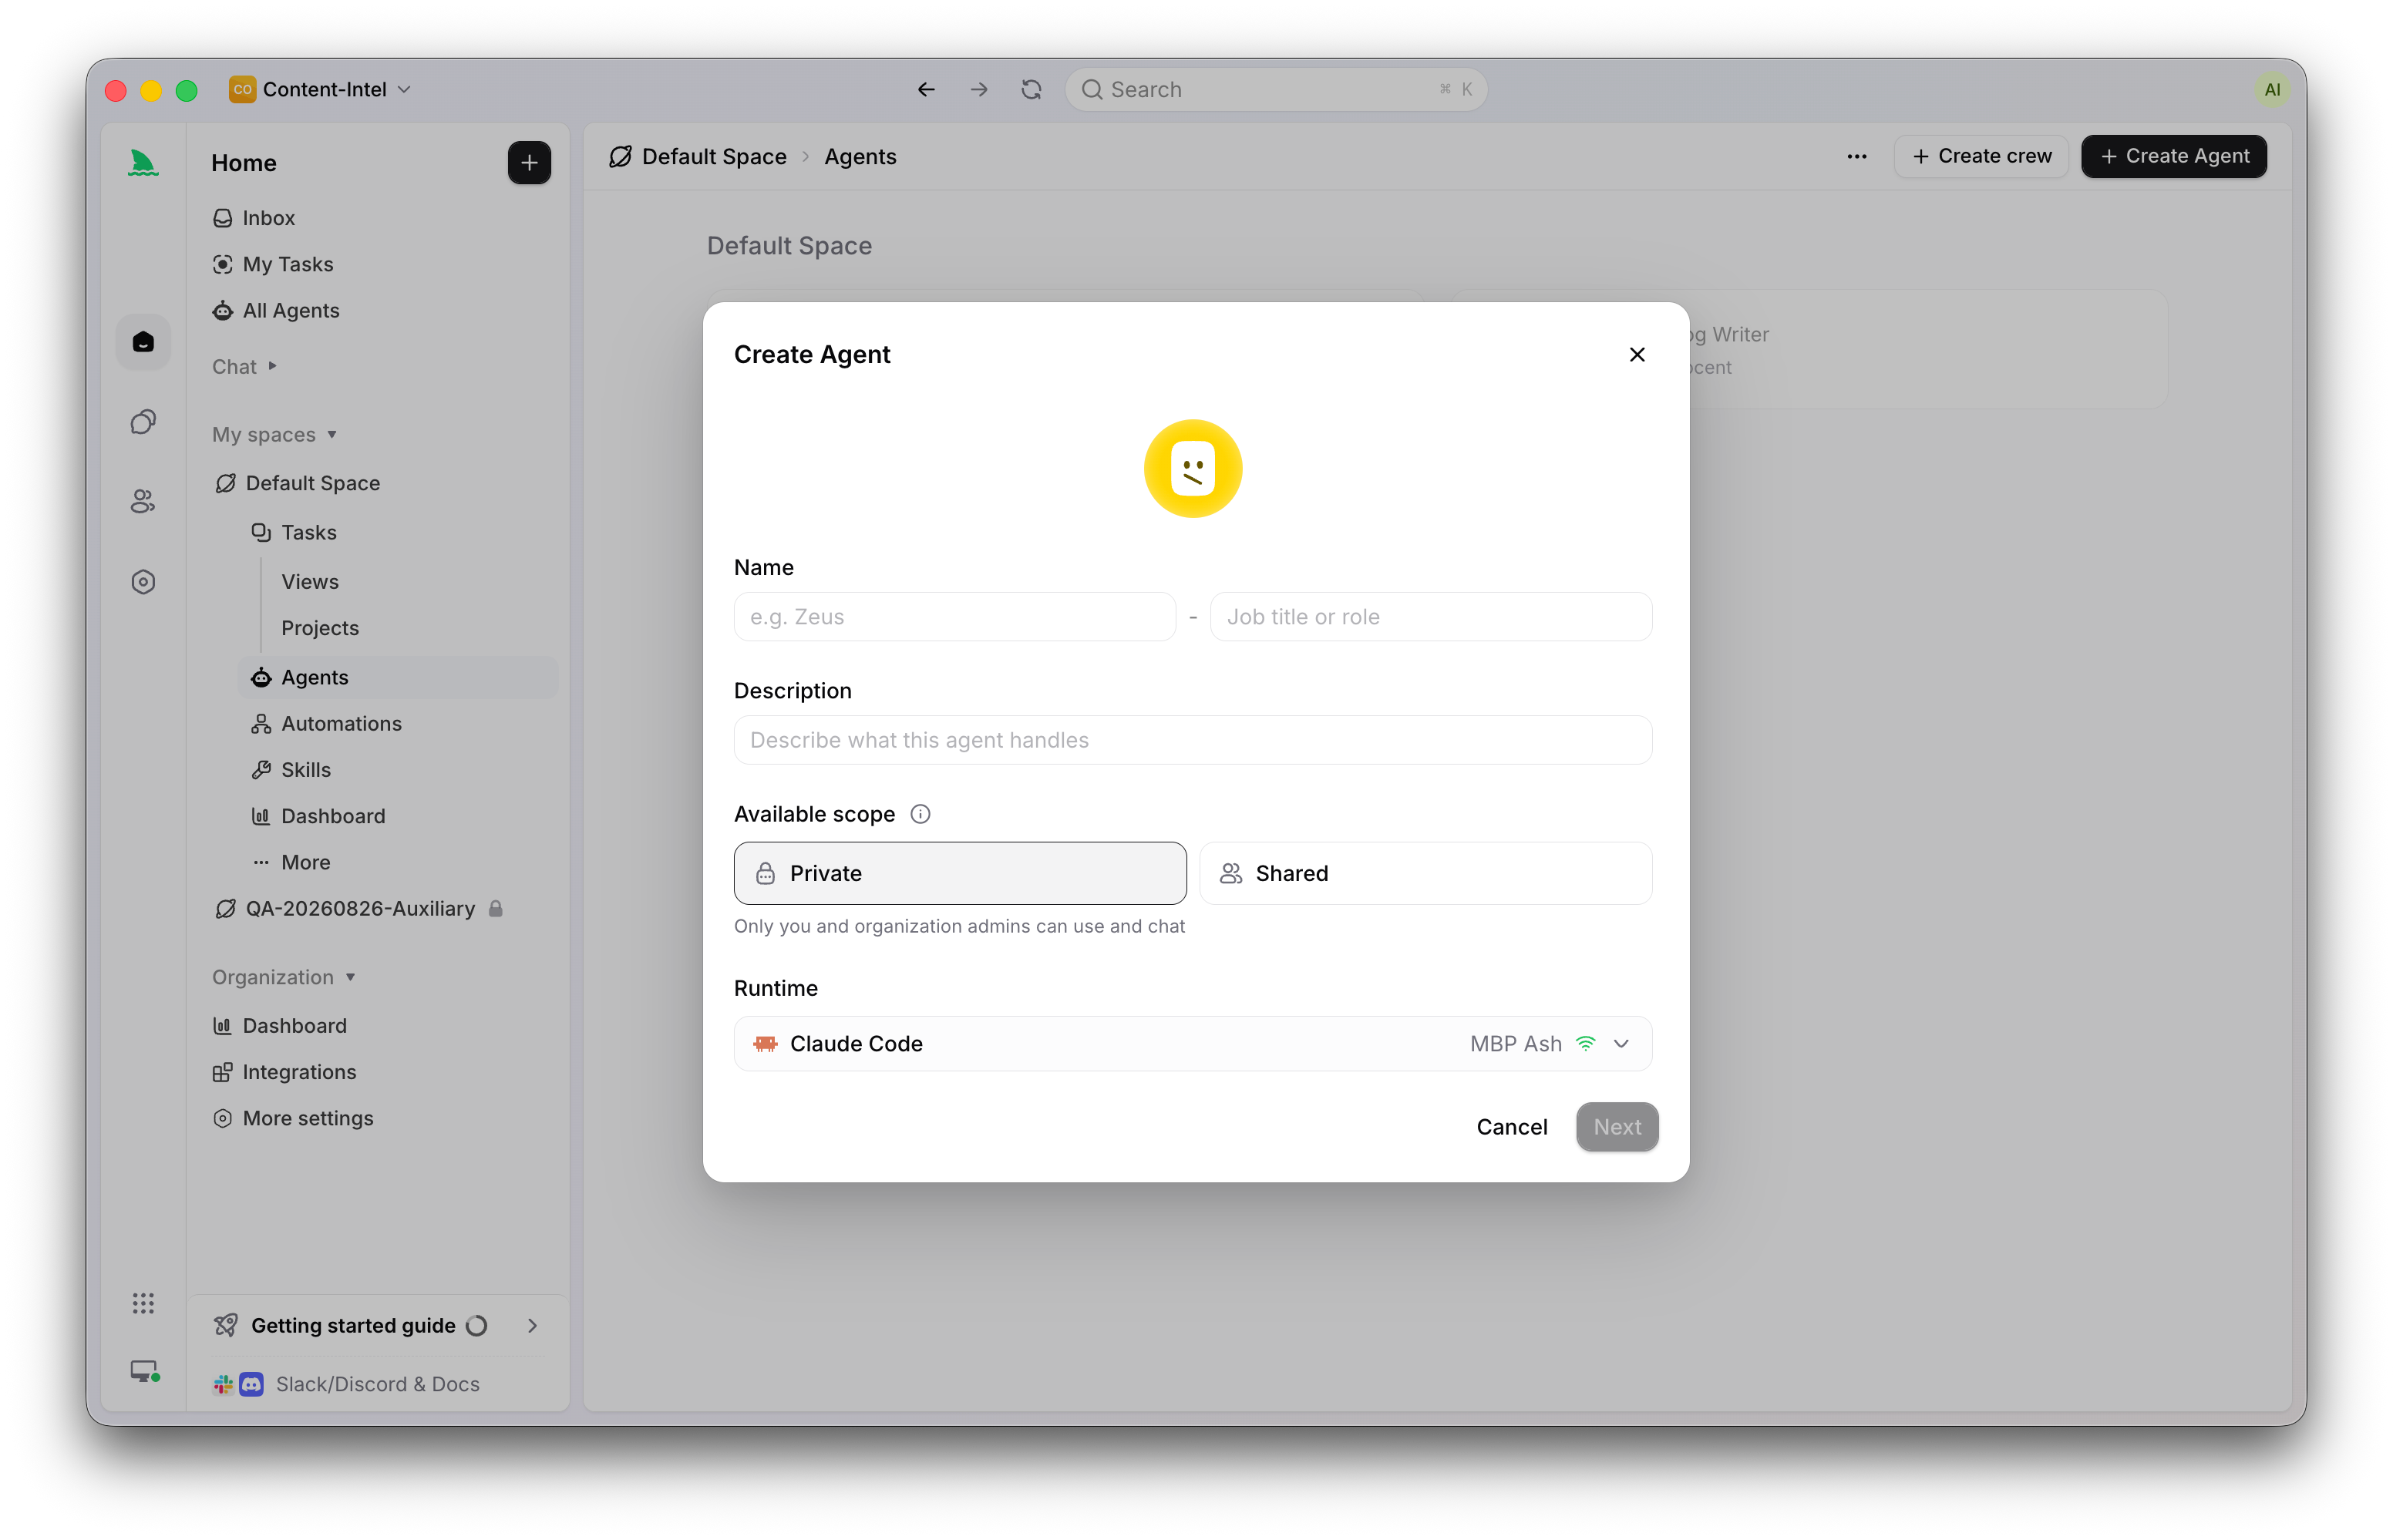
今週中に自分の設定を見てほしい。基準は「自分はどれだけ待てるか」ではなく、「実際に使っているeffortレベルでこのRuntimeがどれだけかかるか、それに作業自体の時間を足したもの」だ。初回トークンだけで100秒以上かかりうるrunにとって、5分未満のタイムアウトは、ポリシーの皮をかぶったコイントスにすぎない。
同じ機会に見直す価値のある関連設定が2つある。Maximum parallel running Tasksは実質的な同時実行数の上限であり、設定済みのディレクトリがすべてビジーのとき、新しいrunは失敗せずにWaiting for local directoryで待機する。これは正しい挙動だが、ターミナルだけを見ているとハングしたように見える。
キャッシュで解決するのか?
一部は解決する。ただし望んでいる部分ではない。GPT-6向けのOpenAIのprompt cachingは、キャッシュされた入力の読み取りに90%の割引を適用し、デフォルトでヒット率を高め、キャッシュされたプレフィックスの終端を自分で選べるよう明示的なbreakpointsを追加し、推論effortやツールの可用性を変更してもキャッシュを壊さなくなった。GitHubは、数十億件のリクエストにわたり、新規処理が必要なpromptトークンが50%以上減ったと報告している。これはプロンプトにおけるコストとレイテンシの確かな改善であり、effort変更でキャッシュが壊れなくなった修正は、フローの途中でタスクを安い設定から高い設定へエスカレートするエージェントにとって本当に有用だ。
とはいえ、推論のパス自体がなくなるわけではない。キャッシュが温まっているのは、プロンプトのより少ない部分をゼロから処理すればよいという意味にすぎない。モデルがすでにあなたのバグについて考え終えているという意味ではない。いずれにせよ、待ち時間は見込んでおくべきだ。
待ち時間を払うべきとき、そうでないとき
二度実行したくないタスクには最大推論設定を使う。マイグレーション、横断的なリファクタリング、誤った答えのコストが90秒を上回るものはすべてそうだ。OpenAIの報告では、Solをxhigh設定で動かすとAutomationBench 1.0.6で33.2%を記録し、タスクあたり$0.27だった。これがこのトレードオフの形だ。精度は金額的には安く、実時間的には高い。
人間がその場で答えを待っている場合は、より低いeffort設定を使う。インタラクティブな作業、ファイルについてのちょっとした質問、小さな スコープを絞った修正。低いeffortでは沈黙の問題はほぼ消える。何を尋ねたかまだ覚えているうちに初回トークンが現れるからだ。
そして正直な線引き。1つのTaskに1体のエージェントを動かしているだけなら、このためにボードは要らない。ログをtailすればいい。状態の問題は、runの数が意味を持って見ていられるターミナルの数を超えた時点で始まる。ほとんどの人にとって、それはおよそ3つだ。
これで解決しないこと
ステータスは、runがWorkingであることを教えてくれる。そのrunが有益なことをしているかまでは教えてくれない。自信満々に間違っているエージェントは、runが続く限り、良いエージェントと同じ緑の状態を表示する。Opus 5.5ではそれが18時間以上になることもある。「動いている」と「うまく動いている」を区別するのは依然として レビューの問題 であり、レビューは今でも人間の仕事だ。自動化は、チームの判断が必要な場所で止まる。
すでに複数のエージェントを同時に走らせているなら、今週打てる最も小さくて役立つ手は、新しいモデルではない。ターミナルを開かずにすべてのrunの状態を読めるようにすることだ。そうすれば、次の90秒の沈黙は問いではなく情報になる。

