
Anthropic은 Claude Opus 5.5의 실행 비용이 Opus 5보다 40% 저렴하다고 밝혔습니다. 팀 안의 누군가는 이미 누구나 할 법한 계산을 끝냈을 겁니다. 같은 예산이면 에이전트 실행 횟수가 약 1.7배, 따라서 출시되는 작업량도 약 1.7배가 된다는 계산이죠. 이 계산은 산술적으로는 맞지만 운영 측면에서는 틀렸습니다. 그리고 이 계산대로 움직이는 그 주에 여러분의 보드는 아무도 읽지 않은 완료된 실행들로 가득 차게 됩니다.
에이전트를 더 많이 병렬로 실행하는 데 걸림돌이 된 것은 결코 모델 청구서가 아니었습니다. 그것은 한 사람이 diff를 읽고, 에이전트가 내린 결정을 이해하고, 이를 받아들일 수 있는 역량이었습니다. 가격 인하는 그 숫자에 아무런 영향을 주지 않습니다. 다만 그 한계에 작업이 도달하는 속도만 높일 뿐입니다.
TL;DR
리뷰 상한(review ceiling)이란 팀이 하루에 실제로 읽고, 판단하고, 받아들일 수 있는 완료된 에이전트 실행의 수이며, 이를 결정하는 것은 토큰이 아니라 사람입니다. 더 저렴한 모델은 그 상한에 작업이 도달하는 속도를 높일 뿐 상한 자체는 건드리지 않습니다. 따라서 가격 인하의 첫 번째 가시적 효과는 더 빠른 릴리스가 아니라 더 길어진 대기열입니다. 에이전트는 조사하고, 실행하고, 테스트하고, 보고합니다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 받아들입니다. 유용한 대응은 예산이 아니라 리뷰어를 기준으로 동시 실행 수를 제한하고, 하나의 리뷰 가능한 결과로 수렴하는 에이전트 작업과 여러 갈래로 흩어지는 에이전트 작업을 구분하는 것입니다. Sharkly는 요청부터 릴리스까지 컨텍스트, 진행 상황, 블로커, 결과, 인간 리뷰를 Task에서 볼 수 있게 유지하며, 바로 이것이 대기열을 셀 수 있게 만드는 토대입니다.
실제로 저렴해진 것은 무엇인가
두 연구소가 2026-09-22에 발표했습니다. 그중 여러분의 청구서에 직접 닿는 부분만 짚어보겠습니다.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| API id | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| 입력 100만 토큰당 | $5 | $4 | $2 | $0.10 |
| 출력 100만 토큰당 | $25 | $20 | $10 | $0.50 |
| 캐시된 입력 | n/a | 읽기 $0.20, 쓰기 $5 | 읽기 90% 할인 | 읽기 90% 할인 |
Anthropic은 Opus 5.5가 Opus 5보다 실행 비용이 40% 저렴하고 출력 속도는 약 30% 빠르다고 밝힙니다. 위의 정가 요율은 Opus 5 토큰 가격에서 20% 할인된 값으로, 이는 공개된 두 수치를 바탕으로 한 우리 자체 계산이며 40%라는 주장과는 별개의 것입니다. OpenAI는 Sol과 Luna가 각각 GPT-5.6 프로모션 가격보다 50% 저렴하다고 밝히는데, '프로모션'은 OpenAI 스스로 쓴 표현이므로 이 헤드라인은 정가가 아닌 할인 요율을 기준으로 측정된 셈입니다.
완료된 태스크당 비용은 토큰당 비용보다 훨씬 더 많이 움직였습니다. AutomationBench 1.0.6에서 OpenAI는 GPT-6 Sol이 extra high reasoning으로 태스크당 $0.27에 33.2%를 기록했고, Claude Opus 5는 max reasoning으로 26.9%를 기록했지만 비용은 Sol의 11.1배라고 보고합니다. DeepSWE 1.1에서 OpenAI는 GPT-6 Luna가 max reasoning으로 66.6%를 기록했으며 태스크당 비용은 Opus 5보다 93% 저렴하다고 제시합니다.
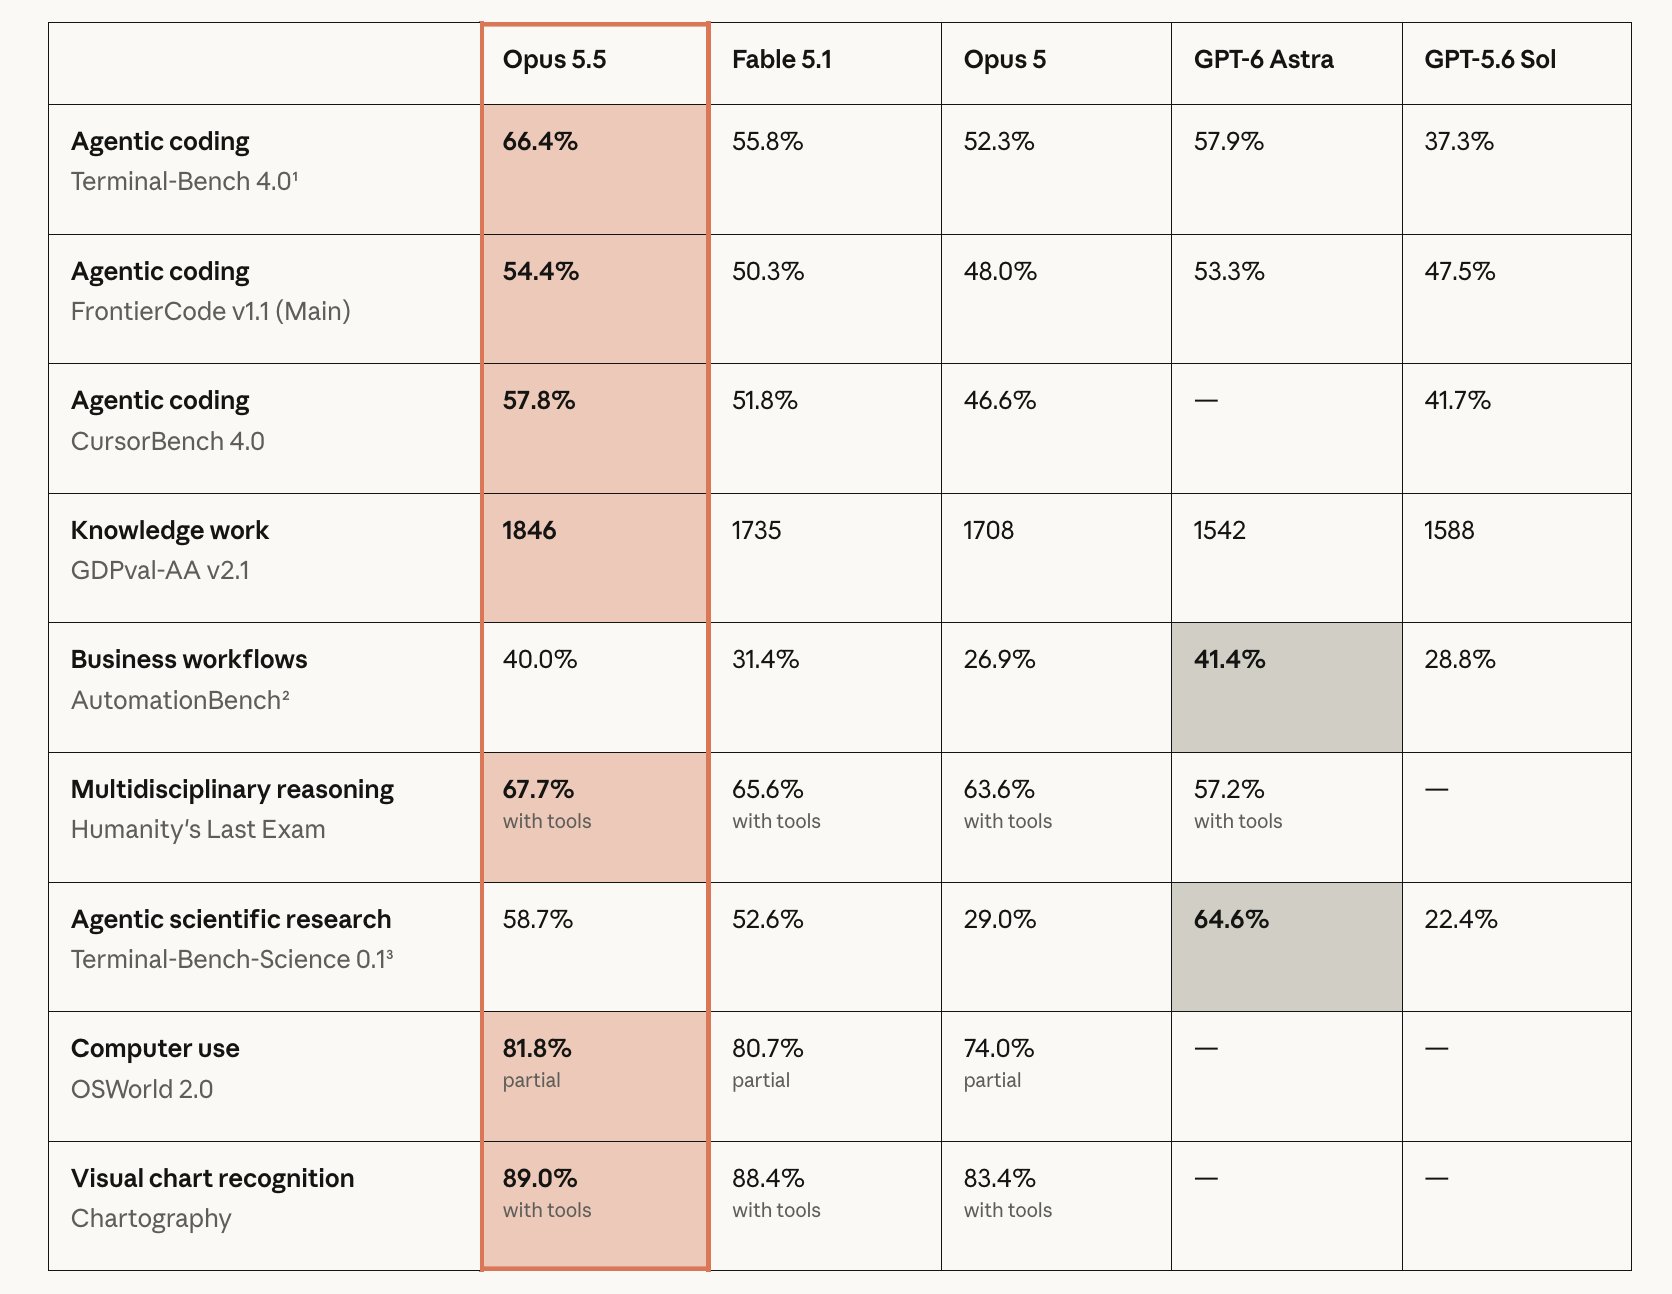
즉, 하루 만에 두 벤더에 걸쳐 한 번의 시도 비용이 크게 떨어졌습니다. 여러분의 한 주에서 달라진 것은 그것뿐입니다.
이번 주 모두가 해본 그 계산
지출을 그대로 두고 나눠 봅시다. 실행 비용이 40% 줄면 같은 월 지출로 Opus 5 실행보다 약 1.67배 많은 Opus 5.5 실행을 살 수 있습니다. 일상적인 작업의 절반을 Luna로 돌린다면 그 배수는 더 이상 흥미롭지 않습니다. 100만 토큰당 $0.10과 $0.50이라면 모델 비용 항목은 더 이상 예산을 배분할 대상이 아니기 때문입니다.
이제 두 번째 계산을 해볼 차례입니다. 이것이 실제로 출시될 수 있는지를 결정하는 계산이죠. 엔지니어 한 명이 하루에 제대로 읽을 수 있는 완료된 실행의 수를 떠올려 보세요. 대충 훑어보거나 초록색 체크만 보고 승인하는 것이 아닙니다. diff를 읽고, 에이전트가 무엇을 하기로 했는지 이해하고, 그에 대한 책임을 지는 것입니다. 그 숫자가 무엇이든, 2026-09-21에도 같았고 다음 분기에도 같을 것입니다. 리뷰 역량 산술은 가격 인하가 있기 전에도 형편없는 결과를 내놓습니다. 가격 인하는 입력 쪽만 바꿀 뿐입니다.
가격 인하는 역량 증가가 아닙니다. 여전히 사람을 필요로 하는 무언가를 만들어내는 비용이 얼마나 싸졌는지의 변화일 뿐입니다.
결정적 단서: 여러분을 멈춰 세운 것은 비용이 아니었다
모델 비용이 실제로 발목을 잡는 제약이었다면, 팀들은 작동하는 가장 저렴한 구성을 사용하고 있었을 것입니다. 그렇지 않았습니다. OpenAI 자체 수치에 따르면 자사 조직의 연구자 중 중간값은 API 가격 기준 하루 $600 이상의 추론을 실행하고, 90번째 백분위수는 하루 $7,000을 실행합니다. 공개된 벤치마크 표를 보면 팀들은 더 낮은 점수를 얻기 위해 태스크당 11.1배 더 비싼 구성을 기꺼이 사용합니다. 신뢰할 수 있는 결과가 두 번 확인해야 하는 결과보다 더 가치 있기 때문입니다.
이것이 진짜 제약의 형태입니다. 사람들은 단위당 인간의 검토가 덜 필요한 결과물에 큰 배수를 지불합니다. 여기서 사들이는 희소 자원은 컴퓨팅이 아니라 주의력이며, 그것은 이미 상당한 프리미엄을 주고 사들이고 있었습니다.
즉, 가격 인하는 비대칭적으로 작용합니다. 생성하는 쪽은 저렴하게 만들고, 받아들이는 쪽은 전혀 그대로 둡니다.
수렴하는 팬아웃, 그리고 보드에 쌓이는 팬아웃
저렴한 모델을 조용히 비싼 존재가 아니라 진정으로 유용하게 만드는 구분이 있습니다. 대부분의 팀이 건너뛰는 부분이죠.
어떤 병렬성은 수렴합니다. 세 개의 에이전트가 격리된 워크트리에서 같은 마이그레이션을 시도하고, 테스트 스위트와 리더 에이전트가 통과한 하나를 고르면, 사람에게는 결과 하나만 도달합니다. 비용은 세 배가 됐지만 리뷰 부담은 그대로입니다. 가격 인하가 실제 처리량을 사주는 지점이 바로 여기이며, 새로운 경제성이 여러분의 환경을 바꿀 가치가 있는 곳입니다.
어떤 병렬성은 발산합니다. 열 개의 에이전트가 서로 무관한 열 개의 Task를 맡아 열 개의 diff, 열 개의 변경 요약, 열 개의 수락 결정을 만들어냅니다. 비용은 똑같이 열 번의 실행입니다. 리뷰 부담은 한 사람의 주의 단위로 열 배입니다.
| 수렴형 팬아웃 | 발산형 팬아웃 | |
|---|---|---|
| 예시 | 하나의 마이그레이션을 3개 에이전트가 시도, 가장 좋은 것 채택 | 10개의 Task, 10명의 Assignee, 10개의 diff |
| 저렴한 모델로 얻는 것 | 시도 횟수 증가, 하나라도 좋은 결과일 확률 상승 | 대기 중인 완료 작업 증가 |
| 생성되는 리뷰 항목 | 1 | 10 |
| 가격만 보고 확장해도 안전한가 | 예 | 아니요 |
저렴한 모델은 재시도를 감내할 수 있는 만큼 수렴형 팬아웃을 넓히는 데 사용하세요. 실행이 아무리 저렴해졌더라도 리뷰어 수를 넘어서까지 발산형 팬아웃을 넓히는 데는 쓰지 마세요. 이것이 정직한 두 가지 결정이며, 후자를 무시했을 때 비용이 발생합니다.
예산 대신 바꿔야 할 것
지출이 아니라 리뷰어를 기준으로 동시 실행 수를 제한하세요. Crew가 볼 수 있는 곳에 규칙을 적어 두세요. 사람의 수락을 기다리는 열린 Task 수는 근무 중인 리뷰어 수에 한 명이 근무 중에 처리하는 리뷰 수를 곱한 값을 넘지 않아야 합니다. 우리 수치가 아니라 여러분의 두 수치입니다. 상한에 도달하면 예산상 가능하더라도 에이전트는 새 Task를 가져가지 않습니다. 이럴 때는 문서화된 라우팅 규칙이 선호도보다 낫습니다. 선호도는 더 저렴한 가격 앞에서 조용히 밀리기 때문입니다.
'사람을 기다리는 중'을 눈에 보이는 상태로 만드세요. 끝난 실행과 뭔가를 묻기 위해 멈춘 실행은 밖에서 보면 똑같아 보이고, 유일한 기록이 터미널이라면 둘 다 보이지 않습니다. 실행, 블로커, 결과, 후속 논의는 Task 타임라인으로 돌아와야 합니다. 그래야 대기열이 금요일에 느껴지는 감이 아니라 셀 수 있는 대상이 됩니다.
토큰이 아니라 리뷰의 가격을 매기세요. 실행당 달러를 보고하는 에이전트 전반의 비용 추적은 더 이상 유효하지 않은 질문에 답합니다. 대시보드에 올릴 가치가 있는 숫자는 수락된 변경당 사람의 분(minutes)입니다. 더 저렴한 모델로 바꾼 뒤 이 수치가 올라갔다면, 그 저렴한 모델은 더 비싼 것입니다.
절약한 비용의 일부는 증거에 쓰세요. 타입체크, 테스트 결과, 변경 요약, 알려진 한계를 함께 첨부하는 실행은 토큰은 더 쓰지만 주의력은 덜 씁니다. Opus 5.5의 캐시 입력 읽기 100만 토큰당 $0.20, GPT-6의 캐시 읽기 90% 할인이라면 추가 검증 패스는 거의 무료이며, 실제로 부족했던 자원을 되사옵니다.
이것이 이번 주에 남기는 것
두 연구소가 같은 날 한 번의 시도 가격을 낮췄고, 그중 한 곳은 몇 시간 뒤 대체된 모델을 기준으로 벤치마크했습니다. 어느 쪽도 여러분 대신 diff를 읽어주는 것을 내놓지 않았습니다. 작업에 대한 인간의 소유권은 40% 저렴해지지 않은 부분이며, 무엇이 프로덕션에 도달할지를 결정하는 부분입니다.
이미 여러 코딩 에이전트를 운영하고 있다면, 이번 주에 유용한 행동은 동시 실행 수를 올리는 것이 아닙니다. 여러분의 리뷰 상한이 실제로 얼마인지 파악하고, 그에 맞춰 동시 실행 수를 설정하는 것입니다. Sharkly는 실행, 블로커, 결과, 그리고 사람이 수락하기를 기다리는 작업 대기열을 한곳에서 볼 수 있게 해줍니다.


