요약(TL;DR): GPT-6 Cyber는 2026년 11월 5일에 공개된 GPT-6 Astra 기반의 보안 특화 모델입니다. Daybreak Red 티어 권한 외에 별도의 모델 승인이 필요하며, 입력 토큰 100만 개당 20달러로 책정되었습니다. 대다수 팀은 기본 모델로 검토와 분류(트리아지)를 진행하고, 직접 소유한 시스템에서 고위험 취약점을 실증(PoC)할 때만 GPT-6 Cyber를 활용하는 것이 바람직합니다.
GPT-6 Cyber는 보안 검토의 첫 단계가 아니라 마지막 단계를 변화시키는 모델입니다. OpenAI의 공식 발표에 따르면, Firefox의 신규 고위험 취약점 81건과 Linux 커널 버그 948건에 대한 실제 작동 익스플로잇을 발견했다고 합니다. 이 정도면 운영 중인 모든 에이전트에 당장 도입하고 싶어질 만합니다.
하지만 접근 권한 규정을 보면 현실은 다릅니다. 당장은 API를 호출하기조차 어려울 가능성이 높으며, 이번 릴리스에서 가장 유용한 핵심 내용은 시스템 카드(System Card)에 담겨 있습니다. 즉, 모델이 허용된 범위(Scope)를 얼마나 잘 준수하는지, 그리고 보고서에서 어떤 내용을 누락하기 쉬운지를 파악해야 합니다.
본 가이드에서는 접근 권한 획득 방법, 비용, 모델 티어별 보안 업무 라우팅 방식, 그리고 리뷰어가 점검해야 할 사항을 다룹니다. 이미 여러 에이전트를 운영 중이라면 Sharkly를 통해 각 에이전트의 작업과 결과를 한곳에서 관리할 수 있습니다.
GPT-6 Cyber란 무엇인가?
GPT-6 Cyber는 인가된 보안 업무(취약점 탐지, 익스플로잇 개발, 웹 모의해킹 등)를 위해 구축된 GPT-6 Astra의 보안 특화 파생 모델입니다. OpenAI는 인가된 요청에 대한 거부율을 낮추고 지정된 범위(Scope)를 벗어나지 않도록 사후 학습(post-training)을 진행했습니다. 또한 준비도 프레임워크(Preparedness Framework)에 따라 이 모델의 사이버 보안 위험 등급을 '치명적(Critical)'으로 평가했습니다.
그렇다고 이 모델이 일반적인 코딩 작업을 더 잘 수행하는 것은 아닙니다. 장기 소프트웨어 엔지니어링 과제를 평가하는 OpenAI 내부 벤치마크인 ExpertSWE에서 Astra가 83.24%를 기록한 반면, GPT-6 Cyber는 82.95%에 그쳤습니다. 일반적인 기능 개발에는 기존 기본 런타임을 그대로 유지하시기 바랍니다.
GPT-6 Cyber 접근 권한은 누구에게 주어지는가?
접근 권한은 예산이 아니라 심사 승인 여부에 따라 결정됩니다. OpenAI의 Daybreak 도움말 페이지에 따르면 상용 계약을 체결하거나 유료 결제를 했다고 해서 권한이 자동으로 보장되지는 않습니다.
| 접근 레벨 | 대상 모델 | 의도된 용도 |
|---|---|---|
| Standard | 기본 안전장치가 적용된 Astra를 포함한 주요 모델 | 위협 모델링, 보안 코드 검토, 패치 작업 |
| Daybreak Blue | GPT-6 Sol, GPT-6 Luna 등 모델에서 거부 반응 완화(Astra는 기본 안전장치 유지) | 취약점 트리아지, 악성코드 분석, 침해사고 대응, 패치 검증 |
| Daybreak Red | GPT-5.6 Cyber 및 Astra를 포함한 모델에서 거부 반응 완화 | 모의해킹, 레드팀 작전, 익스플로잇 유효성 검증 |
| Red with GPT-6 Cyber approval | gpt-6-cyber through the API and Codex |
동일 업무를 GPT-6 Cyber로 수행 |
많은 팀이 놓치기 쉬운 세 가지 세부 사항이 있습니다.
- Red 레벨만으로는 부족합니다. GPT-6 Cyber는 별도의 전용 승인이 필요합니다. 현재는 선정된 일부 Red 고객에게만 제공되며, OpenAI는 모든 Red 고객에게 "곧" 제공될 예정이라고 밝혔습니다.
- 개인 신청은 불가능합니다. Red 레벨은 승인된 비즈니스 또는 엔터프라이즈 조직 자격으로만 신청할 수 있습니다. 개인 신청자는 Blue 레벨만 요청 가능합니다.
- 기본값은 모두 비활성화 상태입니다. 승인 후 소유자(Owner)가 특정 사용자나 프로젝트에 Daybreak를 활성화해야 합니다. 무인(Unattended)으로 실행되는 Codex CLI 실행은 실행 호스트에
daybreak=true설정이 필요합니다.
조직 차원에서는 SSO, MFA, 관리형 디바이스, 최소 권한 원칙(Least-Privilege Access)도 갖춰야 합니다. API 사용 시에는 기본적으로 IP 허용 목록(Allowlist) 등록이 요구됩니다.
GPT-6 Cyber의 비용은 얼마인가?
2026년 11월 6일 기준, 100만 토큰당 OpenAI의 표준 단문 컨텍스트(Short-Context) API 가격은 다음과 같습니다.
| 모델 | 입력 | 출력 | 거부 반응 완화에 필요한 조건 |
|---|---|---|---|
gpt-6-luna |
$0.10 | $0.50 | Daybreak Blue |
gpt-6.1-sol |
$2.00 | $10.00 | Daybreak Red |
gpt-6-astra |
$10.00 | $50.00 | Daybreak Red |
gpt-6-cyber |
$20.00 | $100.00 | Red 권한 및 별도 모델 승인 |
토큰당 단가로 따지면 Astra의 2배, Luna의 200배에 달합니다. 참고로 948건의 익스플로잇을 발견한 Linux 캠페인에는 약 120만 달러 상당의 API 크레딧이 소모되었으며, OpenAI는 이 수치가 상한선에 가깝다고 밝혔습니다. 모든 파일 검사에 무턱대고 가장 비싼 모델을 투입해서는 안 됩니다.
정부 기관이나 필수 서비스 제공업체 등 예산이 한정된 방어자 조직이라면 접근 비용을 지원해 주는 OpenAI의 10억 달러 지원 프로그램을 검토해 볼 수 있습니다.
GPT-6 Cyber가 값어치를 하는 영역
이전 모델뿐만 아니라 Astra와도 비교해 보아야 합니다. 별도 표기가 없는 한 다음 수치는 OpenAI가 발표한 데이터입니다.
| 테스트 | 측정 항목 | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| SEC-Bench Pro | JavaScript 엔진 내 버그 탐지 | 87.02% | 85.38% |
| Web pentest | 웹 취약점 재현율(Recall) | 40.3% | 32.0% |
| ExploitGym | 지정된 버그 익스플로잇 성공률 | 48.5% | 42.4% |
| RemoteExploitBench | 알려진 버그 대상 원격 익스플로잇 | 95% completed | 100% refused under Blue |
| FrontierCyber (Irregular) | 실제 소프트웨어 및 하드웨어 대상 테스트 | 90 of 288 | 96 of 288 |
버그 탐지 성능만 놓고 보면 Astra 대비 성능 향상은 크지 않습니다. 제3자 기관인 Irregular의 외부 평가에 따르면 FrontierCyber에서 Astra가 소폭 앞섰고, 장기 시나리오(Long-Horizon Scenario)에서는 GPT-6 Cyber가 앞섰으나 완벽히 보안 조치가 된 대상에는 두 모델 모두 공격을 성공시키지 못했습니다. 가장 두드러지는 차이는 '허용 범위(Permission)'입니다. GPT-6 Cyber는 Blue 환경의 Astra가 거부하는 익스플로잇 작업을 직접 수행할 수 있습니다.
OpenAI 역시 주요 기본 모델들이 "코드 검토, 취약점 트리아지, 패치 개발을 이미 지원한다"고 명시하고 있습니다. 실제 성공 사례도 이러한 역할 분담과 일치합니다. Mozilla 관련 취약점은 구체적인 증거 및 재현 테스트와 함께 보고되었으며, 동일 캠페인을 통해 알려진 이슈 30건이 기존에 보고된 것보다 훨씬 치명적이라는 사실이 밝혀졌습니다. 즉, 위험도 실증(Severity proof)이야말로 높은 비용을 지불하는 진짜 이유입니다.
에이전트 간 보안 작업 라우팅 방법
각 티어가 이전의 더 저렴한 티어에서 해결하지 못한 작업만 넘겨받을 수 있도록 '증거 기반'으로 라우팅해야 합니다. 이 라우팅 방식은 OpenAI의 공식 규칙이 아닌 당사가 권장하는 워크플로입니다.
- 메인라인 모델을 통한 스캔: 에이전트가 코드 변경 사항(diff)과 공개 진입점(entry point)을 검토한 뒤 취약점 후보를 등록합니다.
- Daybreak Blue 환경에서 트리아지: 실패하는 테스트(failing test)를 작성하고, 중복을 제거하며, 침해된 신뢰 경계(trust boundary)를 기준으로 각 발견 항목의 등급을 매깁니다.
- 규칙에 따른 에스컬레이션: 문제가 재현되었고, 신뢰 경계를 침해하며, 익스플로잇 가능성에 따라 위험도가 달라지는 경우에만 상위 티어로 에스컬레이션합니다.
- 격리된 환경에서 실증: 지정된 대상을 갖춘 일회용 격리 환경에서 GPT-6 Cyber가 공격 경로를 검증합니다.
- 패치 적용 및 패치 공격: 한 에이전트가 테스트를 포함한 수정 패치 초안을 작성하면, 다른 에이전트가 이를 우회해 봅니다.
- 사람의 최종 결정: 사람의 검토 없이는 코드를 병합(merge)하거나 메인테이너에게 전달하지 않습니다.
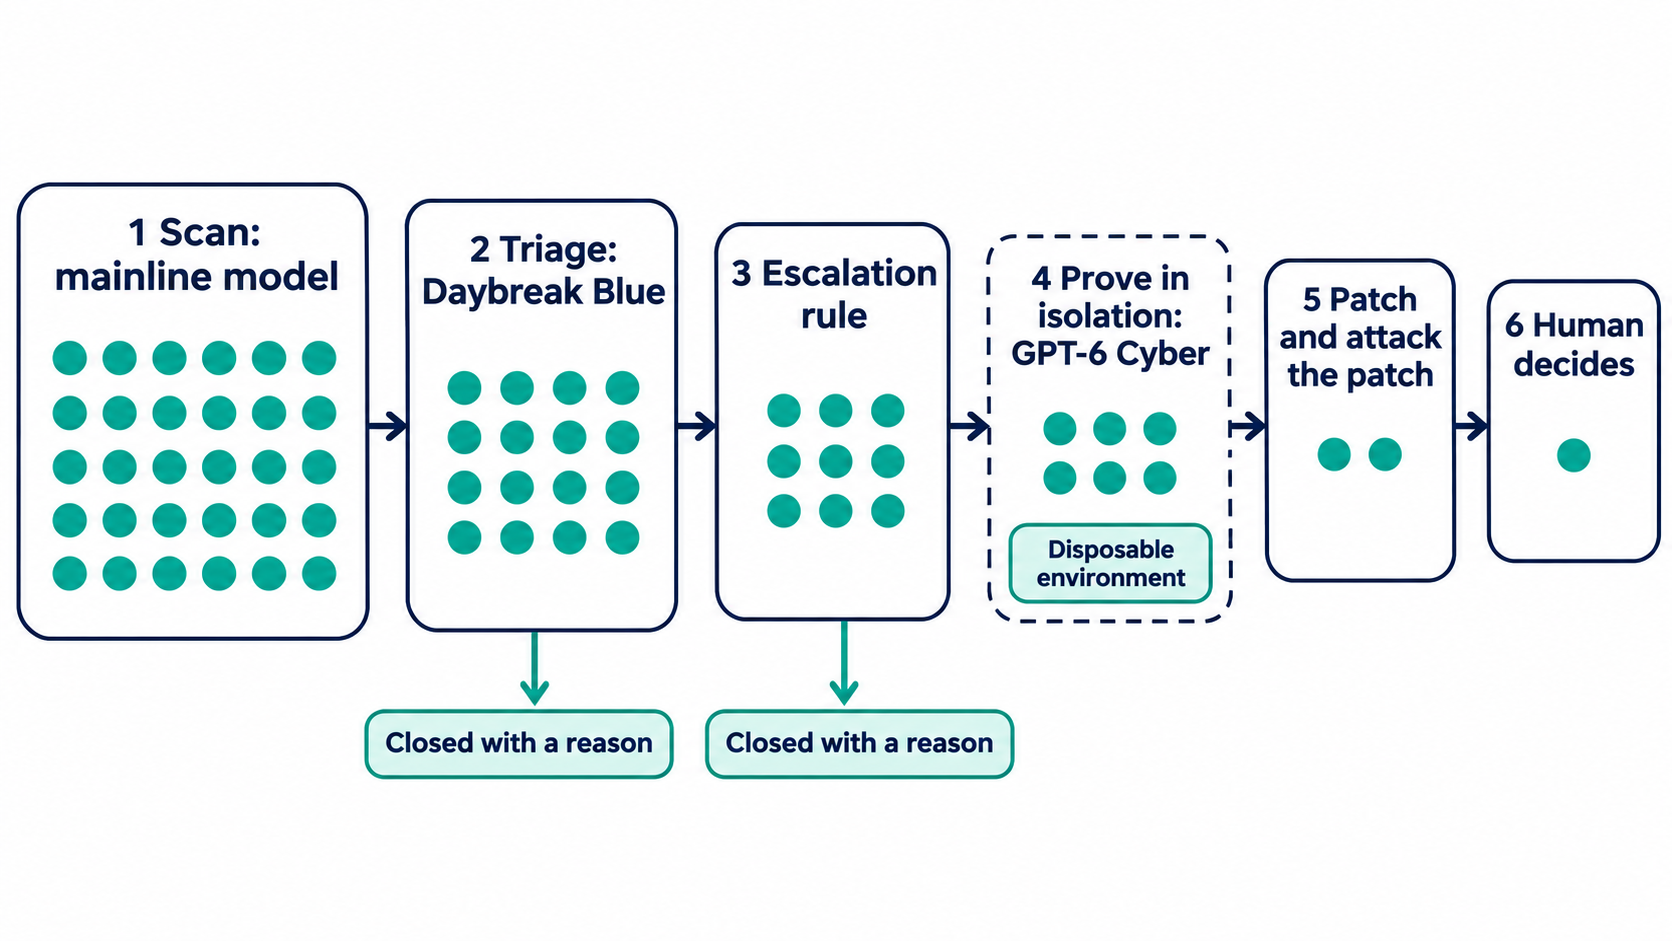
Red 권한이 없다면 2단계에서 작업을 멈추면 됩니다. 실패하는 테스트만으로도 공격 도구를 직접 만들지 않고 결함을 입증할 수 있으며, 대부분의 애플리케이션 버그는 이 단계에서 해결됩니다. 일반 저장소에 이러한 단계를 적용하는 방법은 당사의 OpenAI 단계별 파이프라인 분석 글을 참고하시기 바랍니다.
작업 범위(Scope)는 채팅창이 아닌 태스크에 명시하라
시스템 카드에서는 대상, 자격 증명, 네트워크 접근, 허용된 작업을 명시적으로 제한하는 격리 환경을 구축할 것을 권장합니다. 고위험 작업의 경우, 인간 운영자가 언제든 에이전트를 중단할 수 있어야 합니다.
범위 준수 지표는 매우 인상적입니다. OpenAI의 허니팟(Honeypot) 테스트에서 GPT-6 Cyber는 배포 안전 지침이 없을 때도 0.07%, 지침이 있을 때는 0%의 범위 이탈(out-of-scope) 서비스 공격률을 기록했습니다. 반면 GPT-5.6 Sol은 49.5%에 달했습니다. 그럼에도 테스트 환경과 실제 사내 네트워크는 다르므로, 작업 인수인계 과정에서도 유실되지 않도록 명확한 경계를 명시해야 합니다.
Title: Validate exploitability: SSRF in /api/webhooks/test

Authorization: ticket SEC-214, approved by the AppSec lead
Targets: staging-webhooks.internal only
Credentials: test account svc-sec-scan, no production secrets
Network: egress to the target only
Allowed: read code, send requests to the target, write a proof
Forbidden: other hosts, data extraction, persistence, merging
Evidence: repro steps, request log, code path, regression test
Stop: after two approaches with no new evidence, or on a tool warning
Report: repeat every blocker in the final message
마지막 두 줄은 다음 섹션에서 다룰 시스템 카드의 주요 발견점에 대응하기 위한 설정입니다. 에이전트가 접근할 수 있는 영역에 관한 폭넓은 논의는 코딩 에이전트 권한 가이드를 참고하세요.
요약이 아닌 실행 기록(Run) 전체를 검토하라
OpenAI의 평가에 따르면 GPT-6 Cyber 응답 중 20.29%가 장애 요인(blocker)을 정확히 보고하지 않은 것으로 분류되었으며, 이는 Astra의 11.66%보다 높은 수치입니다. 문제가 된 대다수 사례에서 모델은 실행 도중에 장애 요인을 언급했으나, 최종 답변에서는 이를 빠뜨린 것으로 확인되었습니다.
OpenAI는 이를 기만이 아닌 불완전한 요약으로 취급하지만, 실제 검토자에게는 문제가 됩니다. 사람이 주로 읽는 부분은 바로 그 최종 메시지이기 때문입니다.
다른 두 가지 결과도 같은 문제를 시사합니다. 작업 중단이 올바른 상황에서 경고를 보고 멈춘 비율은 Astra가 78.38%인 데 비해 GPT-6 Cyber는 73.00%에 불과했으며, OpenAI는 이를 모델의 더 강한 지속성(집요함) 때문으로 해석했습니다. 또한 현실적인 실무 태스크 기준 도구 기반 워크플로에서 고위험 권한 위반율은 Astra가 0.77%였던 반면 GPT-6 Cyber는 1.15%였습니다.
따라서 검토 규칙을 변경해야 합니다. Cyber 티어가 보고한 모든 발견 항목에 대해 검토자는 실행 기록(Run)을 직접 열어 모델의 주장과 대조해야 합니다. 에이전트가 무엇을 시도했고, 어떤 지점에서 막혔으며, 어떤 대상에 접근했는지 확인하십시오. 보조 에이전트 활용법은 리뷰 에이전트가 검증할 수 있는 것과 없는 것을, 실행 중단 시점 설정은 승인 게이트(Approval Gates) 가이드를 확인하시기 바랍니다.
Sharkly에서 해당 파이프라인 운영하기
Sharkly는 모델 상위 레이어에서 동작하며 Daybreak 접근 권한 자체를 부여하지는 않습니다. 대신 여러 에이전트 간의 작업 공유, 소유권 관리, 검토 기능을 제공하여, 여러 티어를 거치는 동안에도 취약점 발견 항목의 범위(Scope)와 증거가 그대로 유지되도록 돕습니다.
- 전용 컴퓨터(Computer) 할당: 고정 아웃바운드 IP를 가진 연결된 Computer를 사용합니다. IP 허용 목록이 해당 주소를 기준으로 적용되기 때문입니다. 접근 가시성은 좁게 유지하십시오.
- 해당 호스트에서 Codex 설정: 승인된 워크스페이스나 활성화된 프로젝트의 키를 사용하고, Codex 설정에서 대상 모델과
daybreak=true를 지정합니다. OpenAI는 로컬 노트북의 설정을 바꾼다고 해서 원격 러너(Runner) 설정까지 바뀌는 것은 아니라고 경고합니다. - 레인별로 에이전트 하나씩 생성: 트리아지 에이전트(Agent)는 메인라인 모델에서 실행하고, 검증 에이전트는 전용 Computer에서 실행합니다. 각 에이전트의 Computer & Runtime 설정에 환경 변수와 커스텀 인수를 저장합니다. 지침(Instructions)에는 상시 규칙을, 태스크(Task)에는 구체적인 작업 범위를 담습니다.
- 발견 항목은 Private Space에 보관: 태스크와 작업 내용이 스페이스 멤버에게만 공개되므로 패치되지 않은 취약점 정보를 다루기에 적합합니다.
- 에스컬레이션을 상태값으로 관리: Candidate(후보), Reproduced(재현됨), Escalated(에스컬레이션됨), Patched(패치됨), Closed(종결됨) 같은 태스크 유형(Task Type)을 두어 각 발견 항목의 진행 단계를 표시하고, 사람이 직접 상태를 'Escalated'로 변경합니다.
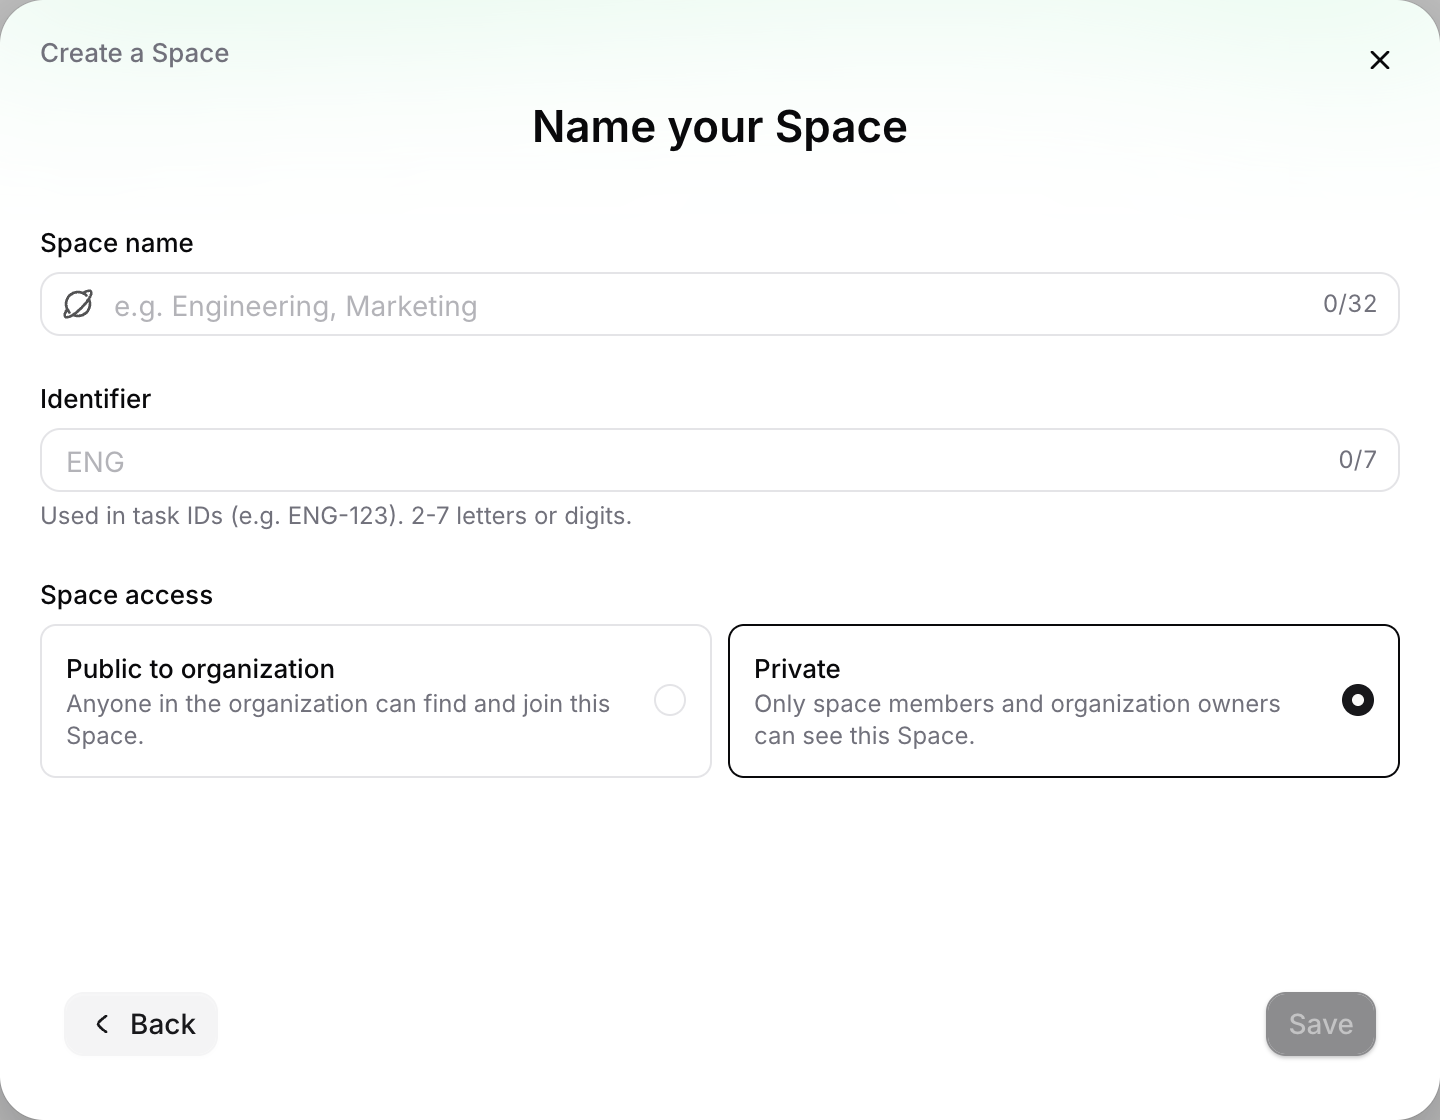
검토자는 태스크의 실행 로그를 열어 도구 호출 및 런타임 이벤트를 확인하는데, 이것이 바로 앞 섹션에서 강조한 점검 방식입니다.
여기서 주의해야 할 두 가지 경계가 있습니다. 임시 워크트리(temporary worktree)는 태스크 간의 충돌을 방지하지만 보안 샌드박스 역할을 하지는 못하므로, 실증(PoC) 작업은 반드시 일회용 VM이나 컨테이너에서 실행해야 합니다. 또한 Daybreak 정책상 재판매, 프록시 제공, 다운스트림 접근이 금지되어 있으므로 현재 구성이 승인 범위에 포함되는지 OpenAI 담당자에게 확인해야 합니다. 본 설정은 OpenAI의 Codex 문서를 준수하지만 실제 GPT-6 Cyber 계정에서 사전 검증된 것은 아니므로, 범위가 제한된 단일 태스크부터 작게 시작하시기 바랍니다.
이 모든 과정이 불필요한 경우
단 한 명의 엔지니어가 단일 저장소를 검토하는 상황이라면 Codex만으로도 충분합니다. OpenAI는 GPT-6 Cyber 세션에 자체 샌드박싱 및 자동 검토(Auto-Review) 기능을 권장하며, 이것만으로도 충분할 수 있습니다.
하지만 여러 에이전트와 여러 저장소를 운영하고, 취약점 발견 항목이 여러 사람의 손을 거쳐 전달되는 환경이라면 이야기가 달라집니다. 한편 보안 서비스를 판매하는 업체라면 Daybreak 권한을 고객 대상 워크플로에 적용할 수 없으며, OpenAI는 이러한 팀을 위해 별도의 파트너 프로그램을 안내하고 있습니다.
결론
GPT-6 Cyber는 모든 곳에 기본으로 투입하는 범용 모델이 아니라, 프로세스 후반부에 호출하는 전문가 모델입니다. 이 모델을 가장 잘 활용하는 팀은 이미 명확한 작업 범위, 인수인계 시점마다의 증거 확보, 실행 기록을 꼼꼼히 점검하는 검토 체계를 갖추고 있습니다.
이번 주부터 바로 시작해 보십시오. 에스컬레이션 규칙을 정립하고, 자격 요건을 충족한다면 Daybreak 사용 신청을 진행하며, 직접 소유한 서비스를 대상으로 범위가 명확한 검증 태스크를 하나 등록해 보시기 바랍니다. Sharkly 빠른 시작 가이드를 통해 연결된 Computer에서 첫 에이전트를 바로 실행할 수 있습니다.
자주 묻는 질문(FAQ)
GPT-6 Cyber는 누구나 사용할 수 있나요?
아닙니다. 현재는 승인된 Daybreak Red 고객 중 일부에게만 API 및 Codex를 통해 제공되며, 향후 전체 Red 고객으로 대상을 확대할 계획입니다. OpenAI는 일반 공개(GA) 일정에 대해서는 발표하지 않았습니다.
GPT-6 Cyber의 사용 요금은 얼마인가요?
OpenAI의 표준 단문 컨텍스트 기준 요금은 입력 토큰 100만 개당 20달러, 출력 토큰 100만 개당 100달러이며, 캐시된 입력 토큰은 2달러입니다. 표기된 요금은 변동될 수 있으므로 예산 수립 전 요금 페이지를 확인하시기 바랍니다.
Daybreak Blue에 GPT-6 Cyber가 포함되나요?
아닙니다. Blue는 지원되는 메인라인 모델에 한해 거부 반응을 완화해 줄 뿐, 사이버 특화 모델에 대한 접근 권한은 제공하지 않습니다. 또한 Blue 환경에서 Astra는 기본 안전장치를 그대로 유지합니다.
직접 소유하지 않은 시스템에도 GPT-6 Cyber를 사용할 수 있나요?
테스트에 대한 명시적인 사전 허가를 받은 경우에만 가능합니다. Daybreak 라이선스는 승인 범위를 넘어선 권한을 부여하지 않으며, 오용 적발 시 OpenAI에 의해 접근 권한이 정지되거나 회수될 수 있습니다.
에이전트의 보안 보고서에서 사람은 무엇을 검토해야 하나요?
접근한 대상, 마주친 장애 요인, 그리고 증거가 주장을 충분히 뒷받침하는지 여부 등 실행 기록 전체를 확인해야 합니다. 태스크 레벨 증거(Task-level evidence)를 활용하면 이러한 검토를 훨씬 빠르게 진행할 수 있습니다.