
Anthropic이 9월 28일 Claude Sonnet 5.5를 출시했습니다. 가격은 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 10달러로, Sonnet 5와 동일한 정가이자 Opus 5.5의 절반 수준입니다. Anthropic에 따르면 이전 Sonnet 5보다 30% 이상 빠르며 작업당 비용은 최대 30%까지 절감된다고 합니다. 여러 코딩 에이전트를 운영하는 팀에 있어 가장 주목할 점은, 일상적인 Agent에 투입할 모델이 이제 Anthropic의 출시 벤치마크 표 대부분의 항목에서 플래그십 모델과 불과 몇 포인트 차이밖에 나지 않는다는 사실입니다.
하지만 이 모델을 워크플로 보드에 올리는 작업은 생각만큼 간단하지 않습니다. Claude Code의 default 모델은 Pro, Max, Team, Enterprise 및 Anthropic API에서 기본적으로 Opus 5.5를 가리키므로, Claude Code를 실행하는 Computer는 설정을 직접 바꾸기 전까지 플래그십 모델을 계속 사용하게 됩니다. 또한 sonnet이라는 별칭(alias)은 Anthropic API에서만 Sonnet 5.5를 뜻하며, Bedrock, Google Cloud, Microsoft Foundry에서는 여전히 Sonnet 4.5로 연결됩니다. 따라서 “Sonnet으로 전환했다”고 생각한 팀이라도 Computer 3대에서 각기 다른 3개의 모델이 돌아가고 있어 어느 실행에 어떤 모델이 쓰였는지 전혀 파악하지 못하는 상황에 맞닥뜨릴 수 있습니다. 이 가이드에서는 가장 실용적이면서도 컴팩트한 접근법을 안내합니다. Computer 1대, Agent 1개, 실제 Task 1개로 시작한 뒤, 여전히 Opus 5.5가 비용 대비 제 역할을 하는 영역을 가려내는 단계까지 살펴봅니다.
TL;DR
Computer의 Claude Code를 v2.1.284 이상으로 업데이트하고, sonnet 별칭 대신 전체 ID인 claude-sonnet-5-5를 명시적으로 고정(pin)한 후, Claude Code Runtime 상태가 Available로 뜰 때까지 재검색(rescan)하세요. Sonnet 5.5 특유의 이른 중간 확인 요청과 요청하지 않은 작업 추가를 방지하도록 Agent 지침을 작성하고, 작업 디렉터리는 Temporary로 유지하며, 범위가 명확한 작업에 맞춰 타임아웃을 설정한 뒤 하나의 Task를 할당합니다. Crew에서는 일상적인 팀원에게 Sonnet 5.5를 맡기고, Opus 5.5는 리더 겸 리뷰어로 유지하세요. Agent는 조사, 실행, 테스트 및 보고를 담당합니다. 방향을 잡고 권한을 부여하며 결과를 승인하는 것은 사람의 몫입니다.
모델 설정이 위치하는 곳
Sharkly는 자체적으로 모델을 선택하지 않습니다. Agents 문서에도 명시되어 있습니다. “Agent는 Runtime의 기본 모델을 따릅니다. 특정 모델명을 보장하거나 표시하지 않습니다. 모델 변경은 Agent가 아니라 Runtime 또는 Computer 툴 구성에서 진행하세요.” 같은 페이지에서는 Agent에 모델 선택기나 사고 깊이(thinking-depth) 제어 기능이 제공되지 않는다는 점도 덧붙이고 있습니다.
이는 Sonnet 5.5를 다룰 때 중요한 부분입니다. 이 모델의 동작 변화는 주로 '노력 수준(effort)'에서 비롯되며, effort 설정은 모델이 위치한 곳, 즉 Computer 내부의 Claude Code에 존재하기 때문입니다. Agent는 작업이 처리되는 방식을 정의하고, Computer는 호스트 환경을 제공하며, Runtime(여기서는 Claude Code)은 세션을 실행하고, Task는 이를 공유 기록으로 남깁니다.
1단계: Computer의 Claude Code에 Sonnet 5.5 적용하기
Claude Code 모델 구성 문서에 따르면 Sonnet 5.5를 사용하려면 Claude Code v2.1.284 이상이 필요합니다. 해당 Computer에서 버전을 업데이트하고 접근 권한이 있는 유료 플랜 또는 API 키로 로그인하세요. Claude Code는 Claude Free 플랜에서는 지원되지 않습니다(채팅 계정으로 실행할 수 있는 항목과 불가능한 항목 참조). 그런 다음 해당 호스트의 일반 터미널에서 claude --model claude-sonnet-5-5를 실행합니다. 세션이 정상적으로 시작된다면 Sharkly에서도 사용할 준비가 된 것입니다.
별칭이 아닌 전체 ID를 고정해야 합니다. 현재 Claude Code에서 sonnet 별칭이 가리키는 실제 모델은 환경마다 다릅니다.
| Claude Code가 모델을 가져오는 위치 | sonnet 별칭이 가리키는 대상 |
|---|---|
| Anthropic API | Sonnet 5.5 |
| Claude Platform on AWS | Sonnet 4.6 |
| Amazon Bedrock | Sonnet 4.5 |
| Google Cloud Agent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
모델 ID는 Bedrock을 제외한 모든 환경에서 claude-sonnet-5-5입니다. Bedrock의 경우 글로벌 교차 리전 프로필인 global.anthropic.claude-sonnet-5-5를 통해 실행됩니다. opusplan 역시 동일한 별칭 문제를 안고 있습니다. Opus로 계획을 세우고, 현재 sonnet이 가리키고 있는 모델로 실행하기 때문입니다.
따라서 설정이 확실히 유지되도록 구성해야 합니다. 해당 Computer의 Claude Code 설정에 모델을 직접 지정하여 로컬 서비스가 시작하는 모든 실행이 기본값인 Opus 5.5 대신 Sonnet 5.5를 사용하도록 만들고, 터미널에서 다시 한 번 확인하세요.
다시 Sharkly로 돌아와 Computer 상세 페이지를 열고 재검색(rescan) 또는 연결 테스트 기능을 실행합니다. Claude Code Runtime 상태에 Available이 표시되어야 합니다. Computer가 online으로 표시되는 것은 로컬 서비스가 하트비트를 보내고 있다는 뜻일 뿐이며, 실제 작업 실행이 가능하다는 신호는 Runtime 상태를 통해 확인해야 합니다.
2단계: Sonnet 5.5의 동작 특성에 맞춰 Agent 구성하기
Agents 메뉴를 열고 New Agent를 선택한 다음, Computer와 Claude Code Runtime을 지정합니다. Anthropic의 Sonnet 5.5 프롬프트 작성 가이드를 보면 리뷰 큐에 직접적인 영향을 미칠 수 있는 모델의 동작 습관들이 정리되어 있습니다.
노력 수준(effort)이 실제 사용 모델의 가치를 결정합니다. Claude Code에서 Sonnet 5.5는 기본적으로 medium 노력 수준으로 실행되며, 여기서는 사고(thinking) 기능을 끌 수 없습니다. 출시 당시 공개된 주요 벤치마크 수치들은 대부분 max 설정에서 측정된 결과입니다. Anthropic의 차트에 따르면 CursorBench 4.0에서 Sonnet 5.5는 medium일 때 39.2%, max일 때 55.5%를 기록했으며, 작업당 예상 비용은 각각 0.70달러와 9.67달러였습니다. 이는 어느 설정이 맞고 틀리고의 문제가 아니라 투입되는 예산의 차이입니다. 가이드에서는 요구사항이 명확한 에이전트 코딩 작업에는 medium을 권장하며, 측정 가능한 성능 향상이 꼭 필요한 경우에만 xhigh 및 max를 아껴서 사용할 것을 제안합니다.
너무 일찍 중간 확인을 요청합니다. low 및 medium 노력 수준에서 Sonnet 5.5는 장기 에이전트 작업을 수행하다가 멈추고 중간 확인을 요청하는 경향이 있습니다. Sharkly에서는 이러한 확인 요청이 Task 댓글로 전달되며, Task 상태가 사람의 응답 대기로 전환되어 누군가 답변할 때까지 수신함(Inbox)에 머물게 됩니다. 따라서 Agent에게 합리적인 가정을 세우고 작업을 계속 진행하도록 지시해야 합니다. 또한 low 설정에서는 테스트를 실행하지 않고 코드가 완료되었다고 보고할 수 있으므로 필수 검증 단계를 반드시 거치도록 요구해야 합니다.
요청하지 않은 항목을 임의로 추가합니다. 가이드에 따르면 모든 effort 수준에서 요청하지 않은 테스트 코드, 문서, 사소한 파일들을 생성하는 경향이 있으며, xhigh 및 max에서는 불필요한 추가 리뷰 라운드나 리뷰어 서브에이전트를 띄우기도 합니다. Anthropic의 출시 발표 주석에 그 비용이 잘 드러나 있습니다. Sonnet 5.5는 FrontierCode 평가 시 max에서 xhigh보다 오히려 낮은 점수를 기록했는데, 이는 수많은 서브에이전트를 생성하는 Claude Code의 코드 리뷰 스킬을 과도하게 실행했기 때문입니다. Cognition이 분석한 두 가지 사례에서는 이로 인해 타임아웃이 발생하거나 작업 범위를 벗어난 수정이 이루어졌습니다. 리뷰어 입장에서는 Task 범위 밖의 수정 사항까지 포함된 거대한 diff를 마주하게 되는 셈입니다.
타임아웃과 작업 디렉터리 설정. Anthropic은 Sonnet 5.5를 “범위가 잘 정의된 일상 업무”에 최적화된 모델로 포지셔닝하고 있습니다. 따라서 Task당 타임아웃 역시 이에 맞게 설정해야 하며, 실행 중 타임아웃에 도달한다면 제한 시간을 무작정 늘리기 전에 먼저 Task를 더 작은 단위로 분할해야 합니다. 작업 디렉터리는 Temporary로 유지하세요. 각 Task에 격리된 디렉터리가 할당되며, 리포지토리 기반 실행 시 깨끗한 새 워크트리를 준비하므로 병렬 실행 간에 서로 덮어쓰는 문제가 발생하지 않습니다. 동시 실행 수는 Computer가 실제 부하를 안정적으로 처리하는 것을 확인할 때까지 기본값인 Computer 제한의 50%로 유지하는 것이 좋습니다.
적용할 지침 예시:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior. Do not add tests,
docs, or new files unless the Task asks for them; list any you
think are missing in your report instead.
Do not stop to ask whether to continue. When a detail is ambiguous,
proceed with a stated assumption and record it in your report.
Ask only when different interpretations would materially change
the result.
Run the closest relevant checks before reporting done, and report
failures without hiding them.
Do not start extra review rounds or reviewer subagents.
If a safeguard notice or refusal appears, say so in your report.
Stop and ask before anything destructive or outside the attached
repositories.
3단계: 단일 Task 할당 후 2계층 Crew 구성하기
인수 조건이 명확한 Task를 하나 선택하고 해당 Agent를 담당자(Assignee)로 지정한 뒤, 할당된 작업이 대기하는 Backlog에서 작업 준비 완료 상태로 이동합니다. 실행은 queued, dispatched, running 단계를 거치며, Executions 탭에서 로그가 실시간 스트리밍됩니다.
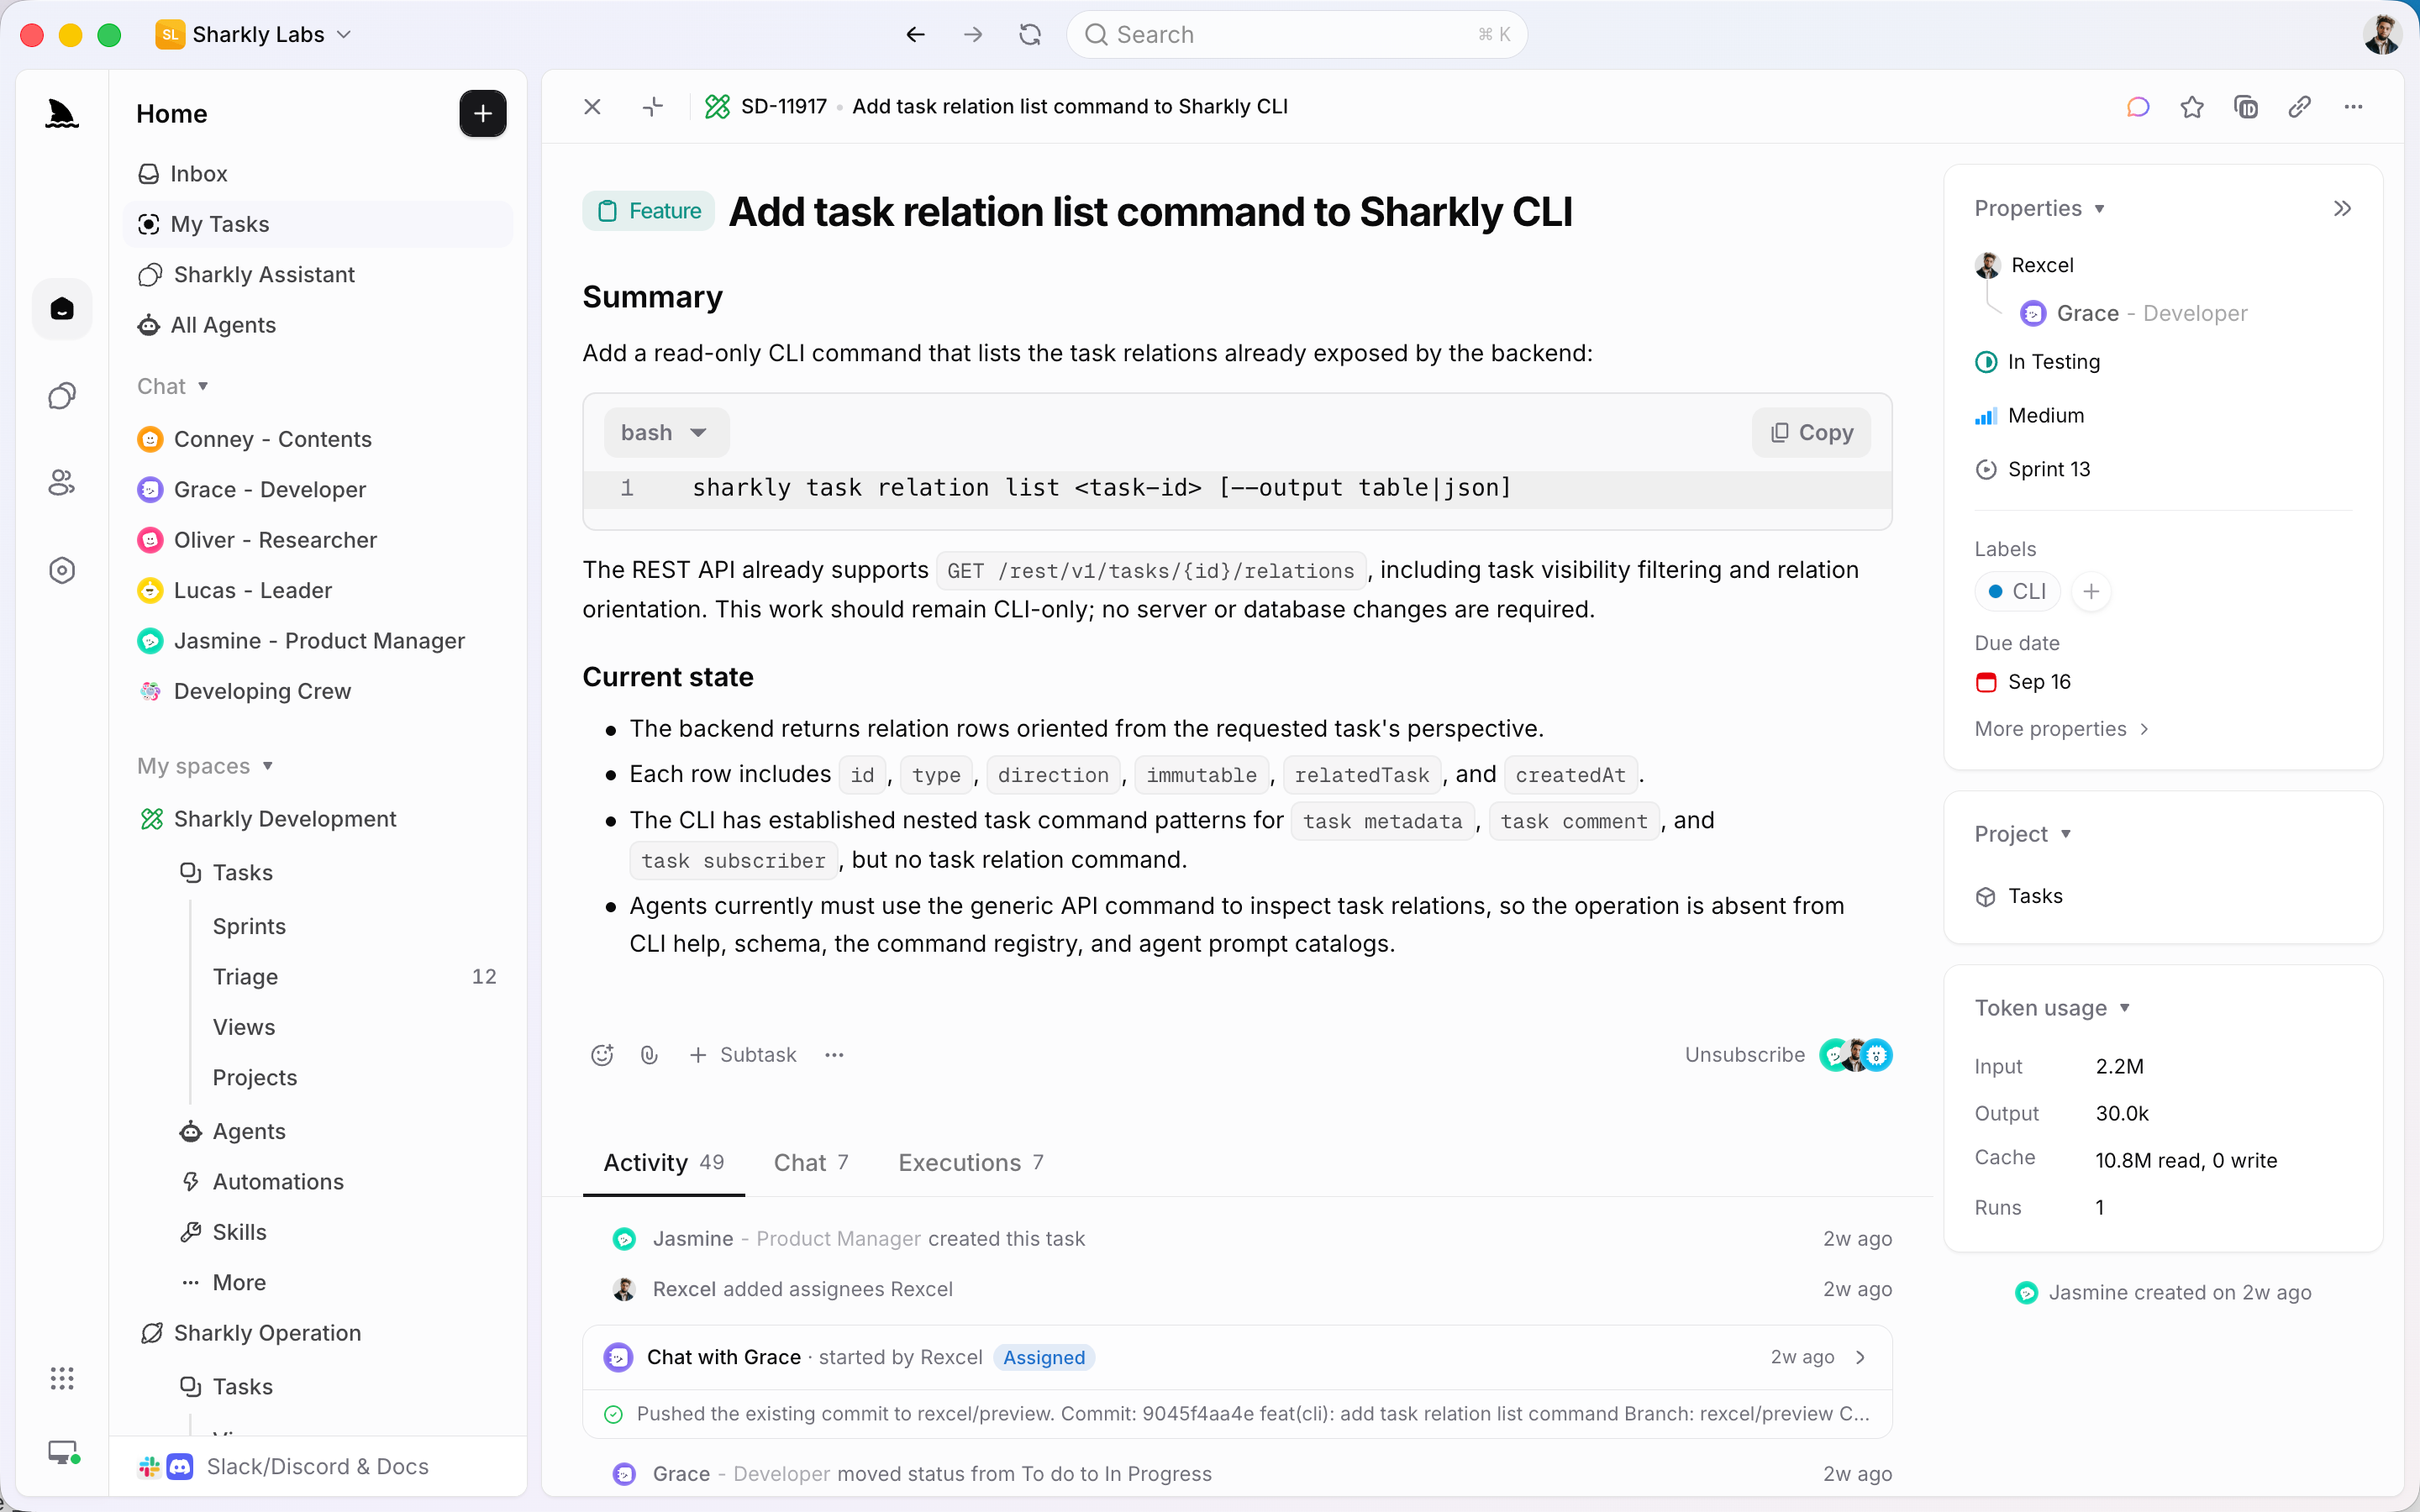
첫 번째 Task는 단일 Agent로 진행하세요. Crew는 1개의 리더 Agent가 조율하는 사람과 Agent들의 재사용 가능한 그룹으로, 리더가 목표를 해석하고 여러 멤버의 결과를 취합하여 하나의 Task로 종합해야 할 때 진가를 발휘합니다. 범위가 명확히 한정된 버그 수정 작업이라면 단일 Agent를 쓰는 것이 올바른 선택입니다.
Crew 내에서의 역할 분담은 Anthropic 자체의 포지셔닝을 따릅니다. Opus 5.5는 “복잡하고 정답이 열려 있는(open-ended) 작업에서 확연히 강력한 성능을 유지”하므로, 계획 수립, 작업 할당, 리뷰라는 리더의 역할에 적합합니다. 반면 일반 멤버의 작업은 Sonnet 5.5의 주력 분야인 범위가 명확한 작업입니다. 출시 페이지에 인용된 한 얼리 테스터 역시 Opus 5.5가 설계한 아키텍처를 Sonnet 5.5가 구현하는 동일한 방식의 역할 분담을 설명하고 있습니다.
| Runtime 모델 | API ID | 100만 토큰당 입력 / 출력 비용 | 적합한 역할 |
|---|---|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 |
$2 / $10 | 일상 업무 담당 멤버: 버그 수정, 범위가 한정된 기능 개발, 문서 작업 |
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | 리더, 리뷰어, 복잡하고 열린 작업 |
| Claude Sonnet 5 | claude-sonnet-5-5 |
$2 / $10 | 이전 세대 Sonnet. 사이버 보안 안전장치에 감지된 요청의 폴백 대상 |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Codex 기반의 두 번째 Runtime (동일 가격대) |
공식 문서상 모델 설정 위치는 Computer의 툴 구성이므로, 가장 직관적인 2계층 구성은 2대의 Computer를 사용하는 것입니다. 한 대는 리더를 위해 Claude Code의 기본값인 Opus 5.5를 유지하고, 다른 한 대는 멤버들을 위해 claude-sonnet-5-5로 고정합니다. 두 모델 간의 분기 기준을 명문화해 두는 것이 좋습니다. 자세한 내용은 Sonnet 5.5와 Opus 5.5 비교 글에서 다루며, 동일한 가격대의 또 다른 Runtime에 대해서는 Sonnet 5.5 대 GPT-6 Sol에서 확인할 수 있습니다. 모델 사용량은 해당 툴에 구성된 구독 플랜이나 API 키를 통해 청구되므로, 비용은 Sharkly가 아닌 각 공급자 청구서에 부과됩니다.
워크플로 보드에서 달라지는 점
실행 속도가 빨라지면 리뷰어의 부담이 가중됩니다. 동일한 예산으로 하루에 완료되는 작업량이 늘어나더라도 사람 리뷰어의 작업 시간은 늘어나지 않습니다. 여기에 테스트 코드와 문서를 임의로 추가하는 모델의 습관까지 더해지면 diff 크기는 더 커집니다. 모델 가격보다는 리뷰 처리 역량을 중심으로 계획을 세워야 합니다.
안전장치에 걸린 실행은 Sonnet 5.5로 처리되지 않을 수 있습니다. 이번 모델은 사이버 보안 안전장치가 탑재된 첫 번째 Sonnet입니다. Anthropic에 따르면 위험도가 높은 사이버 관련 작업은 “Sonnet 5로 눈에 띄게 폴백(fallback)될 것”이며, 시스템 카드에서는 보안상 무해한 작업이라 하더라도 거부 응답이 늘어날 수 있음을 경고하고 있습니다. 하지만 세션 내부에서 폴백이 확인된다고 해서 보드에 그대로 표시되는 것은 아닙니다. Sharkly는 모델명을 별도로 표시하지 않으므로, Agent가 직접 기록하지 않는 한 Task 화면만 보고는 어떤 모델이 응답했는지 알 수 없습니다. 앞선 지침에서 이 내용을 명시하도록 요청한 이유가 바로 여기에 있습니다.
추론 내용은 해당 모델 내에 머뭅니다. Sonnet 5.5는 Opus 5.5의 사고 블록(thinking blocks)을 읽을 수 없고, 다른 어떤 모델도 Sonnet 5.5의 사고 블록을 읽을 수 없으며, 읽을 수 없는 블록은 오류 없이 그대로 폐기됩니다. 단일 Claude Code 세션 내에서조차 두 모델을 전환하면 표시되는 텍스트는 유지되지만 그 이면의 추론 과정은 유실됩니다. Crew 내의 Agent 간에도 추론 과정은 전달되지 않으며, 리뷰어는 멤버가 Task에 작성한 내용만을 전달받게 됩니다. 모델 핸드오프 시 추론 손실 문제에서 해결 방안을 다루고 있으며, 핸드오프 템플릿을 통해 구체적인 가이드를 제공합니다.
이번 주에 모델이 새로 바뀌었습니다. 그러나 작업 할당, 컨텍스트, 진행 상황, 병목 지점, 결과물, 그리고 사람에 의한 검토는 여전히 팀의 시야 안에 머물러 있습니다. 워크트리를 활용해 이를 직접 구축할 수도 있고, Sharkly를 통해 워크플로를 체계적으로 관리할 수도 있습니다.


