
TL;DR: MIT CSAIL의 한 팀이 Python 샌드박스 안에서 프런티어 모델이 Qwen3.5-0.8B의 가중치를 읽고 수정하도록 했습니다. 순전파 횟수에는 엄격한 예산을 걸고, 모든 단계를 로그로 남겼죠. 저자들은 MATH-500 점수가 7.9%에서 48.1%로 올랐다고 보고합니다. 코딩 에이전트가 모델 가중치를 편집하도록 하는 것도 같은 방식으로 할 수 있습니다. 보드에 다섯 개의 태스크를 두고, 각 태스크에 예산을 명시하고, 평가는 별도 에이전트가 맡기고, 편집된 파일은 사람이 승인하는 겁니다.
2026년 11월 2일, Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab이 Sparks of Weight-Space Programming을 발표했습니다. 이들의 연구에 사용된 모델인 GPT-6 Astra는 가중치 텐서를 열고, 이에 대해 numpy와 PyTorch 코드를 작성하고, 가설을 세운 뒤, 0.8B 파라미터 모델의 131,072개 숫자를 바꿨습니다.
구성을 보면 익숙합니다. 샌드박스, 툴 예산, 모든 프롬프트와 실행된 셀의 로그. 이는 하네스를 갖춘 코딩 에이전트이며, 여러분의 팀이 오늘 바로 따라 할 수 있는 부분이 바로 그 하네스입니다.
MIT 팀이 한 일을 숫자로 보기
가중치 공간 프로그래밍(weight-space programming)이란 LLM이 네트워크의 파라미터를 데이터로 읽고, 경사 하강법이나 학습 실행 없이 직접 편집하는 것을 말합니다. MIT의 글은 소규모 모델에서 엄격한 툴 제한을 두고 모든 턴을 로그로 남긴 결과를 보고합니다.
핵심 결과는 Qwen3.5-0.8B 편집입니다.
| 지표 (저자들의 수치) | 베이스 모델 | 편집된 모델 |
|---|---|---|
| MATH-500 | 7.9% | 48.1% |
| GSM8K | 13.8% | 67.1% |
| IFEval | 21.0% | 62.3% |
| 32,768 토큰 한도에 도달한 실행 | 93.0% | 33.1% |
Astra는 토큰이 바닥날 때까지 반복하던 모델의 습성을 15번째와 19번째 레이어의 MLP가 만들어낸 하나의 방향으로 추적한 뒤, 각 레이어의 출력 64개 컬럼에서 그 방향을 빼냈습니다. 131,072개의 가중치, 즉 모델 전체의 0.016%에 해당합니다. 공개된 체크포인트는 Apache-2.0 라이선스이며, 모델 카드에 따르면 베이스 모델과 다른 텐서는 단 두 개뿐입니다. 바로 그 두 레이어의 down_proj.weight 행렬입니다.
결과를 결정하는 건 하네스다
이 글에는 팀 입장에서 헤드라인보다 더 중요한 두 가지 발견이 있습니다.
예산이 결과를 바꿨습니다. 각 순전파는 평균 64개 시퀀스 배치를 처리했습니다. 10회 패스에서는 MATH-500이 12.3%에 그쳤고, 25회에서는 14.1%, 50회에서는 48.1%에 도달했습니다. 같은 모델, 같은 태스크지만 에이전트가 아이디어를 테스트할 수 있는 횟수의 상한이 달랐던 겁니다.
툴이 결과를 바꿨습니다. Gemma 3 270M 변형 두 개의 가중치만 주어졌을 때, Astra는 네 번의 시도 모두에서 어느 쪽이 아첨성(sycophantic) 모델인지 구별하지 못했습니다. 자신이 작성한 최대 16개 텍스트에 대한 어텐션 가중치를 반환하는 툴을 주자, 세 쌍 모두에서 아첨성 모델을 정확히 짚어냈습니다.
즉 두 가지 지렛대가 있습니다. 에이전트가 무엇에 예산을 쓸 수 있는지, 그리고 무엇을 볼 수 있는지입니다. 둘 다 실행이 시작되기 전에 문서로 정해두어야 합니다.
한계도 분명합니다. Astra는 Gemma 3 270M의 MATH-500 성능을 개선하지 못했습니다. 6.8%에서 시작해 최선의 편집이 7.7%에 그쳤죠. 저자들은 이를 모델에 없던 능력을 더한 것이 아니라 장애물을 제거한 편집으로 해석합니다. 이들은 발견들이 초기 단계이며, 몇몇은 단일 실행 결과라고 밝힙니다. 여러분의 실험도 수정이 아니라 검증으로 계획하세요.
코딩 에이전트가 안전하게 모델 가중치를 편집하도록 하는 방법
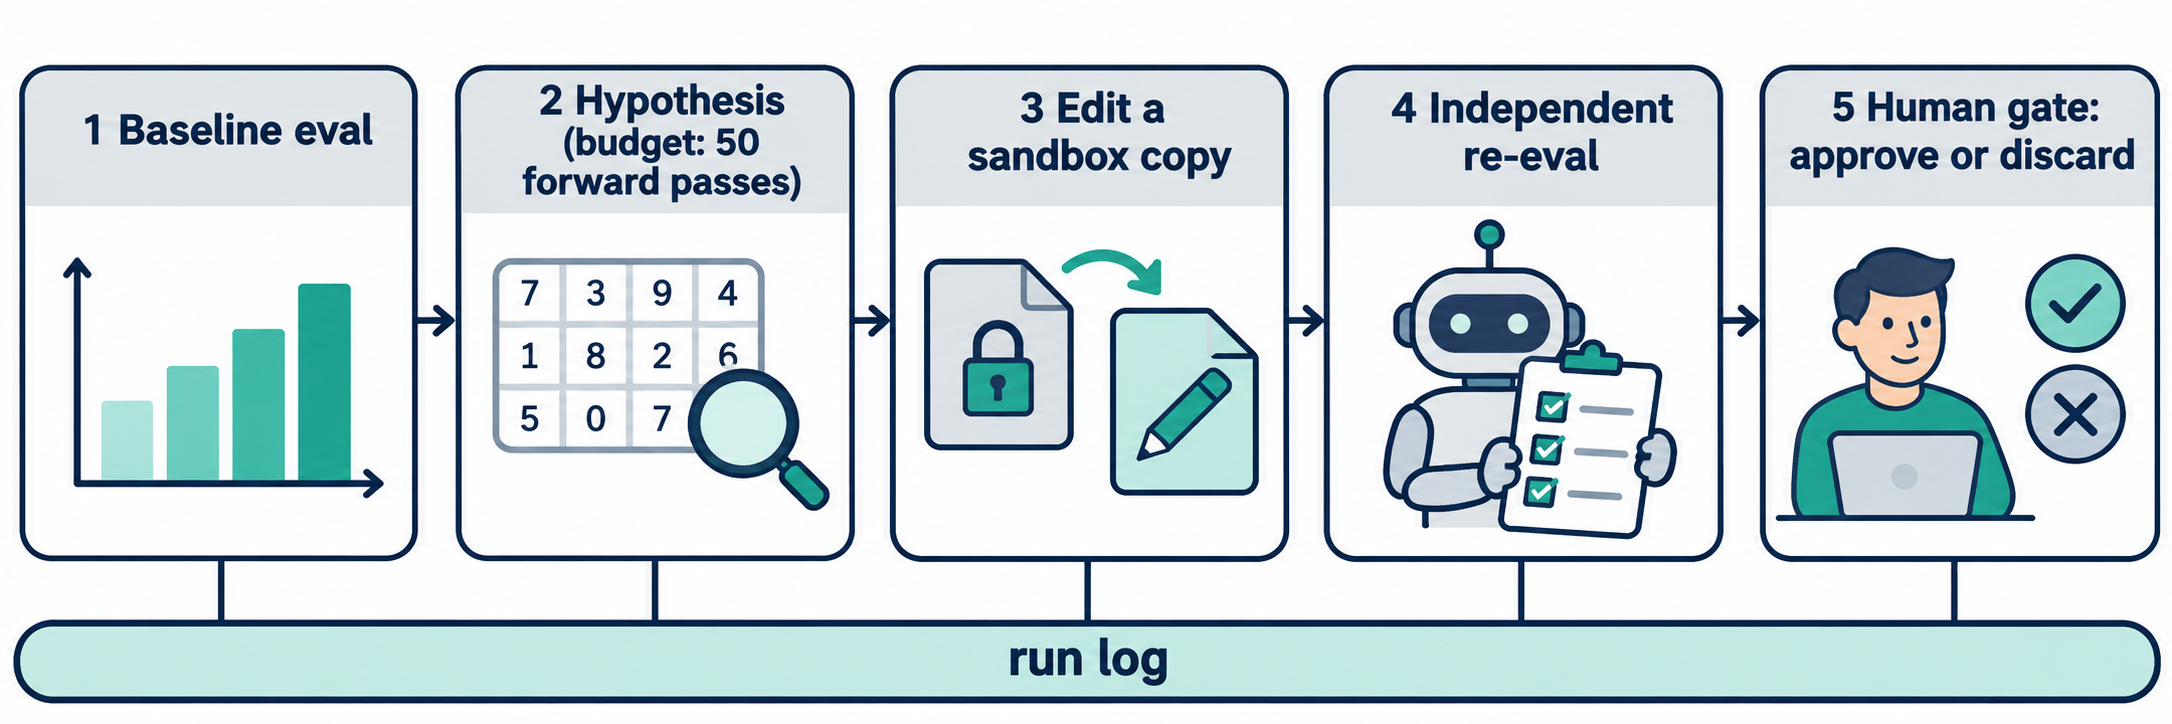
안전한 가중치 공간 실험은 다섯 가지 속성을 갖습니다.
- 원본 가중치는 모든 에이전트에게 읽기 전용입니다.
- 순전파 예산은 태스크에 명시된 숫자이며, 샌드박스가 이를 강제합니다.
- 편집자가 보는 평가 세트는 리뷰어가 실행하는 회귀 세트와 분리되어 있습니다.
- 모든 실행의 로그는 해당 단계에 그대로 붙어 있습니다.
- 편집된 파일이 샌드박스 밖에서 로드되기 전에 사람이 승인합니다.
Sharkly는 순전파를 세거나 텐서를 검사하지 않습니다. 그건 여러분의 샌드박스 스크립트가 하고, 읽기와 편집은 여러분의 런타임(Claude Code, Codex, 또는 이미 사용 중인 다른 에이전트)이 합니다. Sharkly는 작업을 관리합니다. 각 단계의 담당자, 쓸 수 있는 예산, 돌아온 결과, 그리고 승인한 사람까지요. MIT 팀의 로그 저장소에는 Codex 설정과 샌드박스 스크립트가 담긴 harness/ 폴더가 있어 샌드박스 측면을 참고하기 좋습니다.
1단계: 손대지 않은 모델의 베이스라인 평가
첫 태스크는 원본 체크포인트에 평가를 실행하고 점수와 모델이 실패하는 지점을 기록합니다. Qwen3.5-0.8B의 경우 실행의 93.0%가 토큰 한도에 도달했습니다. 가설 수립 태스크에는 바로 이 실패 설명이 필요합니다.
2단계: 가중치를 읽고 가설 작성하기
예산이 걸린 태스크입니다. 숫자를 본문에, 에이전트가 잘못 읽을 수 없는 형태로 적어 넣으세요.
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
태스크에 적힌 예산은 약속이고, 샌드박스 래퍼에 있는 예산은 보증입니다. 둘 다 작성하고, 래퍼가 사용한 패스 수를 출력하도록 해서 그 숫자가 실행 로그에 남게 하세요.
3단계: 샌드박스 복사본에서 편집하기
편집 에이전트는 체크포인트의 복사본을 수정하고 diff를 보고합니다. 원본에 대한 쓰기 권한은 절대 주어지지 않습니다. Sharkly에서는 각 태스크 실행이 격리된 자체 디렉터리를 가지며, 리포지토리 작업에는 실행별로 분리된 워크트리를 사용할 수 있어서 3단계가 1단계에서 측정한 것에 손댈 수 없습니다.
4단계: 리뷰어 에이전트의 독립적 재평가
이 단계는 편집을 수행한 에이전트와 다른 에이전트에게 배정하세요. 1단계 평가를 다시 실행하고, 편집자가 한 번도 본 적 없는 회귀 세트를 추가합니다. Crew를 운영한다면, 리더가 편집은 한 멤버에게, 재평가는 다른 멤버에게 넘길 수 있습니다. 이 패턴은 별도 리뷰어를 둔 혼합 모델 Crew와 일치합니다. 변경을 작성한 에이전트가 그 변경을 평가하는 에이전트가 되어서는 안 된다는 것이죠.
편집자는 자신이 볼 수 있는 것에 맞춰 최적화했기 때문에, 그 문제들에서만 나타나는 향상은 큰 의미가 없습니다.
5단계: diff에 대한 사람의 승인 게이트
마지막 태스크는 세 가지 첨부와 함께 사람에게 도달합니다. 변경된 텐서 목록, 변경 전후 표, 리뷰어의 회귀 결과입니다. 이 태스크가 진행되기 전까지는 샌드박스 밖에서 편집된 체크포인트를 로드하는 것은 없습니다.
다음 짧은 스크립트가 첫 번째 첨부를 만들어냅니다. safetensors 체크포인트 두 개를 비교해 변경된 모든 텐서를 나열합니다.
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
공개된 체크포인트에서는 모델 카드에 명시된 대로 정확히 두 개의 down_proj.weight 텐서가 보여야 합니다. 여러분이 직접 한 편집이 가설에 명시되지 않은 텐서를 건드렸다면, 그것이 바로 그 편집을 버려야 할 이유입니다.
Sharkly에서 보드 운영하기
하나의 실험을 위한 보드는 다음과 같습니다. 각 행은 담당자, 상태, 실행 이력을 갖는 하나의 태스크입니다.
| 태스크 | 담당자 | 예산 또는 게이트 | 완료 조건 |
|---|---|---|---|
| 1. 베이스라인 평가 | 평가 에이전트 | 평가 세트만 | 점수와 실패 기록 게시 |
| 2. 가중치로부터 가설 수립 | 편집 에이전트 | 순전파 50회 | 가설 게시, 사용한 패스 수 기록 |
| 3. 샌드박스 편집 | 편집 에이전트 | 복사본만, 원본은 읽기 전용 | diff와 편집된 파일이 샌드박스에 존재 |
| 4. 재평가 및 회귀 | 리뷰어 에이전트 | 홀드아웃 회귀 세트 | 변경 전후 표 게시 |
| 5. 승인 또는 폐기 | 사람 | 사람 게이트 | 결정을 태스크에 기록 |
blocks 관계로 각 단계를 연결하면 보드에서 체인이 보입니다. Sharkly의 태스크 관계는 범위에 대해 솔직합니다. 관계는 카드에 의존성과 진행 상황을 표시하지만, 태스크를 이동시키거나 실행을 스스로 시작하지는 않습니다. 각 단계는 이전 단계가 끝날 때까지 Backlog에 두세요. 에이전트에게 배정된 태스크는 Backlog에 있는 동안 실행을 시작하지 않으므로, 꺼내는 것이 트리거가 됩니다.
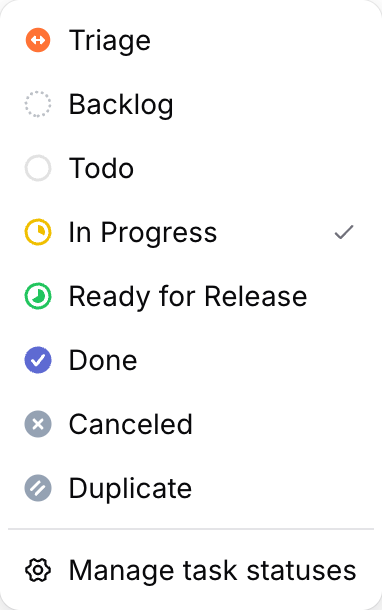
4단계가 끝나면 에이전트는 태스크를 사람 검토 대기 상태로 남길 수 있고, 사람은 Inbox에서 이를 확인합니다. 실행 로그는 각 실행의 시작, 종료, 툴 호출, 트리거를 기록합니다. 이는 해당 단계에 그대로 남는 여러분의 감사 추적입니다. 에이전트를 어디서 멈춰야 하는지에 대해서는 코딩 에이전트를 위한 승인 게이트를 참고하세요.
시작하기 전에 알아둘 현실적 한계
- 작게 시작하세요. 이 연구는 CPU 텐서 접근이 가능한 0.8B와 270M 모델을 사용했습니다. 몇 분 안에 평가할 수 있는 모델을 고르세요.
- 없는 능력에는 향상을 기대하지 마세요. Gemma 결과는 편집이 모델의 막힌 부분을 풀 수는 있어도, 능력을 가르칠 수는 없다는 것을 보여줍니다.
- 단일 실행은 일화로 취급하세요. 편집을 신뢰하기 전에 새 에이전트로 실험을 반복하세요.
결론
MIT 글에서 재사용할 수 있는 교훈은 하네스입니다. 문서로 명시된 예산, 제한된 툴, 완전한 로그, 그리고 다른 사람이 검증할 수 있는 결과입니다. 이것들은 코드를 편집하는 코딩 에이전트 주위에 이미 두고 싶어 하는 통제 장치들입니다.
직접 시도해보려면 Sharkly Space에서 다섯 개의 태스크를 만들고, 1~4단계는 연결된 Computer의 에이전트에게 배정하고, 5단계는 직접 맡으세요. Sharkly는 sharkly.ai에서 무료로 시작할 수 있습니다.
FAQ
코딩 에이전트가 모델 가중치를 편집할 수 있나요?
MIT CSAIL 연구에서는 가능했습니다. GPT-6 Astra는 Python 샌드박스에서 Qwen3.5-0.8B 텐서를 읽고 131,072개의 가중치를 바꿨습니다. 저자들은 MATH-500이 7.9%에서 48.1%로 올랐다고 보고합니다. 다만 이 작업은 초기 단계이고 소규모 모델을 대상으로 했으며, 여러 결과가 단일 실행입니다.
가중치 공간 프로그래밍이란 무엇인가요?
LLM이 네트워크의 파라미터를 데이터로 읽고 학습 없이 직접 편집하는 것입니다. 코드로 텐서를 분석하고, 가설을 세우고, 가중치를 바꾸고, 제한된 횟수의 순전파로 효과를 측정합니다.
순전파 예산이 왜 중요한가요?
저자들의 Qwen 소거 실험에서 10회 패스는 MATH-500에서 12.3%, 25회는 14.1%, 50회는 48.1%에 도달했습니다. 예산은 에이전트가 테스트할 수 있는 아이디어 수를 결정합니다. 태스크에 명시하고 샌드박스에서 강제하세요.
가중치 편집으로 모델에 새로운 능력을 추가할 수 있나요?
이 연구는 그렇지 않다고 시사합니다. Astra의 최선의 편집은 Gemma 3 270M의 MATH-500 성능을 6.8%에서 7.7%로 끌어올리는 데 그쳤습니다. 저자들은 편집이 Qwen의 장애물을 제거한 것이지 새로운 능력을 더한 것이 아니라고 결론짓습니다.
편집된 가중치가 프로덕션에 도달하지 않게 하려면 어떻게 해야 하나요?
원본을 읽기 전용으로 마운트하고, 복사본을 편집하고, 독립적 재평가를 실행하고, 샌드박스 밖에서 파일을 로드하기 전에 사람이 텐서 diff를 승인하도록 요구하세요.


