
OpenAI는 9월 22일 GPT-6 Luna를 출시했습니다. 백만 입력 토큰당 $0.10, 백만 출력 토큰당 $0.50이며, API id는 gpt-6-luna이고 컨텍스트 윈도우는 1M입니다. 이 가격이 되면 흥미로운 질문은 더 이상 이 모델이 추상적으로 충분히 좋은가가 아닙니다. 문제는 보드의 어느 레인을 기꺼이 이 모델에 넘길 것인가, 그리고 저렴한 레인과 비싼 레인이 같은 Computer 위에서 돌아가면서도 어떤 결과가 어느 쪽에서 나왔는지 아무도 헷갈리지 않게 하려면 어떻게 해야 하는가입니다.
이것은 모델 문제이기 전에 구성 문제입니다. Luna를 모든 곳에 묶어버린 팀은 돈을 아꼈다가 리뷰에서 그 돈을 다시 씁니다. 반대로 한 번도 묶지 않는 팀은 Agent가 테스트 파일 이름만 바꾸게 하려고 계속 프리미엄 요금을 냅니다. 이 가이드는 가장 작고 유용한 경로를 택합니다. gpt-6-luna를 하나의 Computer에 올리고, 자체 레인에 유지하고, 실제 Task 하나를 배정하고, 팀 모두가 볼 수 있는 곳에서 결과를 확인하는 것입니다.
요약
연결된 Computer의 Runtime 기본 모델로 gpt-6-luna를 지정하고, 해당 Runtime이 Sharkly에서 Available로 표시되는지 확인하고, 비싼 Agent를 재사용하지 말고 Luna 전용 Agent를 따로 만들어 주고, 긴 실행을 신뢰하기 전에 Task별 타임아웃을 늘리고, Luna는 사람이 1분 안에 결과를 검증할 수 있는 작업에만 투입하세요. Sharkly는 모델 이름을 표시하지 않습니다. 대신 실행, 로그, 질문, 그리고 Task의 결과를 보여줍니다. Agents는 조사하고, 실행하고, 테스트하고, 보고합니다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 받아들입니다.
모델 설정이 있는 위치
Sharkly는 모델을 고르지 않습니다. Agents 문서에 명확히 나와 있습니다. "Agent는 Runtime의 기본 모델을 따릅니다. 특정 모델 이름을 약속하거나 표시하지 않습니다. 모델은 Agent가 아니라 Runtime 또는 Computer 도구 구성에서 변경하세요."
따라서 Agent에는 모델 드롭다운도, 사고 깊이(thinking-depth) 제어도 없습니다. 네 가지 역할이 있고 각각 하나의 임무를 맡습니다. Agent는 작업이 어떻게 처리되어야 하는지를 정의합니다. Computer는 호스트와 로컬 리소스를 제공합니다. Runtime은 실제 에이전트 세션을 수행합니다. Task는 팀을 위한 공유 기록으로 남습니다. 이 구성에 대한 전체 안내는 GPT-6 Sol 가이드에 있으며, 이 글은 저렴한 모델을 보드에 올리는 것과 관련된 부분을 다룹니다.
1단계: Computer에 gpt-6-luna 바인딩하기
이 모델을 실행할 Computer에서 에이전트 도구를 업데이트하고 Luna 접근 권한이 있는 계정 또는 API 키로 로그인하세요. OpenAI는 Luna를 ChatGPT Work와 Plus, Pro, Business, Enterprise, Edu 플랜의 Codex에서 사용할 수 있게 했고, Free와 Go 사용자에게는 데스크톱 앱에서 Luna를 제공했으며, 아직 Chat에는 넣지 않았습니다. 해당 호스트의 일반 터미널에서 codex -m gpt-6-luna로 세션이 시작된다면 Sharkly에서 사용할 수 있습니다.
그다음 해당 Runtime의 실행이 이 모델을 선택하도록 기본값을 설정하세요.
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
이 스니펫에는 두 가지 주의사항이 있습니다. reasoning-effort 키 이름은 Codex 버전마다 다르므로, 해당 Computer에 설치된 빌드의 샘플 구성과 대조해 확인하세요. 그리고 high는 기본값이 아니라 의도적으로 넣은 것입니다. 아래에 인용된 모든 Luna 결과는 high 또는 max effort에서 측정된 것이지, 저렴한 모델을 더 저렴하게 만들려고 고를 만한 설정에서 측정된 것이 아닙니다. [VERIFY]
다시 Sharkly로 돌아와 Computer 상세를 열고 재스캔 또는 연결 테스트를 실행하세요. Runtime이 Available로 표시되어야 합니다. Computer가 online으로만 표시된다는 것은 로컬 서비스가 하트비트를 보내고 있다는 뜻일 뿐입니다. 실행이 시작될 수 있는지는 Runtime 기능 상태가 알려줍니다.
2단계: 저렴한 레인을 눈에 띄게 분리하기
하나의 Computer는 하나 이상의 Runtime을 노출할 수 있고, 각 Runtime은 자체 연결 상태를 보고하며, Computer 상세에서 고유한 이름과 시작 명령을 가진 커스텀 ACP Runtime을 추가할 수 있습니다. 여기서 쓸 만한 지렛대가 바로 이것입니다. Luna 레인에 전용 Runtime 항목과 전용 Agent를 부여하고, 모델 이름이 아니라 레인 이름으로 지정하면, 아무도 실행 로그를 읽지 않고도 보드가 어떤 Task가 어느 레인에서 실행되었는지 알려줍니다.
이것은 겉치레가 아닙니다. Sharkly는 Runtime이 실제로 사용하는 모델을 안정적으로 읽을 수 없으며, 그래서 Agent가 Runtime 기본값을 따르고 모델 이름을 표시하지 않는 것입니다. 만약 누군가 구성 파일을 수정해서 하나의 Agent가 화요일과 목요일 사이에 조용히 모델을 바꾼다면, Task에서 똑같아 보이는 두 실행은 사실 같지 않습니다. 비용 등급별로 레인을 나누면 팀이 이미 보고 있는 바로 그곳에서 이것이 드러납니다. Runtime이 어떻게 감지되고 테스트되는지는 Sharkly의 Computers를 참고하세요.
두 레인을 유지하는 데는 비용이 들기 때문에, 판단 기준을 한 쌍 제시합니다. 해당 Computer에서 여러 사람이 작업을 배정하고, $0.10 실행과 $10 실행의 차이가 누군가에게 중요하다면 Runtime을 분리하세요. 한 명의 엔지니어가 일주일에 몇 개의 Task만 돌린다면 분리하지 마세요. 단일 Runtime과 Task별 판단이 관리하기 더 간단하며, worktree 격리가 이미 실행 간 충돌을 막아줍니다.
3단계: 시작이 느린 모델에 맞게 실행 크기 조정하기
저렴함이 빠름과 같은 말은 아니며, 이 설정을 사람들이 가장 먼저 잘못 잡습니다. 두 벤더 중 어느 쪽도 아닌 제3자인 Artificial Analysis는 GPT-6 Luna의 max 추론 변형이 초당 153.9 출력 토큰, 첫 토큰까지 124.23초를 기록했다고 측정했습니다. 이는 대부분의 사람이 프로세스가 멈췄다고 판단하기 전에 기다리는 시간보다 깁니다.
따라서 Task별 타임아웃을 의도적으로 설정하고, 작업 디렉터리는 Temporary 모드로 유지해서 각 Task가 격리된 디렉터리와 새 worktree를 받도록 하세요. 그러면 같은 저장소에서 두 개의 Luna 실행이 서로 덮어쓸 수 없고, 사고 중인 실행은 죽은 실행과 다르게 보입니다. Task는 상태를 유지하는 반면 터미널 스크롤백은 그렇지 않기 때문입니다.
Crew에서 저렴한 Runtime이 있어야 할 자리
Crew는 한 명의 리더 Agent가 조율하는, 재사용 가능한 People과 Agents의 그룹입니다. OpenAI 자체 수치에서 도출되는 배치 규칙은 Luna가 리더가 아니라 멤버들 사이에 속한다는 것입니다.
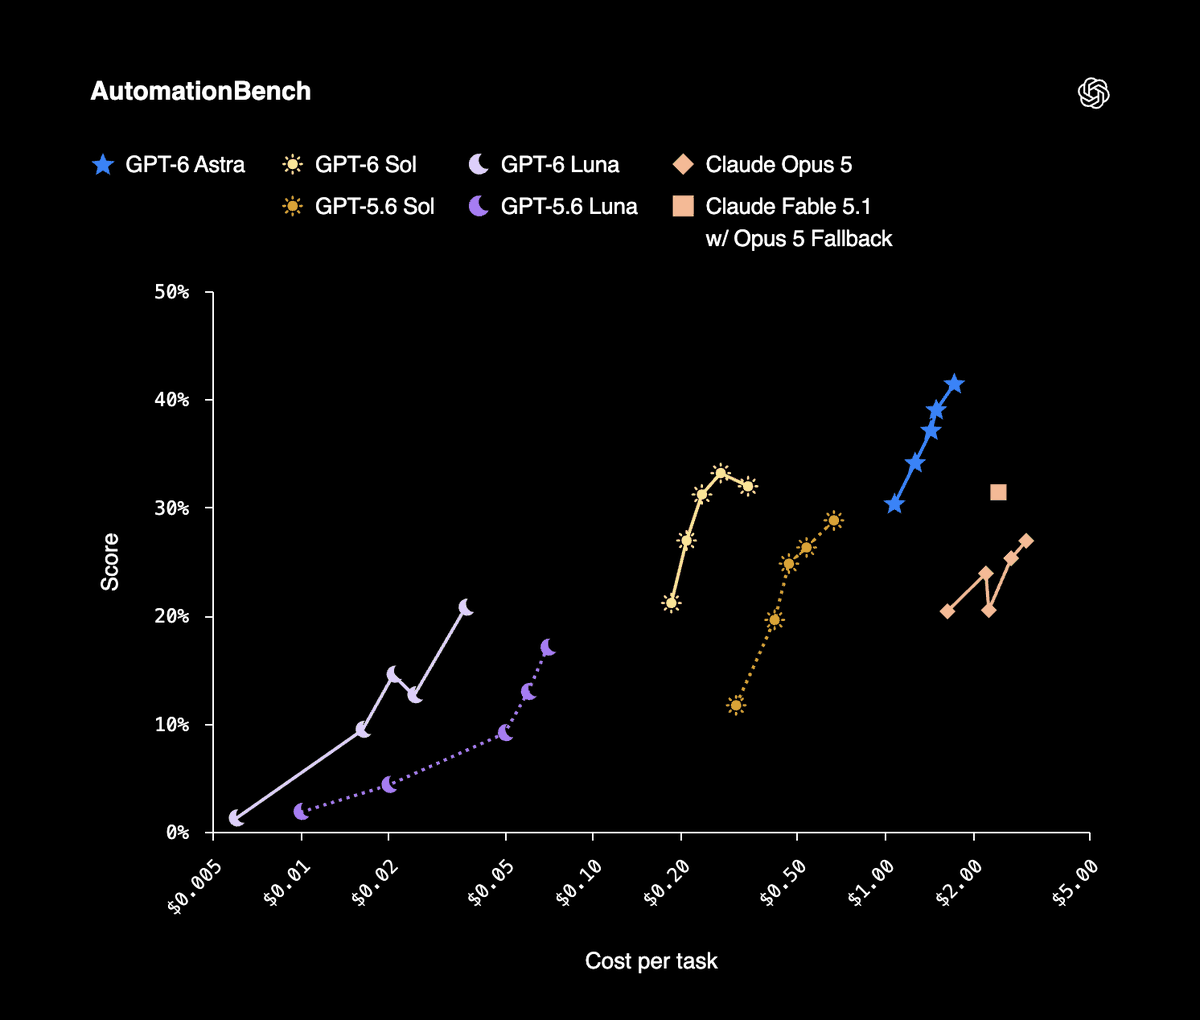
멤버로서의 사례는 강력합니다. DeepSWE 1.1에서 OpenAI는 max effort의 Luna가 66.6%를 기록해 medium effort의 Claude Opus 5, Fable 5와 비슷한 수준이며, 작업당 비용은 Opus 5보다 93%, Fable 5보다 96% 낮다고 보고합니다. OSWorld 2.0 오프라인에서 max 설정의 Luna는 10분의 1 비용으로 medium 설정의 GPT-5.6 Sol을 앞섭니다. AutomationBench 1.0.6에서 high 설정의 Luna는 작업당 비용 58% 낮으면서 전작보다 5.4%포인트 높은 점수를 냅니다. 사실성(factuality)에서는 더 높은 effort의 Luna가 약 100분의 1 비용으로 GPT-5.6 Sol과 대등합니다. OpenAI는 또한 Sol과 Luna가 GPT-5.6 프로모션 가격보다 50% 저렴하다고 설명하는데, 이 단서는 OpenAI 스스로 붙인 것입니다. 기준선이 정가가 아니라 프로모션 요금이라는 뜻입니다.
리더로서의 사례는 약합니다. 벤치마크 때문이 아닙니다. 리더는 목표를 해석하고, 멤버가 무엇을 할지 결정하며, 그들의 결과를 하나의 Task로 모읍니다. 맨 위에서의 해석 오류는 잘못된 실행 하나가 아니라 모든 멤버의 실행이 잘못된 방향을 향하는 것이며, 리더의 토큰에서 아끼는 비용은 그에 비하면 반올림 오차 수준입니다. Crew 리더 가이드에서도 가격표의 반대쪽 끝에서 같은 주장을 합니다.
| 작업 | 레인 | 이유 |
|---|---|---|
| 트리아지, 라벨링, 백로그 정리 | Luna | 볼륨이 크고, 사람이 판정 결과를 몇 초 만에 확인 가능 |
| 테스트 스캐폴딩, 1차 리뷰 노트 | high effort의 Luna | 공개된 성과는 더 낮은 설정이 아니라 high 또는 max에서 나온 것 |
| 실제 배포되는 코드 변경 | $2 / $10의 GPT-6 Sol | 작업당 $0.27에 AutomationBench 33.2% |
| Crew를 위한 모호한 목표 해석 | GPT-6 Sol, 또는 $10 / $50의 Astra | 리더의 실수는 모든 멤버에게 증폭됨 |
이것을 습관이 아니라 규칙으로 적어 두세요. 라우팅 문제 전반은 어떤 코딩 작업에 어떤 모델을 쓸까에서 다룹니다.
OpenAI의 마진을 읽을 때의 주의점 하나: 출시 게시물은 Claude Opus 5를 기준으로 벤치마크하는데, Anthropic은 같은 날 몇 시간 뒤에 Opus 5를 Opus 5.5로 교체했습니다. 위의 Luna 비교는 이름에 적힌 모델의 이전 세대를 기준으로 측정된 것입니다.
저렴한 Runtime이 저렴하게 만들어 주지 않는 것
Luna는 변경을 만들어내는 가격을 낮춥니다. 변경을 받아들이는 가격은 전혀 건드리지 않습니다. 저렴한 실행 열 번은 diff 열 개, 테스트 출력 열 세트, 그리고 사람만이 내릴 수 있는 결정 열 개를 만들어냅니다. OpenAI 자체 지출 수치를 보면 이는 안심이 아니라 경고입니다. 코딩 에이전트에 하루 $600 이상을 쓰는 연구원이 중간값이고, 90번째 백분위는 $7,000이라고 보고합니다. 작업당 저렴함이 바로 그런 청구서를 만드는 방식입니다.
그렇다면 이 제안의 정직한 버전은 이렇습니다. 저렴한 Runtime은 그것이 맡는 작업을 사람이 빠르게 검증할 수 있을 때 바인딩할 가치가 있고, 리뷰어 앞의 대기열만 늘린다면 오히려 손해입니다. 컨텍스트, 진행 상황, 블로커, 결과, 사람의 리뷰를 요청부터 릴리스까지 보이게 유지하고, 레인은 리뷰 시점이 아니라 배정 시점에 결정하세요. 그 스케줄링 측면은 사람의 리뷰가 병목이다에서 다룹니다.
이미 여러 코딩 에이전트를 돌리고 있다면, Computer 하나를 연결하고, 저렴한 레인에 Agent 하나를 만들고, 지루한 작업 하나를 배정해 보세요.


