
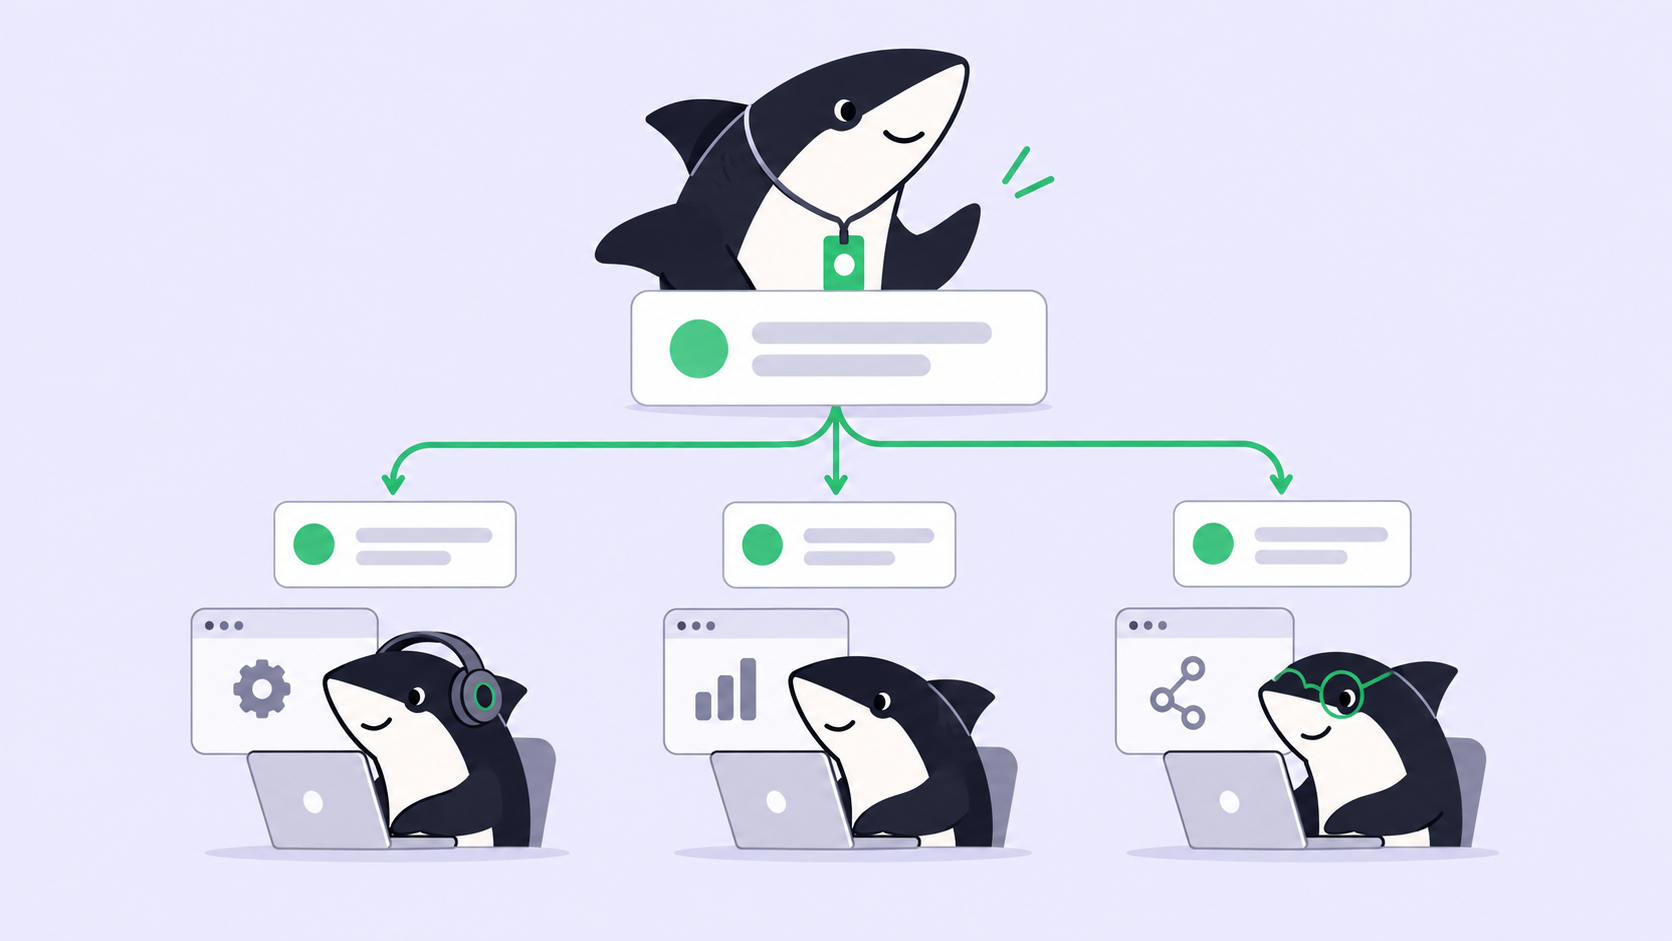
크루 리더는 코드를 거의 작성하지 않는다. 태스크를 읽고, 누가 움직여야 할지 판단하고, 필요한 멤버를 멘션하고, 기다렸다가, 돌아온 결과를 읽고, 그것을 취합하거나 되돌려 보낸다. 입력 100만 토큰당 $10, 출력 100만 토큰당 $50인 GPT-6 Astra에서는, 가장 적은 코드를 생산한 에이전트가 크루에서 가장 높은 단가를 받았다.
OpenAI는 2026년 9월 22일 GPT-6 Sol을 입력 $2, 출력 $10에 출시했다. API id는 gpt-6-sol이며, 양쪽 모두 Astra 단가의 5분의 1 수준이다. 그렇다고 Sol이 사용 가능한 가장 똑똑한 모델이 되는 것은 아니다. 다만 조율을 맡는 자리를, 여러분이 운영하는 모든 크루에 배치할 수 있을 만큼 저렴하게 만든다.
우리는 GPT-6 Astra를 크루 리더로 글에서 Astra를 선택하는 논거를 제시했다. 결정을 내리는 자리에는 팀에서 가장 뛰어난 판단력을 가진 모델을 앉히고, 멤버는 평범해도 된다는 것이다. 그 논거는 여전히 유효하다. 달라진 것은 그것을 실행하는 데 드는 가격이다. 달라지지 않은 것은 사람이 승인하기를 기다리는 완료된 작업의 대기열이다.
TL;DR
크루(Crew)는 여러 사람과 에이전트를 하나의 리더 에이전트가 조율하는 재사용 가능한 그룹이며, 실행은 리더 우선 방식이다. 즉, 어떤 멤버가 시작하기 전에 리더가 태스크 컨텍스트와 크루 지침을 먼저 읽는다. 이 자리는 입력 비중이 높고 태스크당 한 번보다 더 자주 실행되므로, 청구서는 작성량이 아니라 읽기량을 따라간다. 캐시된 입력 읽기에 90% 할인이 적용되는 $2 / $10의 Sol은 모든 크루에 리더를 둘 수 있을 만큼 비용을 낮춰준다. 요구사항 자체가 모호할 때는 Astra나 Claude Opus 5.5를 그 자리에 유지하라. 에이전트는 조사하고, 실행하고, 테스트하고, 보고한다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 승인한다.
리더 자리가 실제로 쓰는 비용
Sharkly 문서는 크루 실행을 고정된 순서로 설명한다. 태스크가 실행 가능한 상태에 있고 리더가 준비되어 있으면, 리더 에이전트가 가장 먼저 시작한다. 태스크 컨텍스트와 크루 지침을 읽은 뒤, 직접 작업을 처리하거나 특정 기여를 위해 자격을 갖춘 에이전트 멤버를 멘션한다. 그들의 결과는 태스크로 돌아오고, 리더가 돌아온 결과를 취합한다.
이것을 청구 구조로 읽어보자. 리더의 모든 턴은 읽기로 시작한다. 설명, 지난번 이후의 댓글, 크루 지침, 사용 가능한 역할, 그리고 멤버들이 이미 올린 내용 말이다. 그리고 짧은 결정이나 멘션을 작성하며 끝난다. 입력은 많고 출력은 적은, 반복되는 패턴이다.
게다가 이 자리는 대부분의 팀이 예상하는 것보다 더 바쁘다. 리더가 태스크당 한 번만 실행되는 게 아니기 때문이다. 크루에 할당된 태스크에서는 멤버가 남긴 자격 요건을 충족하는 일반 댓글 하나가 다른 실행과 동일한 가용성 요건 아래에서 크루 리더를 시작시킬 수 있다. 활발한 논의가 오가는 태스크는, 리더가 그 스레드를 여러 번 읽은 태스크다.
| 리더 자리 후보 | API id | 100만 토큰당 입력 / 출력 | 캐시 입력 |
|---|---|---|---|
| GPT-6 Astra | 미공개 | $10 / $50 | 미공개 |
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | 읽기 $0.20, 쓰기 $5 |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | 읽기 90% 할인 |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | 읽기 90% 할인 |
이는 벤더의 API 요금이며, 청구서 자체보다는 비율을 보여주기 위해 제시한 것이다. 모델 사용은 여러분의 코딩 도구에 설정된 구독이나 API 키를 통해 계속되므로, 팀이 실제로 지불하는 금액은 연결한 요금제에 따라 달라진다.
토큰당 비용이 아니라 태스크당 비용
요구사항을 잘못 읽은 리더는 하루치 멤버 실행을 낭비하게 만든다. 따라서 요금표는 이 문제를 판단할 적절한 기준이 아니다. OpenAI는 점수와 함께 태스크당 비용을 공개하는데, 이쪽이 실제 질문에 더 가깝다.
| OpenAI가 공개한 AutomationBench 1.0.6 | 점수 | 태스크당 비용 |
|---|---|---|
| GPT-6 Sol, 초고 추론 강도 | 33.2% | $0.27 |
| GPT-6 Astra, 낮은 추론 강도 | 30.3% | Sol의 3.9배 |
| Claude Opus 5, 최대 추론 강도 | 26.9% | Sol의 11.1배 |
Agents’ Last Exam V1에서 최대 추론 강도의 Sol은 56.4%를 기록해 Opus 5의 최고 결과를 넘어섰으며, 태스크당 비용은 60% 더 낮다.
그 표를 근거로 지출하기 전에 짚어둘 세 가지 솔직한 단서가 있다. 이 수치는 리더 실행이 아니라 에이전트 전체 벤치마크 실행이다. 조율 비용을 공개하는 곳은 없으며, 리더의 실제 청구액은 여러분의 태스크에서 대화가 얼마나 많이 오가는지에 달려 있다. Astra 행은 낮은 추론 강도로 측정된 것으로, 이는 OpenAI가 비교 기준점으로 직접 선택한 것이지 Astra가 최선을 다한 결과가 아니다. 그리고 OpenAI는 Astra가 “전반적으로 우리의 최고 모델로 계속 남아 있다”고 분명히 밝히는 반면, 제3자인 Artificial Analysis는 Sol의 지능 지수를 48로, Claude Opus 5.5를 58로 평가한다. Sol은 그 자리에 앉힐 수 있는 가장 강력한 모델이 아니다. 모든 크루에서 그 자리에 계속 앉혀둘 수 있을 만큼 저렴한, 가장 강력한 모델이다.
캐싱은 특히 리더 자리에 대한 할인이다
GPT-6는 기본적으로 캐시 적중률을 높이고 캐시된 입력 읽기에 90% 할인을 적용한다. 리더에게 멤버보다 더 중요하게 작용하는 두 가지 변화가 있다. 추론 강도나 사용 가능한 도구 집합을 바꿔도 더 이상 캐시가 무효화되지 않으며, 명시적 브레이크포인트를 통해 캐시된 프리픽스가 어디서 끝나는지 지정할 수 있다. OpenAI는 GitHub가 수십억 건의 요청에서 새로 처리해야 하는 프롬프트 토큰이 50% 이상 줄어든 사례를 언급했다.
크루에서 컨텍스트를 반복 전송하는 최악의 주범은 리더다. 리더는 매 턴마다 동일한 크루 지침, 동일한 저장소 규칙, 그리고 점점 길어지는 태스크 스레드를 읽는데, 그 프리픽스는 매번 거의 동일하다. 이것이 바로 캐시된 프리픽스가 만들어진 형태다. 설정은 에이전트가 아니라 컴퓨터의 런타임에 있다. Sharkly에서 GPT-6 Sol 에이전트를 실행하는 방법에서 어디에 설정하는지 다룬다.
Astra나 Opus 5.5가 자리를 지켜야 할 때
크루가 하루에 경계가 명확한 태스크를 많이 처리하고, 역할이 안정적이며, 대부분의 판단을 매 실행마다 다시 도출하는 대신 크루 지침에 적어둘 수 있다면 Sol을 리더로 사용하라. 요구사항 자체가 모호할 때, 잘못된 해석이 세 명의 멤버를 엉뚱한 길로 보낼 수 있을 때, 또는 태스크가 여러 개의 짧은 작업이 아니라 하나의 긴 작업일 때는 더 비싼 모델을 그 자리에 유지하라.
리더가 저렴해졌다고 해서 에이전트 하나로 할 수 있는 일에 크루를 투입할 이유는 되지 않는다. 문서는 이 점을 명확히 말한다. 작고 잘 정의된 작업이라면 태스크를 하나의 에이전트에 직접 할당하라. 리더가 목표를 해석하고, 다른 에이전트 멤버를 참여시키고, 그 결과를 하나의 태스크로 모아야 할 때 크루를 사용하라. 파일 하나를 고치는 작업을 크루로 돌리면, 어떤 요금이든 전혀 필요하지 않았던 조율 실행 비용을 치르는 셈이다.
리더의 모델을 바꿔도 소유권에는 아무런 변화가 없다. 오너(Owner)가 크루를 관리하고, 리더는 실행을 조율한다.
판단을 글로 적어두는 것이 더 저렴한 자리를 실행 가능하게 만든다.
You lead this Crew. Read the Task and the comments added since your
last turn, then pick the smallest set of members that can finish it.
Mention @backend for API and job changes, @tests for coverage,
@docs for user-facing pages.
Ask a person only when two readings of the requirement would produce
different designs. Otherwise state your assumption and proceed.
Combine member results into one summary: what changed, what you ran,
what failed, what you did not cover. Leave acceptance to a person.
긴 리더 턴을 신뢰하기 전에 알아둘 운영상의 참고 사항이 하나 있다. Artificial Analysis는 GPT-6 Sol의 최대 추론 변형에 대해 첫 토큰까지 102.15초가 걸린다고 측정했는데, 이는 벤더가 아니라 제3자가 최대 추론 설정을 측정한 수치다. [VERIFY] 크루 전체가 리더의 첫 턴을 기다리므로, 생각 중인 리더와 멈춰버린 리더는 상태 표시가 알려주기 전까지 똑같아 보인다.
움직이지 않은 청구서
OpenAI에 따르면 자사 연구원의 중간값은 하루에 코딩 에이전트에 $600 이상을 지출하고, 90번째 백분위는 $7,000을 지출한다. Sol의 요금이라면, 크루 실행을 아껴 쓰던 팀도 이제 몇 배 더 많은 실행을 감당할 수 있다. 그리고 그 실행 하나하나는 모두 사람이 읽어야 하는 결과로 끝난다.
이것이 가격 인하가 개선이 아니라 악화시키는 제약이다. 조율이 저렴해지면 더 많은 병렬 작업, 더 많은 diff, 주당 더 많은 결정을 살 수 있지만, 그에 맞서는 검토 역량은 2026년 9월 22일에 달라지지 않은 사람의 시간으로 측정된다. 에이전트는 조사하고, 실행하고, 테스트하고, 보고한다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 승인한다. 자동화는 팀의 판단이 필요한 지점에서 멈춘다.
그래서 리더의 출력이 요금보다 더 중요하다. 스크롤백 속에 묻히고 끝나는 리더 실행은 $0.27이든 $3이든 가치가 없다. 계획, 멤버 결과, 검증, 실패, 그리고 미해결 질문을 하나의 태스크로 돌려주는 리더 실행이 있어야 사람이 작업을 재구성하는 대신 몇 분 만에 승인할 수 있다. 요청부터 릴리스까지 컨텍스트, 진행 상황, 블로커, 결과, 사람의 검토를 모두 볼 수 있게 유지하면, 더 저렴한 자리는 밀린 작업이 아니라 처리량이 된다.
이번 주에 바꿔야 할 것
- 비싼 리더를 둔 크루 하나를 골라, 해당 컴퓨터의 런타임을
gpt-6-sol로 지정한다. - 리더가 즉흥적으로 판단하도록 비용을 지불했던 부분을 크루 지침에 글로 옮긴다.
- 스프린트 하나를 실행하고 이전 스프린트와 두 가지 수치를 비교한다. 완료된 태스크와, 검토 후 되돌려진 태스크다. 되돌려진 태스크가 늘었다면, 기존 자리가 생각보다 더 많은 일을 하고 있었던 것이다.
이미 여러 에이전트를 운영하고 있다면, Sharkly에서 그들의 태스크와 결과를 한곳에서 관리할 수 있다.


