
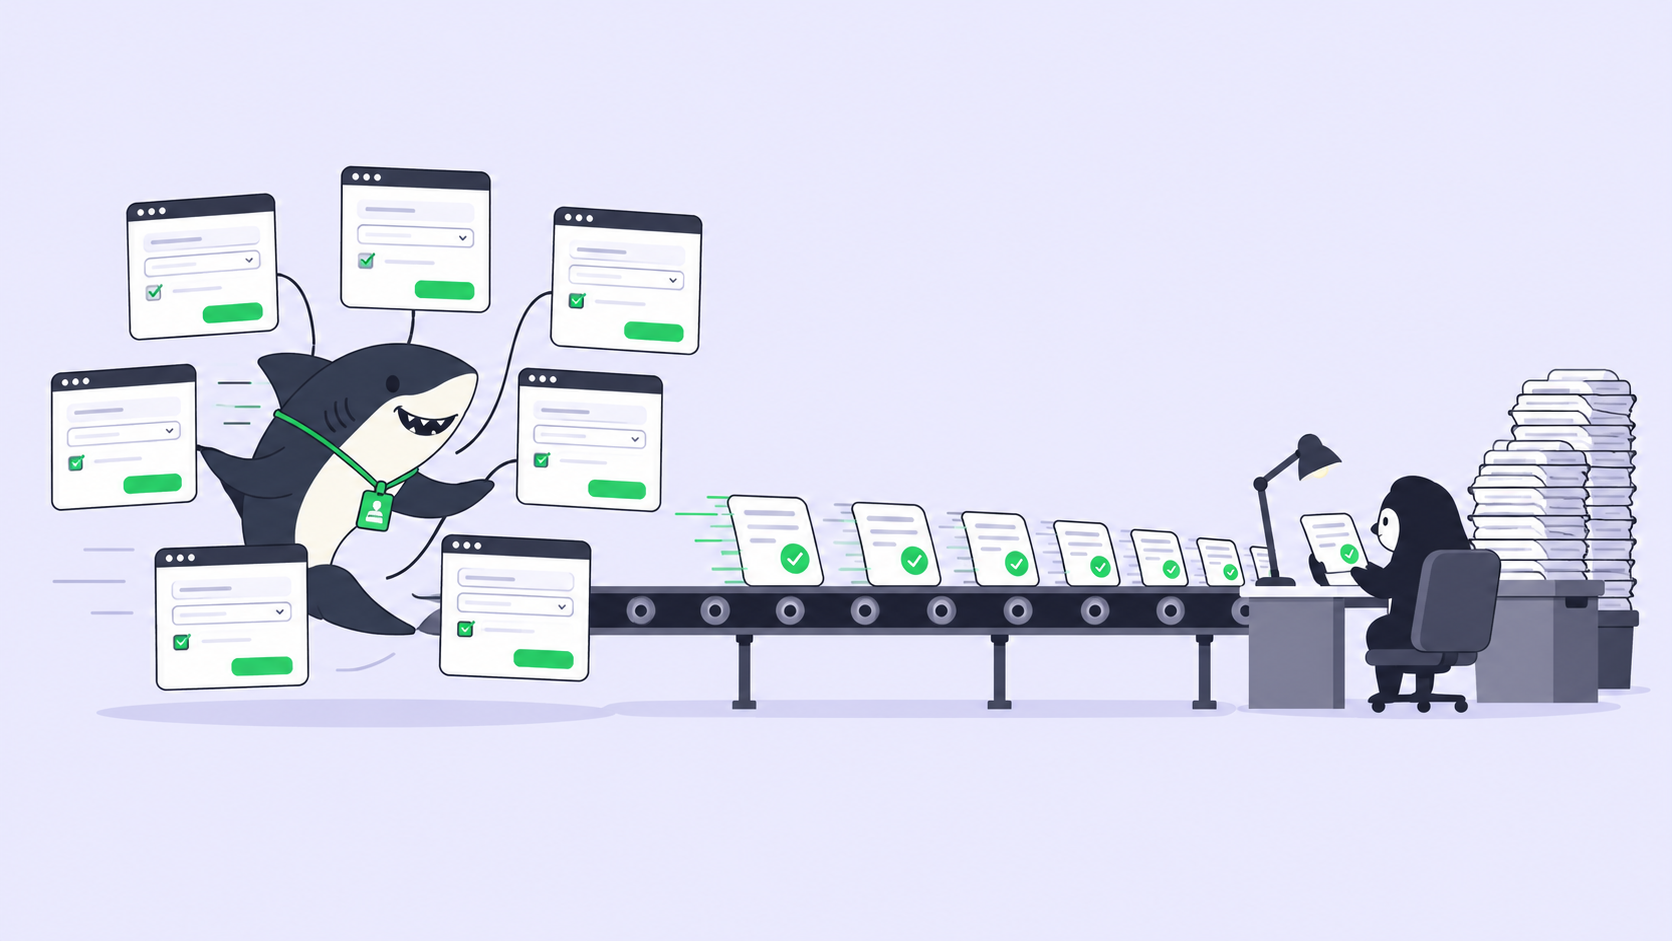
Anthropic은 10월 7일 Claude Haiku 5.5를 출시하며 웹 브라우저 기반 작업에 최적화된 모델로 전면에 내세웠습니다. 출시 안내 글에서는 이 모델을 “실시간 고객 지원 및 브라우저 활용(browser use)과 같이 속도에 민감한 작업”에 적합하다고 소개하고 있으며, 제품 페이지에는 양식 작성(form filling), 데이터 입력, 앱 간 정보 이동 등이 주요 활용 사례로 명시되어 있습니다. 또한 이번 릴리스를 통해 Anthropic의 Python 및 TypeScript SDK에 컴퓨터 사용(computer use) 및 브라우저 사용 기능이 베타 버전으로 추가되었습니다. Anthropic이 발표한 컴퓨터 사용 벤치마크인 OSWorld 2.1에서 Haiku 5.5는 최대 에포트(max effort) 설정 시 시도당 약 0.61달러로 72.4%를 기록했고, 기본값인 중간 에포트(medium effort) 설정에서는 시도당 약 0.13달러로 53.3%를 기록했습니다.
하지만 전면에 내세운 대표 수치는 부분 점수(partial-credit) 기준입니다. 시스템 카드를 확인해 보면 동일한 실행에서 엄격한 성공률(strict pass rate)은 37.1%에 불과합니다. 따라서 Haiku 5.5를 브라우저 자동화 파이프라인에 연결하면 실행 비용은 몇 센트에 불과하지만, 십중팔구 작업이 일부만 완료된 결과를 얻게 됩니다. 실행 비용은 저렴해졌지만, 이를 검토하는 비용은 결코 저렴해지지 않았습니다. 여러 에이전트를 운영하는 팀의 경우, 브라우저 자동화의 실질적인 비용 부담이 결국 그 결과를 검토하는 담당자에게 전가되는 셈입니다.
핵심 요약 (TL;DR)
Anthropic의 OSWorld 2.1 오프라인 서브셋 평가에서 Haiku 5.5는 부분 점수 기준 평균 72.4%를 기록했으나, 완벽하게 성공한 비율은 37.1%에 그쳤습니다. Sonnet 5.5와 Opus 5.5 역시 훨씬 더 비싼 가격에도 불구하고 동일하게 34~35%포인트의 격차를 보입니다. 검토가 끝나기 전까지는 모든 브라우저 실행 결과를 ‘부분 완료’ 상태로 간주해야 합니다. 작업(Task)에 엄격한 승인 기준(acceptance check)을 명시하고, 에이전트(Agent)가 최종 제출(submit) 동작 전에 멈춰 완료된 항목, 미완료 항목, 증빙 자료를 보고하도록 하세요. 그리고 사람이 에이전트를 @멘션하는 댓글을 남겨 최종 단계를 승인하도록 해야 합니다. 검토 시간을 아끼기 위해 에포트(effort) 설정을 높이세요. 실행 비용은 가장 저렴한 부분일 뿐입니다. 에이전트는 조사하고, 실행하고, 테스트하고, 보고합니다. 방향을 정하고, 권한을 부여하며, 결과를 최종 승인하는 것은 사람의 몫입니다.
부분 완료는 완료된 것이 아닙니다
Anthropic은 OSWorld 2.1의 108개 작업 중 82개를 대상으로 1080p 해상도, 시도당 최대 500단계, 최대 에포트 설정으로 5회 시험하여 평균을 냈습니다. 모델당 두 가지 수치가 발표되었는데, 검토자가 실제로 감당해야 하는 것은 바로 두 번째 수치입니다.
| 모델 (최대 에포트) | 부분 점수 | 엄격한 성공률 | 격차 | 시도당 비용 | 엄격한 성공당 비용 (자체 계산) |
|---|---|---|---|---|---|
| Haiku 5.5 | 72.4% | 37.1% | 35.3%p | $0.61 | 약 $1.65 |
| Sonnet 5.5 | 83.9% | 48.8% | 35.1%p | $5.73 | 약 $11.75 |
| Opus 5.5 | 87.2% | 53.2% | 34.0%p | 집계되지 않음 | 집계되지 않음 |
첫째, 이러한 격차는 비단 Haiku만의 문제가 아닙니다. Claude 제품군의 모든 모델은 “대부분의 단계를 수행했음”과 “작업이 완전히 완료됨” 사이에 약 35%포인트의 간극을 보이며, 심지어 Opus 5.5조차 완전 성공률은 절반 수준에 불과합니다. 이번 측정 결과에서 보듯, 컴퓨터 사용 작업 시도의 상당수는 불완전하게 끝납니다. 둘째, Haiku 5.5는 이렇게 부분적으로 완료된 결과물을 매우 저렴한 비용으로 양산할 수 있게 합니다. 엄격한 성공 기준 비용은 Sonnet 5.5의 약 7분의 1 수준이며, 시도당 비용은 약 9분의 1에 불과합니다.
브라우저 작업에서 가장 위험한 경우가 바로 이 ‘부분 완료’입니다. 아예 실패한 실행은 아무런 흔적도 남기지 않습니다. 하지만 40개의 레코드 중 31개만 CRM으로 옮겨두었거나, 공급업체 양식을 세금 항목 직전까지만 작성해 둔 실행은 외부 시스템에 언뜻 보기에 완료된 것처럼 보이는 상태를 남깁니다. 검토자는 누락된 9개의 레코드를 직접 찾아내야 하지만, 화면의 그 어디에서도 누락된 항목을 가리켜주지 않습니다.
실행 비용이 몇 센트에 불과할 때 실제 비용은 어디로 향하는가
브라우저 자동화 비용이 저렴해지면 예산에서 주시해야 할 항목이 달라집니다. 시도당 0.13달러라면 100번의 양식 작성 작업은 모델 사용료 청구서에서 거의 무시해도 될 수준입니다. 하지만 입력된 내용을 확인하기 위해 사람의 손길이 일일이 필요한 100번의 실행은 누군가의 하루치 업무 시간을 통째로 소모할 수 있습니다. Haiku 5.5는 100K 토큰 이하 프롬프트에서 Haiku 4.5보다 90% 저렴해졌지만, 검토자의 인건비는 저렴해지지 않았습니다.
가격 정책에도 주의할 점이 있습니다. Haiku 5.5는 100K 토큰 이하 프롬프트의 경우 100만 입력 토큰당 0.10달러, 100만 출력 토큰당 0.50달러이지만, 100K 토큰을 초과하는 프롬프트는 각각 0.50달러와 2.50달러로 책정되어 있습니다. 브라우저 세션이 길어지면 프롬프트 크기가 이 기준선을 넘길 수 있으며, 그 이후부터는 각 요청마다 더 높은 요금이 부과됩니다. 브라우저 작업(Task)을 짧게 유지해야 하는 이유가 바로 여기에 있습니다. 하나의 양식, 한 묶음의 레코드당 하나의 작업으로 분할하세요.
사람의 검토가 병목이다 및 인간 근무일당 에이전트 근무일 포스트에서도 이미 지적한 바 있습니다. Haiku 5.5가 바꾼 것은 그 비율입니다. 실행당 0.13달러 수준에서는 모델 비용이 거의 체감되지 않으며, 검토 대기열의 비용까지 합산하면 저렴한 모델이 오히려 더 비쌀 수 있습니다. 이제 남은 유일한 해결책은 각 검토 과정을 더 빠르게 만드는 것뿐입니다.
컴퓨터 사용 에이전트 검토: 작업(Task)에 반드시 담아야 할 내용
브라우저 에이전트의 작업은 검토하는 데 드는 시간이 작업을 직접 다시 수행하는 것보다 적게 걸릴 때 비로소 ‘검토 가능’하다고 할 수 있습니다. 이는 에이전트가 사후에 지어낼 수 없는 세 가지 요소에 달려 있습니다. 바로 실행 전에 작성된 엄격한 승인 기준(acceptance check), 완료된 것과 미완료된 것을 구분한 보고서, 그리고 세션을 다시 재생해 볼 필요 없이 사람이 바로 열어볼 수 있는 증빙 자료(evidence)입니다.
Sharkly에서 작업(Task)은 이미 공유 레코드 역할을 합니다. 설명(description), 댓글, 첨부 파일, 활동 내역이 모두 여기에 보관되며, 에이전트가 팀을 위해 작성한 텍스트는 실행과 연결된 댓글 형태로 작업에 저장됩니다. 또한 실행 로그에는 도구 호출(tool calls)과 런타임(Runtime) 이벤트가 기록됩니다. 따라서 검토 체계의 설계는 두 곳에서 이루어집니다. 즉, 작업 설명에는 ‘완료’의 정의가 무엇인지 명시하고, 에이전트 지침(instructions)에는 보고서에 무엇이 포함되어야 하는지 정의하는 것입니다. 브라우저 데이터 입력 에이전트 지침의 기본 예시는 다음과 같습니다.
Restate the acceptance check from the Task description before you start.
Work up to, but not including, any submit, send, publish, pay, or delete action.
Then stop and report, in this order:
  Done: every record or field you completed, by its identifier.
  Not done: everything you skipped or could not complete, and why.
  Check: the acceptance check, and whether your own count meets it.
  Evidence: the paths of the screenshots you saved in the task directory.
Leave the Task waiting for human review. Do not take the final action
until a person @ mentions you in a comment on this Task to release it.
승인 기준은 단순히 “스프레드시트 가져오기”가 아니라 “CRM에 40개 행 입력, 각 행마다 일치하는 이메일 포함”과 같이 계량 가능한 형태로 작성하세요. “미완료(Not done)” 목록은 부분 점수가 가려버리는 핵심 영역입니다. 건너뛴 항목을 구체적으로 밝히면, 모호한 72%짜리 실행이 ‘남은 잔여 작업이 명확히 파악된 72%짜리 실행’으로 바뀝니다. 보고서 형식에 대한 자세한 내용은 작업 수준의 증빙 자료로 에이전트 작업 검토하기 가이드를 참조하세요.
Sharkly의 에이전트 설명서에 따르면, 에이전트는 런타임의 기본 모델을 따릅니다. 모델을 변경하려면 에이전트 또는 런타임의 사용자 지정 인수(Custom arguments)에 지정해야 합니다(Claude Code의 경우 claude-haiku-5-5). 별도의 모델 선택 드롭다운은 제공되지 않습니다. 설정 방법은 Sharkly에서 Claude Haiku 5.5 에이전트 실행하기 포스트에 안내되어 있습니다.
제출(Submit) 전에 멈추기
초안 단계라면 부분 완료도 괜찮지만, 이미 제출된 양식이라면 부분 완료는 용납될 수 없습니다. 따라서 모델이 알아서 잘 처리해 줄 것이라 막연히 기대하지 말고, 되돌릴 수 없는 최종 실행 단계는 실행 흐름에서 분리하세요.
이 패턴은 Sharkly에 이미 마련된 기능들을 활용합니다. 에이전트는 최종 작업 직전까지만 진행한 뒤 작업을 사람의 검토 대기 상태로 남겨두며, 이는 검토자의 수신함(Inbox)에 표시됩니다. 검토자는 보고서와 스크린샷을 확인하여 수정하거나 반려할 수 있으며, 승인할 경우 작업 댓글에서 에이전트를 @멘션하여 최종 작업을 진행하도록 합니다. 일반 댓글로는 에이전트가 실행되지 않으며, 멘션을 통해 작업 내 대화가 시작되거나 이어지고 에이전트의 응답은 해당 실행에 연결된 또 다른 댓글로 저장됩니다. 최종 제출은 사람이 승인한 후, 동일한 작업 및 동일한 레코드 안에서 이루어집니다. 이러한 중단점을 어디에 더 배치해야 하는지는 코딩 에이전트를 위한 승인 게이트 가이드에서 다룹니다.
이러한 승인 게이트는 브라우저 작업의 또 다른 위험 요소도 차단합니다. 브라우저 에이전트는 자신이 작성하지 않은 웹페이지를 읽습니다. Anthropic의 시스템 카드에 따르면 Haiku 5.5는 이전 Haiku 모델보다 프롬프트 인젝션(prompt injection)에 훨씬 강하게 저항하며, 컴퓨터 사용 환경의 적응형 공격자(adaptive attackers)를 상대로 프론티어 모델에 준하는 방어 성능을 보입니다. 그러나 이는 벤치마크 결과일 뿐 귀사의 공급업체 포털 환경을 보장하는 것은 아니며, 사람의 댓글 승인 없이는 제출 버튼에 도달할 수 없도록 격리된 인젝션 명령은 사고 규모를 대폭 줄여줍니다. 호스트 측 경계 설정(전용 컴퓨터, 비밀 환경 변수를 통해 에이전트별로 바인딩된 자격 증명, 한 번에 하나의 브라우저 실행)은 컴퓨터 사용 안전장치(guardrails) 가이드와 동일하며, 자세한 내용은 프롬프트 인젝션 및 에이전트 가드레일에서 확인할 수 있습니다.
자동화 라인 구축 시 판단 기준은 다음과 같습니다. 검토 결과를 개수나 목록으로 1분 이내에 확인할 수 있고, 최종 동작이 되돌릴 수 있거나 댓글 승인 게이트로 제어될 때는 Haiku 5.5 브라우저 에이전트를 활용하세요. 반면 검토 작업 자체가 업무를 처음부터 다시 하는 것과 다름없다면 사람이 직접 수행하거나 동일한 게이트를 둔 더 큰 모델을 사용하세요. 그런 상황에서 37%의 엄격한 성공률은 결국 일만 두 번 하게 만들 뿐이기 때문입니다.
에포트(Effort)에 투자하여 검토 비용 절감하기
Haiku 5.5는 Anthropic의 Haiku 제품군 중 최초로 에포트(effort) 설정 기능을 지원하며 기본값은 중간(medium)입니다. OSWorld 평가에서 에포트 설정은 매우 적은 추가 비용만으로도 부분 점수를 크게 끌어올립니다.
| 에포트 | 부분 점수 | 시도당 비용 |
|---|---|---|
| Low | 42.0% | $0.07 |
| Medium (기본값) | 53.3% | $0.13 |
| High | 61.3% | $0.18 |
| Xhigh | 67.6% | $0.28 |
| Max | 72.4% | $0.61 |
중간(medium)에서 최대(max)로 올리면 시도당 약 0.49달러의 비용이 추가되지만 부분 점수는 19%포인트 상승합니다. 이러한 점수 향상으로 사람의 검토 시간이 조금이라도 단축된다면, 사람이 검토하는 모든 브라우저 작업에서는 최대(max) 설정이 오히려 더 경제적인 선택입니다. 시스템 카드에서는 에포트별 엄격한 성공률을 차트로 보여주지만 구체적인 수치는 최대(max) 설정에서만 공개하고 있으므로, 더 낮은 레벨을 선택하기 전에 실제 작업 환경에서 엄격한 성공률을 직접 측정해 보아야 합니다. 에포트는 컴퓨터 환경의 Claude Code에서 설정하며, 에이전트 자체에는 모델 선택기나 사고 깊이(thinking-depth) 제어 기능이 제공되지 않습니다. 따분한 80%를 위한 Luna에서 다룬 것처럼 아무도 결과물을 검토하지 않는 영역이라면 저렴한 파이프라인을 저렴하게 유지해도 좋지만, 브라우저 자동화 라인은 그런 영역이 아닙니다.
외부 시스템에 데이터를 입력하는 브라우저 작업은 누군가의 최종 승인이 필요하므로, 대규모 실행의 하위 단계로 묻어두기보다는 독립된 작업(Task)으로 분리해야 합니다. 이에 대한 일반적인 원칙은 하위 에이전트로서의 Haiku 5.5와 독립 에이전트로서의 Haiku 5.5에서 자세히 다룹니다.
더 저렴해진 브라우저 에이전트는 더 많은 실행을 의미하며, 실행이 많아질수록 누군가의 검토를 기다리는 ‘부분 완료’ 결과물도 늘어납니다. 이미 여러 에이전트를 운영 중이라면, Sharkly를 통해 에이전트의 작업과 결과를 한곳에서 효율적으로 관리해 보세요.


