
실제 업무를 어떤 코딩 에이전트에게 맡길지 고민하고 있다면 선택지는 Claude Code, Codex, Gemini CLI, OpenCode, 또는 이 중 둘을 동시에 쓰는 것일 겁니다. 그래서 벤치마크 점수를 살펴봅니다. 한 에이전트는 공개 태스크 세트의 68%를 해결하고, 다른 하나는 71%를 해결한다고 하니 그 숫자로 선택하라는 셈이죠. 그런데 막상 에이전트가 여러분의 저장소에 들어오면, 어떤 공개 데이터셋에도 없던 빌드 단계에서 멈춰버립니다.
벤치마크는 고정된, 모두에게 공통된 문제 집합을 측정합니다. 여러분의 코드베이스는 사적인 문제 집합입니다. 여러분만의 관례, 여러분의 모노레포 구조, 아무도 신경 안 쓰는 불안정한 테스트, 단 한 사람만 이해하는 배포 스크립트까지요. 여러분의 한 주를 결정하는 점수는 그 코드 위에서 직접 생성한 점수이지, 어떤 연구소가 발표한 점수가 아닙니다. 이 가이드는 실제로 출시하는 소프트웨어에서 코딩 에이전트를 비교하는 방법과, 에이전트들이 서로 엉키지 않도록 터미널 다섯 개를 열지 않고도 그 비교를 수행하는 방법을 다룹니다.
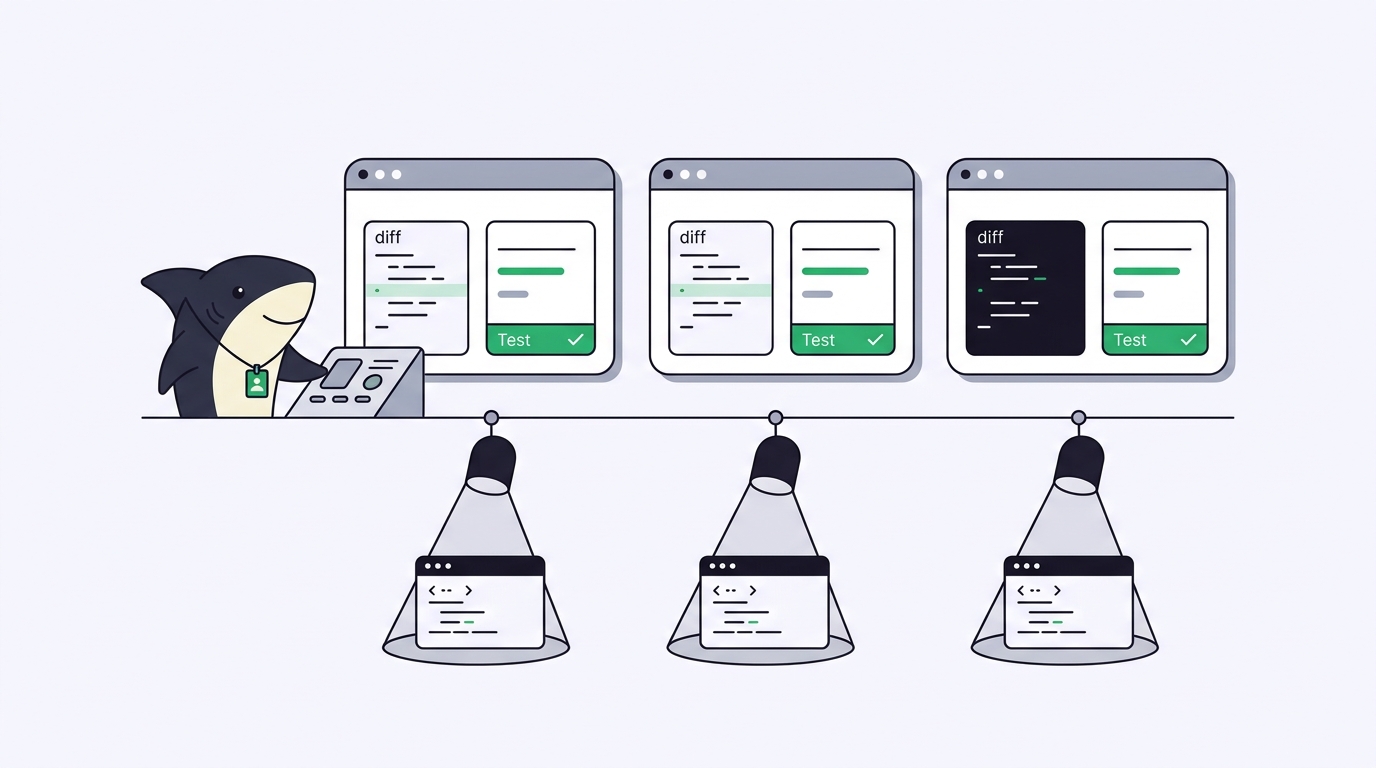
Sharkly는 바로 그 방법이 도착하는 지점입니다. Sharkly는 올인원 에이전트 명령 및 관리 플랫폼으로, 여러분의 컴퓨터를 연결하고 동일한 Task를 서로 다른 Agent에 할당하면 모든 실행의 diff, 테스트 출력, 리뷰가 한곳으로 모입니다. 그래야 공정한 비교가 가능합니다. 여러분이 측정하고자 하는 변수는 에이전트이지, 세 개의 실행이 서로 간섭하지 않게 하려고 터미널을 저글링하는 행위가 아닙니다.
벤치마크 점수는 여러분의 저장소가 아니라 데이터셋을 측정한다
코딩 에이전트 벤치마크는 모두에게 동일한 방식으로 채점되는 고정된 공개 테스트 세트입니다. 바로 그 점이 모델을 만드는 연구소에는 유용하고, 여러분에게는 형편없는 예측 지표가 되는 이유입니다.
SWE-bench 같은 공개 벤치마크는 잘 알려진 오픈소스 프로젝트에서 태스크를 가져오며, 정교하게 조정된 하네스와 선별된 인수 검사를 사용합니다. 그 어느 것도 여러분의 화요일을 설명하지 못합니다. 에이전트가 여러분의 코드에서 어떻게 동작할지를 결정하는 요소들은 공개 데이터셋이 결코 담을 수 없는 것들입니다. 모델이 한 번도 읽은 적 없는 내부 라이브러리, 여러분의 린트 설정, 서비스가 실제로 어떻게 부팅되는지 설명하는 400줄짜리 컨텍스트 파일, 테스트가 하나도 없는 그 모듈 같은 것들 말이죠.
높은 벤치마크 점수는 에이전트가 여러분의 저장소에서 어떻게 행동할지를 예측하지 않습니다. 남의 저장소에서 어떻게 행동하는지를 예측할 뿐입니다. 리더보드는 어떤 에이전트를 테스트해볼 가치가 있는지 걸러내는 대략적인 필터로만 활용하고, 그다음에는 진짜 중요한 테스트를 하세요. 각 에이전트에 어떤 모델을 붙일지 아직 고민 중이라면, 원점수보다는 어떤 모델을 어떤 코딩 작업에 매칭할지를 먼저 물어보는 편이 낫습니다.
장난감 프롬프트가 아닌 실제 태스크 하나를 골라라
가장 작고 유용한 비교부터 시작하세요. "할 일 앱 만들어줘" 같은 걸로 에이전트를 벤치마킹하지 마세요. 백로그에서 실제 요구사항 하나를 고르세요. 범위가 좁은 버그, 단일 모듈에 대한 작은 기능, 어차피 할 예정이었던 마이그레이션 같은 것 말입니다. 돌려볼 수 있는 인수 테스트가 있고, diff를 몇 분 안에 읽을 수 있는 것이어야 합니다.
그다음 모든 에이전트에게 동일한 입력을 주세요. 같은 태스크 설명, 같은 시작 커밋, 같은 인수 기준입니다. 이슈 트래커에 적듯이 SH-312: 인보이스 내보내기의 타임존 드리프트 수정처럼 써두세요. 한 에이전트에게 다른 에이전트보다 풍부한 프롬프트를 주면, 여러분은 에이전트가 아니라 프롬프트를 측정하는 셈입니다.
에이전트가 기존 코드를 어떻게 읽고 선을 지키는지 보고 싶으면 버그 수정을 쓰세요. 새로운 코드를 어떻게 구성하고 자체적으로 테스트를 작성하는지 보고 싶으면 작은 기능을 쓰세요. 시간을 두고 둘 다 돌려보세요. 태스크 하나로는 태스크 하나에 대한 정보만 얻습니다.
모든 에이전트를 최상의 상태로 비교하고, 최악의 상태로는 절대 비교하지 마라
각 에이전트에는 가장 강력한 작업을 수행하는 환경이 있습니다. 알맞은 모델, 알맞은 컨텍스트 파일, 실제로 필요한 권한입니다. Claude Code에는 CLAUDE.md를, Codex에는 해당 설정을, 각 Runtime에는 문서가 권장하는 환경을 제공하세요. 잘 설정된 에이전트와 설정이 전혀 없는 에이전트를 비교하는 건, 어느 쪽을 굳이 세팅했는지 외에는 아무것도 알려주지 않습니다.
각 에이전트를 최상의 상태로 나란히 돌리는 순간, 터미널 방식은 무너집니다. Sharkly에서는 동일한 Task를 각 Agent에 할당하면, 각 Agent가 격리된 워크트리에서 연결된 컴퓨터 위에서 실행되므로, 같은 저장소를 편집하는 세 에이전트가 서로의 파일을 건드리지 않습니다. 하나의 공유 워킹 트리와 손으로 풀어야 하는 병합 대신, 같은 문제에 대한 깔끔한 세 번의 시도를 얻는 셈이죠. 이걸 수동으로 해오고 있었다면, 여러 에이전트를 동시에 실행하는 일이야말로 Sharkly가 여러분의 어깨에서 덜어내도록 설계된 부분입니다.
에이전트를 하나만 쓰고 터미널에서 산다면, 워크트리 안에서 잘 튜닝된 Claude Code 세션 하나로 충분하며 이런 게 전혀 필요 없을 수도 있습니다. 하지만 두 개 이상의 에이전트를, 하나 이상의 태스크에 걸쳐 비교하고, 그 결과를 실제로 나란히 읽을 수 있는 형태로 원하는 순간 방정식은 달라집니다.
실제 작업에서 판가름하는 다섯 가지 기준
벤치마크는 숫자 하나를 채점합니다. 태스크를 통과했는지 여부죠. 실제 작업은 그 숫자가 놓치는 다섯 가지로 결정됩니다.
| 기준 | 답하는 질문 |
|---|---|
| 병렬 실행 | 같은 태스크에 대해 여러 에이전트를 격리된 상태에서 동시에, 충돌 없이 돌릴 수 있는가? |
| 팀 가시성 | 나 외의 다른 사람이 각 에이전트가 무엇을, 왜 했는지 볼 수 있는가? |
| 리뷰 흐름 | diff, 테스트, 알려진 한계를 얼마나 빨리 읽고 수락 또는 거부할 수 있는가? |
| 자체 머신 실행 | 에이전트가 내 실제 환경과 시크릿에 맞서 내 컴퓨터에서 실행되는가? |
| 통합 | 결과가 우리가 이미 쓰는 트래커, 저장소, 리뷰 도구로 들어오는가? |
앞의 네 가지야말로 대부분의 에이전트가 벤치마크에서는 똑같아 보이지만 여러분의 코드에서는 전혀 다르게 행동하는 지점입니다. 특히 자체 머신 실행은 공개 테스트에서 보이지 않습니다. 실제 툴체인, 로컬 데이터베이스, 실제 CI 훅에 맞서 실행되는 에이전트는 그것과 비슷하게 흉내 낸 샌드박스가 아니라, 여러분이 출시하는 것 위에서 테스트되는 것입니다.
에이전트는 조사하고, 실행하고, 테스트하고, 보고합니다. 여러분은 방향을 정하고, 권한을 부여하고, 결과를 수락합니다. 그 모든 과정을, 모든 에이전트에 대해, 스크롤백에서 재구성할 필요 없이 볼 수 있어야만 비교가 정직해집니다.
에이전트가 주장하는 것이 아니라 돌아오는 것을 채점하라
"완료"를 출력하는 에이전트는 통과한 변경과 같지 않습니다. 각 실행을 자기 주장이 아니라 돌아온 결과로 채점하세요. 모든 시도에서 유용한 증거는 늘 같은 짧은 목록입니다. diff, 타입체크 및 테스트 결과, 변경 요약, 그리고 에이전트가 인정한 한계입니다. Sharkly는 컨텍스트, 진행 상황, 블로커, 결과, 사람의 리뷰를 요청부터 릴리스까지 가시적으로 유지하므로, 비교가 기억해야 할 터미널 다섯 개가 아니라 결과 표처럼 읽힙니다.
이 지점에서 진짜 병목이 드러나기도 합니다. 두 에이전트가 20분 만에 태스크를 "끝냈다"고 해도, 각각 리뷰하는 데 한 시간이 걸릴 수 있습니다. 에이전트 출력을 리뷰하는 일은 흔히 팀이 흡수할 수 있는 병렬 작업량의 진짜 한계이며, 어떤 에이전트를 고르느냐에 크게 반영되어야 합니다. 무엇에 비중을 둘지는 누가 고르느냐에 달려 있습니다.
| 고르는 주체 | 가장 크게 볼 것 |
|---|---|
| 1인 개발자 | 리뷰 흐름과 자체 머신 실행, 리뷰어가 본인뿐이므로 |
| 소규모 팀 | 병렬 실행과 팀 가시성, 여러 사람이 같은 실행을 봐야 하므로 |
| 플랫폼 팀 | 통합과 가시성, 워크플로가 다음 최고 에이전트까지 버텨야 하므로 |
마지막 행이야말로 애초에 비교하는 이유입니다. 오늘의 최고 에이전트가 다음 분기의 최고 에이전트일지는 모릅니다. 리더가 바뀔 때마다 워크플로를 다시 짓는 건 그 자체로 세금입니다. Sharkly는 코딩 에이전트도, 벤치마크 하네스도 아닙니다. 매번 프로세스를 다시 짜지 않고도 여러분의 코드에 맞서 에이전트를 계속 테스트할 수 있게 해주는 계층입니다.
하나의 생태계에 정착하기보다 여러 코딩 에이전트를 계속 쓰고 싶다면, 바로 그것이 Sharkly가 겨냥해 설계된 문제입니다. Sharkly를 다운로드하고 컴퓨터 하나를 연결한 뒤, 동일한 실제 태스크를 두 에이전트에 할당해보세요. 그렇게 돌아오는 비교는 여러분의 코드베이스에 관한 것이며, 그것만이 여러분의 한 주를 예측해줍니다.


