
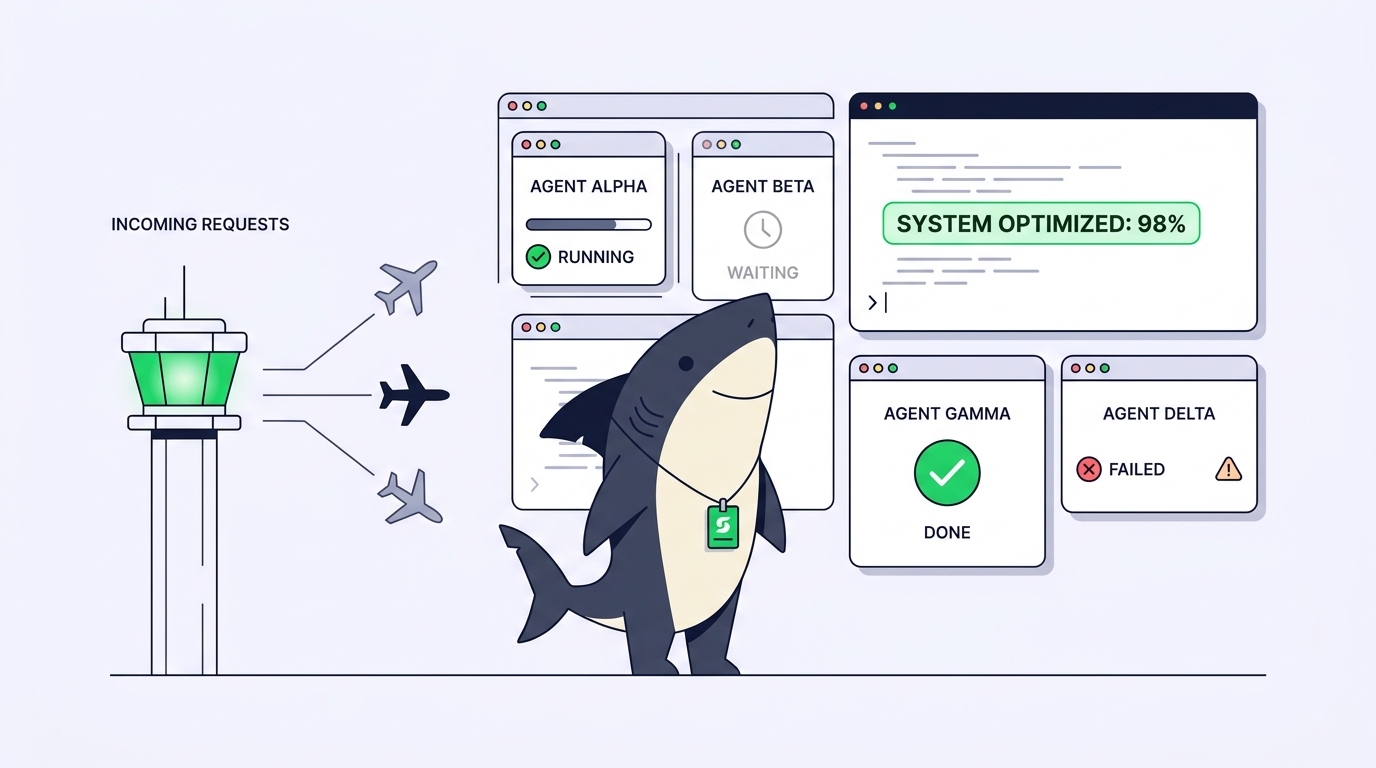
오늘 아침 세 개의 코딩 에이전트를 실행했다고 해봅시다. 하나는 인증 모듈을 리팩터링하고 있고, 다른 하나는 테스트 코드를 작성 중이며, 나머지 하나는 간헐적으로 실패하는 CI 작업을 추적하고 있습니다. 한 시간 뒤, 화면에는 터미널 창 5개와 분리된(detached) tmux 창 2개가 열려 있고, 한눈을 판 사이 최소한 하나는 진작 멈춰서 놀고 있을 것 같다는 찜찜한 기분이 듭니다. 결국 Alt-Tab을 연타하며 로그를 스크롤하고, 상황을 짐작해 볼 뿐입니다.
이러한 '짐작'이야말로 에이전트를 병렬로 실행할 때 발생하는 진짜 비용입니다. 이제 여러 코딩 에이전트를 동시에 띄우는 일 자체는 간단합니다. 문제는 어떤 에이전트에 내 개입이 필요한지, 어떤 것이 막혀 있는지, 어떤 것이 조용히 작업을 마쳤는지 파악하느라 오후 시간을 통째로 날리게 된다는 점입니다. 병렬 코딩 에이전트를 모니터링한다는 것은 창을 다섯 개씩 열어보지 않고도 네 가지 핵심 질문에 즉각 답할 수 있음을 의미합니다. 각 에이전트가 지금 무엇을 하고 있는가, 얼마나 진행되었는가, 무엇 때문에 막혀 있는가, 그리고 검토가 필요한 결과물로 무엇이 반환되었는가?
이 가이드에서는 먼저 직접 구축하는 DIY 모니터링 방식을 살펴보고 각 단계에서 나타나는 실패 유형(failure mode)을 짚어봅니다. 이어서 해당 방식이 한계에 부딪히는 지점과 공유 작업 레이어(shared task layer)가 어떤 가치를 더해주는지 설명합니다. 그 공유 레이어가 바로 Sharkly입니다. 이미 사용 중인 코딩 에이전트들이 여러 터미널에 흩어져 있는 대신, Sharkly는 모든 에이전트의 진행 상황, 차단 요소(blocker), 결과물을 한곳에서 볼 수 있도록 해 이들을 하나의 팀으로 만들어 줍니다. 모니터링 체계는 대부분 직접 구축할 수도 있습니다. 두 가지 방식을 모두 살펴보는 이유는 직접 구축한 방식이 아껴주는 비용보다 초래하는 비용이 더 커지는 시점을 정확히 알기 위해서입니다.
반드시 주시해야 할 4가지 신호
모니터링은 단일한 작업이 아닙니다. 흔히 에이전트가 "잘 돌아가고 있다"고 말할 때는 대개 네 가지 개별 신호 중 하나를 의미하며, 각 신호마다 실패하는 양상이 다릅니다.
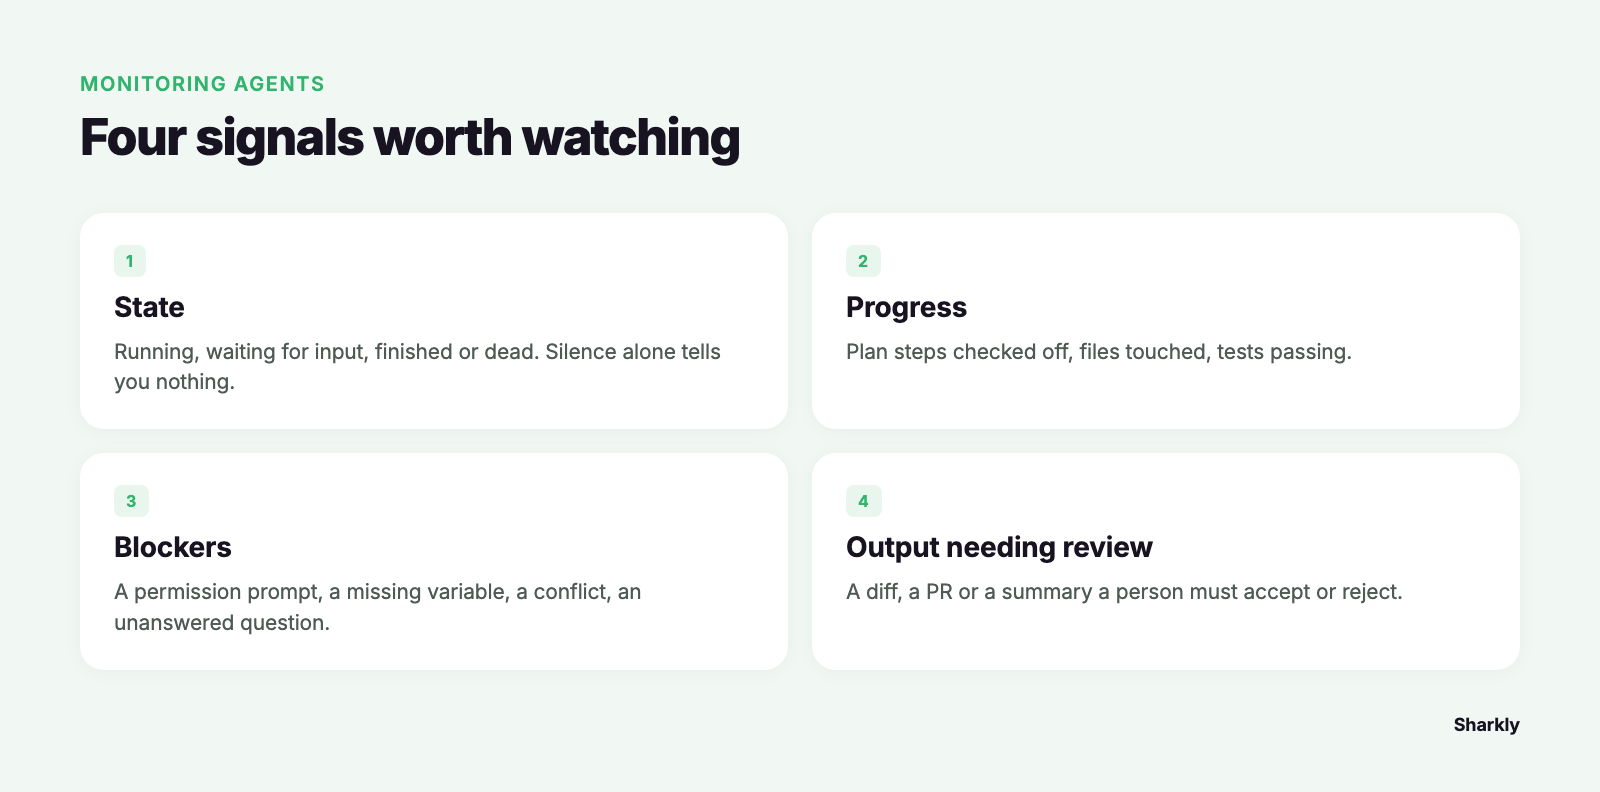
- 상태(State). 프로세스가 실행 중인지, 입력을 기다리는 중인지, 완료되었는지, 아니면 비정상 종료(dead)되었는가? 완료된 에이전트와 멈춰버린(hung) 에이전트는 둘 다 새로운 출력을 내보내지 않으므로, 침묵 그 자체로는 아무것도 알 수 없습니다.
- 진행도(Progress). 작업이 얼마나 완료되었는가? 계획 중 체크된 항목, 수정된 파일, 통과한 테스트 등이 해당합니다. 진행도를 확인해야 실행 중인 에이전트가 무한 루프에 빠지지 않고 실제로 작업을 진척시키고 있는지 알 수 있습니다.
- 차단 요소(Blockers). 에이전트가 무엇을 기다리고 있는가? 권한 승인 프롬프트, 누락된 환경 변수, 머지 충돌, 혹은 에이전트가 질문을 던졌는데 아무도 답하지 않은 상태 등이 있습니다.
- 검토가 필요한 결과물(Output needing review). 사람이 승인하거나 반려해야 할 결과물로 에이전트가 무엇을 만들어냈는가? diff, PR, 변경 사항 요약 등이 여기에 해당합니다.
상태만 본다면 실행 중이지만 재시도 루프에 갇힌 에이전트를 놓치게 됩니다. 진행도만 본다면 20분 전에 이미 끝난 에이전트를 놓치게 됩니다. 제대로 된 모니터링 환경이라면 모든 에이전트에 대해 이 네 가지 신호를 한눈에 보여줄 수 있어야 합니다.
1단계: DIY 방식으로 모니터링하기, 그리고 각 단계에서 발생하는 구멍들
직접 구축하는 방식은 이미 보유하고 있는 도구를 활용합니다. 각 단계가 어떤 빈틈을 남기는지 솔직하게 짚어보겠습니다.
실행 중인 항목 확인하기. 각 에이전트가 독립된 git worktree에서 실행 중이라면, 워크트리와 브랜치 목록을 확인합니다.
git worktree list
tmux ls   # if each agent runs in a tmux session
실패 유형: 세션이 존재한다는 사실만 알려줄 뿐, 그 안의 에이전트가 작업 중인지 대기 중인지는 알 수 없습니다. Continue? (y/n) 프롬프트에서 멈춰 있는 tmux 창이나 한창 작업 중인 창이나 겉보기에는 똑같습니다. 직접 세션에 연결(attach)해 보아야만 알 수 있습니다.
진행도 확인하기. 각 에이전트의 출력을 tail로 확인하고 워크트리의 변경 사항을 주기적으로 폴링(polling)합니다.
tail -f /path/to/agent-1.log
watch -n 5 'git -C ../wt-auth status --short'
실패 유형: 에이전트 수가 늘어남에 따라 확인해야 할 작업도 정비례해서 늘어납니다. 로그가 3개일 때는 읽을 만하지만, 서로 뒤섞이는 로그 tail이 6개가 되면 감당하기 어렵습니다. 또한 watch 루프는 단순한 파일 변경 내역만 보여줄 뿐 그 의미를 알려주지 않습니다. 파일이 바뀌고 있다는 것은 보여도, 그 변경이 올바른지 아니면 에이전트가 헛돌고 있는지는 전혀 알 수 없습니다.
완료 감지하기. 프로세스가 종료될 때 알림(ping)을 보내도록 각 에이전트를 래핑합니다.
your-agent-command "$TASK"; \
  curl -s -X POST "$WEBHOOK_URL" -d "agent-1 exited $?"
실패 유형: 종료 코드 0은 프로세스가 끝났음을 의미할 뿐, 작업이 제대로 되었거나 완료되었다는 뜻이 아닙니다. 많은 에이전트가 사용자가 보지도 못한 질문을 던진 채 정상 종료되기도 합니다. 이러한 "완료" 알림은 실제로는 완료되지 않은 신호를 완료된 것으로 믿게 만드는 잘못된 학습을 유도합니다.
충돌 감지하기. 여러 에이전트가 하나의 레포지토리를 공유할 때, 워크트리를 쓰면 작업 디렉터리는 분리되지만 서로 다른 두 브랜치에서 두 에이전트가 같은 파일을 수정하면 결국 머지 시점에 충돌이 발생합니다.
git worktree list --porcelain | grep branch
실패 유형: 머지를 시도하는 순간에야 겹치는 부분이 있다는 사실을 알게 되며, 이는 충돌을 발견하기에 가장 비용이 많이 드는 시점입니다.
이 방식들이 잘못되었다는 것은 아닙니다. 서로 관련 없는 작업을 수행하는 2~3개의 에이전트라면 몇 개의 tmux 창과 watch 루프만으로도 충분히 합리적인 모니터링이 가능하며, 굳이 더 무거운 도구를 도입할 필요는 없습니다. 한계에 부딪히기 전까지는 부가적인 요소를 최소화하는 것이 좋습니다.
DIY 모니터링이 한계에 부딪히는 지점
그 한계는 한 화면에 다 담을 수 없을 만큼 많은 에이전트를 실행하는 시점에 찾아옵니다. 이때 세 가지 문제가 복합적으로 작용합니다.
폴링은 원인이 아닌 상태만 알려줍니다. git status와 로그 tail은 무언가 바뀌었거나 출력이 멈췄다는 사실만 보여줍니다. 에이전트가 프롬프트 대기 중인지, 의존성이 없어서 막힌 것인지, 아니면 작업이 끝난 것인지 원인을 구분해주지 못합니다. 결국 원인을 진단하기 위해 세션에 일일이 접속(attach)해야 하는데, 이는 병렬 작업을 통해 없애려 했던 '터미널 전환의 피로'를 고스란히 다시 불러옵니다.
공유 상태가 없습니다. 모니터링 정보는 내 노트북, tmux 서버, 쉘 히스토리에만 갇혀 있습니다. 팀원은 어떤 에이전트가 어떤 작업을 맡고 있는지 알 수 없으며, 나 역시 노트북 덮개를 닫고 나면 확인할 길이 없습니다. 에이전트가 원격 머신에서 실행되는 경우, 로컬 tail 방식은 아예 무용지물이 됩니다.
검토가 병목이 됩니다. 사람들이 가장 간과하기 쉬운 문제입니다. 에이전트를 아무리 병렬로 돌려도 그 결과물을 검토하는 과정이 다시 1인 대기열로 직렬화된다면 아무 의미가 없습니다. '검토 완료 / 수정 요청 / 머지됨' 상태를 추적할 공유 공간 없이 완료된 diff가 5개 쌓이면, 결국 브라우저 탭 5개와 머릿속 기억에만 의존해야 합니다. 에이전트는 빨라졌지만, 사람은 더 느려진 셈입니다.
이 시점에서 부족한 것은 더 많은 터미널이 아닙니다. 바로 '공유된 기록'입니다.
작업 보드가 더해주는 가치: 결과가 한곳으로 모입니다
작업 레이어(task layer)를 도입하면 모니터링의 단위가 '터미널 창의 프로세스'에서 '상태를 가진 작업(Task)'으로 바뀝니다. 이것이 바로 Sharkly가 설계된 핵심 패러다임이며, 앞서 언급한 4가지 신호와 직결됩니다.
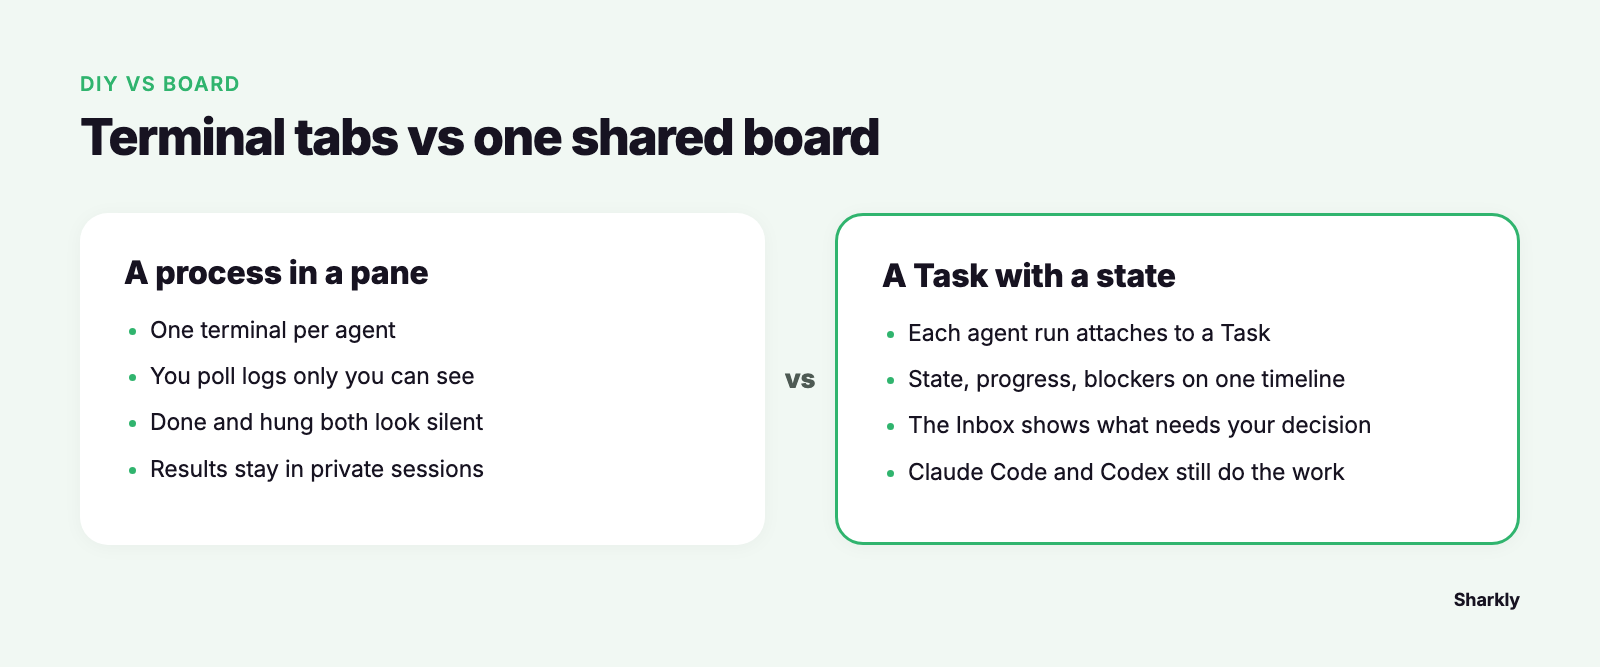
각 에이전트의 실행은 하나의 작업(Task)에 연결됩니다. 상태, 진행도, 차단 요소, 결과물은 나만 볼 수 있는 로그에 머무르지 않고 모두 해당 작업의 타임라인으로 수집됩니다. 이제 폴링하는 대신 보드를 봅니다. 어떤 작업이 진행 중인지, 무엇이 막혀 있는지, 어떤 작업이 완료되어 내 확인을 기다리고 있는지 한눈에 확인할 수 있습니다. Sharkly의 수신함(Inbox)은 사람의 개입이 필요한 실행 건들을 띄워주므로, "끝난 작업이 있나?" 하고 찾아 헤맬 필요 없이 "내 판단이 필요한 항목이 여기 모여 있다"로 바뀝니다. 에이전트는 조사, 실행, 테스트, 보고를 담당하고, 사람은 방향 설정, 권한 승인, 결과 수용을 담당합니다. 판단이 필요한 지점에서 자동화는 멈추고 사람에게 바통을 넘깁니다.
여기서 경계를 명확히 하는 것이 중요합니다. 오해하기 쉽지만, Sharkly는 직접 에이전트를 실행하거나 코드를 작성하지 않습니다. 실제 실행은 여러분이 이미 사용 중인 Claude Code, Codex 및 기타 런타임이 계속 담당합니다. Sharkly는 그 주변에 공유 작업, 컴퓨터, 컨텍스트, 검토 레이어를 더해줄 뿐이며, 덕분에 요청부터 릴리스까지 실행 진행 상황과 diff를 팀 전체가 볼 수 있는 공간에 기록할 수 있습니다. 또한 각 실행을 독립된 격리된 워크트리에 유지하므로, 머지 시점에야 발견했을 동일 파일 충돌 문제를 작업 단위로 미리 제어할 수 있습니다.
솔직한 판단 기준을 제시하자면 이렇습니다. 서로 관련 없는 작업에 에이전트를 한두 개 정도만 띄우고 다른 사람에게 인계할 일도 없다면, DIY 모니터링으로도 충분하며 Sharkly는 오히려 과할 수 있습니다. 하지만 에이전트 수가 화면을 넘어서거나, 내가 직접 앉아 있지 않은 머신에서 작업이 실행되거나, 다른 팀원들과 같은 보드를 공유해야 할 때는 계산이 달라집니다. 특정 생태계 하나에 종속되지 않고 여러 코딩 에이전트를 계속해서 병용하고 싶다면, 바로 그 공유 뷰를 제공하는 것이 Sharkly가 해결하고자 설계된 핵심 문제입니다. 대시보드에 실제로 어떤 내용이 들어가야 하는지에 대한 전반적인 내용은 AI 코딩 에이전트 대시보드에 실제로 표시되어야 하는 것을 참고하세요.
지금 바로 점검해 볼 수 있는 모니터링 체크리스트
직접 구축한 방식을 유지하든 공유 레이어로 전환하든, 병렬 에이전트 모니터링 환경이라면 세션에 일일이 접속하지 않고도 다음 질문들에 답할 수 있어야 합니다.
- 모든 에이전트가 명명된 작업에 매핑되는가. 이름 모를 "agent-3" 같은 것은 없어야 합니다. 각 에이전트가 무엇을 위한 것인지 즉시 말할 수 있어야 합니다.
- 상태를 한눈에 파악할 수 있는가. 실행 중, 입력 대기, 완료, 실패 상태가 침묵을 통해 추측하는 것이 아니라 명확히 구분되어 보여야 합니다.
- 막힌 에이전트가 직접 손을 드는가.
y/n입력을 기다리는 프롬프트, 누락된 비밀 키(secret), 답변 없는 질문 등이 조용히 멈춰 있는 대신 사용자에게 즉각 노출되어야 합니다. - 단순 프로세스 종료가 아닌 '검토 가능'을 완료로 정의하는가. 완료된 실행은 단순한 종료 코드가 아니라 diff나 PR을 가리키고 있어야 합니다.
- 검토 단계 자체의 상태를 추적할 수 있는가. '검토 완료', '수정 요청', '머지됨' 등의 상태가 관리되어 병렬 작업이 다시 하나씩 처리하는 검토 대기열로 밀리지 않아야 합니다.
- 노트북을 닫아도 상태가 유지되고 공유 가능한가. 상태 정보가 단순한 쉘 히스토리가 아닌 다른 어딘가에 온전히 저장되어 있어야 합니다.
- 동일 레포지토리 내 작업이 격리되어 있는가. 각 에이전트가 고유한 워크트리를 가지며, 파일 중복 수정이 머지 도중이 아니라 머지 전에 미리 드러나야 합니다.
현재 구축된 환경을 이 목록과 대조해 보세요. 오늘 체크하지 못한 항목들이 나중에 여러분의 오후 시간을 고스란히 앗아갈 항목들입니다. 이미 여러 에이전트를 운영 중이라면, Sharkly를 통해 에이전트들의 작업과 결과물을 한곳에서 관리할 수 있습니다. 또한 기존에 사용하던 런타임을 그대로 유지하면서 기존 코딩 에이전트를 Sharkly를 통해 실행할 수도 있습니다.


