
파일 아홉 개에 걸쳐 340줄이 바뀐 풀 리퀘스트가 검토 대기열에 들어옵니다. 코딩 에이전트가 작성한 것입니다. 하지만 diff는 에이전트가 무엇을 요청받았는지, 어떤 접근 방식을 시도했다가 포기했는지, 변경이 제대로 동작한다고 스스로를 납득시키기 위해 무엇을 실행했는지, 어디에서 대충 넘어갔다는 걸 알고 있는지를 알려주지 않습니다. 그래서 여러분은 둘 중 하나를 하게 됩니다. 대충 훑고 승인하거나, 변경 전체를 처음부터 다시 검증하거나. 전자는 나쁜 코드가 배포되는 방식이고, 후자는 에이전트가 아무것도 아껴주지 못했다는 뜻입니다.
AI가 생성한 코드를 제대로 리뷰하는 일은 동료의 PR을 리뷰하는 것과는 다른 작업입니다. 작성자가 옆에 앉아 자신의 추론 과정을 설명해 줄 수 없기 때문입니다. 해결책은 diff와 그 근거를 함께 리뷰하는 것입니다. 목표, 실행된 검사, 그리고 에이전트가 이미 표시해 둔 한계까지 말입니다. Sharkly는 바로 이 지점을 중심으로 만들어졌습니다. Sharkly는 여러분의 코딩 에이전트(Claude Code, Codex, Gemini 등) 위에 자리하며, 목표와 변경, 검증 결과, 그리고 모든 실행에 대한 사람의 리뷰를 터미널과 PR 설명에 흩어 놓지 않고 하나의 Task에 담아 둡니다.
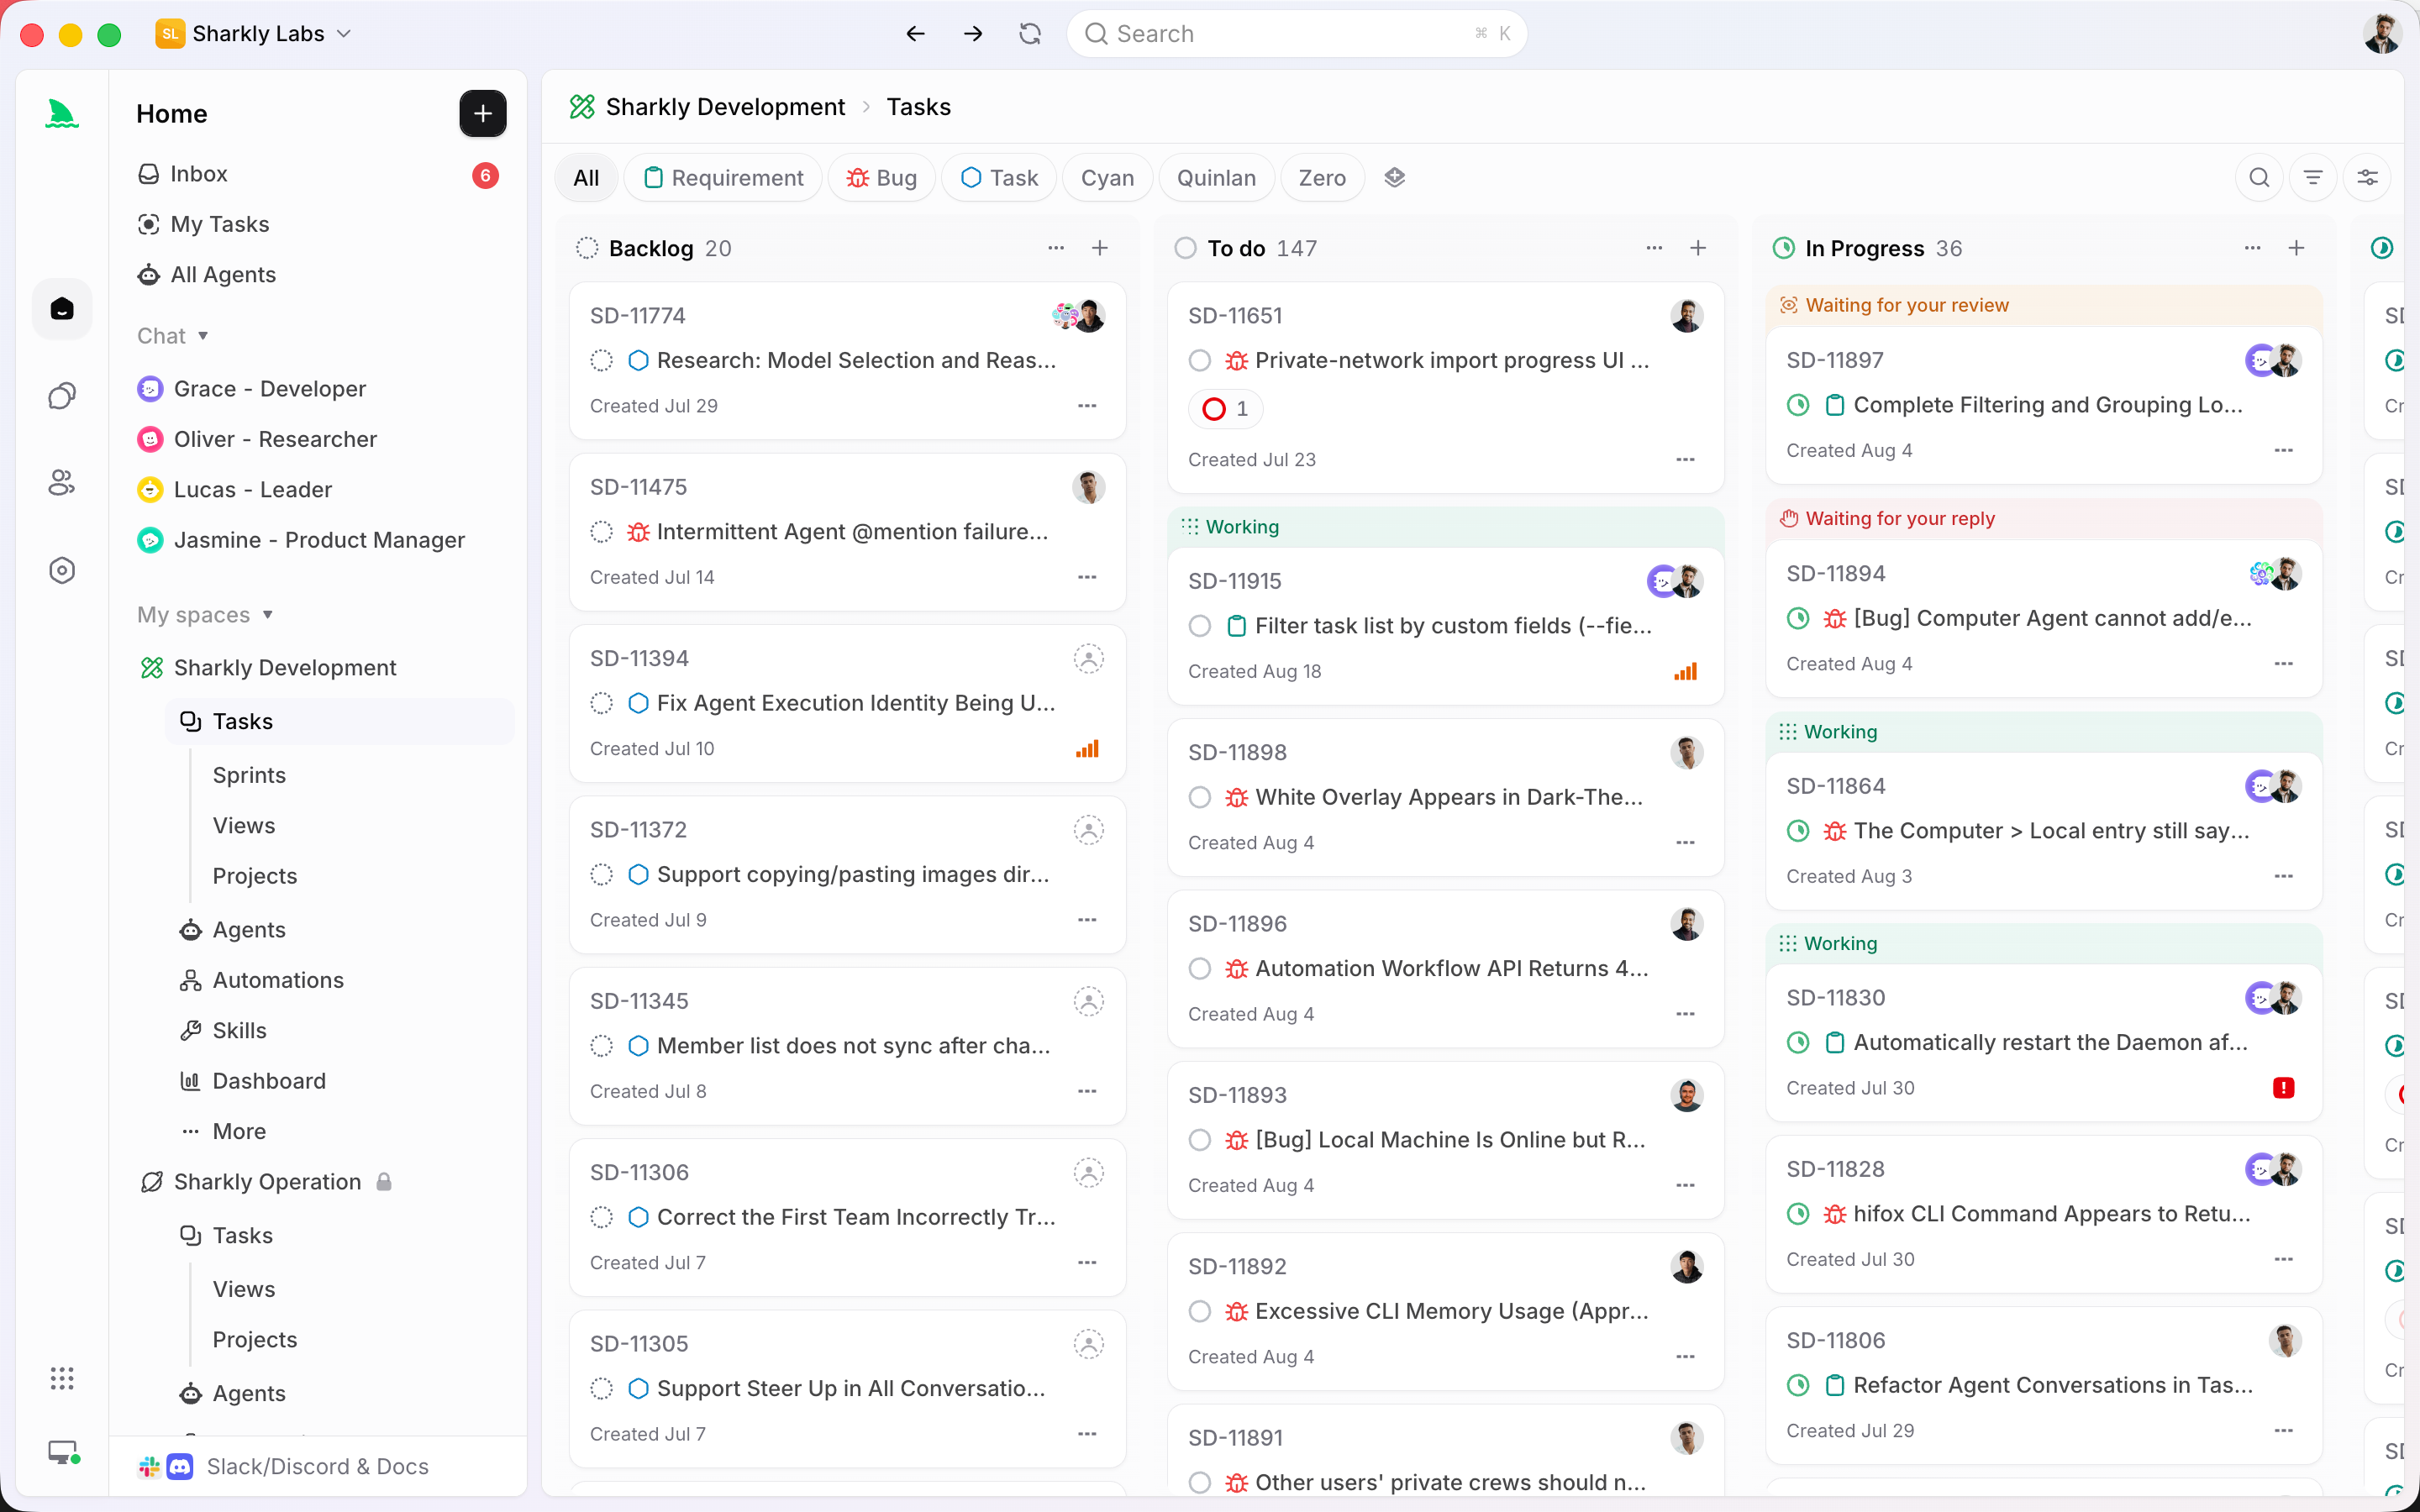
이 가이드에서는 그 뒤에 있는 운영 모델을 살펴봅니다. 누가 작업을 할당하고, 누가 실행하고, 누가 리뷰하고, 누가 수용하는지, 에이전트의 일과 사람의 일을 구분하는 상태와 게이트, 그리고 티켓에서 머지된 PR까지 이어지는 실제 예시 하나를 다룹니다.
빠른 답변
AI가 생성한 코드는 diff 수준이 아니라 Task 수준에서 리뷰하세요. Agent가 변경 요약, 실행한 typecheck/test/build 결과, 그리고 알려진 한계를 공유된 Task에 첨부하게 한 뒤, 그 Task를 리뷰 상태로 옮기세요. 사람이 diff와 함께 근거를 읽고, 변경을 요청하거나 수용하고, 머지 여부를 결정합니다. Agent는 만들고 검증하며, 사람은 수용합니다.
diff만 보고 리뷰하면 실패하는 이유
코드를 읽는 일은 쓰는 일보다 어렵습니다. 코드 리뷰에서 잘 알려진 현실은 리뷰어가 작성자보다 맥락을 덜 쥐고 있다는 것이고, 작성자가 에이전트라면 그 격차는 완전합니다. GitHub diff는 목적지만 보여줄 뿐 경로는 결코 보여주지 않습니다. 에이전트가 캐싱 계층을 먼저 시도했다가 경쟁 상태(race condition)에 부딪혀 되돌렸다는 사실은 보이지 않습니다. 테스트 스위트를 돌렸는데 변경과 무관한 불안정한(flaky) 테스트 하나가 실패했다는 사실도 보이지 않습니다.
이런 맥락이 없으면 리뷰는 두 가지 실패 모드로 무너집니다. 도장 찍기식 승인은 그럴듯해 보이지만 에이전트가 미처 고려하지 못한 엣지 케이스를 조용히 깨뜨리는 코드를 통과시킵니다. 전면 재검증은 추론을 직접 다시 구성하게 만들고, 그 시점에 에이전트의 속도 이점은 사라집니다. 에이전트 세 개가 동시에 PR을 열면 어느 쪽도 확장되지 않습니다. 탈출구는 에이전트의 결과물만이 아니라 에이전트의 작업 자체를 리뷰 가능하게 만드는 것입니다.
Task 수준 근거란 실제로 무엇을 뜻하는가
Task 수준 근거는 Agent가 자신의 Task에 첨부하는 기록입니다. 어떤 목표를 가지고 작업했는지, 어떤 변경을 만들어냈는지, 어떤 검사를 실행했는지, 그리고 어떤 한계를 알고 있는지가 담깁니다. 빈약한 diff 하나 대신, 출처가 따라붙는 diff를 받게 되는 것입니다.
실제로 근거 묶음은 네 가지로 이루어집니다.
- 목표와 인수 기준: Task 설명에 담겨 있어, 리뷰가 "그럴듯해 보이는가"가 아니라 "무엇을 요청했는가"를 기준으로 평가됩니다.
- 변경 요약: 에이전트가 직접 쓴 표현으로, 무엇을 왜 건드렸는지 정리한 것입니다.
- 검증 결과: 에이전트가 작업을 넘기기 전에 실행한 typecheck, 테스트, 빌드의 출력입니다.
- 알려진 한계: 에이전트가 숨기지 않고 표시해 둔 엣지 케이스, 가정, 후속 작업입니다.
이 모든 것이 Task로 돌아옵니다. 실행, 블로커, 결과, 후속 논의가 하나의 타임라인에 남기 때문에, 리뷰어는 PR과 Slack 스레드, 어렴풋이 기억나는 프롬프트를 짜맞출 필요 없이 하나의 기록만 열면 됩니다. 이것이 요구사항에서 코드까지 추적 가능한 워크플로를 뒷받침하는 원칙입니다. 근거는 결과물의 일부입니다.
운영 모델: 누가 할당하고, 누가 실행하고, 누가 리뷰하고, 누가 수용하는가
좋은 리뷰는 명확한 역할에 달려 있습니다. 계약은 짧습니다. Agent는 조사하고, 실행하고, 테스트하고, 보고합니다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 수용합니다. 자동화는 팀의 판단이 필요한 지점에서 멈춥니다.
| 역할 | 담당 | 업무 |
|---|---|---|
| 할당자(Assigner) | 사람(보통 Task Owner) | 필요를 설명하고, 인수 기준을 정하고, Task를 할당 |
| 실행자(Runner) | 연결된 Computer에서 Runtime을 통해 동작하는 Agent | Task를 가져가 격리된 worktree에서 실행하고, 근거를 첨부 |
| 리뷰어(Reviewer) | 사람 | 근거와 대조하며 diff를 읽고, 변경을 요청하거나 승인 |
| 수용자(Accepter) | 사람(Owner 또는 지정된 승인자) | 최종 수용과 머지/릴리스 결정을 내림 |
Sharkly는 Claude Code나 Codex, 그 밖의 실행 도구를 대체하는 것이 아닙니다. 팀이 이미 쓰고 있는 도구 주위에 공유 Task와 Computer, 컨텍스트, 리뷰 계층을 더해 줍니다. 코드는 런타임이 작성하고, Sharkly는 리뷰가 누구의 대기열로 들어갈지, 사람이 보기 전에 어떤 근거가 갖춰져 있어야 하는지를 정합니다. 할당 측면을 더 깊이 알고 싶다면 누가 에이전트 작업을 할당하고 누가 수용하는가를 참고하세요.
상태와 리뷰 게이트: Agent는 Ready for review까지, 사람은 Done까지
리뷰 게이트는 상태 경계입니다. Sharkly에서 모든 task 상태는 시스템적 의미를 지닌 고정 카테고리에 속합니다. Backlog(보류), Unstarted(준비됨, 미시작), Started(진행 중), Completed(종료)입니다. 여러 표시 상태가 같은 카테고리를 공유할 수 있으므로, 특정 task 유형의 워크플로는 무언가가 Completed에 도달하기 전에 Development와 Ready for review를 두 개의 서로 다른 Started 상태로 운영할 수 있습니다.
이 구조가 게이트를 실제로 작동하게 만듭니다. Agent는 Task를 Development에서 Ready for review로 옮길 수 있고, 사람의 리뷰를 기다리는 상태로 남겨둘 수도 있습니다. 하지만 스스로 Task를 Completed 상태로 옮길 수는 없습니다. 수용은 설계상 사람이 수행하는 전환입니다.
| 상태 | 카테고리 | 이 상태로 옮기는 주체 |
|---|---|---|
| Backlog | Backlog | 사람, 작업을 보류할 때 |
| Todo | Unstarted | 사람, Task가 준비되었을 때 |
| Development | Started | Agent, Task를 가져가 작업할 때 |
| Ready for review | Started | Agent, 근거를 첨부했을 때 |
| Done | Completed | 사람, 수용한 뒤 |
Completed 상태로 넘어가는 전환에 사람이 필요하도록 워크플로를 구성하면, 에이전트가 여러분이 지켜볼 수 있는 속도보다 빠르게 결과를 쏟아내도 흔들리지 않는 리뷰 게이트를 갖게 됩니다. 이것은 코딩 에이전트에 human in the loop을 유지하는 방식의 기계적인 구현이며, 에이전트가 머지하기 전에 어디에서 멈추게 할지 결정하는 지점이기도 합니다.
실제 예시: 티켓에서 머지된 PR까지
SH-312를 예로 들어 보겠습니다. "공개 검색 엔드포인트에 속도 제한을 추가하고, API 키당 분당 60회로 제한한다."
- 사람이 그 목표와 두 가지 인수 기준을 담아 SH-312를 등록합니다. 한도를 초과한 요청은 HTTP 429를 반환하고, 한도는 IP가 아니라 키 기준으로 적용됩니다. Task는 Todo에서 시작합니다.
- Agent가 이를 가져가 Development로 옮기고, 격리된 worktree에서 실행하므로 체크아웃이 같은 저장소에서 작업하는 다른 Agent와 충돌하지 않습니다. (worktree 덕분에 병렬 실행이 깔끔하게 유지됩니다. Task당 하나의 체크아웃을 참고하세요.)
- Agent는 토큰 버킷(token-bucket) 방식의 리미터를 구현하고 PR을 연 뒤, SH-312에 근거를 첨부합니다. 변경 요약, 통과한 typecheck와 단위 테스트, 빌드 결과, 그리고 한 가지 알려진 한계입니다. "버킷이 프로세스 메모리에 있으므로 배포할 때마다 한도가 초기화되고 인스턴스 간에 공유되지 않습니다."
- Agent가 SH-312를 Ready for review로 옮깁니다. diff와 근거가 함께 사람의 대기열에 들어옵니다.
- 리뷰어는 알려진 한계 메모를 먼저 읽고, 인메모리 버킷으로 당장은 충분하다고 판단한 뒤 한 가지 변경을 요청합니다. 429 응답에
Retry-After헤더를 반환하도록요. Agent가 변경을 적용하고 갱신된 테스트 출력을 다시 첨부합니다. - 리뷰어가 수용하고 PR을 머지한 뒤 SH-312를 Done으로 옮깁니다. 공유 리미터를 위한 후속 티켓은 이미 연결되어 있습니다.
리뷰는 몇 분 만에 끝났습니다. 리뷰어가 변경을 다시 구성할 필요가 없었기 때문입니다. 그 일은 근거가 해냈습니다. 이슈에서 리뷰까지 이어지는 Claude Code 프로젝트 관리와 같은 루프이며, 근거 묶음이 리뷰를 병목이 아니라 빠른 과정으로 만들어 줍니다.
근거를 빠르게 리뷰하는 방법과 가볍게 봐도 되는 경우
모든 변경에 같은 수준의 검토가 필요한 것은 아닙니다. 판단 기준을 두세요.
변경이 인증, 결제, 데이터 마이그레이션, 공개 API, 또는 되돌리기 어려운 무엇이든 건드린다면 무겁게 접근하세요. diff를 한 줄씩 읽고, 테스트를 직접 다시 실행하고, 알려진 한계 메모를 여러분이 떠올리는 엣지 케이스와 대조하세요. 변경이 문구 수정이거나 테스트가 잘 갖춰진 내부 리팩터링, 또는 검사가 모두 통과한 의존성 업데이트라면 가볍게 접근하세요. 요약을 읽고, diff를 훑고, 검증 통과를 확인한 뒤 수용하면 됩니다.
무거운 리뷰를 빠르게 끝내는 체크리스트는 다음과 같습니다.
- diff가 해피 패스만이 아니라 모든 인수 기준을 충족하는가?
- 에이전트가 실제로 검사를 실행했는가, 아니면 실행했다고 주장만 하는가? 첨부된 출력을 확인하세요.
- 알려진 한계 메모를 읽었는가? 어떤 한계가 후속 작업이 아니라 블로커인가?
- 변경이 요청 범위 안에 머물렀는가, 아니면 에이전트가 무관한 파일까지 건드렸는가?
이미 여러 코딩 에이전트를 운영하고 있다면, 이것이 Sharkly가 한곳에서 관리하게 해주는 워크플로입니다. Task를 할당하고, 에이전트가 근거를 첨부하게 하고, 게이트에서 리뷰하세요. worktree와 PR 템플릿, 상태 보드로 각 요소를 직접 만들어도 되고, Sharkly를 다운로드해 Task와 근거, 게이트를 하나의 시스템으로 갖춰도 됩니다.
FAQ
AI가 생성한 코드에서 Task 수준 근거란 무엇인가요? 에이전트가 diff와 함께 자신의 Task에 첨부하는 기록입니다. 목표, 변경 요약, 실행한 typecheck/test/build 결과, 그리고 알려진 한계가 담깁니다. 이 묶음을 리뷰하는 편이 diff만 리뷰하는 것보다 빠르고 안전합니다.
AI 에이전트가 자기 코드를 스스로 승인할 수 있나요? 아닙니다. 바로 그것이 리뷰 게이트의 존재 이유입니다. 에이전트는 Task를 Ready for review로 옮길 수 있지만, Completed 상태로의 전환은 사람의 결정입니다. Agent는 만들고 검증하며, 사람은 수용합니다.
도장 찍기식 승인 없이 AI 코드를 더 빠르게 리뷰하려면 어떻게 해야 하나요? 노력을 위험도에 맞추세요. 모든 변경의 근거는 읽되, 인증이나 마이그레이션처럼 위험도가 높은 영역에만 한 줄씩 읽기와 테스트 재실행을 남겨 두세요. 에이전트가 사람보다 빠를 때 리뷰 역량이 어떻게 확장되는지 살펴보세요.
풀 리퀘스트는 여전히 사용하나요? 그렇습니다. 에이전트는 GitHub에 실제 풀 리퀘스트를 엽니다. Task 계층은 그 주위에 근거와 게이트를 더해, PR이 컨텍스트가 존재하는 유일한 장소가 되지 않도록 합니다.


