
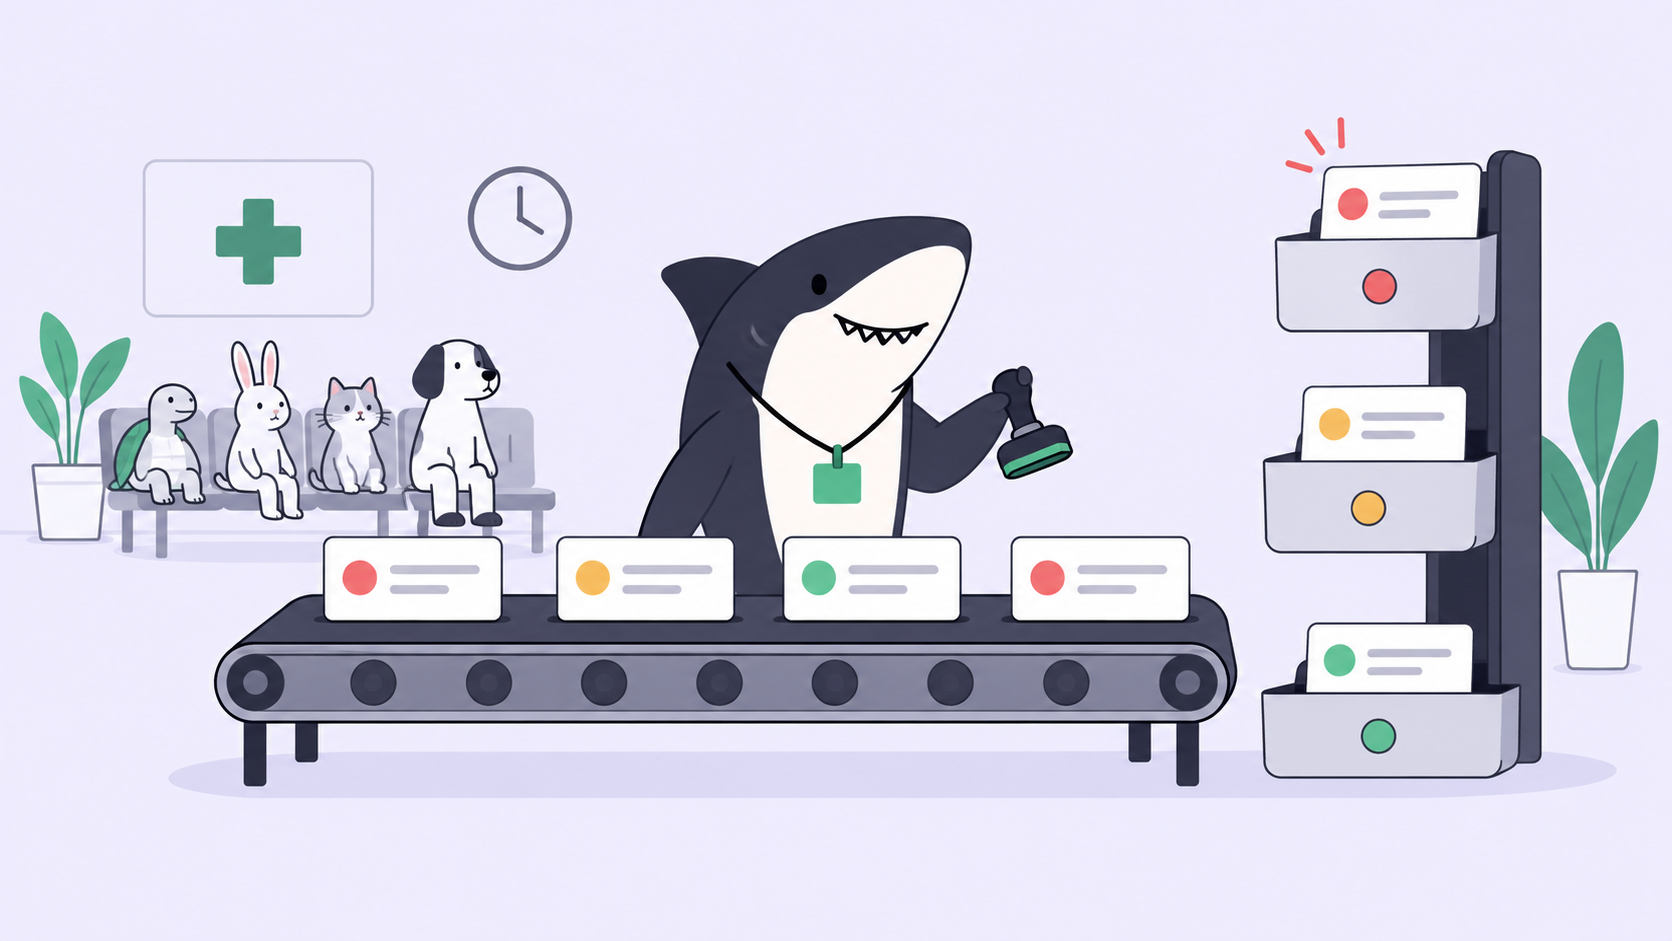
코딩 에이전트 네 개가 같은 시간 안에 작업을 마치고 풀 리퀘스트 네 개를 연다. 하나는 결제 재시도 경로를 건드리고, 하나는 테스트 헬퍼 이름을 바꾸고, 하나는 마이그레이션을 추가하고, 하나는 README 오타를 고친다. 병목은 코드도 테스트도 아니다. diff를 한 줄도 읽기 전에 사람이 답해야 하는 질문, 즉 "이 중에 뭘 먼저 봐야 하지?"다. 우리는 에이전트가 병렬로 돌기 시작하면 사람의 리뷰가 병목이 된다고 주장해 왔다. 이 글은 그 문제에서 기계적인 부분, 즉 큐의 순서를 정하는 일과, Jev 같은 결정 모델이 리뷰 자체를 가져가지 않으면서 리뷰어의 부담에서 순서 정하기를 덜어낼 수 있는 방법을 다룬다.
Jev란 무엇인가
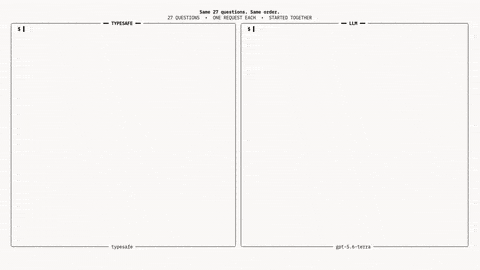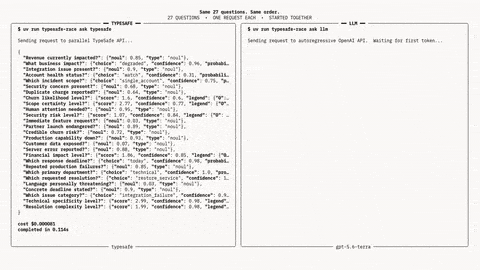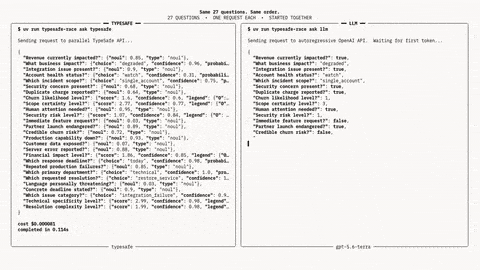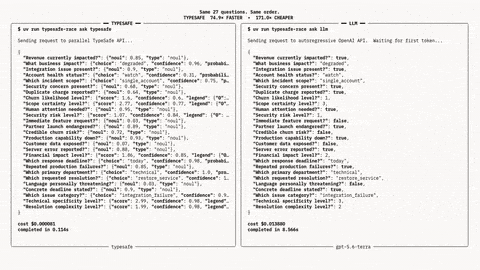
Jev는 TypeSafe AI의 System One 모델이다. 상태(state) 한 조각과 타입이 지정된 질문 묶음을 보내면, 각 질문에 대해 보정된 확률과 함께 답을 돌려준다. 자유 서술 텍스트는 절대 없다. 이름을 분명히 하자면, 이건 TypeSafe의 모델 Jev이지 유튜버도, 일본뇌염 백신도 아니다. TypeSafe의 출시 글은これを "비정형 상태를 입력하면 타입이 지정된 확률적 결정이 나온다"고 설명한다. API는 엔드포인트 하나, POST https://api.typesafe.ai/v1/systemone, Bearer 키, 모델 jev-latest, 그리고 세 가지 질문 유형으로 이루어진다. noul(예/아니오 확률), choice(최대 255개 선택지 중 하나), score(2~10단계 루브릭상의 위치)다. 텍스트 전용이며 요청당 64k 토큰(상태에 32k 할당), 입력 토큰 100만 개당 $0.042, 출력은 과금되지 않는다. 코딩 에이전트를 위한 결정 계층으로서의 Jev를 다룬 자매 글에서는 이 모델 전반을 설명하고, 여기서는 한 가지 작업에만 사용한다.
리뷰의 세 가지 질문
코딩 에이전트가 여는 모든 PR은 같은 세 가지 질문을 낳고, 각각은 하나의 프리미티브에 대응한다. 세 질문 모두 상태는 같다. diff 요약, 테스트 결과, 변경된 경로다. 전체 diff가 아니다. 요약을 쓰면 호출이 예산 안에 들어오고, 모델이 코드를 다시 리뷰하는 대신 라우팅 질문에 답하도록 붙잡아 둘 수 있다.
병합 전에 사람이 필요한가? noul이다. 이건 필터다. PR이 애초에 사람 큐에 들어갈지, 아니면 낮은 우선순위 레인에서 기다릴지를 결정한다.
어떤 리뷰어 또는 어떤 큐인가? 팀이 실제로 운영하는 큐들에 대한 choice다. 답에는 선택지와 함께 전체 분포가 담기므로, 두 큐 사이의 0.48 / 0.44 분할은 그 PR이 소유권 경계에 걸쳐 있다는 뜻이고, 이 사실 자체만으로도 알아둘 가치가 있다.
얼마나 큰 위험을 안고 있는가? 순서가 있는 루브릭에 대한 score다. 결과는 확률 가중 위치이므로, 어떤 변경이 "테스트로 커버되는 로직 변경"과 "인증·결제·데이터를 건드림" 사이의 2.6에 놓일 수 있다. 그 숫자가 큐의 정렬 키다.
요청 하나로 세 가지에 모두 답한다:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
응답은 같은 키 아래에 놓인 세 개의 타입 지정된 답이다. SH-418의 경우 needs_human은 0.9 근처, queue는 payments를 선택, risk는 루브릭 상단 근처일 것으로 예상된다. 테스트가 모두 통과한 결제 재시도 수정이라도 결제 큐 맨 앞으로 간다. 테스트가 통과했다고 해서 "사람이 읽어야 하는가"에 대한 답이 되지는 않기 때문이다.
임계값과 각 구간이 하는 일
확률은 코드가 그것을 행동으로 바꿔줄 때에야 쓸모가 있다. 아래 구간은 출발점일 뿐, 여러분의 저장소에 대한 권장 사항이 아니다. 일주일쯤 돌려본 뒤에 조정하라.
needs_human |
동작 |
|---|---|
| 0.85 이상 | 사람 큐 맨 앞, risk 내림차순 정렬 |
| 0.15 ~ 0.85 | 사람 큐, risk 기준 정렬, 위 구간 다음 |
| 0.15 미만 | 낮은 우선순위 레인. 그래도 사람이 각자의 일정에 맞춰 병합한다 |
이 체계를 정직하게 유지하는 규칙이 두 가지 있다. 첫째, 루브릭 최상단의 risk는 needs_human이 뭐라고 하든 항상 PR을 맨 앞 구간으로 승격시킨다. 스키마 마이그레이션이 리뷰를 받아야 한다고 0.12 확신하는 모델은 깔끔한 diff 요약을 본 것이지, 프로덕션을 본 게 아니다. 둘째, 상위 두 선택지가 0.1 이내로 붙어 있는 choice는 두 큐 모두로 라우팅한다. 어느 쪽도 아닌 게 아니다. 소유권이 모호하다는 건 두 사람이 그 변경을 흘깃 봐야 할 이유이지, 아무도 안 봐도 된다는 이유가 아니다.
모든 구간에서 사람에게 남는 게 무엇인지 보라. 바로 병합이다. 구간은 읽는 순서와 읽는 깊이를 바꿀 뿐, 누가 결정하는지는 절대 바꾸지 않는다.
판정이 아니라 큐에 Jev를 써라
질문에 정해진 답 집합이 있고, 상태가 충실한 요약이며, 사람의 주의를 더 나은 순서로 쓰고 싶을 때 Jev를 써라. 누가 읽을지, 얼마나 빨리 읽을지, 어느 큐로 갈지 말이다. 이런 질문은 모든 PR에서 나오고, 이 가격이면 매 실행마다 물어볼 만큼 저렴하다.
변경이 올바른지가 질문일 때는 사람을, 또는 추론 과정을 보여줄 수 있는 언어 모델을 써라. 변경에 리뷰가 필요하다는 확률은 리뷰가 아니다. Jev에는 컴파일러도, 테스트 러너도, 자신이 채점하는 파일에 대한 접근 권한도 없다. 여러분이 보낸 요약만 있을 뿐이다. "병합해도 안전"에 0.96이라는 건 그 PR을 누군가의 목록 맨 위에 올릴 강력한 이유일 뿐, 그 누군가를 건너뛸 이유는 결코 아니다. 승인 게이트는 모델 뒤에 있고, 모델은 그것을 열 방법이 없다.
커뮤니티가 만든 것
출시 며칠 만에 한 개발자가 jev-review를 공개했는데, README에서는 이를 "TypeSafe Jev로 만든 작은 코드 리뷰 워크플로"라고 설명한다. Git diff 또는 코드베이스 전체를 리뷰하고, 정확성·보안·신뢰성·호환성·테스트 커버리지를 검사하며, 영향을 채점하기 전에 코드 영역을 선택하고, 임계값과 워크플로 정책을 코드로 적용하며, 결과를 로컬 대시보드에 보여준다. README는 범위를 신중하게 밝힌다. 이 프로젝트를 "빠른 타입 지정 판단을 리뷰 워크플로로 조합하는 실험"이라고 부르고, "아직 컴파일러 진단, 정적 분석기, 저장소 인덱싱, 생성된 설명을 통합하지 않는다"고 말한다.
그 설계에서 따라 할 만한 점이 두 가지 있다. 오케스트레이션은 코드에 두고 Jev는 경계가 정해진 질문에만 답하게 하는 것, 그리고 전체 diff에 대한 하나의 거대한 질문 대신 영역을 고르고 나서 채점하는 식으로 작업을 단계화하는 것이다. Jev는 Vercel AI Gateway에도 typesafe-ai/jev로 올라와 있으며 AI SDK 7의 experimental_evaluate를 통해 쓸 수 있다. Gateway 문서는 이것이 AI SDK를 통해서만 사용 가능하다고 밝힌다.
Sharkly와의 관계
Sharkly는 여러분 대신 Jev를 호출하지 않고, 결정 모델도 아니다. 팀이 이미 돌리고 있는 코딩 에이전트를 둘러싼 공유 태스크, Computer, 컨텍스트, 리뷰 계층이다. 순위가 매겨진 큐가 그 계층에 요구하는 것은 실행할 곳과 결과가 안착할 곳이다.
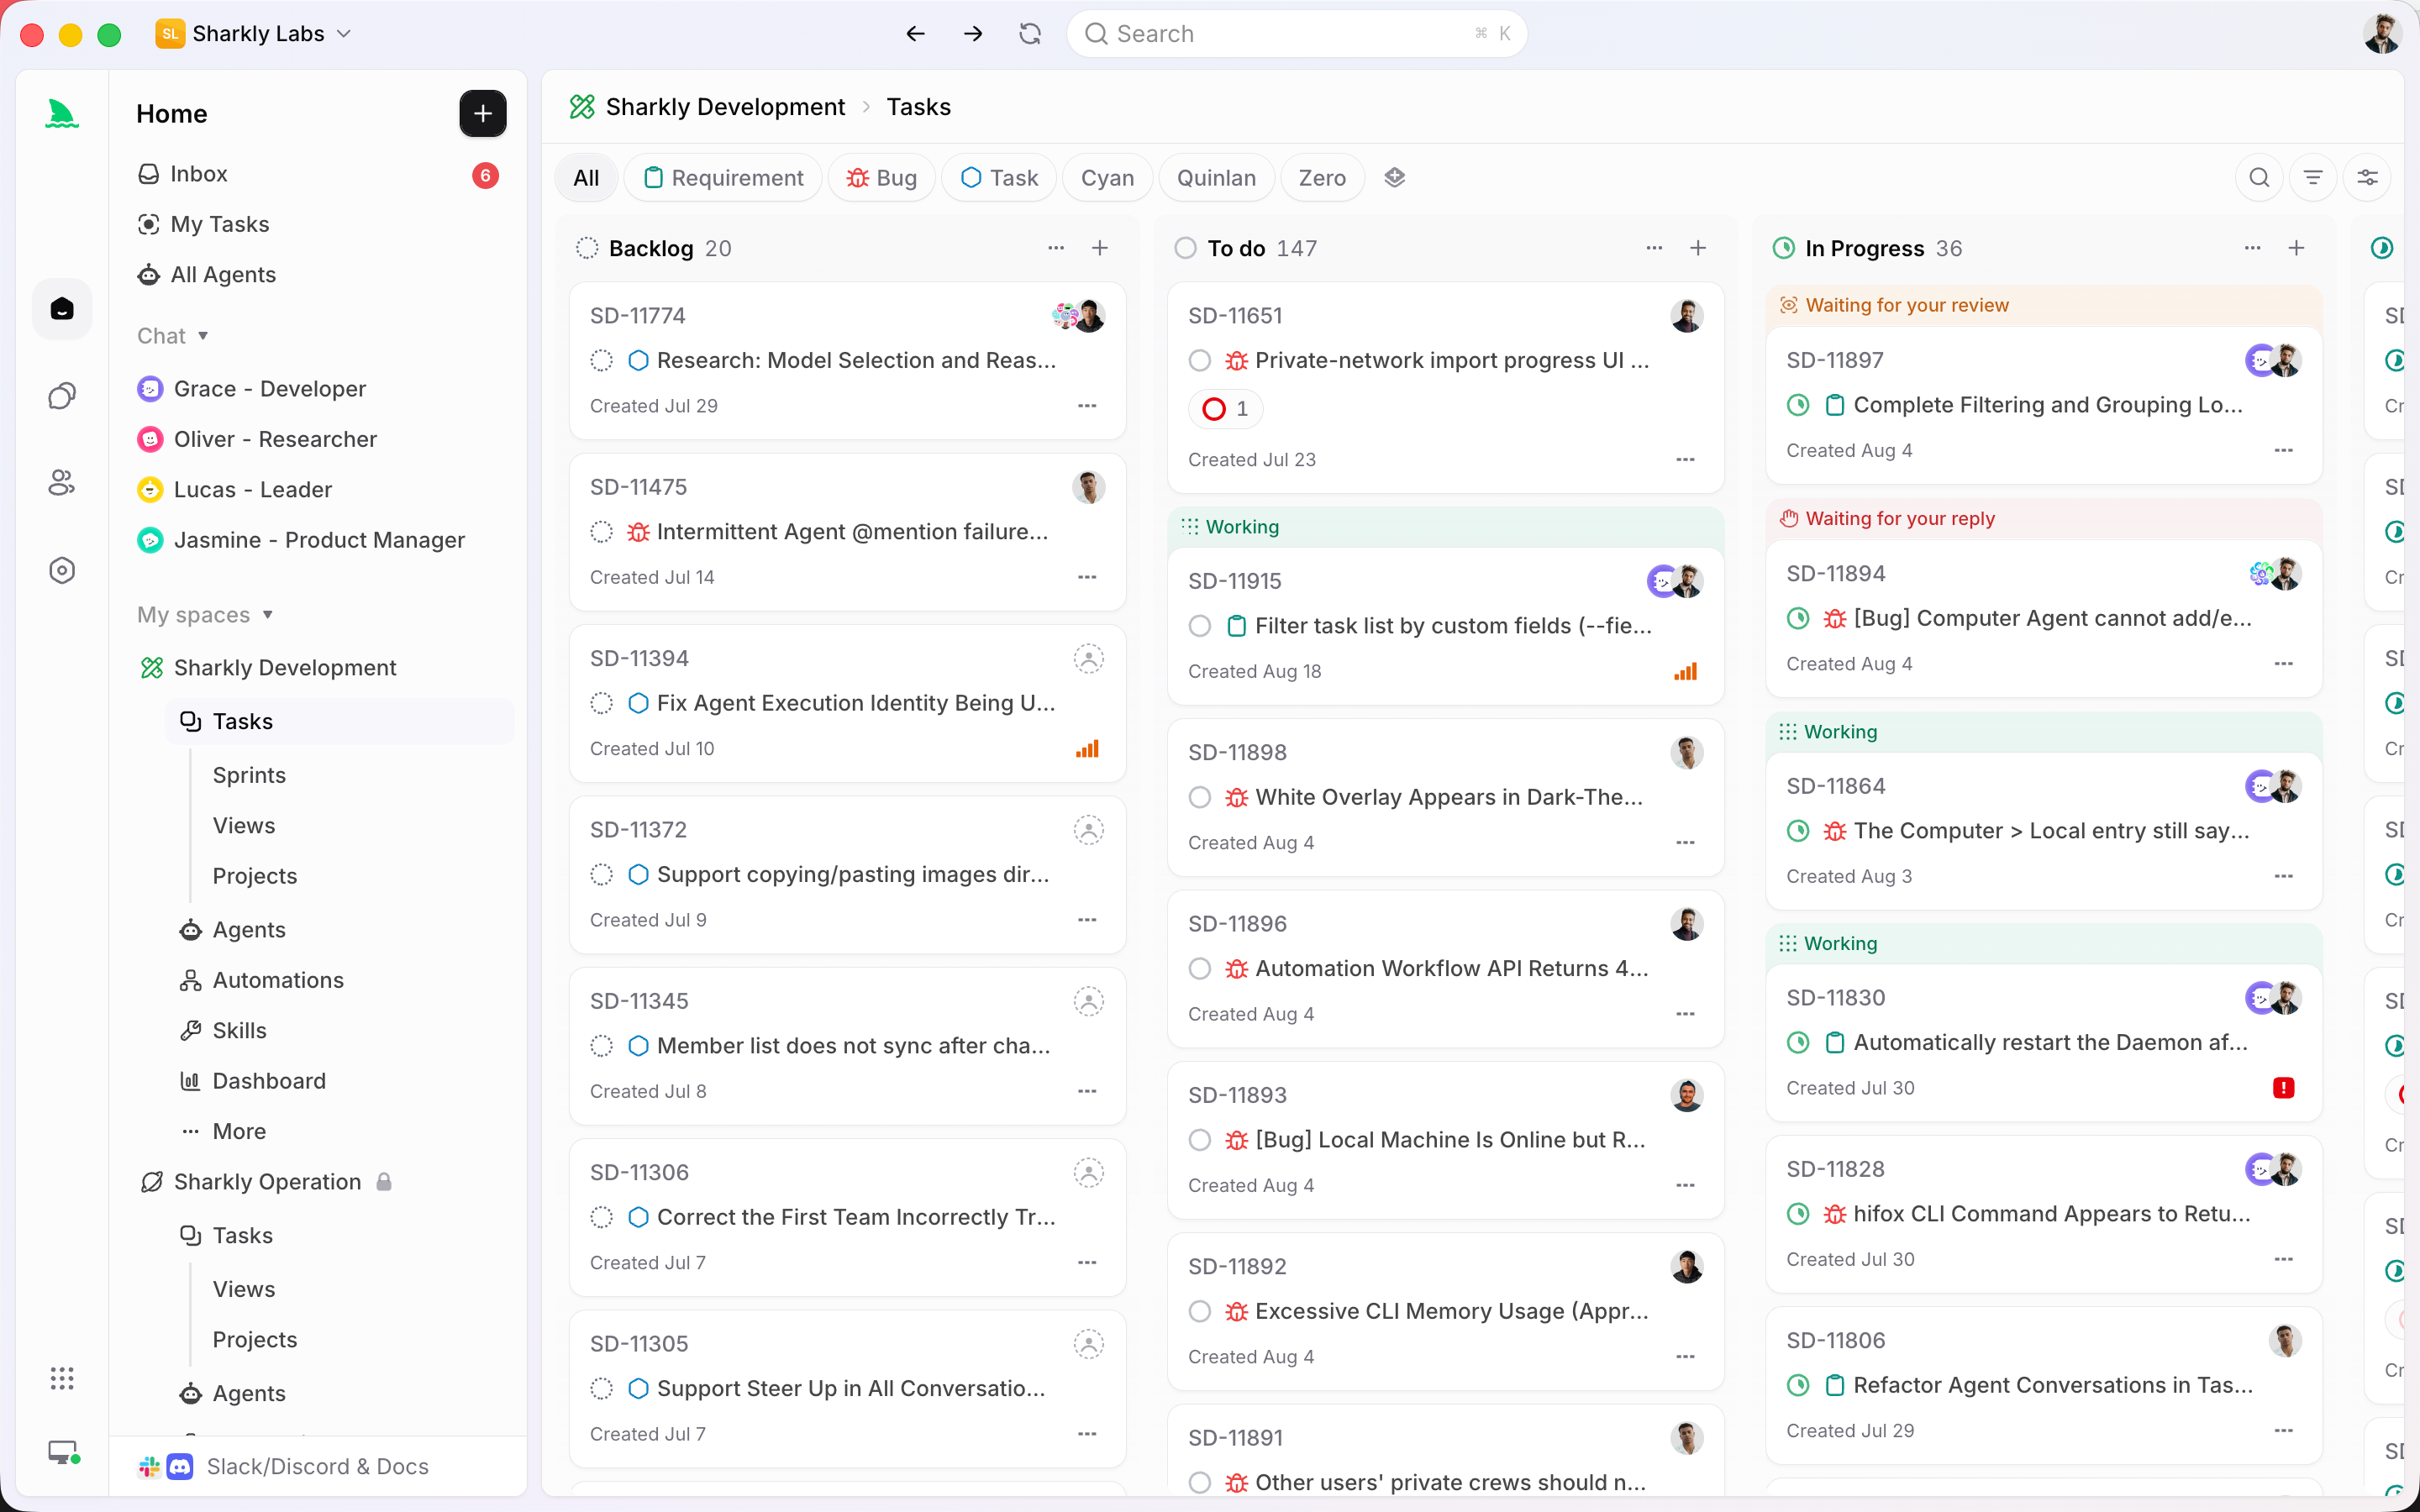
실행할 곳은 Automation이다. 트리거가 발생하면 일련의 지시와 함께 Agent를 시작하는 Space 소유 규칙이며, 트리거 중 하나는 태스크가 지정한 상태로 이동하는 것이다. PR이 열렸을 때 Agent가 도달하는 상태를 지정하면, 지시는 이렇게 된다. 태스크의 diff 요약, 테스트 결과, 변경된 경로를 읽고, 세 가지 질문으로 Jev를 호출하고, 답과 구간을 태스크에 대한 댓글로 다시 쓰고, 큐 레이블을 설정한다. 문서는 완료된 실행이 "모든 다운스트림 비즈니스 결과가 올바랐다는 약속이 아니다"라고 분명히 밝히는데, 이는 리뷰 구간이 그리는 경계와 같다.
안착할 곳은 태스크 자체다. 구간, 큐, 위험 점수는 리뷰어가 이미 보는 곳, 즉 실행의 변경 요약과 검증 결과 옆에 있는 태스크로 돌아간다. 사람은 위험 순으로 정렬된 보드를 열고 각 PR이 왜 그 위치에 있는지 확인한다. 에이전트는 풀 리퀘스트를 열고, 테스트를 돌리고, 보고한다. 사람은 큐가 제안하는 순서로 읽고, 수락하거나 거부한다. 순서는 확률에서 나왔지만, 결정은 그렇지 않았다.
이미 여러 에이전트를 돌리고 있고 리뷰 큐가 문제라면, 그것이 Sharkly 시작하기가 세팅해 주는 워크플로다. Computer 하나, Agent 하나, 순위 매기기에 필요한 증거를 담은 태스크 하나.
FAQ
Jev가 요약 대신 전체 diff를 읽을 수 있나요?
상태로 최대 32k 토큰을 받으니 작은 diff는 들어간다. 그래도 요약을 보내라. 에이전트의 diff는 예산을 훌쩍 넘고, 요약을 쓰면 질문이 라우팅 수준에 머문다. 전체 diff는 사람이 읽는 것이고, 그 옆에 태스크 수준 증거가 놓인다.
에이전트가 diff 요약을 직접 작성했다면요?
그러면 요약이 에이전트에 유리한 쪽으로 틀릴 수 있고, 순위가 그걸 그대로 물려받는다. 별도 단계에서 diff로부터 생성한 요약을 쓰고, 최상단 risk 점수가 낮은 needs_human을 항상 덮어쓰게 하라. AI 코드 리뷰의 한계가 여기에도 적용된다. 모델은 보여준 것의 순위는 매길 수 있지만, 보지 못한 것은 검증할 수 없다.
낮은 구간이면 PR이 자동으로 병합되나요?
아니다. 낮은 구간은 누군가가 나중에, 각자의 일정에 맞춰, 큐에서 먼저 읽지 않고 병합한다는 뜻이다. 병합의 소유권, 그리고 에이전트가 만들어낸 작업의 소유권은 모든 구간에서 이름이 붙은 사람에게 남는다.
Sharkly를 통해 Jev를 무료로 쓸 수 있나요?
Sharkly는 Jev나 다른 어떤 모델도 재판매하지 않는다. 여러분이 직접 TypeSafe 또는 Gateway 키를 가져오면 되고, 실행이 Runtime에 연결된 구독으로 청구되는 방식과 같다. Sharkly 자체는 현재 5인 이하 조직까지 무료다.


