
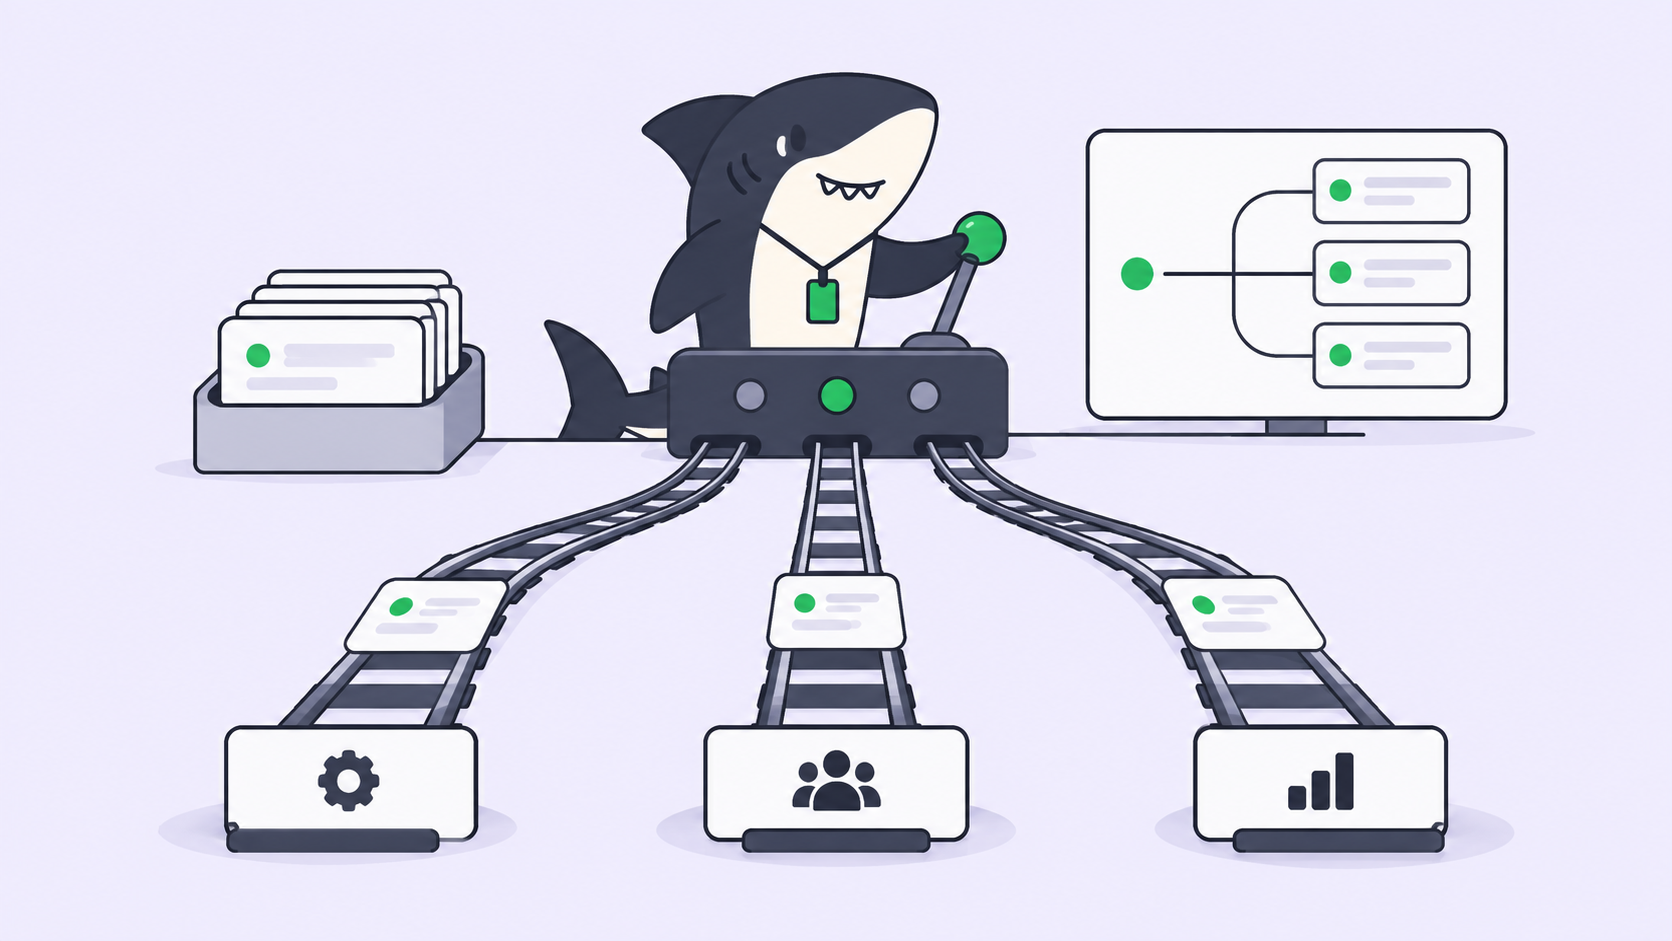
여러분의 팀은 이미 모델 간에 작업을 라우팅하고 있다. 다만 그게 사람들 머릿속에서 이루어질 뿐이다. 한 엔지니어는 실패율이 낮다는 이유로 모든 작업을 비싼 티어에서 돌린다. 또 다른 엔지니어는 지난달에 저렴한 모델로 갈아탔지만 아무에게도 말하지 않았다. 세 번째 엔지니어는 도구가 설치 시점에 기본값으로 잡아둔 모델을 여전히 쓰고 있다. 한 사람이 에이전트 하나를 돌리는 동안에는 이 정도로도 버틸 만하다. 하지만 다섯 개의 Agent가 동시에 실행되는 순간, 그리고 docstring 하나 처리하는 데 필요한 비용의 40배를 쓰고 있는 게 어느 것인지, 감당할 수 없는 작업을 조용히 실패하고 있는 게 어느 것인지 아무도 말할 수 없게 되는 순간, 그 방식은 끝난다.
2026년 9월 22일, 티어 간 격차는 무시할 수 없을 만큼 벌어졌다. Anthropic은 Claude Opus 5.5를, OpenAI는 GPT-6 Sol과 GPT-6 Luna를 출시했다. 세 모델 중 가장 저렴한 것과 가장 비싼 것의 입력 토큰 가격 차이는 40배에 달하며, 셋 모두 실제 Task를 맡길 만큼 충분히 뛰어나다.
라우팅 규칙은 선호가 아니라 명문화된 선언이다
라우팅 규칙은 어떤 종류의 Task가 어떤 Runtime에서 실행되는지를 문서로 명시한 것이다. 그리고 그것은 실행을 시작한 사람이 아니라 그 작업을 수행하는 Agent에 붙는다.
핵심은 바로 여기에 있고, 중요한 쪽은 '문서로'라는 부분이다. 선호는 한 사람의 터미널에만 존재하고, 그 사람이 휴가를 가면 사라진다. 규칙은 Agent 옆에 붙어 있기 때문에, Task를 넘겨받는 Assignee는 그 규칙을 그대로 물려받고, 리뷰어는 자신이 읽고 있는 diff를 어느 티어가 만들어냈는지 알 수 있으며, 다음 분기에 마음이 바뀌어도 여섯 번의 대화 대신 한 번의 수정으로 끝난다.
라우팅 규칙은 모델 순위표가 아니다. 어느 모델이 최고라고 주장하지도 않고, 그럴 필요도 없다. 그저 각 종류의 작업이 기본적으로 어디로 가는지, 그리고 그 기본값이 틀렸을 때 어떻게 할지를 정할 뿐이다.
세 티어의 비용
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| API ID | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| 1M당 입력 / 출력 | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| 캐시된 입력 | 읽기 $0.20, 쓰기 $5 | 읽기 90% 할인 | 읽기 90% 할인 |
| 컨텍스트 | 1M | 872k | 1M |
참고로 Claude Opus 5는 $5 / $25, GPT-6 Astra는 $10 / $50이다. OpenAI는 Sol과 Luna가 GPT-5.6 프로모션 가격보다 50% 저렴하다고 설명한다. '프로모션'이라는 단어는 OpenAI가 직접 쓴 표현이며 의미를 바꿔 놓는다. 그 헤드라인의 기준선은 정가가 아니라 할인가다. OpenAI는 또한 Astra가 "모든 면에서 여전히 우리의 최고 모델"이라고 밝히는데, 이는 Sol이 해당 모델군의 플래그십이 아니라 가성비 티어라는 점을 상기시켜 주는 유용한 대목이다.
규칙에 티어를 적어 넣기 전에 실무적으로 확인할 것이 하나 있다. OpenAI는 Sol과 Luna를 ChatGPT Work와 Codex의 Plus, Pro, Business, Enterprise, Edu 플랜에서 제공하며, Free와 Go는 데스크톱 앱에서 Luna를 쓸 수 있다고 밝히고, 둘 다 아직 Chat에는 없다고 말한다. 가용성은 가격만큼이나 라우팅 규칙을 좌우한다. Crew의 절반이 접근할 수 없는 티어는 티어가 아니기 때문이다.
토큰 단가가 아니라 완료된 작업당 비용을 기준으로 라우팅하라
토큰 가격은 실제로 지불하는 금액을 대신 보여주는 지표일 뿐이다. 단가가 5분의 1이어도 네 번 시도하고 사람이 구해야 한다면 그 모델은 더 저렴하지 않다. OpenAI는 이번 출시에서 점수와 함께 작업당 비용을 공개했는데, 이는 이례적으로 직접적인 지표이며 라우팅 결정에 딱 맞는 형태의 근거다.
| OpenAI가 공개한 벤치마크 | 결과 | 작업당 비용(상대값) |
|---|---|---|
| AutomationBench 1.0.6, Sol(extra-high) | 33.2% | 작업당 $0.27 |
| AutomationBench 1.0.6, GPT-6 Astra(low) | 30.3% | Sol의 3.9배 |
| AutomationBench 1.0.6, Claude Opus 5(max) | 26.9% | Sol의 11.1배 |
| AutomationBench 1.0.6, Fable 5.1(Opus 5 폴백, max) | 31.4% | Sol의 8.9배 이상 |
| Agents’ Last Exam V1, Sol(max) | 56.4%, Opus 5의 최고 기록 상회 | Opus 5보다 60% 낮음 |
| OSWorld 2.0 offline, Sol(extra-high) | 60.5%, Opus 5의 medium 설정(60.3%)과 비교 | 약 80% 저렴 |
| DeepSWE 1.1, Luna(max) | 66.6% | Opus 5보다 93% 저렴 |
| DeepSWE 1.1, Sol(max) | 68.8%, Fable 5의 extra-high 기록과 1.1pp 차이 | 약 80% 저렴 |
이 표에는 두 가지 사실이 동시에 담겨 있다. 격차는 크지만, 그 비교 대상은 Claude Opus 5.5가 아니라 Opus 5다. Opus 5.5는 OpenAI의 글이 작성될 당시 존재하지 않았고, 몇 시간 뒤에 Anthropic의 자체 설명에 따르면 Opus 5보다 40% 저렴한 비용으로 출시되었다. 아무도 그 비교를 다시 실행하지 않았다. 이 행들은 마지막으로 공개된 수치로, 그리고 그것이 시사하는 순위는 여러분의 저장소에서 직접 검증해 볼 가설로 받아들여라.
이 단서에도 살아남는 것은 전체적인 형태이며, 라우팅 규칙에 필요한 것도 바로 그 형태다. 저렴한 티어들은 범위가 정해진 반복 작업에서 훨씬 적은 비용으로 충분히 제 몫을 해낸다. Anthropic이 Opus 5.5에 대해 내세우는 주장은 작업당 가격과는 전혀 무관하다. Opus 5보다 40% 저렴한 실행 비용, 약 30% 빠른 출력, 128k 최대 출력, 그리고 18시간 이상 작업에 집중을 유지하는 능력이다. 이는 길고 지저분한 작업에 투입하는 모델을 설명하는 것이지, 백 개의 작은 작업에 투입하는 모델을 설명하는 게 아니다.
규칙을 문서로 옮기면
결과물은 이렇다. 의도적으로 따분하게 만들었고, 한 사람의 노트북에 있는 개인 설정 파일이 아니라 팀원들이 읽는 곳에 있어야 한다.
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
실질적인 역할을 하는 건 세 줄이다. 기본 티어가 명시되어 있으니 아무도 신경 쓰지 않은 Task도 합리적인 곳에 배치된다. 에스컬레이션이 명확하게 정의되어 있으니 저렴한 실패가 아무도 모르는 사이 비싼 실패로 번지지 않는다. 예외는 Task에 기록되며, 이 점이 규칙과 제안을 가르는 차이다.
팀들이 빠뜨리는 절반, 에스컬레이션
위 표의 절약 효과는 시도 한 번 기준으로는 실제다. 하지만 저렴한 시도가 습관적으로 비싼 재시도와 사람의 구원을 불러온다면 그 절약은 사라진다. 두 번의 실행과 업무 중단까지 모두 비용으로 지불하게 되기 때문이다. 이것이 자동 폴백 체인의 실패 양상이다. 저렴한 티어의 비용을 비싼 티어의 청구서 안에 숨겨 버려서, 아무도 환율을 볼 수 없게 만든다.
그러니 에스컬레이션은 수동으로, 그리고 눈에 보이게 만들어라. 실패한 실행은 로그, 지금까지의 diff, 그리고 막혔던 지점의 질문과 함께 Task로 돌아온다. 사람이 그것을 상위 티어로 재라우팅할지, 쪼갤지, 명확히 할지를 결정한다. Agent는 조사하고, 실행하고, 테스트하고, 보고한다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 받아들인다. 에스컬레이션 경로가 재시도 루프라면, 사람이 필요했던 바로 그 결정을 자동화해 버린 셈이다.
지연에 민감한 작업을 하위 티어로 라우팅하기 전에 눈여겨볼 것이 하나 더 있다. 두 벤더 중 어느 쪽도 아닌 제3자인 Artificial Analysis는 'max' 추론 변형을 측정한 결과 Sol이 초당 115.2 출력 토큰에 첫 토큰까지 102.15초, Luna가 초당 153.9 토큰에 124.23초를 기록했다고 밝혔다. 이 수치에 의존하기 전에 현재 공시된 정보와 대조해 확인하라. [VERIFY] 중요한 건 전체적인 양상이다. 최대 추론 강도에서는 저렴한 모델이 빠르게 시작하는 모델이 아니며, 백 초 동안 생각 중인 Agent는 멈춰 버린 Agent와 똑같이 보인다. 어느 티어로 라우팅하든, Runtime이 진행 상황과 실패를 어떻게 알리는지가 그 차이를 누군가 알아차릴 수 있는지를 결정한다.
라우팅 규칙을 쓰지 말아야 할 때
저장소 하나에 에이전트 하나를 돌리고 있다면, 이런 건 아무것도 하지 마라. 여러분의 작업에 맞는 티어를 골라 쓰고 넘어가라. 라우팅에는 관리해야 할 문서 하나와 치러야 할 논쟁 하나가 따른다. 그리고 여러 Agent가 동시에 돌아가고 그 비용이나 실패 양상이 서로 다를 때에만 그만한 값을 한다.
기준은 대략 이렇다. 두 명 이상이 실행을 시작할 수 있거나, 하나의 예산으로 여러 Agent를 동시에 운영할 때 규칙을 작성하라. 그 아래에서는 규칙이 그냥 부담이다. 그 위에서는 규칙의 부재가 지난달 청구서를 아무도 설명하지 못하는 이유가 된다.
움직이지 않는 숫자
완료된 작업당 비용은 이번 출시를 기점으로 양쪽 모두 크게 떨어졌다. 규모를 가늠해 보자면, OpenAI는 자사 연구원의 중간값이 코딩 에이전트에 하루 $600 이상을 쓰고, 90번째 백분위는 $7,000에 달한다고 보고한다. 그 선 아래에 있는 팀들은 같은 예산으로 몇 배나 더 많은 완성된 에이전트 작업을 얻었으며, 이는 청구서별이 아니라 Runtime별로 추적할 가치가 있다.
그러나 리뷰어의 시간은 단 1분도 늘지 않았다. 라우팅은 비용 지렛대이자 신뢰성 지렛대이며, 처리량 지렛대는 아니다. 사람이 승인해 주기를 기다리는 작업 큐는 그대로이기 때문이다. 라우팅이 할 수 있는 일은 그 큐를 읽을 수 있게 만드는 것이다. 이 diff를 어느 티어가 만들었는지, 비용은 얼마였는지, 시도는 몇 번이었는지, 그리고 두 번 실패한 Task가 누군가의 Inbox에 있는지 아니면 어디에도 없는지를 말이다. 요청부터 릴리스까지 목표, 실행, 비용, 블로커, 리뷰를 모두 Task에 남겨 두면, 라우팅 규칙은 여섯 명이 각자 품고 있는 습관이 아니라 팀이 함께 수정하는 설정이 된다.
Sharkly는 모델을 실행하지도, 여러분 대신 모델을 골라주지도 않는다. Sharkly는 그 일을 해내는 도구들을 둘러싼 공유 Task, Computer, 컨텍스트, 리뷰 레이어이며, 라우팅 규칙이 그것을 작성한 사람보다 오래 살아남으려면 바로 여기에 있어야 한다. 이미 여러 코딩 에이전트를 돌리고 있다면, 어떤 모델이 어떤 작업을 맡을지와 어떤 에이전트가 그 작업을 맡을지는 같은 결정을 양쪽에서 바라본 것이다. Computer 하나를 연결하고, 티어마다 Agent를 하나씩 만들고, 저렴한 쪽에는 따분한 일을 맡겨라.


