
Meta가 10월 12일 Muse Wonder를 출시했습니다. 가격은 100만 입력 토큰당 4달러, 출력 토큰당 20달러이며, 100만(1M) 토큰 컨텍스트와 함께 세 가지 규격(OpenAI Responses, Chat Completions, Anthropic Messages)을 지원하는 API를 제공합니다. 바로 이 마지막 규격 지원 덕분에 지금 당장 Sharkly 보드에서 활용할 수 있습니다. Meta의 coding-agents 가이드에서는 Codex와 Claude Code의 엔드포인트를 api.meta.ai로 지정하여 muse-wonder-1.0을 실행하는 방법을 다루고 있으며, 두 도구 모두 Sharkly Computer에서 구동할 수 있는 Runtime입니다. Meta의 대표 벤치마크에 등장하는 모델인 Muse Wonder Full은 API로 제공되지 않으므로 Runtime 모델로 사용할 수 없는데, 이에 대한 자세한 내용은 아래에서 다루겠습니다.
이 가이드에서는 기존 Sharkly Computer에서 Codex Runtime을 사용해 Muse Wonder 레인을 구성하고, Task가 어떤 레인으로 전달되었는지 보드에 표시되도록 Agent에 모델명을 지정하며, Meta와 Artificial Analysis의 벤치마크 수치에서 이 모델이 강점을 보인 영역, 즉 장기 자율 에이전트 실행(long agentic runs)에 알맞게 작업을 배분하는 방법을 다룹니다.
핵심 요약 (TL;DR)
Computer의 ~/.codex/config.toml에 Meta용 Codex 프로바이더를 설정하고, model = "muse-wonder-1.0", wire_api = "responses"로 지정한 뒤 로컬 서비스의 환경 변수 MODEL_API_KEY에서 키를 읽어오도록 구성합니다. Codex Runtime 상태가 Available로 표시될 때까지 재검색(Rescan)을 실행합니다. 해당 Runtime에 Agent를 생성하고 Custom arguments에 모델을 지정한 다음, 여러 단계에 걸친 리팩터링, 마이그레이션, 검토 및 수정 반복(review-and-fix loops)과 같은 긴 호흡의 Task를 할당합니다. 방대한 지식이 필요하거나 터미널 작업 비중이 높은 작업은 Opus 5.5 또는 Astra Agent에 맡기세요. Agent는 조사, 실행, 테스트, 보고를 담당하며, 그 결과는 Task에 기록됩니다.
모델 설정이 위치하는 곳
Sharkly는 자체적으로 모델을 선택하지 않습니다. Agents 문서에 따르면 Agent는 Runtime의 기본 모델을 따르며 모델명을 직접 표시하지 않습니다. 모델을 변경하려면 Agent나 Runtime의 Custom arguments에 예를 들어 specify model: model-name과 같이 직접 지정해야 합니다. Sharkly는 Runtime이 어떤 모델을 사용했는지 안정적으로 판별할 수 없기 때문에 별도의 모델 드롭다운 메뉴나 사고 깊이(thinking-depth) 제어 옵션을 제공하지 않습니다.
Meta 모델을 사용할 때는 설정이 두 계층으로 나뉩니다. Runtime이 api.meta.ai와 API 키를 참조하는 프로바이더 설정은 Computer의 Runtime 자체 설정 파일에 위치합니다. 반면 모델 선택은 Agent 레벨에서 지정됩니다. 따라서 한 대의 Computer에서 서로 다른 Runtime을 기반으로 Muse Wonder Agent와 Opus 5.5 Agent를 함께 운영할 수 있으며, 리뷰어가 확인할 수 있는 위치에 모델명이 명시됩니다.
1단계: Computer에서 Codex에 Meta 프로바이더 설정하기
Meta의 가이드에 나와 있는 Codex 설정 방법입니다. Computer의 ~/.codex/config.toml 파일에 다음을 추가합니다.
model = "muse-wonder-1.0"
model_provider = "meta"
model_reasoning_effort = "high"
model_context_window = 1048576

[model_providers.meta]
name = "Meta Model API"
base_url = "https://api.meta.ai/v1"
env_key = "MODEL_API_KEY"
wire_api = "responses"
Meta에서 강조하는 두 가지 주의 사항이 있습니다. 첫째, Codex에서 먼저 OpenAI 계정을 로그아웃해야 합니다. 그렇지 않으면 계속해서 OpenAI 프로바이더를 사용하게 됩니다. 둘째, wire_api = "responses" 설정이 필수적입니다. Responses API는 여러 턴에 걸쳐 추론(reasoning) 맥락을 유지해 주므로 장기 실행 작업의 일관성을 유지하는 핵심 역할을 합니다.
API 키는 Codex를 실행하는 프로세스의 환경 변수에 설정해야 하며, Sharkly Computer에서는 로컬 서비스 프로세스가 이에 해당합니다. 해당 서비스가 환경 변수를 읽어오는 위치에 MODEL_API_KEY를 설정한 다음 서비스를 재시작하세요. Sharkly UI에는 API 키를 입력하지 마세요. Computers 문서에서는 비밀번호, 토큰, API 키를 Runtime의 실행 파일(executable), 인수(arguments), 환경 변수(environment) 필드에 입력해서는 안 된다고 명시하고 있습니다. 이 필드들은 비밀 정보가 아닌 기본값을 설정하는 용도입니다.
보드에서 작업을 시작하기 전에 해당 호스트의 일반 터미널에서 먼저 테스트하세요.
codex "Say which model you are and stop."
Codex가 muse-wonder-1.0으로 응답한다면 Sharkly에서 사용할 준비가 된 것입니다. Computer 세부 정보 페이지를 열고 재검색(rescan) 또는 연결 테스트를 실행하세요. Codex Runtime 상태가 Available로 표시되어야 합니다. Computer가 online으로 표시되는 것은 로컬 서비스가 하트비트를 보내고 있다는 의미일 뿐이며, 실제로 실행이 가능한 상태인지는 Runtime 상태를 확인해야 합니다.
Runtime으로 Claude Code를 선호한다면 Meta 가이드에 안내된 모델 슬롯 매핑을 따르세요. ANTHROPIC_BASE_URL="https://api.meta.ai", ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY", ANTHROPIC_MODEL="muse-wonder-1.0"으로 설정하고, Opus 슬롯은 Wonder로, Sonnet 및 Haiku 슬롯과 CLAUDE_CODE_SUBAGENT_MODEL은 muse-spark-1.3으로 매핑하며, MCP 도구가 정상 로드되도록 ENABLE_TOOL_SEARCH="true"를 지정합니다. 모든 슬롯에 Meta 모델을 지정해야 합니다. 그렇지 않으면 Plan Mode 및 서브에이전트가 Meta에서 제공하지 않는 Claude 모델 호출을 시도하게 됩니다. API 키는 Sharkly 필드가 아닌 호스트 환경 변수에 설정해야 한다는 원칙은 동일하게 적용됩니다.
2단계: 사용 중인 모델을 명시하는 Agent 생성하기
Agents 메뉴를 열고 New Agent를 선택한 뒤, 해당 Computer와 Codex Runtime을 선택하고 Agent 이름을 Muse 대신 레인의 용도를 나타내는 Long-run worker 등으로 지정합니다. Custom arguments에는 앞서 테스트한 모델명과 일치하는 muse-wonder-1.0을 지정합니다. 각 Task가 격리되어 실행될 수 있도록 작업 디렉터리를 Create temporary directory로 설정하고, 일반적인 짧은 레인보다 Task당 제한 시간(timeout)을 넉넉하게 설정하세요. Meta가 이 모델에서 가장 내세우는 강점은 지치지 않고 작업을 지속한다는 점이며, SWE-Marathon이 바로 이를 평가하는 벤치마크입니다.
Sharkly 인터페이스에는 모델명이 표시되지 않으므로, Agent가 직접 기록을 남기도록 지침(instructions)을 작성합니다.
You are the long-run lane. State the model id you ran on at the top of your report.
Take the Task as written. Plan before you edit, and keep a running list of what
you tried and why, so a reviewer can follow the path, not only the diff.
Run the closest relevant check before reporting done. Report failures as failures.
If you need a fact you are not sure of, look it up in the repository or say you
could not confirm it. Do not fill gaps from memory.
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, or any action you would want a person to confirm.
네 번째 지침을 넣은 데에는 분명한 이유가 있습니다. Artificial Analysis의 지식 지수 평가에서 Wonder는 25점을 기록해 46점인 Opus 5.5에 크게 못 미쳤으며, 환각(hallucination) 발생률은 27%였습니다. 즉 실행력은 뛰어나지만 백과사전식 지식에는 취약한 일꾼이므로, 이 지침을 통해 어떤 역할에 집중해야 하는지 명확히 규정해 주는 것입니다.
3단계: 장기 실행 Task를 이 레인으로 라우팅하기
Meta의 모델 카드와 독립적인 벤치마크 결과를 종합해 볼 때, 이 레인에 적합한 작업 유형은 다음과 같습니다.
| 평가 항목 | Muse Wonder | Claude Opus 5.5 |
|---|---|---|
| SWE-Marathon (장기 코딩 작업) | 53.1 | 46.3 |
| DeepSWE 1.1 | 78.8 | 74.2 |
| Terminal-Bench 4.0 | 52.0 | 59.6 |
| AA-Omniscience (지식) | 25 | 46 |
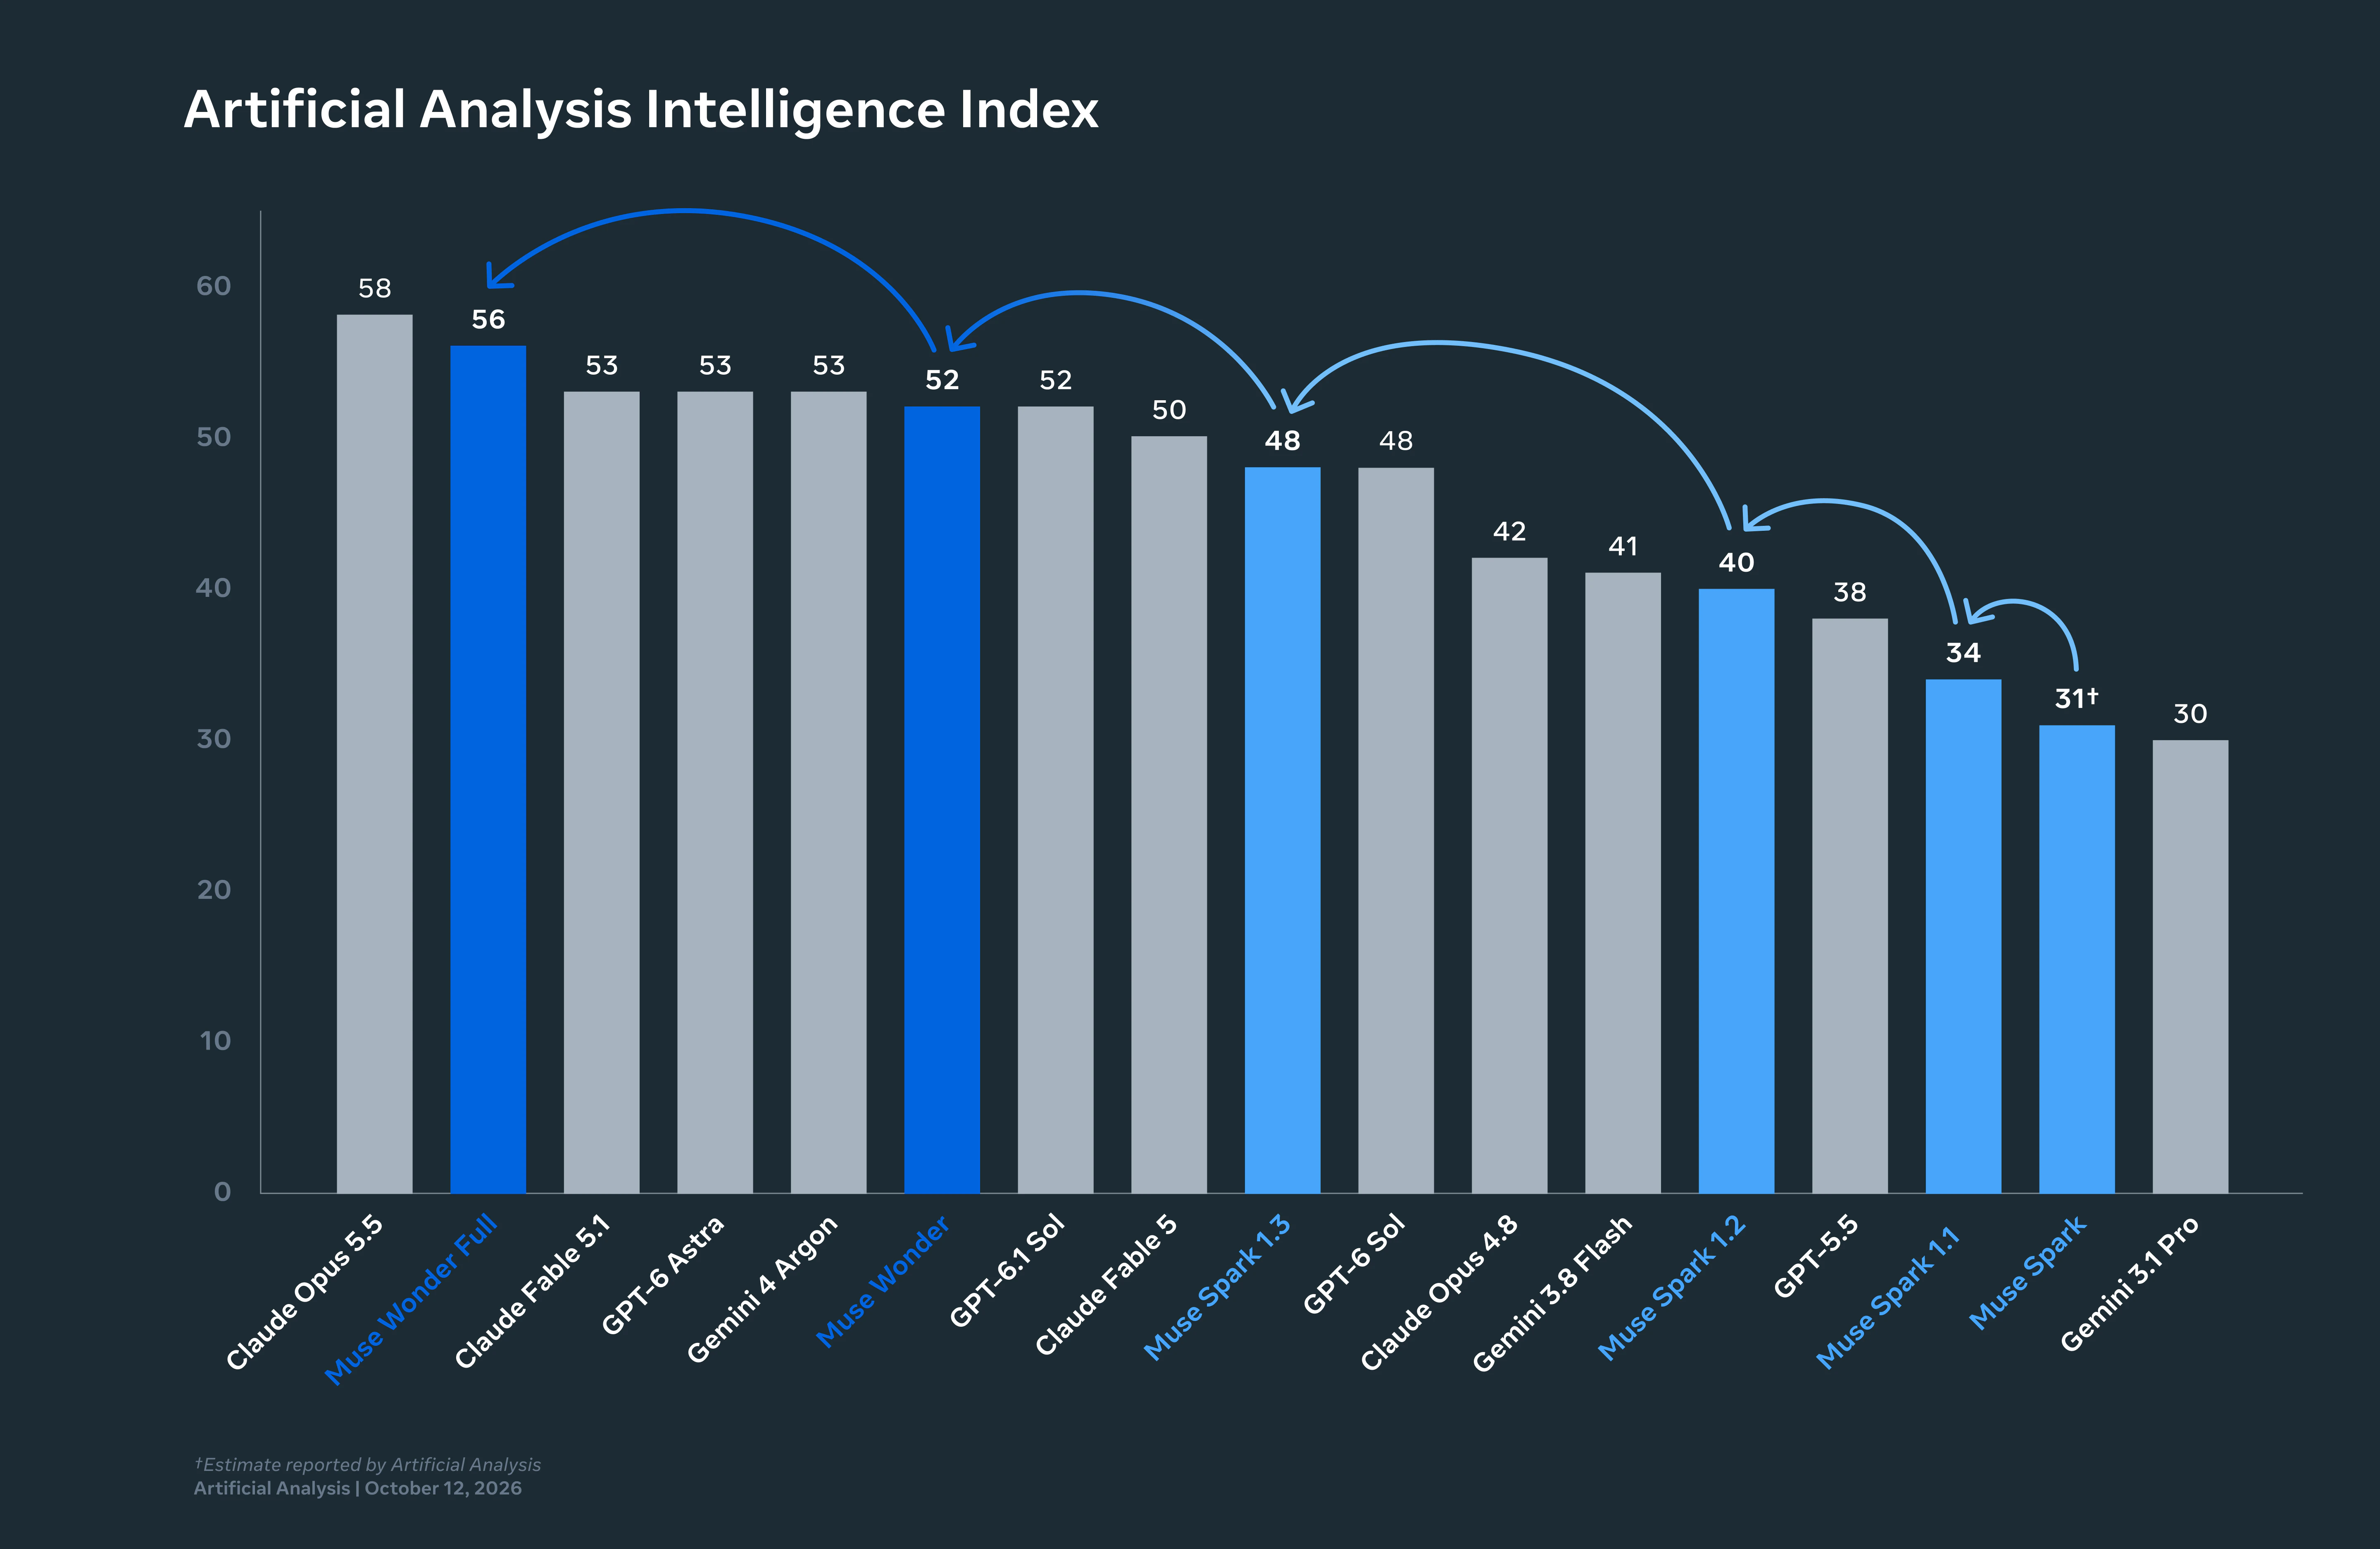
| Intelligence Index (지능 지수) | 52 | 58 |
| 100만 토큰당 가격 (입력 / 출력) | $4 / $20 | $4 / $20 |
가격은 같지만 특성은 완전히 다릅니다. 따라서 Crew의 라우팅 규칙은 다음과 같이 명확해집니다.
- Muse Wonder Agent에 할당: Task의 호흡이 길고 여러 단계로 구성되어 있으며 도중에 문제에 부딪힐 가능성이 높을 때 적합합니다. 여러 파일에 걸친 리팩터링, 실패하는 테스트를 추적하며 해결해야 하는 의존성 마이그레이션, 불안정한(flaky) 테스트 스위트를 수정하고 검증하는 반복 루프 등이 이에 해당합니다.
- Opus 5.5 또는 Astra Agent 유지: 터미널 작업 비중이 높거나, 광범위한 사실적 지식이 필요하거나, 가장 정교한 코드 리뷰가 요구될 때 적합합니다. 일반적인 작업 할당 원칙은 어떤 Agent에 Task를 할당해야 하는가(Which agent gets the Task)를 참고하세요.
그런 다음 완료 기준(acceptance criterion)이 명확한 Task를 골라 담당자(Assignee)로 Muse Wonder Agent를 지정하고, Backlog에서 작업 준비 완료 상태로 이동시킵니다. 작업은 queued, dispatched, running 상태를 거쳐 진행되며, 실행 로그에는 도구 호출과 Runtime 이벤트가 기록됩니다. Agent가 작업을 멈추고 확인 질문을 던지면 해당 질문은 Task에 댓글 형태로 추가되어 수신함(Inbox)으로 라우팅됩니다. Meta는 Wonder가 중요한 작업을 수행하기 전에 사용자에게 확인을 거치도록 훈련시켰으며, 보드 시스템에서는 이러한 확인 요청이 수신함이라는 명확한 창구로 전달됩니다. 이를 어떻게 활용하는지에 대해서는 Active Focus와 검토 대기열(Active Focus and the review queue)을 참조하세요.
실행할 수 없는 모델: Muse Wonder Full
Muse Wonder Full은 Coding Agents Index에서 56점을 기록(Wonder는 52점)하며 Sonnet 5.5 기반의 Claude Code와 함께 공동 68위를 기록했습니다. 하지만 이 모델은 50달러 Power 요금제 및 200달러 Maximum 요금제의 Muse Code 내에서만 제공됩니다. 별도의 API 모델 ID가 없기 때문에 Codex나 Claude Code의 엔드포인트로 지정할 수 없으며, Muse Code는 Sharkly 로컬 서비스가 자동으로 감지하는 Runtime도 아닙니다. Sharkly는 자동 감지되지 않는 도구를 위한 커스텀 ACP Runtime을 제공하지만, Meta 문서에는 Muse Code가 ACP를 지원하는지 여부가 명시되어 있지 않으므로 현재로서는 검증되지 않은 것으로 보아야 합니다. 팀 단위 환경에서 Full 모델은 개별 엔지니어가 터미널에서 사용하는 모델일 뿐, 보드에서 자동으로 할당할 수 있는 모델이 아닙니다. 자세한 의미는 구독 전용으로 제공되는 Muse Wonder Full(Muse Wonder Full is subscription-only) 문서를 참조하세요.
비용 및 데이터 정책
이 과정에서 발생하는 모델 사용료는 Sharkly 요금에 청구되지 않습니다. 모델 사용량은 Computer에 설정된 Meta API 키를 통해 직접 정산되며, 요율은 Meta의 기준에 따릅니다. 즉 100만 토큰당 입력 4달러, 출력 20달러, 캐시된 토큰 0.20달러이며, 긴 컨텍스트에 대한 추가 할증이 없고 팀 전체 기준 분당 3,000건의 요청 및 400만(4M) 토큰 한도가 적용됩니다. 장기 실행 작업은 매 턴마다 컨텍스트를 재전송하므로 Muse Wonder 레인은 본질적으로 프롬프트 캐시 활용률이 매우 높습니다. Artificial Analysis의 실측에 따르면 Task당 비용은 Opus 5.5가 5.98달러였던 것에 비해 Wonder는 4.52달러였는데, 이는 주로 Wonder의 출력 토큰 비용이 더 저렴했기 때문입니다.
Meta의 Standard 모드에서 발생하는 API 트래픽은 모델 학습에 사용되지 않습니다. 이는 기본값이 Contributor 모드로 설정되는 Muse Code 구독 방식과는 다릅니다. Computer의 Runtime은 API를 직접 사용하므로, 별도의 설정을 변경하지 않아도 팀의 코드가 Meta의 학습 데이터에 포함되지 않고 안전하게 보호됩니다.
이번 주 모델 환경에 새로운 변화가 찾아왔습니다. 하지만 요청부터 릴리스에 이르기까지 컨텍스트, 진행 상황, 병목 지점, 결과물, 그리고 사람에 의한 검토 과정을 투명하게 가시화해야 한다는 점은 변하지 않았습니다. 이러한 체계를 git worktree를 활용해 수작업으로 구축할 수도 있고, Sharkly를 사용해 전체 워크플로를 관리할 수도 있습니다.


