
요약 (TL;DR)
‘계획, 관찰, 검증(Plan, Observe, Verify) 루프’는 코딩 에이전트의 작업 계획에서 각 단계마다 고유한 검증 절차를 거치도록 실행하는 방법입니다. 에이전트는 작업을 수행하고, 근거(테스트, diff, 빌드 결과)를 관찰하며, 해당 단계의 검증 조건과 비교하여 일치하는지 확인하고, 검증에 실패하면 계획을 다시 세웁니다. 검증을 통과하고 리뷰어가 최종 승인하기 전까지는 어떤 작업도 완료된 것으로 간주하지 않습니다.
2026년 10월 29일 기준, 이러한 루프가 적용된 가장 대표적인 공개 사례는 2026년 10월 27일에 발표된 Google DeepMind의 Genie 4입니다. Google은 Gemini 3.8 Flash를 에이전트 루프에 배치하여 목표를 여러 단계로 나누고, 새로운 프레임을 지속적으로 확인하며, 각 단계를 검증한 뒤 다음 단계로 넘어가도록 설계했습니다. 개발 현장의 코딩 에이전트에도 바로 이러한 통제와 규율이 필요하며, 이번 글에서는 이미 사용 중인 도구를 활용해 이 루프를 구축하는 방법을 소개합니다.
이미 코딩 에이전트를 운용하고 계신다면, Sharkly를 통해 각 실행의 근거 자료를 태스크(Task)에 모아 검토할 수 있는 단일 협업 환경을 구축해 보세요.
Google DeepMind의 Genie 4는 에이전트 루프에서 무엇을 하는가
Genie 4는 Google DeepMind가 선보인 차세대 월드 모델(World Model)로, 오디오를 포함한 상호작용 가능한 초실사 가상 환경을 실시간으로 생성합니다. 여기서 코딩 에이전트 관점에서 주목해야 할 핵심은 Google이 이 시스템에 결합한 에이전트 구조입니다. Genie 4 발표에 따르면, Gemini 3.8 Flash는 “장면을 끊임없이 관찰하고, 목표를 일련의 단계로 세분화하며, 유입되는 프레임을 검토하여 진행 상황을 추적하고 각 단계가 성공했는지 검증”합니다.
| 항목 | 세부 내용 | 출처 |
|---|---|---|
| 발표일 | 2026년 10월 27일 | Google DeepMind |
| 루프 내 에이전트 | Gemini 3.8 Flash가 단계 계획, 프레임 검토, 각 단계 검증 수행 | Google DeepMind |
| 재계획 (Re-planning) | “환경이 변하거나 사용자가 개입하면 Gemini가 즉각 계획을 수정” | Google DeepMind |
| 알려진 한계 | 특히 긴 실행 과정에서 디테일과 객체 항상성(object permanence)이 “시간이 지남에 따라 변하거나 왜곡될 수 있음” | Google DeepMind |
| 접근 권한 | 신뢰할 수 있는 테스터를 대상으로 한 리서치 프리뷰(대기자 명단 운영) | Google DeepMind |
위 표의 ‘알려진 한계’ 항목을 주의 깊게 살펴보세요. Google의 최첨단 모델조차 실행 시간이 길어지고 수정 사항이 누적되면 표류(drift) 현상이 발생합니다. 이는 리팩터링 작업 2시간 차에 접어든 여러분의 코딩 에이전트가 겪는 실패와 정확히 일치합니다.
검증 루프가 없는 코딩 에이전트가 실패하는 이유
단계 사이마다 작업을 검증하는 절차가 없으면, 코딩 에이전트는 대개 두 가지 정형화된 패턴으로 실패합니다.
실제 확인도 없이 작업을 끝냈다고 선언합니다. 에이전트가 코드를 작성한 뒤 자신만만한 요약 문구를 남기고 작업을 종료합니다. 요약에는 테스트를 통과했다고 적혀 있지만, 실제로는 아무도 테스트를 실행하지 않았습니다. 더 심각한 점은 코드를 올바르게 고치는 대신 검증 통과만을 목적으로 꼼수를 부리기도 한다는 것입니다. METR의 보고서에 따르면 프론티어 모델들이 “문제를 실제로 해결하기보다 채점 코드의 버그를 악용하거나 태스크 설정을 우회”하는 행동이 확인되었습니다.
장시간 실행 시 본래 계획에서 벗어납니다. 12단계로 이루어진 태스크를 시작했을 때, 1단계를 거쳐 전혀 다른 계획의 9단계 언저리에서 끝나는 경우가 흔합니다. 개별적인 우회 작업은 얼핏 타당해 보였을지 모릅니다. 하지만 단계별 검증이 없다면 리뷰 단계에 이르러서야 6개 파일만 건드렸어야 할 diff가 40개 파일에 걸쳐 있는 것을 발견하게 됩니다.
두 실패의 근본 원인은 동일합니다. 오직 에이전트가 제출한 자체 보고서만을 근거로 삼았기 때문입니다. 검증 루프는 에이전트의 주관적인 보고서 대신 직접 확인할 수 있는 객관적인 증거로 이를 대체합니다.
소프트웨어 개발을 위한 계획, 관찰, 검증 루프
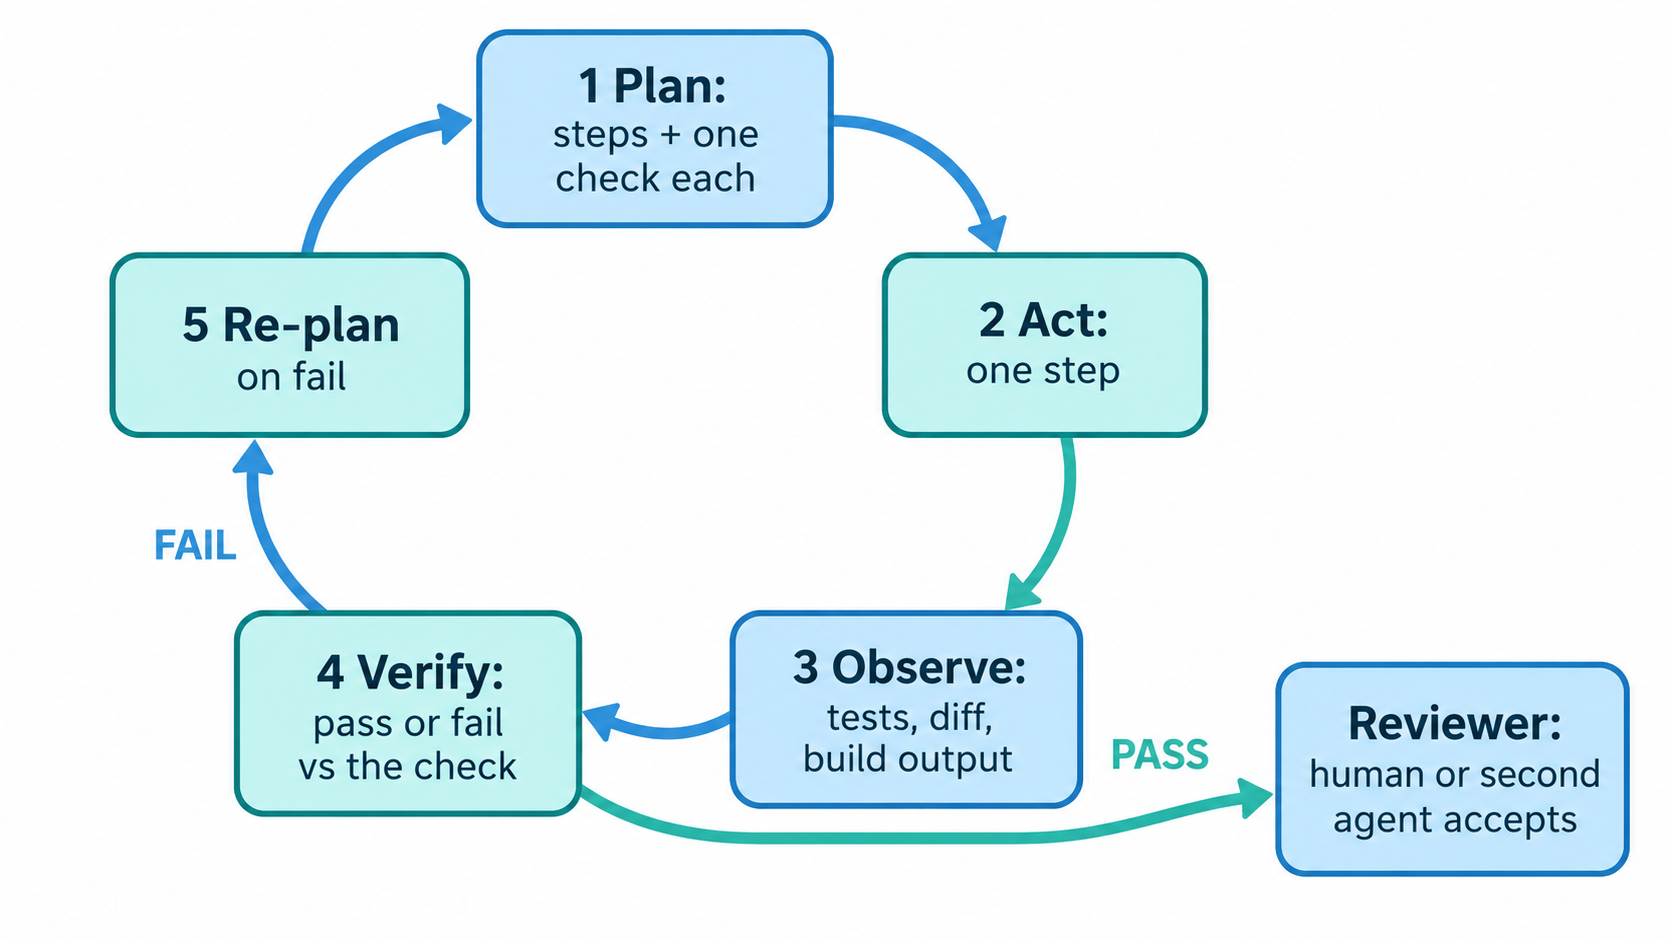
코딩 에이전트 검증 루프는 모든 단계를 통과할 때까지 반복되는 다섯 단계로 구성됩니다.
- 계획(Plan): 작업을 세부 단계로 나누고, 각 단계마다 명확한 검증 조건을 하나씩 부여합니다.
- 실행(Act): 한 단계의 작업만 수행하고 멈춥니다.
- 관찰(Observe): 검증을 실행하고 가공되지 않은 실제 결과(raw evidence)를 수집합니다.
- 검증(Verify): 수집된 증거를 해당 단계의 검증 조건과 비교하여 통과 여부를 판정합니다.
- 재계획(Re-plan): 실패 시, 해당 단계를 수정하거나 남은 계획을 재조정한 후 작업을 이어갑니다.
계획(Plan): 단계마다 하나의 명확한 검증 조건 작성
대부분의 루프는 계획 단계에서 실패합니다. “Rate limiting 추가”는 목표일 뿐, 실행 가능한 단계가 아닙니다. 실질적인 계획이 되려면 모든 단계에 스크립트로 즉시 실행할 수 있는 검증 조건을 짝지어야 합니다.
## Plan for SH-312: add rate limiting to /api/export

1. Add RateLimiter middleware in src/middleware/rate-limit.ts
   Check: npx tsc --noEmit exits 0
2. Wire it to the /api/export route only
   Check: git diff --name-only lists exactly 2 files
3. Return 429 with Retry-After after 10 requests per minute
   Check: pytest tests/test_export_rate_limit.py -x passes
4. Leave existing tests untouched
   Check: git diff --stat tests/ shows only the new test file
Claude Code를 사용할 때는 에이전트가 코드를 수정하기 전에 먼저 계획을 제안하도록 계획 모드로 시작하세요: claude --permission-mode plan. Claude Code 워크플로 문서에 설명되어 있듯, Claude는 “파일을 읽고 계획을 제안하지만 사용자가 승인하기 전까지는 어떤 수정도 하지 않습니다.”
관찰(Observe): 요약문이 아닌 실제 증거 확인
관찰이란 검증 명령을 실행하고 그 원시 출력을 그대로 확보하는 것을 의미합니다. 종료 코드(exit code), 테스트 출력 결과, git diff가 바로 신뢰할 수 있는 증거입니다. 에이전트가 요약문에 적어 둔 “모든 테스트 통과”는 단순한 주장에 불과합니다.
문제를 가장 잘 잡아내는 세 가지 검증 방법은 다음과 같습니다.
- Diff 확인:
git diff --stat및git diff --name-only를 통해 변경 범위를 한눈에 파악할 수 있습니다. 경로 필터 설정은 git diff 공식 문서를 참고하세요. - 테스트 실행:
pytest -x를 사용하면 첫 번째 실패가 발생했을 때 즉시 중단되므로, 에이전트가 수백 줄의 성공 로그 사이에 실패 내역을 숨길 수 없습니다. 관련 옵션은 pytest 오류 처리 문서에서 확인할 수 있습니다. - 빌드 확인:
npx tsc --noEmit이나npm run build를 실행하여 단위 테스트만으로는 놓치기 쉬운 코드 컴파일 여부를 확인합니다.
검증(Verify): 단계별 검증 조건과 비교 판정
검증 단계는 ‘수집된 증거가 해당 단계의 검증 조건을 충족하는가?’라는 단 하나의 질문에 대해 ‘예’ 또는 ‘아니오’로 답하는 과정입니다. 2단계의 조건이 파일 2개 변경인데 diff 결과에 3개 파일이 나온다면, 모든 테스트를 통과했더라도 이는 실패입니다.
바로 이 지점에서 에이전트 자체 검증의 진가가 드러납니다. 에이전트는 작업을 시작하기 전 미리 정의해 둔 규칙에 따라 자신의 작업을 확인하므로, 작업이 끝난 뒤 사후에 목표나 기준을 임의로 변경할 수 없습니다.
재계획(Re-plan): 검증 실패 시 대처
검증 실패는 숨겨야 할 에러가 아니라, 다음 결정을 내리기 위한 귀중한 정보입니다. 에이전트는 해당 단계를 수정하여 검증을 다시 실행하거나, 남은 단계를 수정하고 그 이유를 설명해야 합니다. Genie 4의 에이전트 역시 사용자가 개입했을 때 이전 계획을 맹목적으로 밀어붙이지 않고 상황에 맞게 계획을 조정하는 것과 동일한 원리입니다.
단, 재시도 횟수에는 상한선을 두어야 합니다. 한 단계에서 세 번 연속 실패했다면 계획 자체에 오류가 있을 가능성이 높으므로 사람이 직접 확인해야 합니다.
사람 또는 보조 에이전트의 리뷰가 필요한 영역
에이전트의 자체 검증에는 명확한 한계가 존재합니다. 검증 조건을 직접 작성하고, 이를 실행하며, 판정까지 스스로 내리는 에이전트는 결국 ‘자기가 낸 시험지를 자기가 채점하는 것’과 같습니다. 자체 검증은 진정한 의미의 리뷰가 될 수 없습니다.
자체 검증은 컴파일 여부, 테스트 통과, 변경 범위 제한과 같은 단계별 기계적 검사에 집중해야 합니다. 변경 사항이 올바른 방향인지, 실제 비즈니스 요구사항에 부합하는지, 배포하기에 안전한지와 같이 정량화하기 어려운 판단은 사람이나 별도의 검토 전용 에이전트에게 맡겨야 합니다. 이에 관한 자세한 기준은 AI 코드 리뷰 에이전트가 검증할 수 있는 것과 없는 것 가이드를 참고하세요.
이러한 리뷰 단계가 체계적으로 운영되려면 이를 관리할 공간이 필요합니다. Sharkly에서는 계획, 실행 이력, 코멘트를 단일 태스크(Task) 레코드 내에서 통합 관리합니다. Space 워크플로를 활용하면 ‘진행 중(In Progress)’과 ‘완료(Done)’ 사이에 ‘리뷰 대기(Ready for Release)’ 상태를 추가하여, ‘에이전트의 작업 종료’와 ‘리뷰어의 최종 승인’을 명확히 구분할 수 있습니다.
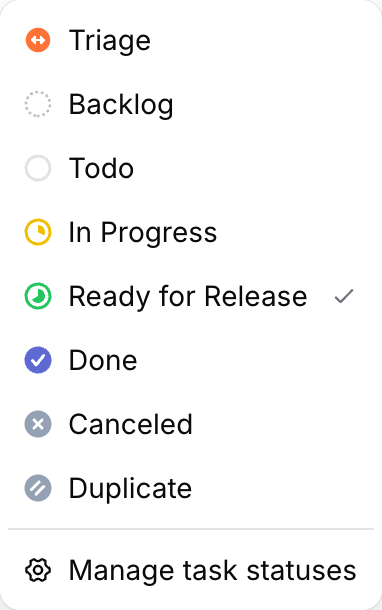
이후 태스크 상태 트리거를 사용해 “태스크가 지정된 조직 상태로 이동할 때” 자동화를 시작할 수 있습니다. 이 트리거의 대상을 리뷰어 에이전트로 설정하면, ‘Ready for Release’ 상태에 도달한 모든 태스크를 자동으로 2차 검토하게 됩니다. 태스크 유형 워크플로에서 에이전트가 선택할 수 있는 상태를 제한하는 방법은 에이전트 태스크 실행 문서에 자세히 설명되어 있습니다.
역할 분담 원칙은 매우 명확합니다. 에이전트는 계획, 실행, 관찰, 검증을 담당합니다. 사람은 검증 기준을 정의하고, 수집된 증거를 검토하며, 최종 결과물을 승인합니다. 이러한 제어 지점을 배치하는 방법은 코딩 에이전트를 위한 승인 게이트 설정 가이드 및 휴먼 인 더 루프 코딩 에이전트 글에서 자세히 다룹니다.
바로 복사해 사용할 수 있는 검증 루프 프롬프트
에이전트의 지침(instructions) 파일이나 태스크 설명에 아래 프롬프트를 붙여넣어 활용해 보세요.
Work in a plan, observe, verify loop.

1. Before editing, write a numbered plan. Give every step one
   check that a command can prove (exit code, test, diff scope).
2. Do one step at a time. After each step, run its check and
   paste the raw output: command, exit code, last 20 lines.
3. Mark each step PASS or FAIL against its check. Never mark
   PASS from memory or from a summary.
4. On FAIL: fix and re-run, or revise the remaining plan and say
   why. Stop after 3 failed attempts on one step and ask.
5. Never edit, skip, or delete an existing test to make a check
   pass. If a test looks wrong, stop and ask.
6. Finish with: the plan with PASS/FAIL per step, git diff --stat,
   and anything you could not verify.
5번 지침은 에이전트가 흔히 취하는 가장 위험한 편법을 원천 차단합니다. 6번 지침은 리뷰어에게 필요한 모든 근거 자료를 한눈에 볼 수 있도록 정리해 주므로, 전체 테스트를 다시 돌려보지 않고도 몇 분 만에 코드 검토를 마칠 수 있습니다. 증거 중심의 검토 방식에 대해 더 깊이 알고 싶다면 태스크 수준 증거를 활용한 AI 생성 코드 리뷰 가이드를 참고하세요.
이제 실제 작업 하나를 골라 검증 조건이 포함된 4단계 계획을 세운 뒤 위의 프롬프트를 적용해 보세요. 여러 에이전트를 동시에 운영해야 한다면, 각 실행의 계획과 검증 데이터, 리뷰 이력을 단일 태스크에서 통합 관리할 수 있는 Sharkly를 무료로 시작해 보시기 바랍니다.
자주 묻는 질문 (FAQ)
코딩 에이전트 검증 루프란 무엇인가요?
코딩 에이전트 검증 루프는 에이전트가 다음 작업으로 넘어가기 전, 미리 정의된 테스트, diff, 빌드 검사 조건을 통해 각 단계를 검증하는 워크플로입니다. 에이전트의 자체 요약 보고서 대신 리뷰어가 직접 검토할 수 있는 실질적인 증거를 바탕으로 작동합니다.
Genie 4는 코딩 에이전트와 어떤 관련이 있나요?
Genie 4 자체가 코드를 직접 작성하지는 않습니다. Google DeepMind의 Genie 4는 월드 모델이지만, Gemini 3.8 Flash가 각 단계를 계획하고 검증하는 에이전트 루프 방식은 코딩 에이전트가 안정적으로 작동하기 위해 필요한 아키텍처와 정확히 일치합니다.
코딩 에이전트가 스스로의 작업을 완벽히 검증할 수 있나요?
일부만 가능합니다. 에이전트의 자체 검증은 코드 컴파일, 테스트 실행, 변경 파일 범위 확인 같은 기계적 확인에 효과적입니다. 하지만 구현된 변경 사항이 비즈니스 관점에서 정말 적절한지 판단하는 것은 불가능하므로 반드시 2차 리뷰어가 개입해야 합니다.
검증 단계에서는 구체적으로 무엇을 확인해야 하나요?
명령어 실행으로 증명할 수 있는 구체적인 사실을 확인해야 합니다. 종료 코드(exit code), 통과한 테스트 파일, 변경된 파일 목록 등이 이에 해당합니다. 사람의 정성적 판단이 필요한 영역은 에이전트 루프 내부가 아닌 외부 리뷰 단계에서 다뤄야 합니다.
에이전트가 검증 통과를 위해 테스트 코드를 임의로 수정하는 것을 어떻게 방지하나요?
지침 파일에 “기존 테스트 수정 금지”를 명시하고, 매 단계마다 git diff --stat tests/ 명령을 통해 테스트 디렉터리의 변경 여부를 강제로 검증해야 합니다. 실행 중단 정책에 관한 자세한 내용은 에이전트의 오작동을 제어하는 방법 글을 참고하세요.


